BOSS直聘发布Nanbeige4.3-33B:Agent基准全面领先,社区在质疑什么
33B Dense模型在多项Agent基准上超过Qwen3.8-27B,512K上下文,Apache 2.0开源。官方定位是教师模型,后续要蒸3B。量化已经有人做了,单卡可跑,但架构和推理开销的质疑也不少。
BOSS直聘旗下的南北阁团队发布了Nanbeige4.3-33B。33B参数,Dense结构,512K上下文,Apache 2.0许可。官方在Hugging Face同时放出了Chat版和Base版权重,并直接和Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B做了对比。
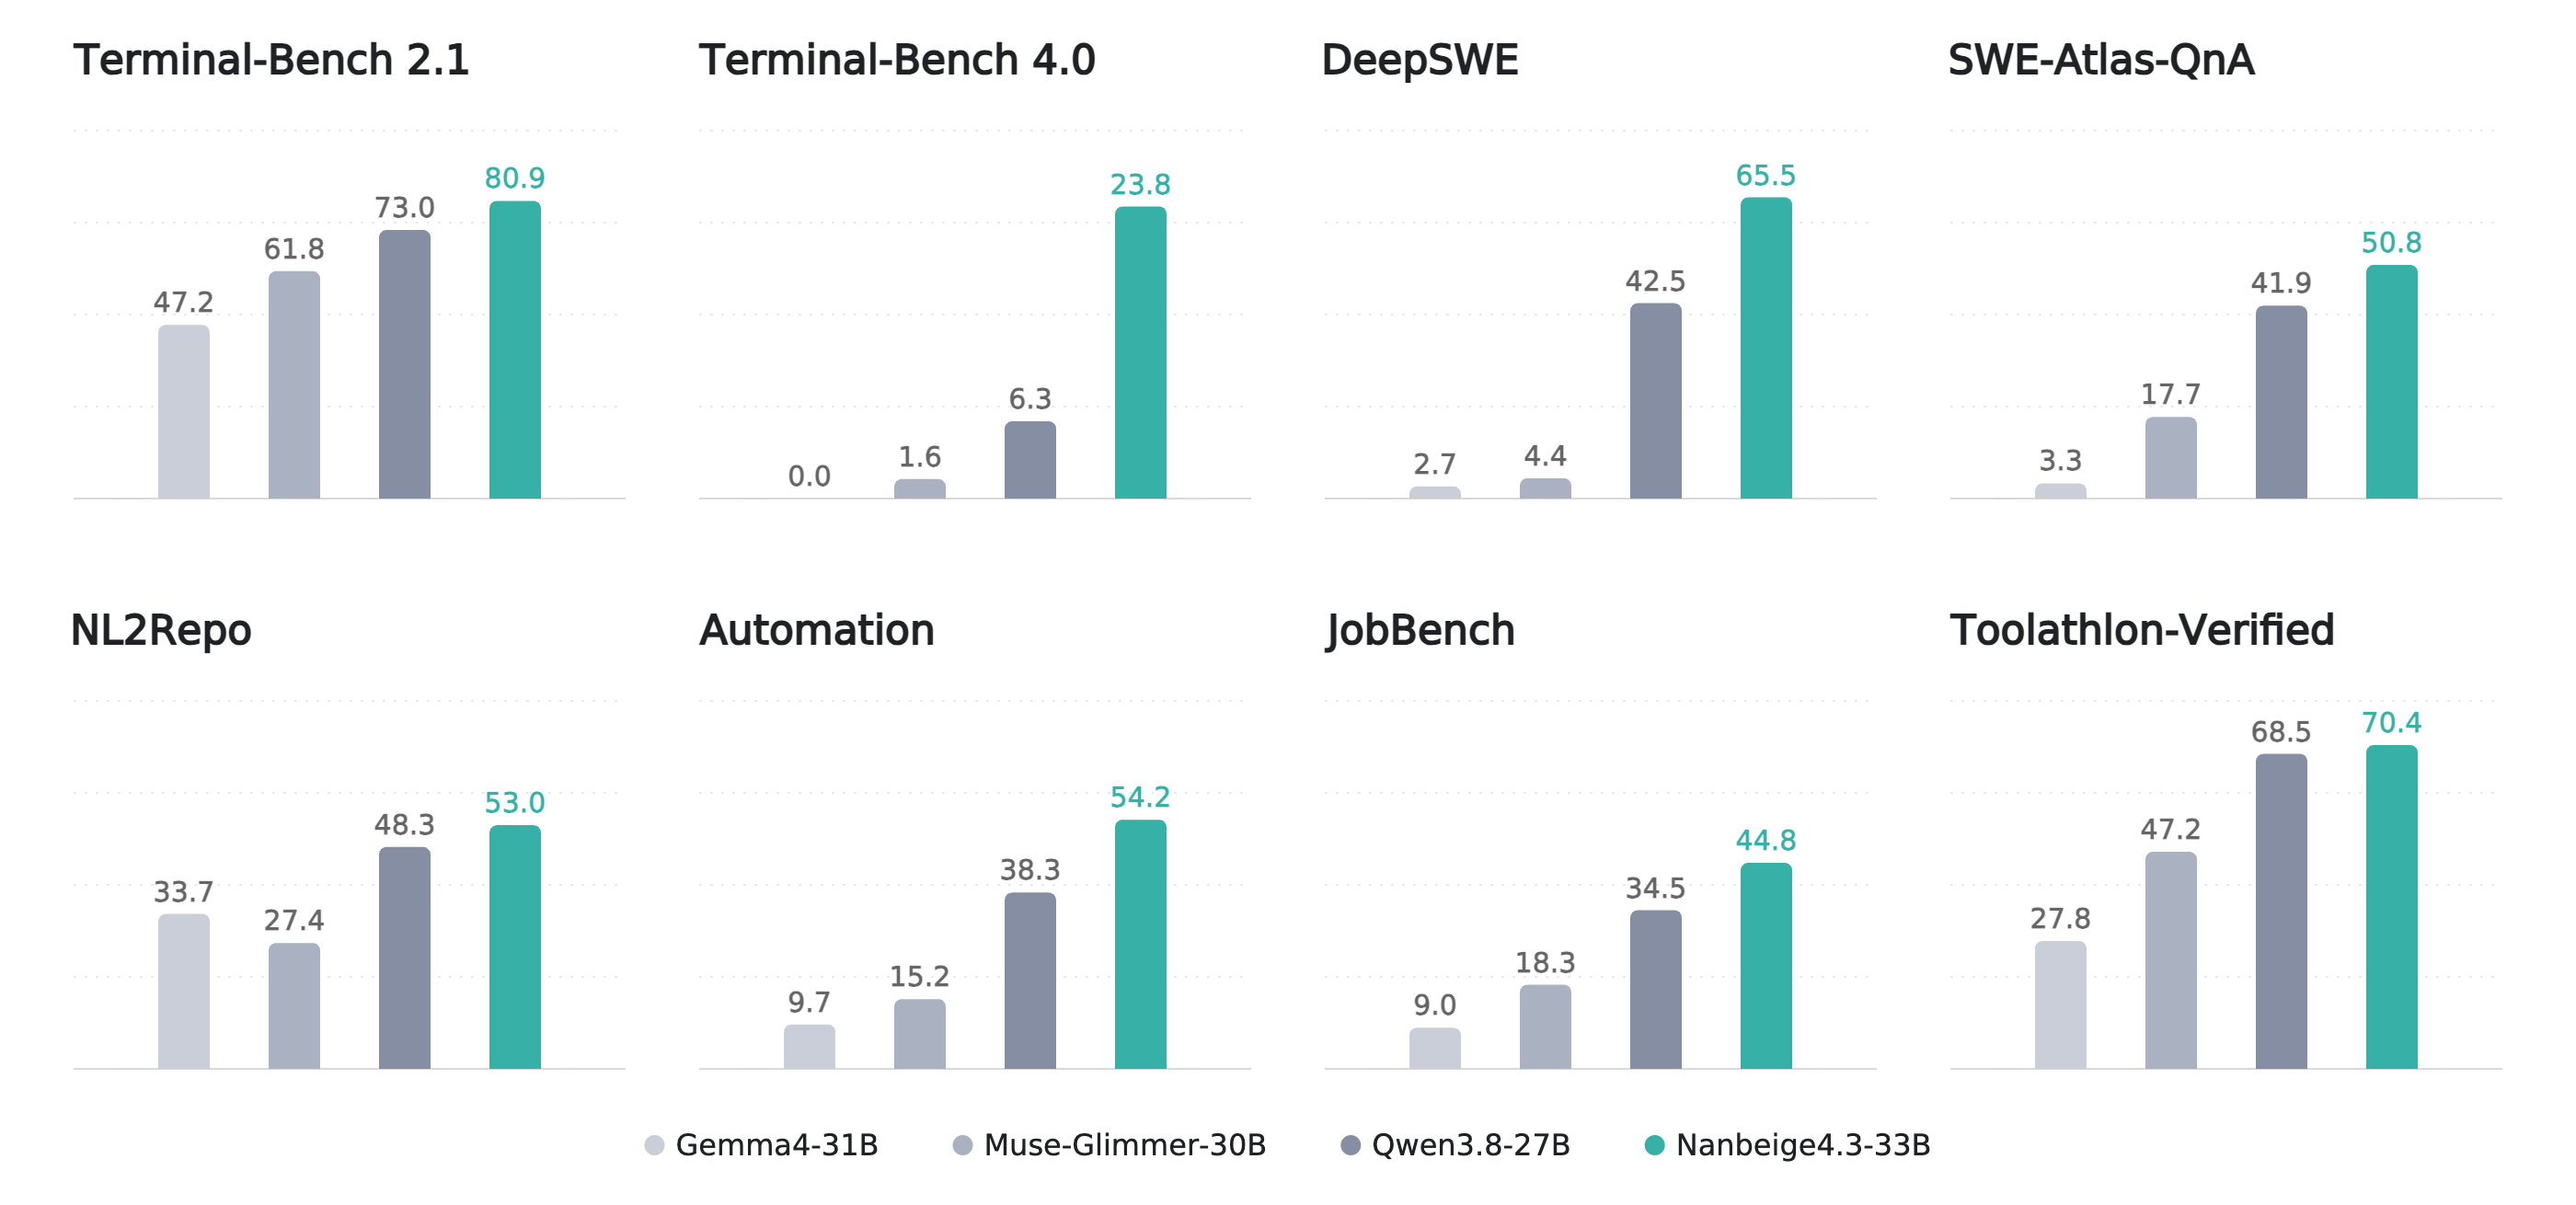
Terminal-Bench 2.1上,Nanbeige4.3-33B拿到80.9,Qwen3.8-27B是73.0。DeepSWE 65.5对42.5,Automation Bench 54.2对38.3,DeepPlanning 63.3对49.2。多数Agent基准上领先,特别是终端操作和软件工程这类任务,差距拉得比较大。
这个模型有一个明确身份:teacher。Nanbeige4.3系列先造一个大模型,再把Agent能力蒸馏到小模型上,官方点名了后续的Nanbeige4.3-3B。也就是说,33B是过渡,3B才是要铺量的终端产品。招聘平台做Agent,场景也很自然:简历筛选、职位匹配、面试调度,都是需要多步工具调用的活。


社区动作很快。GSQ-RCO的GGUF量化已经有人做出来了,单张48GB显存的4090有机会跑起来。Hugging Face上已经挂了50个量化版本。不过质疑也同步出现。有网友表示,这个分数太猛,得自己拉下来跑跑再信。有网友指出架构还是老llama那一套,全注意力没有线性层,推理成本和KV开销都高,长上下文本地跑不动。还有人在等3B蒸馏版,觉得33B不是最终答案。
模型卡里有一张详细的Benchmark表格,官方也注明了各基准用的harness,比如NL2Repo用的是Claude Code,JobBench也接了Claude Code的harness。这意味着分数不能简单横向对比,不同任务的评测环境并不一致。实际Agent能力如何,还得部署起来看。
一个招聘平台开源一个33B的Agent底座,这件事本身就有点反常识。但仔细想,Agent模型和数据、场景绑定更深,BOSS直聘手里恰好有大量真实职场任务数据。下一步看3B蒸馏版能保留多少Agent能力,那才是决定这个系列有没有存在感的关键。
压力给到Qwen4。开源社区又多了一个可以跑的Agent底座,而且单卡可及。Nanbeige4.3-33B到底行不行,跑过的人说了算。
发布时间: 2026-10-26 12:50