招聘软件发了个33B开源模型,Terminal-Bench分数压过Qwen 27B,但先别急着换
BOSS直聘研究团队Nanbeige发布Nanbeige4.3-33B,多项Agent基准超过Qwen3.8-27B,SWE-Bench Pro和GDPval仍落后。512K上下文在24GB卡上只剩约10K,网友等着第三方复跑。
一个招聘软件的研究团队,发了个33B的开源模型。
BOSS直聘旗下的Nanbeige发布了Nanbeige4.3-33B,权重放在Hugging Face,Apache 2.0。Thom Wolf在X上给了个容易记住的类比:BOSS直聘像WhatsApp加LinkedIn。现在这个组合里长出一个模型团队,交出的东西在多项Agent基准上压过Qwen3.8-27B。
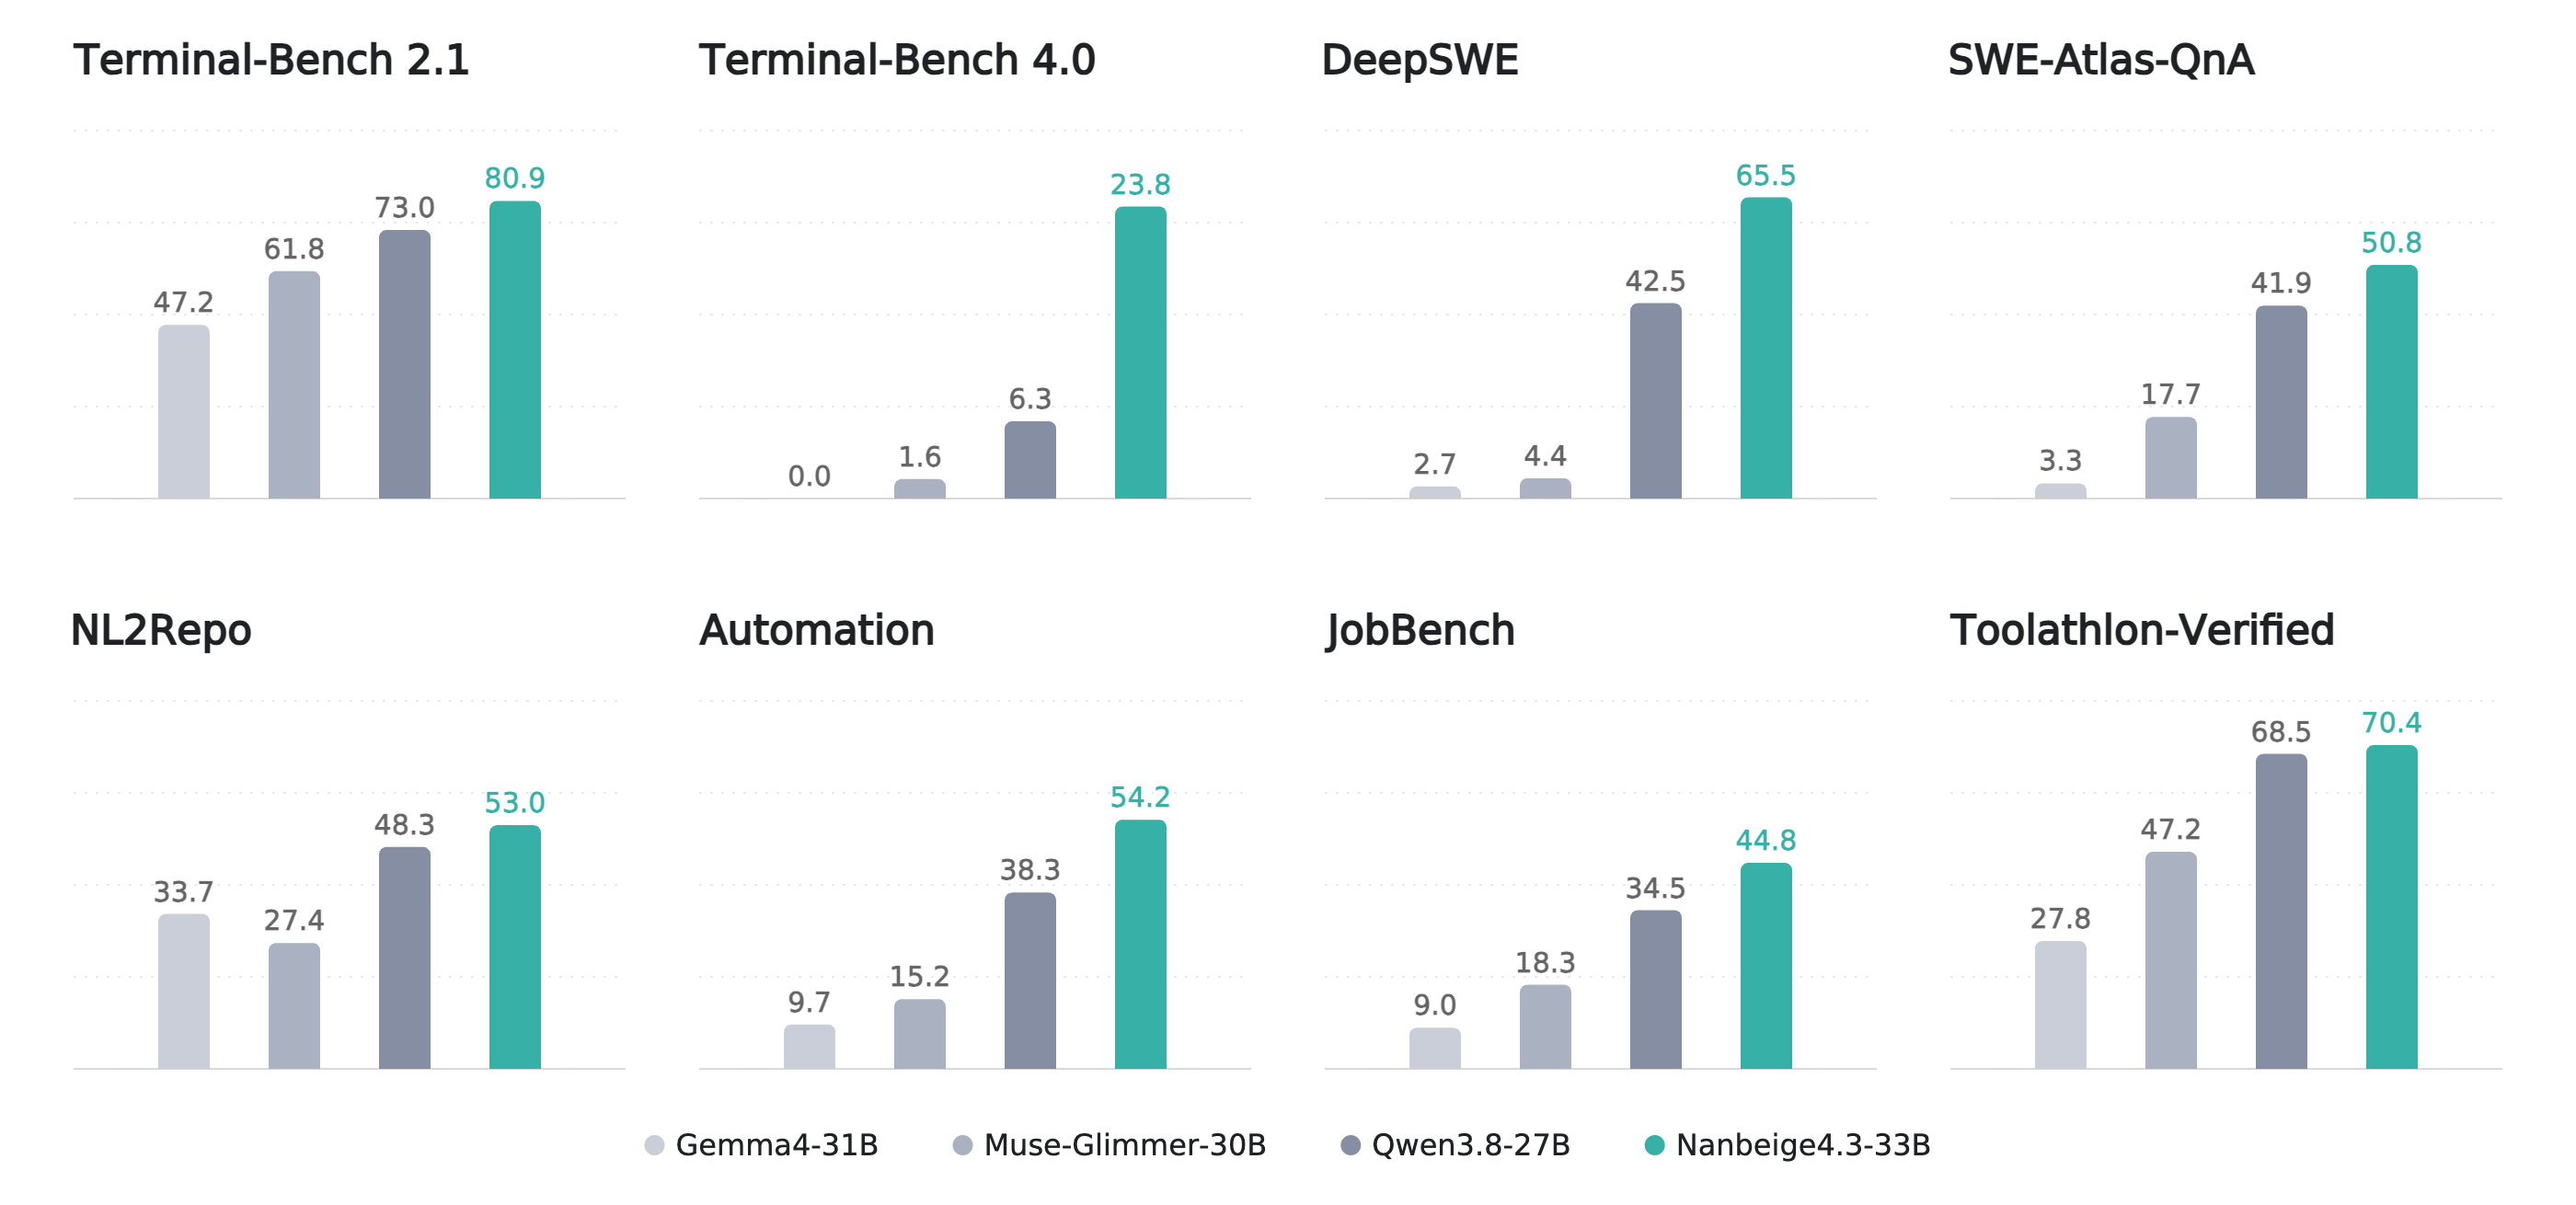
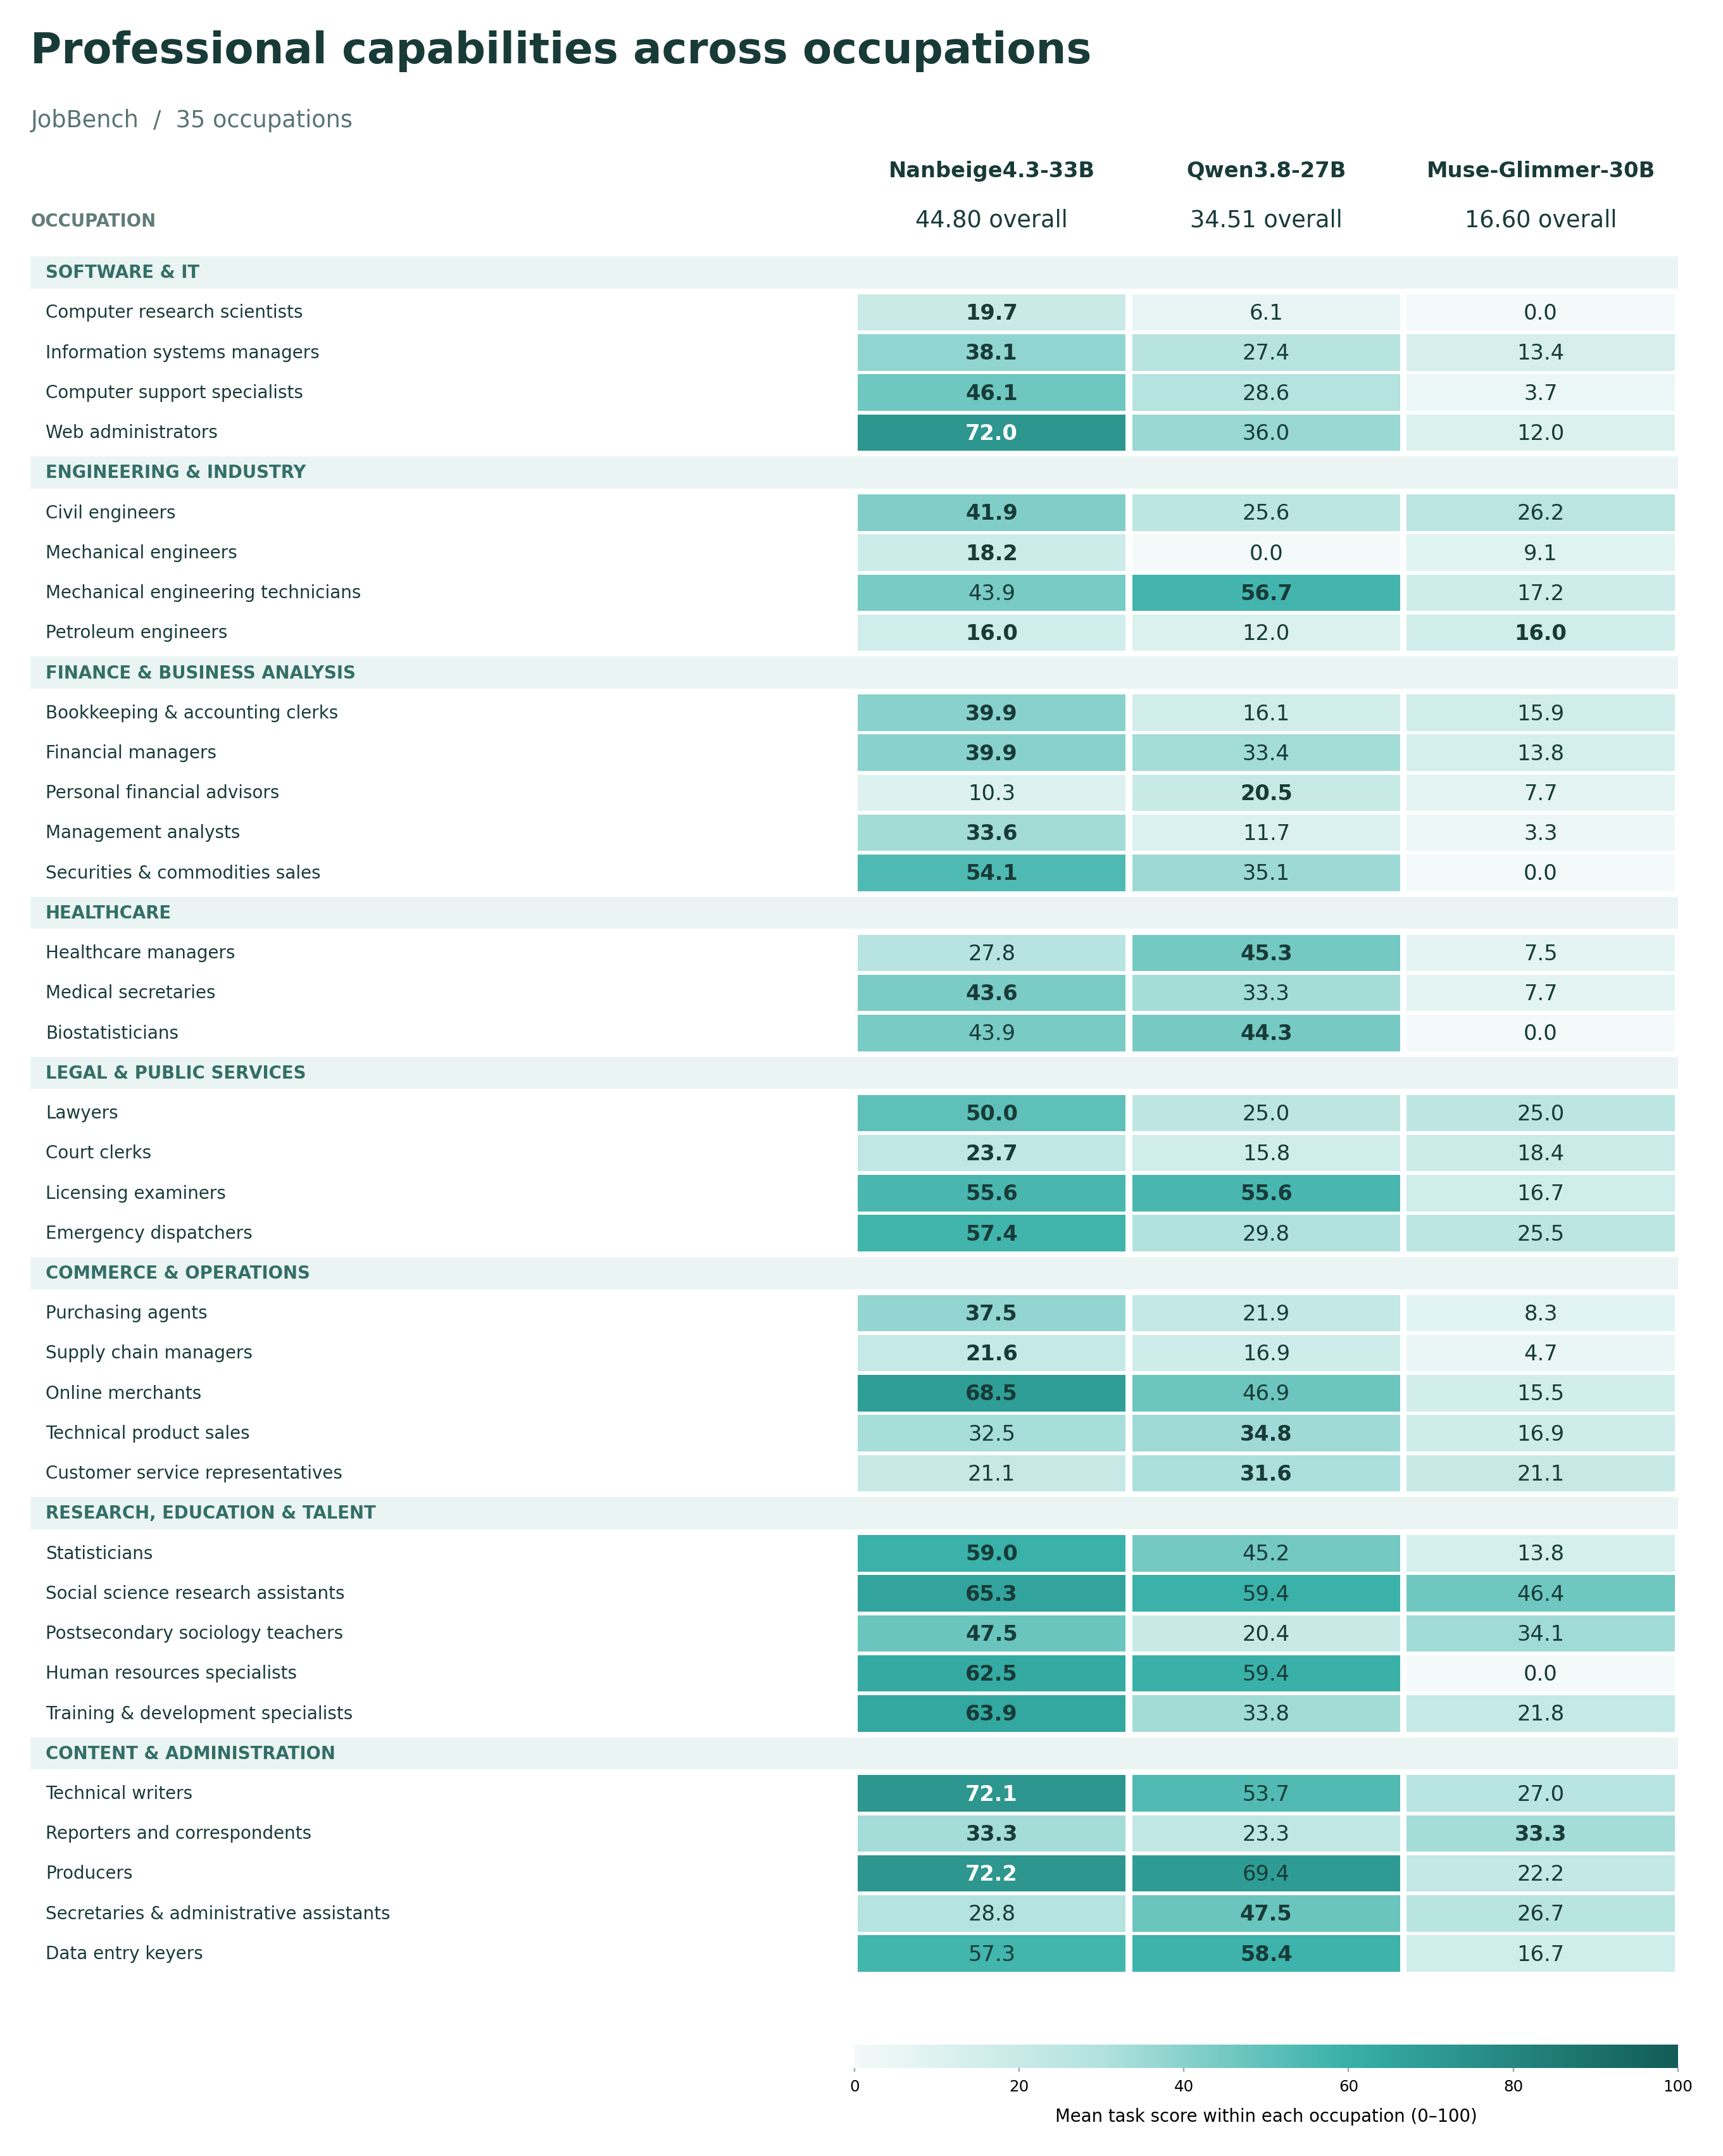
先看分数。Terminal-Bench 2.1,Nanbeige4.3-33B是80.9,Qwen3.8-27B是73.0。Terminal-Bench 4.0,23.8对6.3。DeepSWE,65.5对42.5。Automation Bench,54.2对38.3。JobBench,44.8对34.5。YC-bench报$1,025,437,Qwen是$641,290。

但表格是实验室自己跑的。Nanbeige这边用了preserve_thinking=true,Qwen在SWE-Bench Pro和GDPval仍然领先,60.3对61.7,84.8对86.4。所以Thom Wolf写“most”是准确的,不是全部。网友Michał Piszczek也提醒了这一点。网友Greg Glazewski盯着DeepSWE的差距,说等第三方复跑。
Nanbeige的路子绕了一步:先把teacher做扎实,再蒸馏小模型。33B是旗舰老师,后面要带出Nanbeige4.3-3B。模型卡里写得很清楚,先推高小Agent的性能天花板。
工程细节也有看点。模型支持524,288 tokens上下文,约512K。chat template里,enable_thinking默认开,preserve_thinking在多轮工具、办公、代码Agent里建议开,普通聊天问答建议关。传tools会启用工具模板,工具调用推荐xml格式,json也兼容。推理参数分两套:Agent和工具任务温度1.0,top_p 0.95,最大新token 65,536;推理和聊天温度0.6,top_p 0.95,最大新token 262,144。Transformers、SGLang、vLLM都能跑。
512K听着爽,本地不一定爽。网友Reza Harirchian算了一笔账:dense llama结构,52层,8个KV head,fp16下KV cache约213KB每token。跑满512K,光KV就约110GB。Q4_K_M权重约21GB,24GB卡大概只剩10K上下文。模型是好模型,只是别把512K当成家用配置。
评论区有人直接甩表情包:
也有人把Qwen4 27B搬出来玩梗:
有人问量化,有人排队WikiBench,有人担心没有长期记录的实验室模型会不会藏后门。Ricardo Dias给了另一个角度:招聘网站发好模型,本身就是招聘广告,会下载33B的人,正好是它想招的ML研究员。
模型卡在这里:Nanbeige4.3-33B,Base版在Nanbeige4.3-33B-Base。原始讨论来自Thom Wolf和Nanbeige公告。
发布时间: 2026-10-26 20:33