AI自己检查自己:5个开源仓库,把幻觉和错误压下去
从Self-Refine到DeepEval,5个开源项目让LLM自我反思和自动化评估,省掉人工校对,把AI输出质量控制在流程里。
让AI自己检查自己,听起来像绕口令,实际上是一类正在快速成型的方法。传统流程里,LLM输出后靠人工验证;这类工具把验证交给模型自己,通过迭代反馈、自我反思、自动化评估,把幻觉和错误压下去。
The Roundtable Show在X上整理了5个开源仓库,覆盖自我修正和外部评估两条路线。有网友看完感叹,Reflexion躺在清单里很久了还没试。
Self-Refine:让模型反复挑自己的毛病
Self-Refine来自2023年一篇同名论文,核心流程简单:先生成一个草稿,然后让同一个模型对草稿输出反馈,再根据反馈改进,循环往复。不需要额外训练,也不需要更大模型。适合文本生成、代码可读性提升这类任务。项目自带动画演示,能直观看到迭代过程。
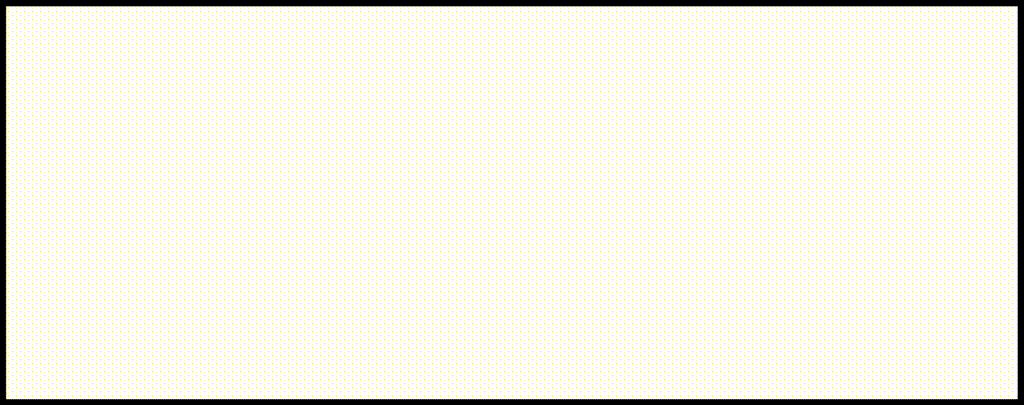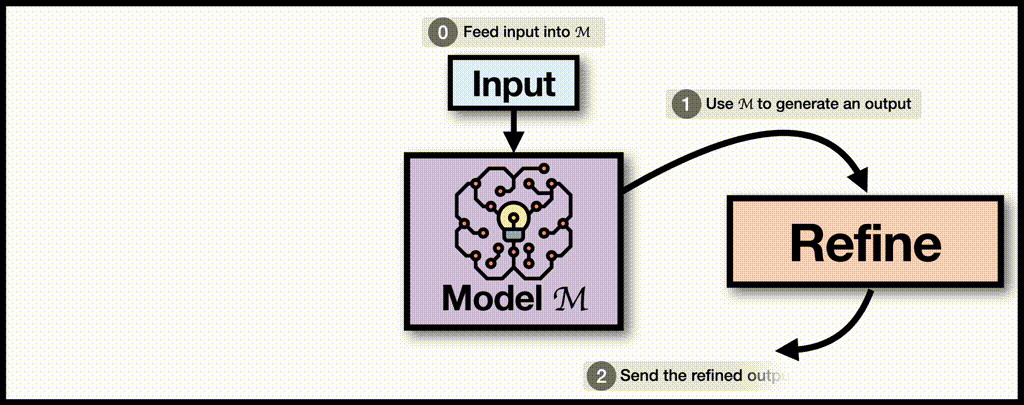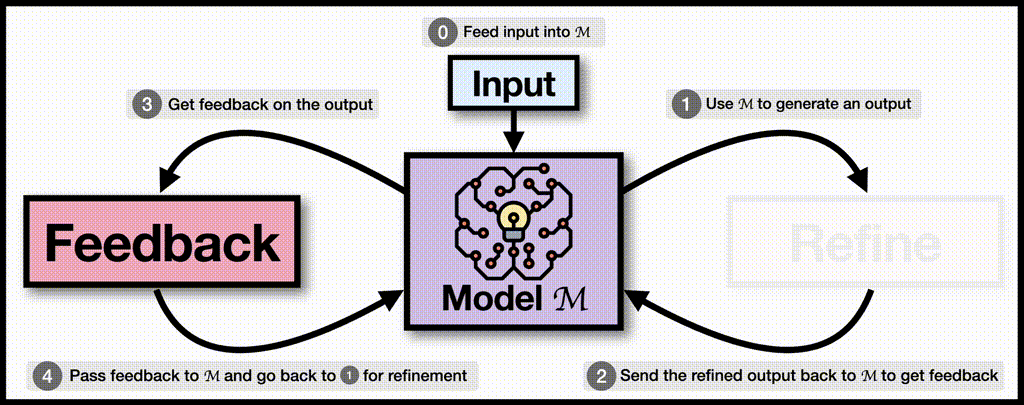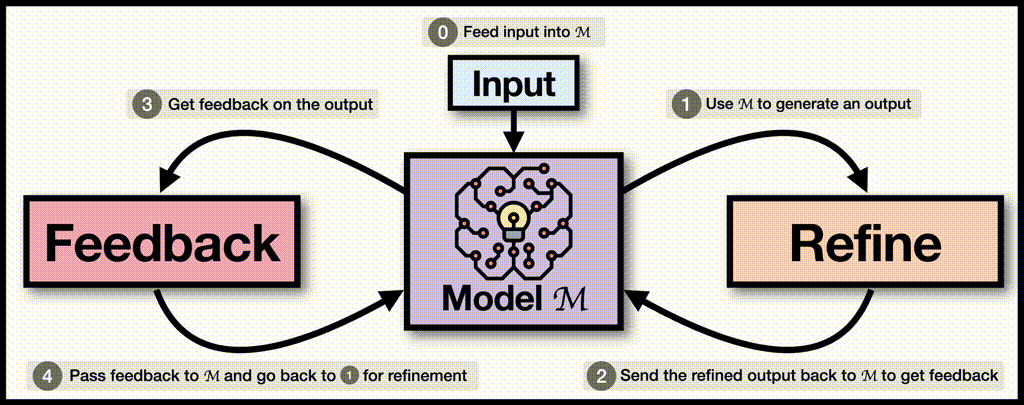
仓库地址:https://github.com/madaan/self-refine
Reflexion:用语言做强化学习
Reflexion是NeurIPS 2023论文,思路是让agent在失败后写下反思,并把反思作为文本存进记忆,下次尝试前先回顾。相当于把强化学习的价值信号换成自然语言反馈。论文在HotPotQA、AlfWorld、LeetcodeHardGym等任务上验证过。对于编程和推理场景,这个模式很有用。

仓库地址:https://github.com/noahshinn/reflexion
DeepEval:像Pytest一样测LLM
DeepEval是个开源评估框架,定位类似Pytest,但针对LLM应用。内置G-Eval、幻觉检测、答案相关性等指标,支持RAG、AI Agent、多轮对话、语音代理等场景。可以在本地运行,也能接入CI/CD。官方快速上手:定义测试用例,设置指标,跑deepeval test run,搞定。

仓库地址:https://github.com/confident-ai/deepeval
另外两个:Promptfoo 和 Inspect AI
Promptfoo偏重提示词的回归测试(https://github.com/promptfoo/promptfoo)。Inspect AI由英国政府BEIS团队维护,用于模型能力与安全评估(https://github.com/UKGovernmentBEIS/inspect_ai)。它们和前面几个一样,都是把AI的输出到底靠不靠谱这件事,变成可自动化的流程。
这五个仓库从不同角度切入:有的让模型自我反思,有的从外部打分。共同点是不再默认模型输出是对的,而是把验证环节系统化。如果你在调试Agent或RAG,值得逐个看一眼。
发布时间: 2026-10-27 03:56