OCRia-1:4B 模型在复杂表格解析上拿到 92.9,评论区问的却是这些问题
LlamaIndex 发布 4B 文档解析模型 OCRia-1,多个表格 benchmark 刷新 SOTA,已上线 LlamaParse。模型主打复杂表格、图表和格式保留,但开发者更关心合并单元格、跨页表格和置信度输出。
PDF 里最难的往往不是文字,是表格。嵌套表头、合并单元格、没有边框、一页塞满几十列,大多数解析模型在这些场景下会悄悄错位,而且不报错。下游拿到的数据是错的。LlamaIndex 今天发布的 OCRia-1,目标就是这些表格。
OCRia-1 是一个 4B 参数的视觉语言模型,官方称在准确率、成本、延迟三个维度都达到 SOTA。它已经上线 LlamaParse,全部解析模式都由它驱动,价格不变。
Jerry Liu 在 X 上贴出的分数:ParseBench 整体 87.4,领先第二名 12.1 分;表格单项 91.5。ParseBench 是业内常用的文档解析测试集,主要衡量文本、表格、图表、格式的还原度。第三方评测中,olmOCR-bench 整体 83.5,表格 92.9;PulseBench-Tab 84.1;fr-bench-pdf2md 长表 83.2。三个都排在对比模型前面。对比模型包括 LightOnOCR-3、Chandra-OCR 2、Mistral OCR 4.1,以及更大的 7B 模型。
表格之外,它还处理图表和排版。官方说它能将无标签的图表转成 HTML 表格,保留数值与标签的对应关系;上标、下标、删除线、复选框都能保留,数学公式输出为 LaTeX。ParseBench 图表单项 85.1,比第二名高 19 分;格式单项 83.4,高 15.5 分。
训练数据包括 10 万+ 文档页面,有人工标注和生成式标注,再用 SFT + RLVR 做后训练。官方没有公开更多细节。
评论区里,开发者问得最多的是:合并单元格在输出里保持原样还是被拍平;跨页表格会不会断;能不能拿到 cell 坐标。一个做检索的开发者说,一个合并单元格读错会悄悄污染整个检索结果。准确率再高一个点,不如每个 cell 给一个置信度分数。另一个开发者提到,报告说权重版本在计划中,线上版本混用了 NVFP4 和 FP8,NVFP4 原生只跑在 Blackwell 上,RTX 40 和 Mac 用户可能要等 BF16 或 GGUF。这些问题官方还没回应。
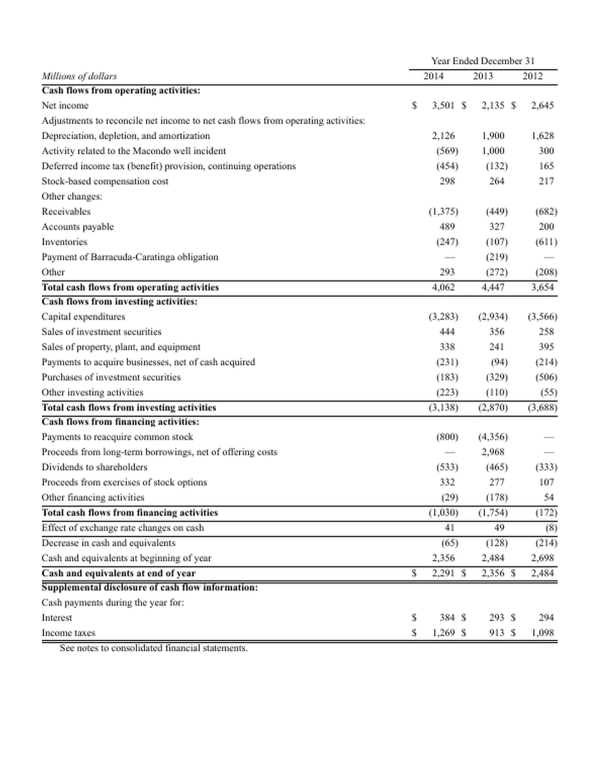
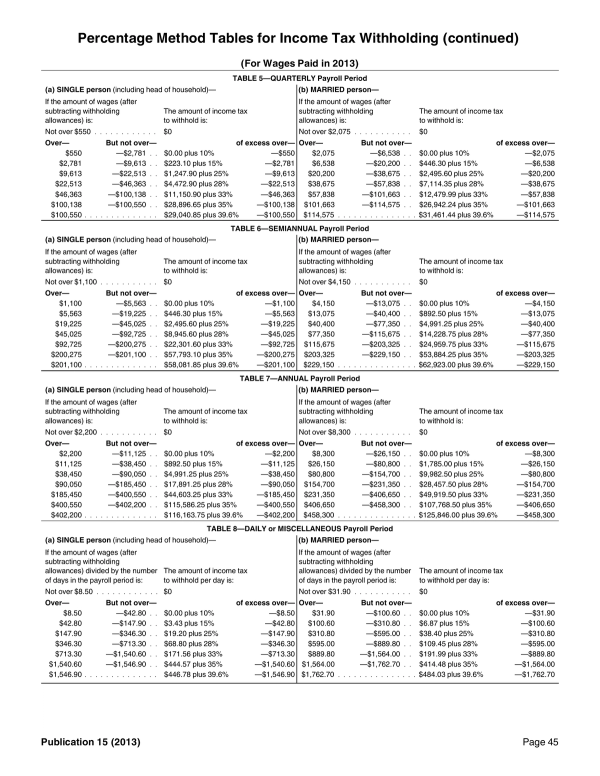
官方放了一段视频,展示 OCRia-1 预测表格单元格时的注意力图变化,播放速度有放慢。下方两张图来自 LlamaIndex 博客,是模型处理过的真实表格:现金流表、工资税预扣表。这类表格就是嵌套表头、合并单元格、无边框的典型样本。
更多细节在 LlamaIndex 博客。
发布时间: 2026-10-28 02:06