AI味可以本地洗了,但检测器先别急着下岗
Abacus.AI 开源 12B 的 Smaug Humanizer,Apache 2.0,能在本地把 AI 文本改得更像人写。它用反向构造数据和 GRPO 保住数字、布局、事实,长文、英文之外和承诺语气仍有坑。
Abacus.AI 把 Smaug Humanizer 的开放权重放上了 Hugging Face。模型 12B,基于 gemma-4-12B,Apache 2.0,直接给了 vLLM、Transformers 和 llama.cpp 的用法。它做的事很直白:输入一段 AI 写的文字,输出同样事实、数字、名字和排版,但语气更像人写的版本。项目页把它叫 humanizer,目标写着 destroy AI-slop,把创造力带回互联网。口号很大,先看实现。

痛点不在 AI 味三个字,在场景。有人把草稿发到云端洗一遍,隐私就多一次暴露。有网友 Mohammad Vazin 提到,humanizer 只有让草稿不离开本机才有意义,小 Gemma 本地跑才是真功能。这个判断比口号实在。Smaug 给 GGUF,Q8_0 能塞进 16GB 显卡,Q4_K_M 能跑在 8GB 显卡或笔记本上。开源权重和本地推理把门槛降下来了。
训练方法值得看。Abacus.AI 从 2021 年或更早的人类文本 h 出发,这些文本确定是人写的。然后让 LLM 把每段重写成自己的风格,得到 AI 文本 x。模型学习反方向:从 x 回到 h。直接这么干有个坑,LLM 改写常常只换几个词,模型会学会轻轻修字。团队用过滤把这种配对丢掉:检查是不是真改写、布局是否一致、事实数字名字引用是否保留。最后留下 3,676 对,在 gemma-4-12B 上训练 LoRA,r=64,alpha=128,2 个 epoch。之后用 GRPO 跑 200 步,组大小 8,奖励让改写靠近人类原文 h、远离 AI 草稿 x,同时用五个确定性门控卡住数字、布局、长度、文字系统和拼写。图里能看到两阶段流程。

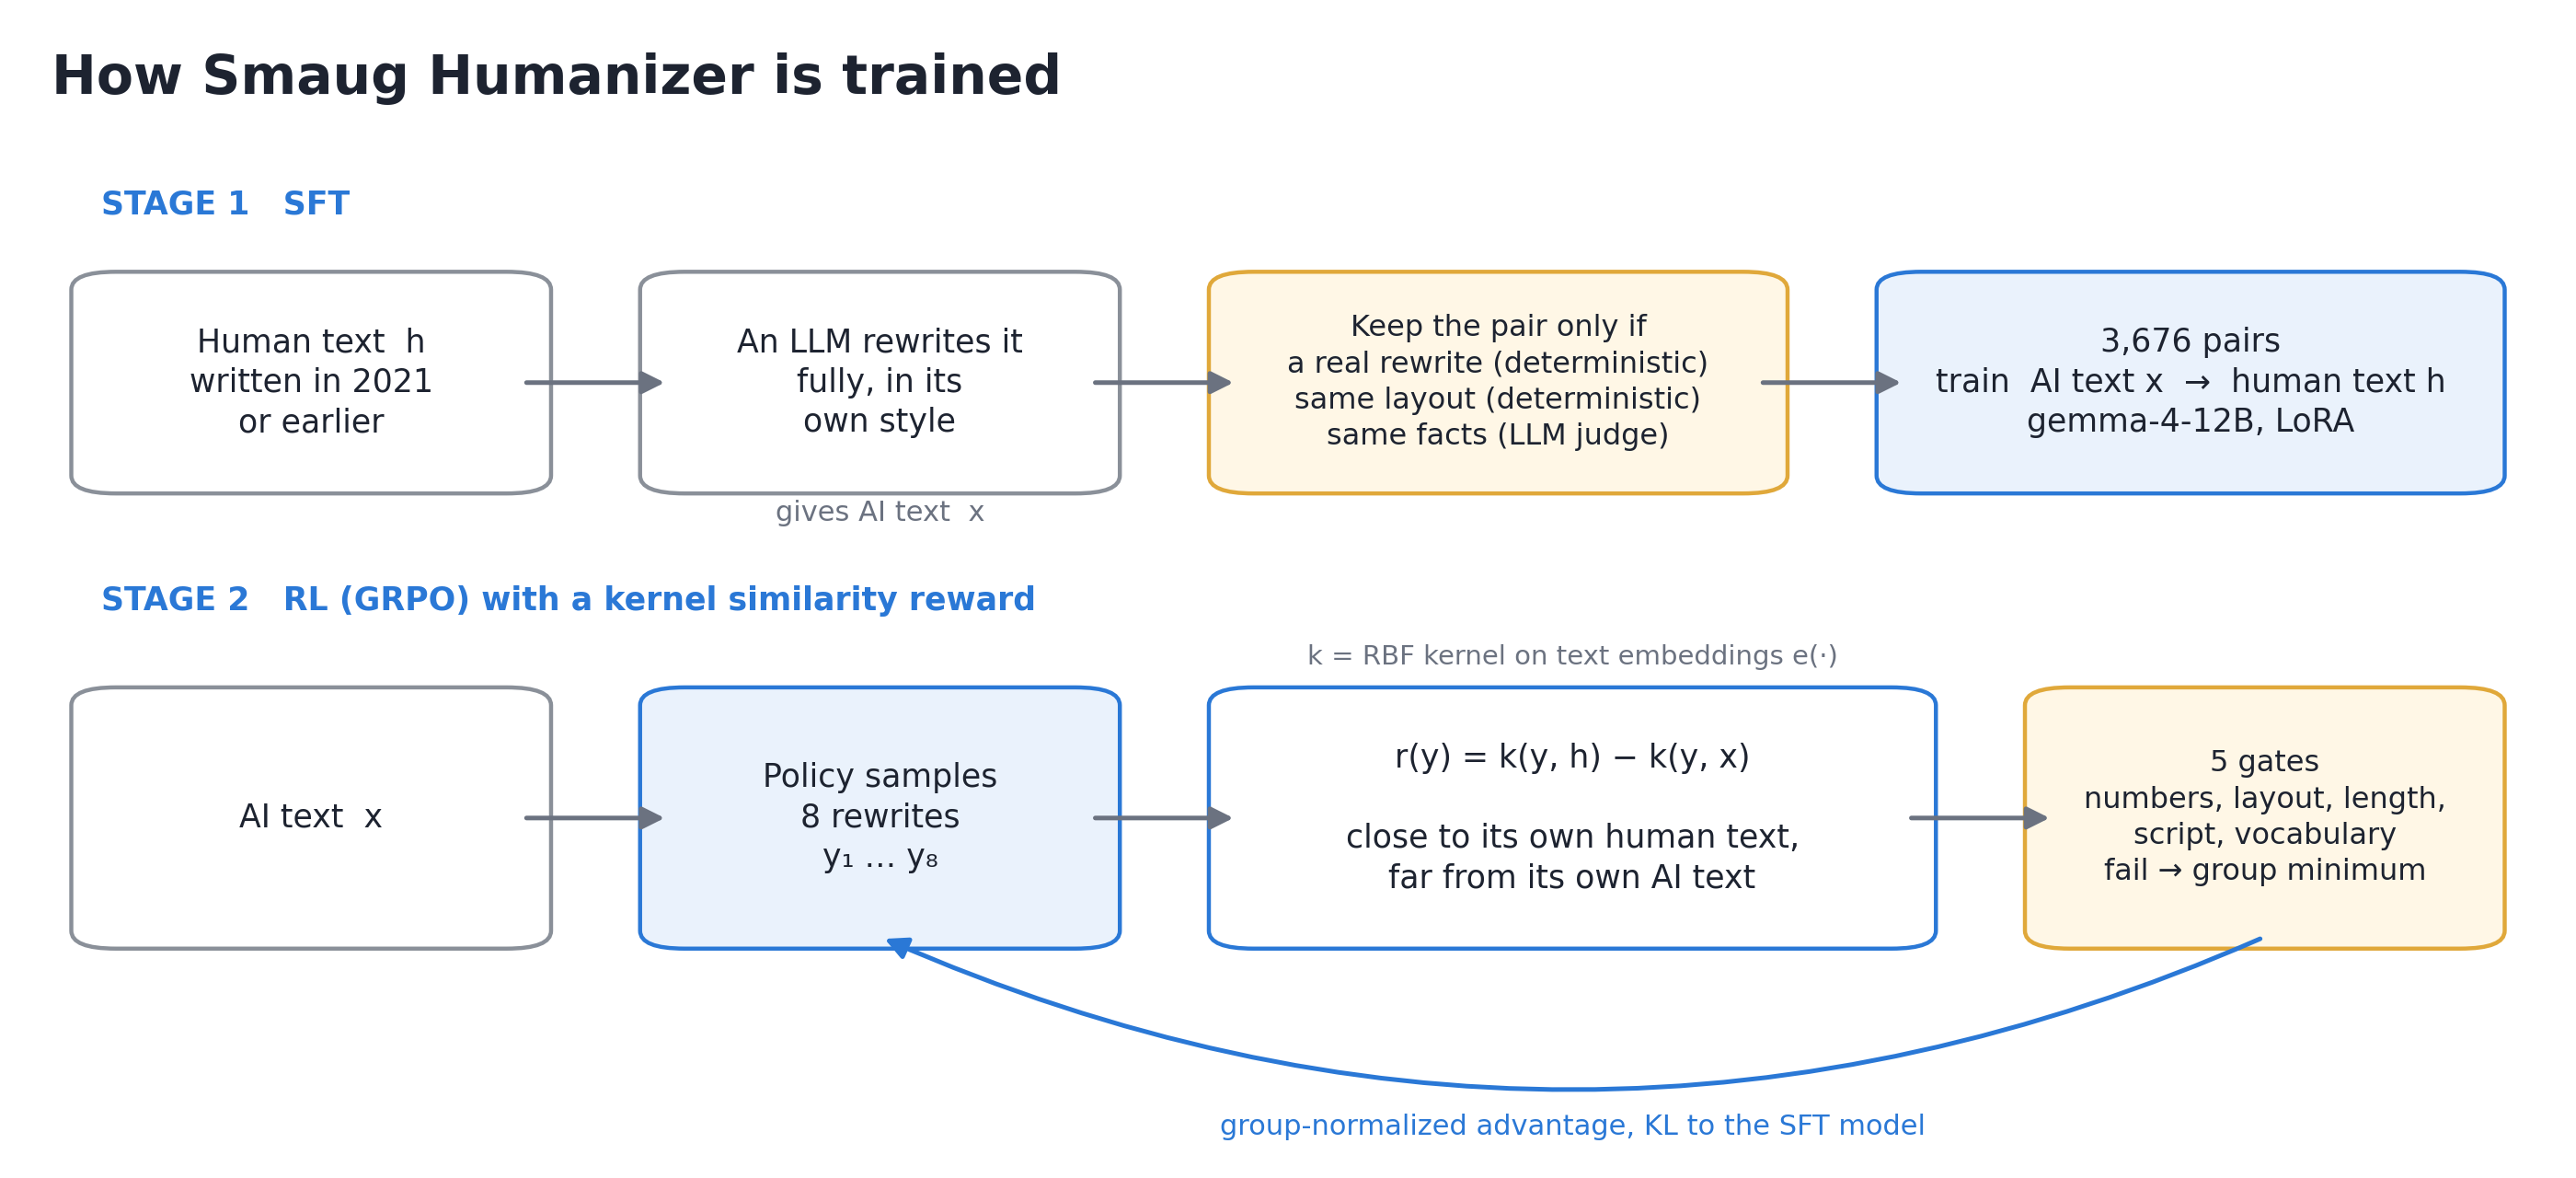
这个奖励设计有个细节。它保护事实,但保护不了承诺强度。有网友 Tevfik Bulent Ongun 举了个例子,We may deliver by Friday 和 We will deliver by Friday 日期一样,读者预期差很远。情态动词和归属需要单独检查。模型卡也提醒,门控覆盖数字和布局,改写仍可能改掉细节,发布前要读。这个提醒不算客套,是使用边界。
评测用了 Pangram 和 LLM judge。官方给出的例子里,地方选举重计、烤面包随笔、月相解释三类输入被 Pangram 判成 100% AI,改写后判成 100% human。图里是烤面包这篇的输入和输出。分数很好看,但不能当成所有文本都过关。模型卡写明长文本更难,主要支持英文,有些改写仍会被检测器标出来。检测器本来就不稳。有网友说,AI 检测器早就像抛硬币,现在免费 humanizer 上了 Hugging Face,学校再拿检测分数挂人,得公开解释依据。这个吐槽有现实感。


另一个容易被忽略的问题是,像人和像你不是一回事。有网友 Jatin Garg 说,匹配人类参考文本可能奖励一种通用人声,保留作者自己的节奏需要单独测。还有网友 Shin 的做法更直接:给模型自己过去写过的帖子,再加一份禁用短语清单,让它起草,比事后 humanizer 有用。事后洗稿能藏掉 slop,加不进真实观点。读者最后记住的是观点和判断,语气只是外层。
怎么用。模型卡给了一段固定提示,要求保留事实、数字、名字、引用、结构和语言,只输出改写文本。推荐采样参数是 temperature 1.0,top_p 0.95,top_k 64,stop 用
发布时间: 2026-10-27 21:39