AI能独立干完一整天活,公司却不敢让它改一条Salesforce记录
METR曲线显示代理任务时长约每7个月翻倍,2022年还是30秒,今天能顶一个工作日。a16z长文里,Databricks CEO Ali Ghodsi说AI没有智力问题,有上下文问题。企业想用代理,得先给它们一套能读、能写、能被验收的系统记录。
METR的曲线被a16z放进了最新文章:自2019年以来,AI代理能独立完成的任务时长,大约每7个月翻一倍。2022年,ChatGPT能处理人类约30秒的编码任务;今天的前沿代理能顶一个熟练工程师一个工作日。图表数据截至2026年5月8日。

同一篇文章里,Databricks CEO Ali Ghodsi给了一个不太客气的注脚:大多数公司仍不愿让AI可靠地更新Salesforce里的记录。
他的判断很短:AI没有智力问题。它有上下文问题。
这句话值得展开。代理要在公司里干活,得知道四件事:哪些数据是真的,这些数据是什么意思,自己有没有权限动,做完之后结果算不算好。这四件事平时藏在数据库、仪表盘、制度文档和资深员工的脑子里。一个销售副总裁知道最大的单子卡住了,因为关键联系人正在悄悄面试别家;也知道某个销售口中的90%其实等于50%。这些信息不在Salesforce字段里,代理再会写代码也读不到。
每7个月翻一倍,卡在一条记录上
Databricks的技术路线像四层叠加,追了将近二十年。2009年,Ali在伯克利看互联网公司用大数据预测点击、购买和观看。Hadoop把计算分散到廉价服务器,但每轮计算都要把结果写回磁盘,机器学习这种反复迭代的负载被拖得很慢。Matei Zaharia写了Spark,让常用数据留在内存里,迭代负载最快提升十倍。2013年,Ali、Matei和几位研究者成立Databricks,把集群、扩缩容、安全这些复杂度包进一个企业平台。
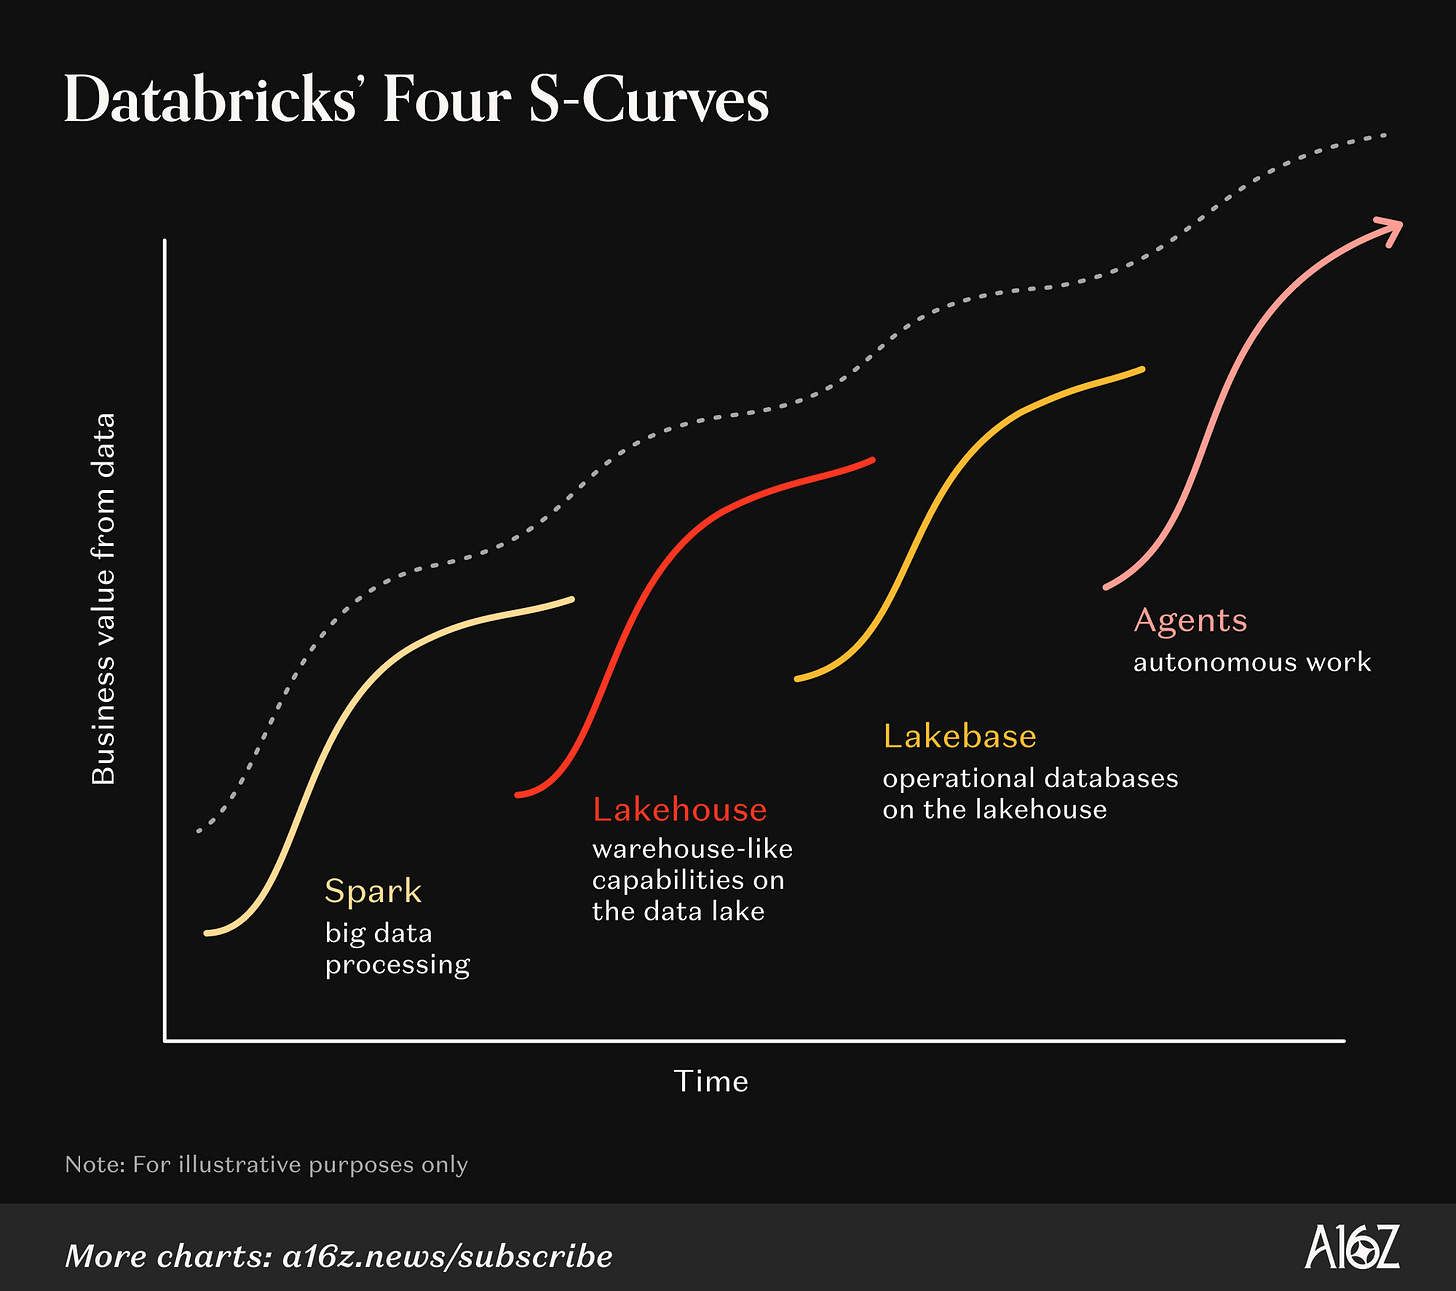
后面两步更贴近今天的代理。2020年的Lakehouse把数据湖的便宜存储和数据仓库的可靠性、查询性能合到一起。2025年收购Neon后,Databricks推出Lakebase,把运营数据库的存储和计算分开,数据库可以像代码一样秒级分支。代理可以开一个隔离分支做实验,用完扔掉。文章称,今天Databricks看到的代理查询比人还多,每天有超过1700万个数据库由代理启动;公司年化收入超过70亿美元,同比增长80%,估值1900亿美元。Lakehouse年化收入超过15亿美元,Lakebase超过1亿美元。
Ali把答案叫面向代理的系统记录,简称SORA。这个说法容易听成营销词,拆开看很具体。代理写入一条记录之前,系统得告诉它:这条记录属于谁,和哪些客户、合同、目标有关,历史上哪些改动出过问题,谁有权批准,改完之后拿什么标准验收。
SORA要回答四个问题
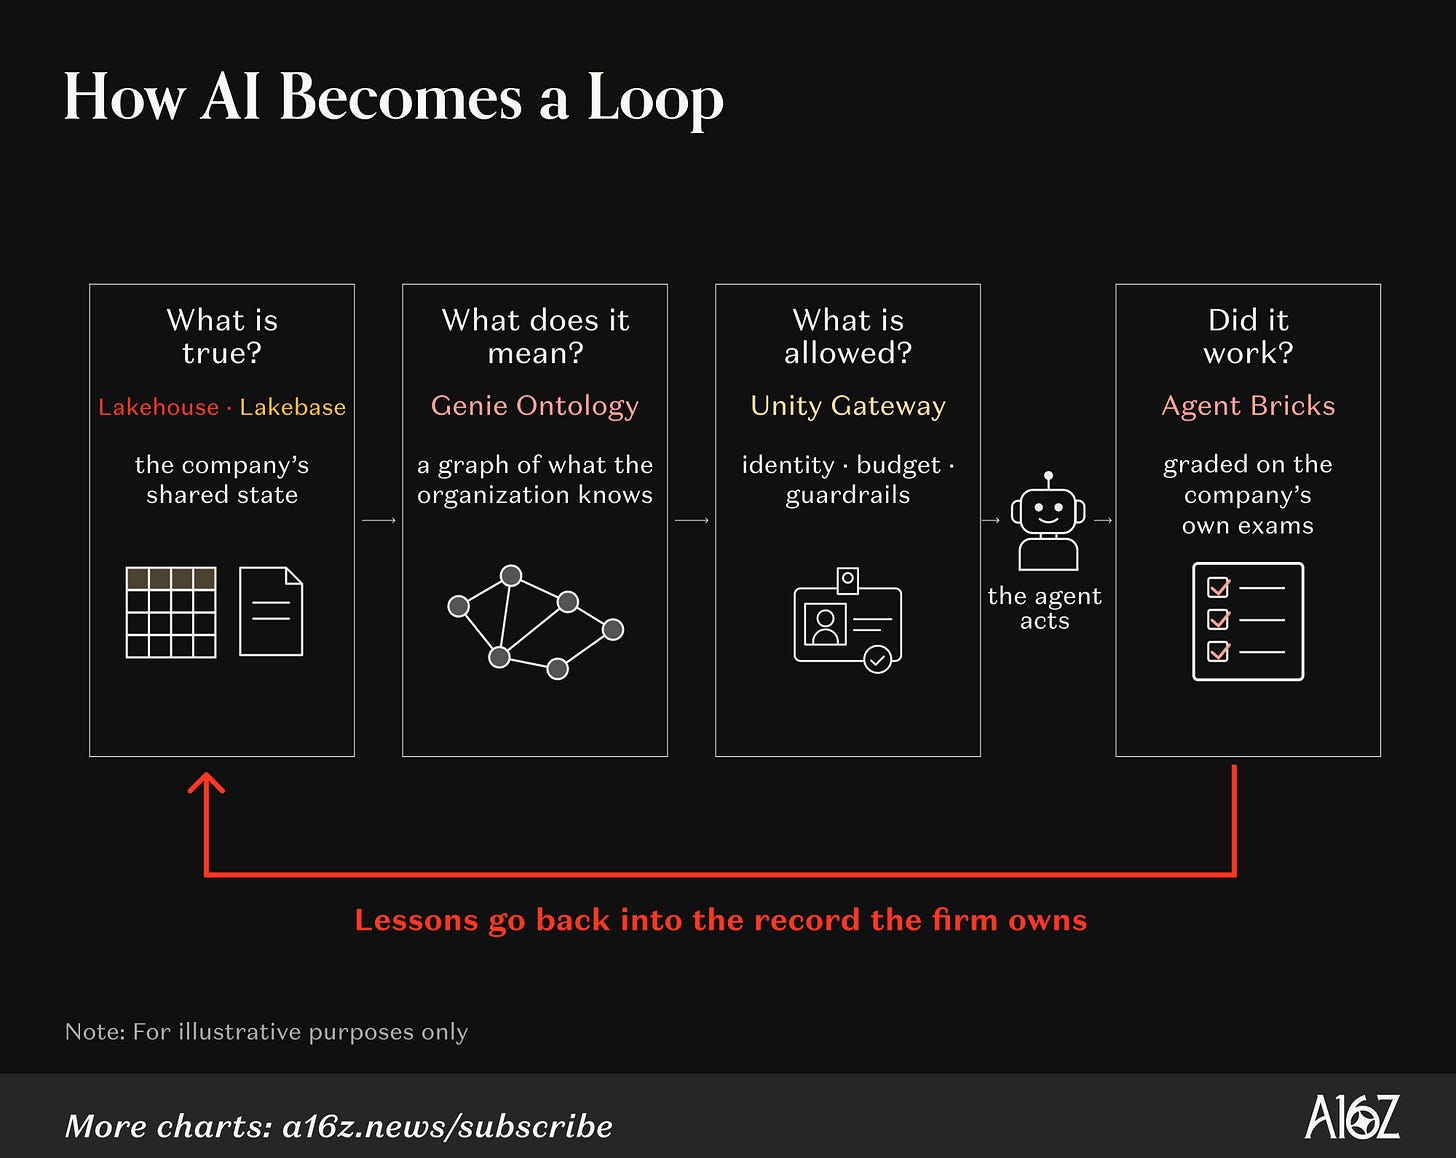
文章把SORA拆成四问。什么是真的,由Lakehouse和Lakebase持有状态。什么意思,Genie Ontology持续构建组织知识图,OntoRank按创建者、使用范围、更新时间等信号给知识排权威。Databricks测试里,把代理接到公司本体上,回答准确率从约50%提到84.5%。什么允许,Unity Gateway给每个模型、代理和AI工具一个身份、预算和护栏,日志记录它们动了什么数据、花了多少钱。是否有效,Genie和Agent Bricks让业务团队和工程团队各自搭代理,也各自写考试,把可接受结果和不能犯的错误定下来,再拿公司标准优化。
文章把镜头拉远到公司本身。Ronald Coase在1937年问,既然市场能通过价格协调,为什么还需要公司。答案落在交易成本:找人、谈判、监督都要花钱。Herbert Simon后来补了一层,共享的计算机记录让分散决策更安全,票务代理不用给每个同事打电话,查记录、卖票、记录变化就行。数据库时代把这条原则扩到整个公司,代理时代会把协调成本再压一轮。
X回复里有网友补了一句:一个代理能完成八小时软件任务,仍没人让它靠近Salesforce字段。另一个网友说,大家把代理当实习生,它们该被当数据库用户。两句话都指向同一件事,能力曲线和验收门不是一条线。代理能跑一整天,不代表公司敢把写权限交出去。上下文会过期,权限会串,错误会累积到流程末端才爆。
Jack Dorsey今年写了从层级到智能,说系统可以维护一份持续更新的业务模型,用模型协调工作。Ali同意方向,但把组织架构和信息流分开。二十年前,要知道公司发生什么,只能沿树状结构问人;现在Genie能回答会上冒出的多数问题。管理层仍要培养人、判断优先级、注意谁不高兴,只是信息路由那部分会被代理接走。
公司得拥有自己的循环
文章里最值得记住的竞争例子是两家银行租同一个前沿模型做信贷决策。第一家发提示词,收答案,记下最终决定。第二家记下哪些事实产生了答案,人工在哪里覆盖,哪些决定后来表现好,哪些失败,再调整政策。一年后更好的模型来了,第二家继承的是定义、权限、评估案例、客户历史和踩过的例外。第一家继承的仍是同一段提示词。
Satya Nadella把这叫人力资本和token资本,循环成为公司的新IP。Jensen Huang说每家公司的业务数据都是金矿。Databricks押的是数据和循环留在公司能控制的系统里。模型可以换,供应商可以换,公司学会的东西不能跟着合同一起消失。
工作形态也在变。文章的判断是,未来岗位未必是人人工程师,更接近人人管理者。工程师现在已经在管理编码代理:圈问题、拆任务、并行委派、审PR,批准一些,打回一些。Novo Nordisk的科学家用Genie问肥胖数据,Rivian的财务分析师生了CFO要的收入仪表盘,供应链分析师生了库存追踪应用。执行变便宜,判断的需求反而上升。
结尾回到那条Salesforce记录。有网友说,半数Salesforce记录在代理碰之前就是错的。这个吐槽不好笑,它解释了为什么写权限难开。代理要值得信任,系统记录得先是真的。等记录能回答什么真实、什么意思、谁允许、有没有效,代理才不只是能写一天代码的演示,而是公司里能接活的员工。
发布时间: 2026-10-28 20:48