只传一个 ID,特征自动到位:Snowflake 的实时反欺诈推理方案
训练和推理阶段的特征不一致,是 ML 系统上线后效果打折的常见原因。Snowflake 的新教程展示了一套方案:把 Feature Store 与推理服务集成,外部调用方只需传一个 ID,特征查找自动完成。
训练时表现很好的模型,上线后效果打折。问题常常不在模型本身,而在特征:训练用的特征和推理时喂给模型的特征,来自不同的代码路径和数据源,稍有出入,预测就偏了。这个坑叫 training-serving skew。
Snowflake 官方发了一个快速上手教程(Build Real-Time ML Inference with Feature Store),展示怎么用 Online Feature Store 配合推理服务,把这条链路走通。搭建的是一个实时反欺诈系统:外部客户端提交一笔交易的 ID,在线模型服务自动从特征存储取特征,跑 XGBoost 分类器,返回欺诈预测结果。
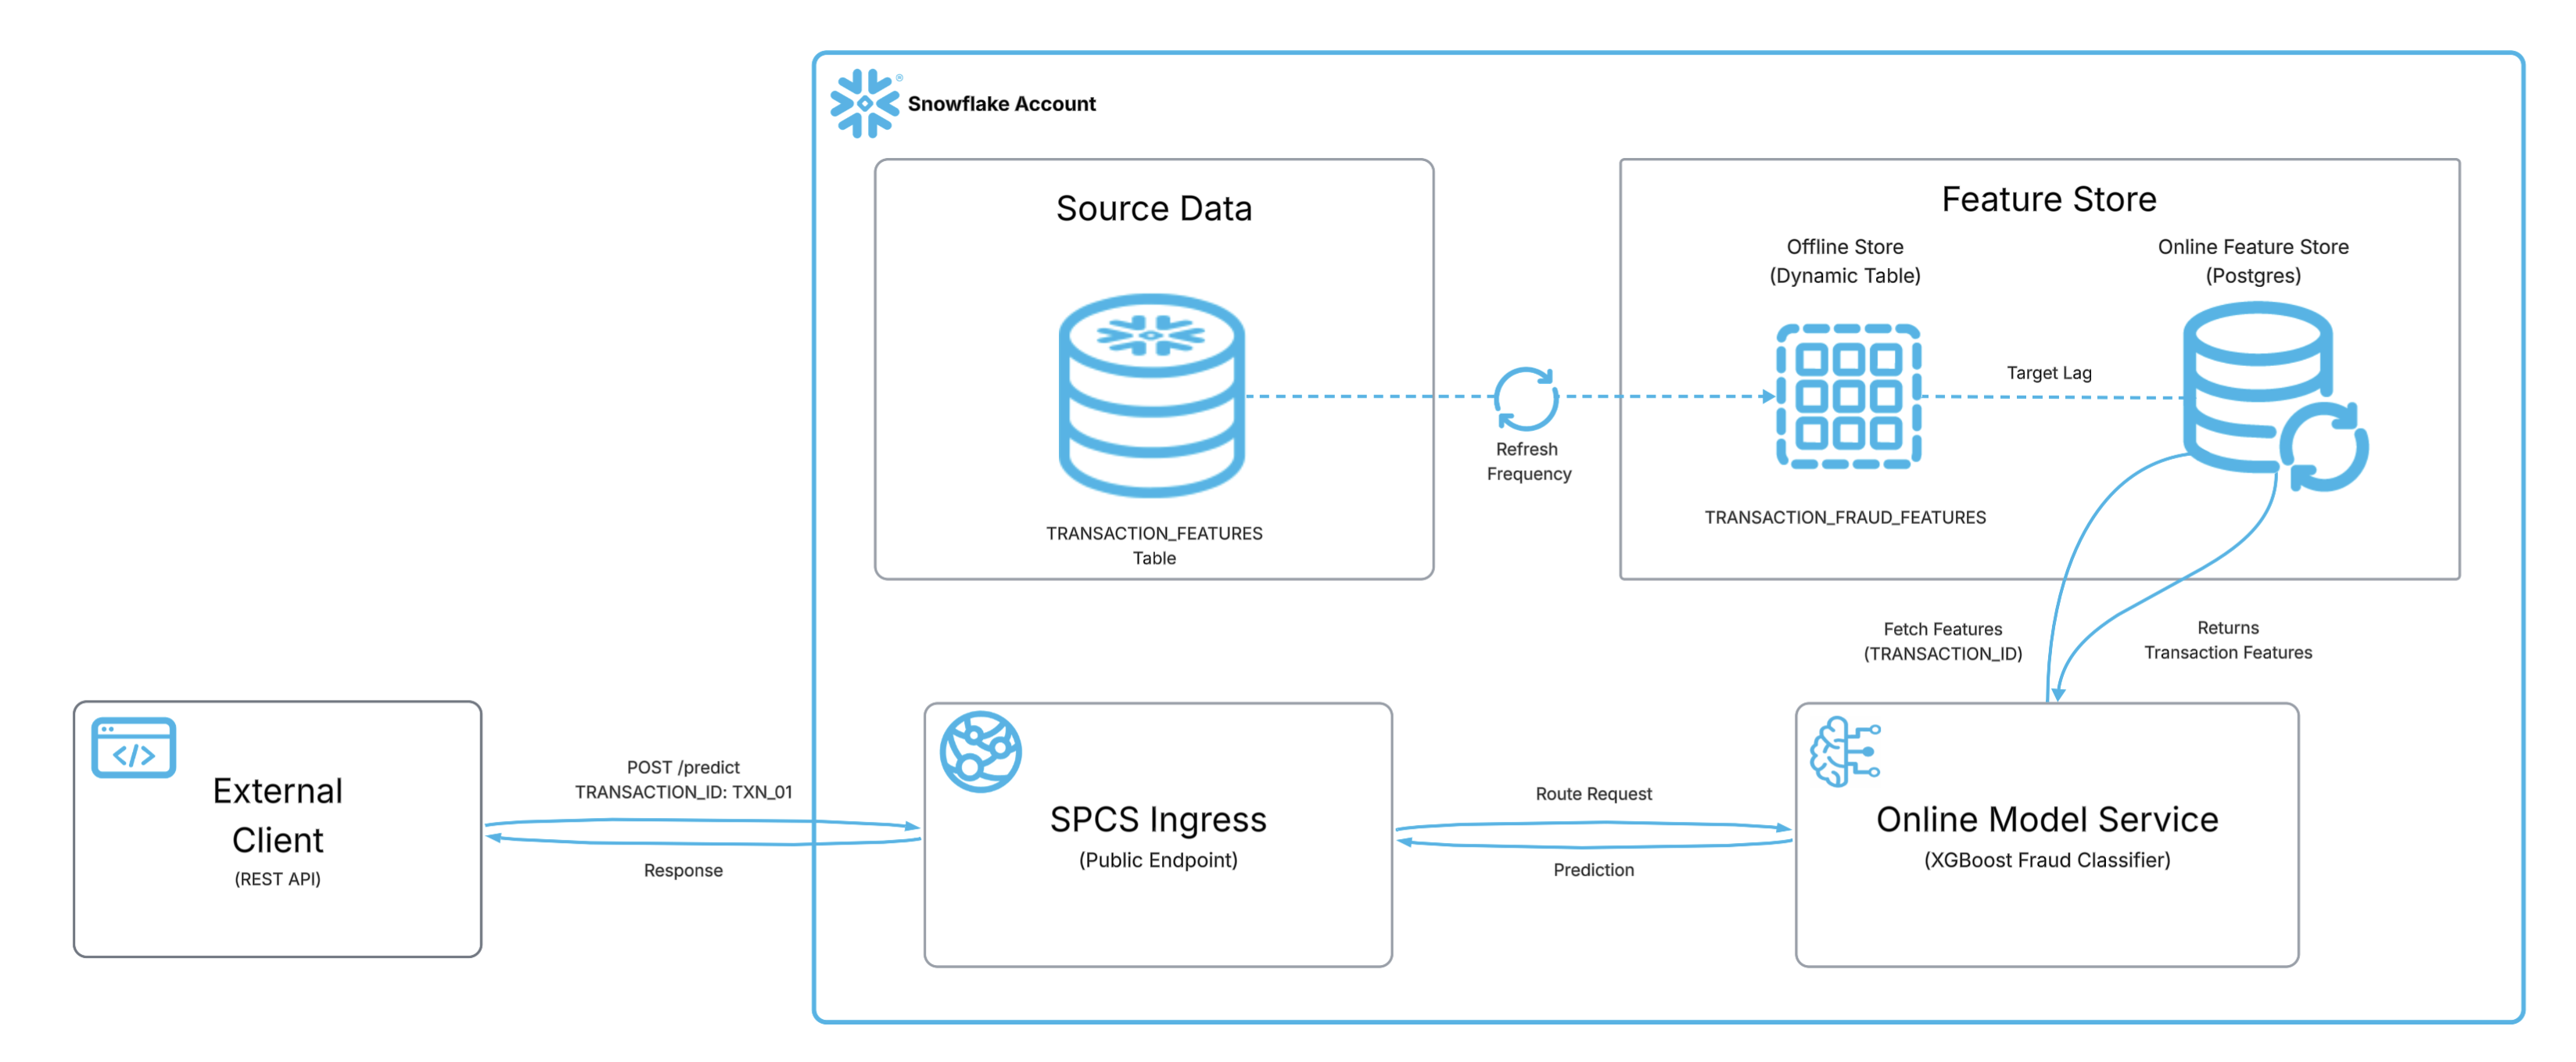
整个流程:源数据表 TRANSACTION_FEATURES 按配置的刷新频率和目标延迟(教程里 10 秒)同步到 Postgres 在线特征存储。外部客户端调用 POST /predict,只带一个 TRANSACTION_ID,SPCS Ingress 把请求路由到在线模型服务,服务从特征存储取特征,跑 XGBoost,把预测结果返回给调用方。

关键在部署时的 feature_sources_per_function 参数。把 predict 方法映射到 Feature View 上,服务就自动具备特征查找能力。调用方不需要知道模型依赖哪些特征,不需要在请求里拼特征,只传实体键。网关拦截请求后,从在线特征存储取回交易金额、商户类别、距家距离、上次交易时长、当日交易笔数这些特征,再把完整 payload 转发给模型容器。
这个设计有两个直接好处。一是特征契约简化:模型依赖的特征变了,只要 Feature View 还在同步,API 不用改,调用方不用动。二是特征新鲜度可控:10 秒目标延迟,源表数据更新后在线存储很快跟上。
技术底子是 Snowflake 的 Postgres-backed Online Feature Store,模型服务部署在 Snowpark Container Services 上。认证用 Programmatic Access Token,外部客户端直接 curl REST endpoint 就能调用。
一个细节:Python SDK 的 mv.run() 和 SQL service function 不走网关,不会触发特征补全。这个能力是给外部实时推理客户端用的,Web 应用、微服务、移动后端这类场景。
教程从环境准备、生成合成数据、注册 Entity 和 Feature View、训练 XGBoost、注册模型、创建计算池、部署服务到调用 endpoint,一步步都有代码。被 training-serving skew 困扰的团队,可以照着跑一遍。
发布时间: 2026-10-28 05:05