SGLang在DeepInfer的主场赢了几个点,评论区先问起了基线
SGLang用DeepInfer自己的基准测DeepSeek-V4.1-Flash,prefill最高1.04倍,decode step最多短7.4%,还把commit、启动脚本和压测客户端一起公开。评论区没急着庆祝,先问基线是哪条曲线。
SGLang 发了一条两分钟视频和一篇技术博客,说自己用 DeepInfer 自己的基准测 DeepSeek-V4.1-Flash,prefill 和 decode 都追上了 DeepInfer,部分点还略高。它给出的数:4 卡 GB300 和 4 卡 B300 上,prefill 吞吐最高 1.04 倍;64 卡 GB300 上,decode 每步时间最多短 7.4%。8 请求/GPU 时两边基本持平,SGLang 的 step 长约 0.4%。
这句话的关键在“DeepInfer 自己的基准”。SGLang 没有只对着 DeepSeek 公开的 Pareto 图喊话。复现 gist 里放了 commit、包版本、启动脚本和压测客户端,DeepInfer 也在同一台机器上跑。技术博客写得更细:prefill 对比取 DeepInfer 每个测试点最快的配置,包括 host memory 和 GPU memory 两种 Engram 放置;decode 用 16 节点 64 卡,DP64/EP64,128K 上下文,每卡固定请求数,3 个 draft token,固定长度验证,接受长度按 3.25 模拟。

这也是评论区先问基线的原因。有网友问,SGLang 是自己跑了 DeepInfer 的整套栈,还是拿公开数字比。Yusuf Sadek 指出,SGLang 实测的 DeepInfer 在 4 卡 B300 的 4K 和 8K 点已经比 DeepSeek 公开曲线高约 9%,如果按 README 的公开数,4K 点的 1.04 倍会变成接近 1.13 倍。SGLang 选了更强的基线,数字没那么炸,但口径更硬。跑分新闻最容易变成阵营口号,这次至少脚本能点开。
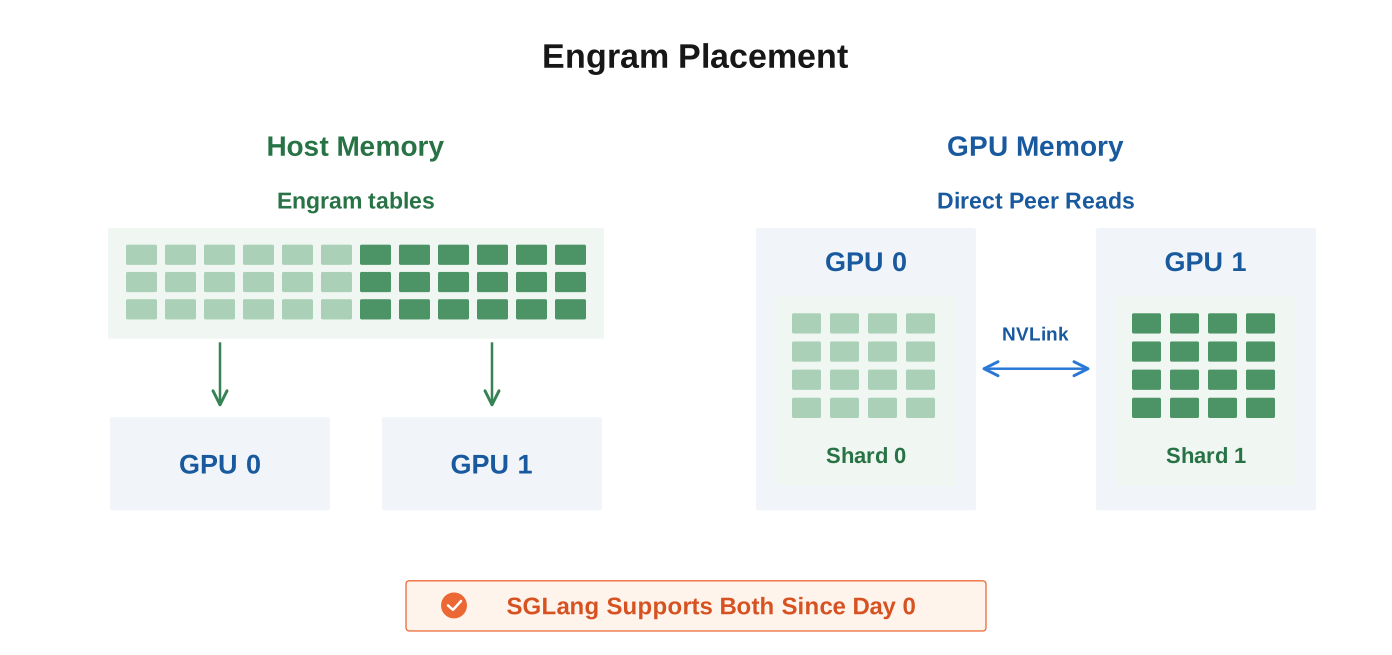
集成的东西比数字更有意思。SGLang 把 DeepSeek 的 FlashMLA、DeepGEMM、DeepEP、DeepSelect、TileLang kernel 接进来,还有 Mega 系列:MegaAttention、MegaMoE、MegaGate、Mega-mHC。MegaMoE 把 token dispatch、专家 GEMM 和 combine 融进一个 kernel。MegaAttention 在 B300 和 GB300 上成了默认注意力路径。DSpark 投机解码、SWA bounded replay、Engram 的 host memory 和 peer shards 两种放置也都在。
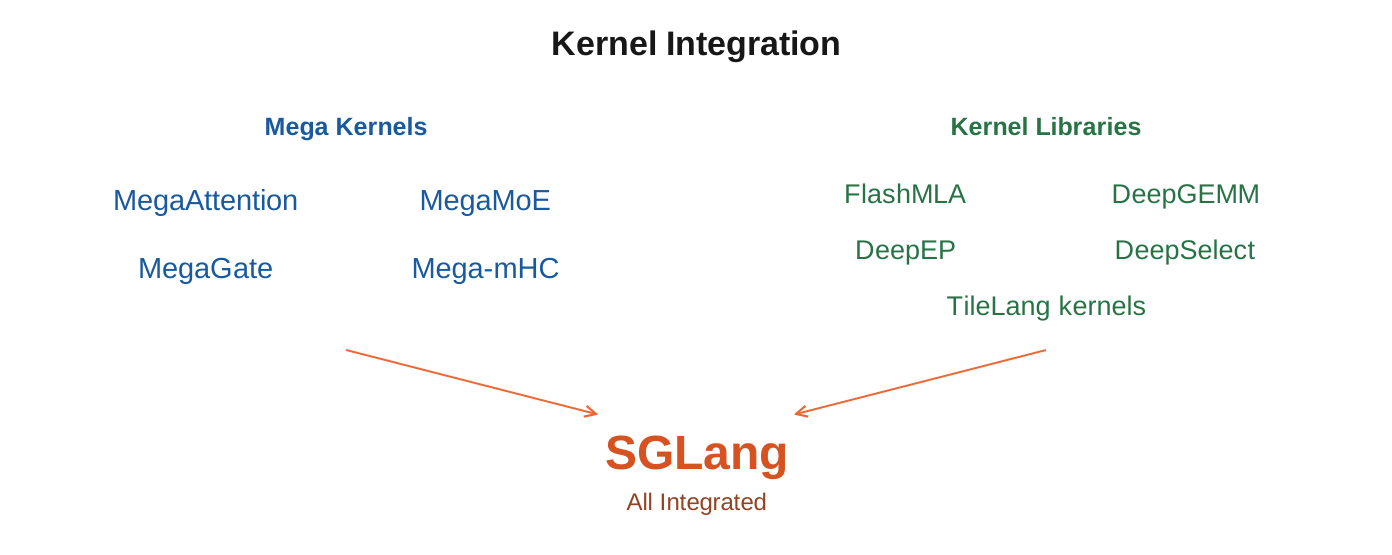
这些名字对普通读者不友好,可以只看结果:SGLang 想说明自己不只是能跑这个模型,还把 DeepSeek 在 DeepInfer 里做的低层优化搬进了通用推理框架。技术博客里列了具体做法,比如 Mega-mHC 直接喂给 MegaMoE,attention 输出 MXFP8 给输出投影,prefill 压缩器和请求窗口 KV 拷贝用融合 kernel,减少中间内存流量和 kernel 启动次数。Breakable CUDA graph 覆盖每 GPU 最多 8K token 的 prefill step。Decoder replay 用单独图,按 bounded suffix 大小跑。
另一个差异是服务栈。DeepInfer 的 README 列了完整推理服务需要但这次发布没包含的三块:KV cache 系统、prefill/decode 分离、跨副本负载均衡。SGLang 说这三块它都有。KV cache 用统一 radix cache 跨请求和对话轮次复用,图里用 Linker 把本地 L1 GPU cache 接到共享 L3 存储,比如 3FS 或 Mooncake。PD 分离支持 Mooncake、NIXL、MORI 做 KV 传输。模型网关按副本分发请求,也能按缓存前缀路由。
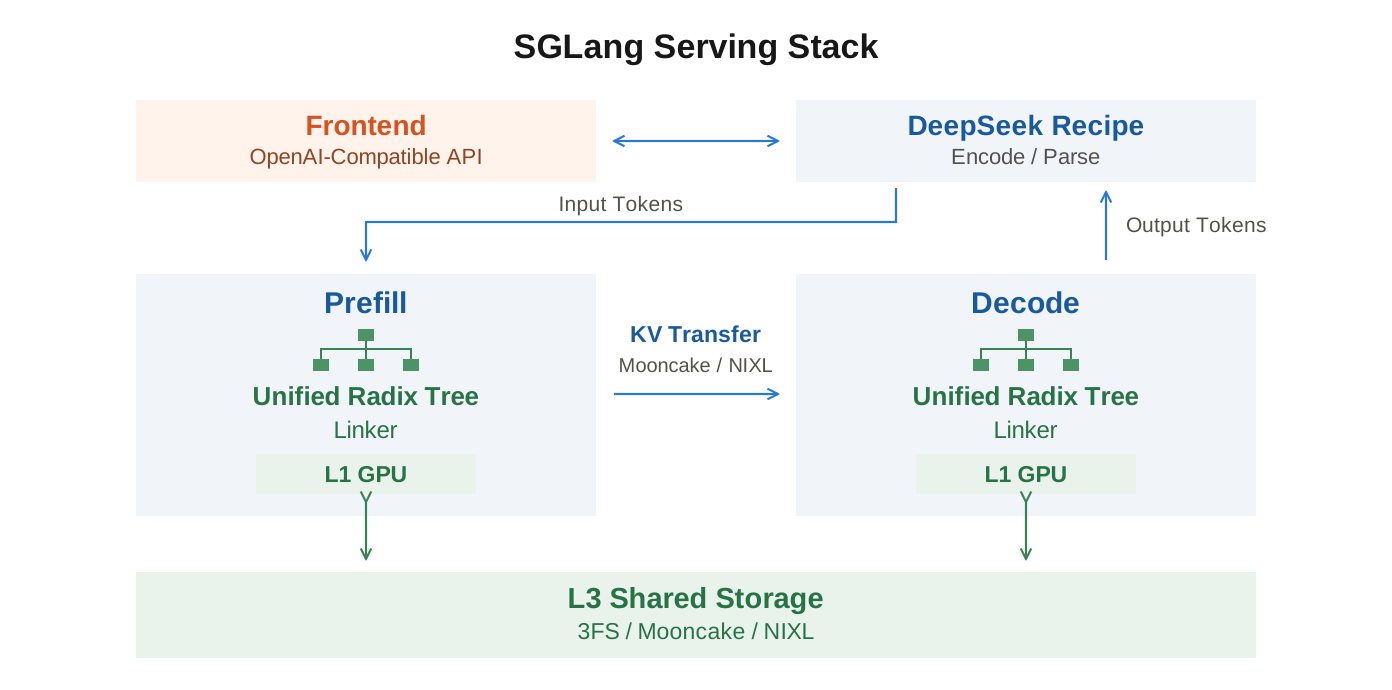
这听着像产品介绍,但对上线的人比 Pareto 图上的最高点实在。跑分决定你能不能进候选名单,KV cache、PD 分离、路由和 API 解析决定你能不能把它放进生产。SGLang 还强调自己支持 NVIDIA GB300、B300、B200、H200 和 AMD MI355X,带 reasoning 和 tool call 解析。
复现设置里有些边界要看清。prefill 用 4 GPU,DP4/EP4,131,072 token 上下文,其中 4,096 token 不走缓存,32 个冗余专家,MoE 路由强制均衡,EPLB 关闭。decode 用 64 GPU,共享 126,976 token 前缀,每 rank 固定 N 个请求,3 个 draft token,静态验证,每步都验完整个 draft block,吞吐换算按每步接受 3.25 token。技术博客明确说,均衡路由这些设置是为了对齐 DeepInfer 的对比,不是生产建议。真要部署,应该看 cookbook 里的默认配置。
评论区还有一些更接近实际使用的问题。Dot 说,公开复现配置比单报峰值有用,但更想看混合长短请求、固定首 token 或单 token 延迟目标时的吞吐,以及缓存命中率变化后的表现。Julien Neo 问 1K 到 2K 的短 prefill,这在 agent 场景里更常见。Qua Ph.D. 问为什么在 InferenceX 上 SGLang 还是比 vLLM 慢。Behnam 贴了 RTX 6000 Pro 双卡、Qwen 3.8 Flash Next FP8 的 TTFT 图,说 SGLang 速度似乎每次更新都在降。这些声音不影响这次对比的有效性,但说明单点跑分和生产体感之间还有一段路。
还有一个项目值得放在旁边看。Chenxi Ma 做了 mini-DeepInfer,从约 2K 行 PyTorch 推理引擎开始,在 4 张 B200 上逐步重建 FlashMLA、DeepGEMM、DeepEP。公开结果里,prefill 从 1,084.8 到 4,315.9 tok/s/GPU,提升 3.98 倍,但只达到官方 DeepInfer 配置的 11.9%,还有 8.4 倍差距。这个对照比任何口号都清楚:单个 kernel 变快,不等于端到端变快,瓶颈会转移。
SGLang 这次值得看的不是 1.04 倍。它把对手的基准、自己的 commit、启动命令、压测客户端和关键环境变量一起摆出来,连“哪些设置只为对比”也写了。对要选型的人,下一步应该看混合负载下的 TTFT、TPOT 和缓存命中率,不是 Pareto 图最右边那个点。对看热闹的人,评论区已经给出另一条线索:跑分赢了之后,大家先问的是基线,再问的是生产。
发布时间: 2026-10-28 22:51