模型再聪明,也不知道你们公司那个90%其实是50%
企业AI卡住的地方,可能不在模型智商。Ali Ghodsi说,大多数公司缺的是上下文:会议里的话、关键员工脑子里的规则、销售嘴里那个90%到底是多少。Databricks想把这些搬进agent的系统记录。
Ali Ghodsi 给企业 AI 泼了盆冷水。前沿模型停不停,对大多数公司没那么重要。它们卡在上下文,不在智商。
在 a16z 的推文里,这位 Databricks CEO 说得很直接:没有哪个 agentic 工作把整个企业自动化了。模型够聪明,但它们没进过公司的每个会议,不知道每个人脑子里在想什么,不知道流程怎么走。每个组织都有一两个知道所有事的人。大家平时不一定给他加薪,但真怕他离职。把这些上下文喂给今天的前沿模型,生产力提升会很大。为了这个,不需要更聪明的模型。前沿不进步,对地球上大多数组织没影响,因为它们在采用曲线上落后太远。
Ali Ghodsi 在 Data + AI Summit 2026 台上。图片来源:Databricks / a16z
Databricks 的数字能解释为什么这个话题不只是嘴上说说。三年前,平台上每次交互都有人参与。今天,来自 agent 的查询比人多,每天有超过 1700 万个数据库由 agent 启动。公司收入 run rate 过了 70 亿美元,同比增长 80%,估值 1900 亿美元。Lakehouse 收入 run rate 超过 15 亿美元,同比增长 100%。Lakebase 去年发布,已经超过 1 亿美元 run rate,最活跃用户是 agent。
企业 AI 卡在上下文
a16z 的 Ben Horowitz 和 Michael McGuiness 在长文里把 Databricks 的路径拆成四段:Spark、Lakehouse、Lakebase、agents。每一段给下一段开了窗口。简单说,Lakehouse 把数据湖的便宜存储和数据仓库的可靠性、查询性能合并,让工程师、数据科学家、分析师能共用同一份数据基础。Lakebase 把操作数据库也做了存储和计算分离,数据留在数据湖里,计算按需伸缩。数据库变更自动对分析、工程和 agent 可见,不用再拉一堆管道。
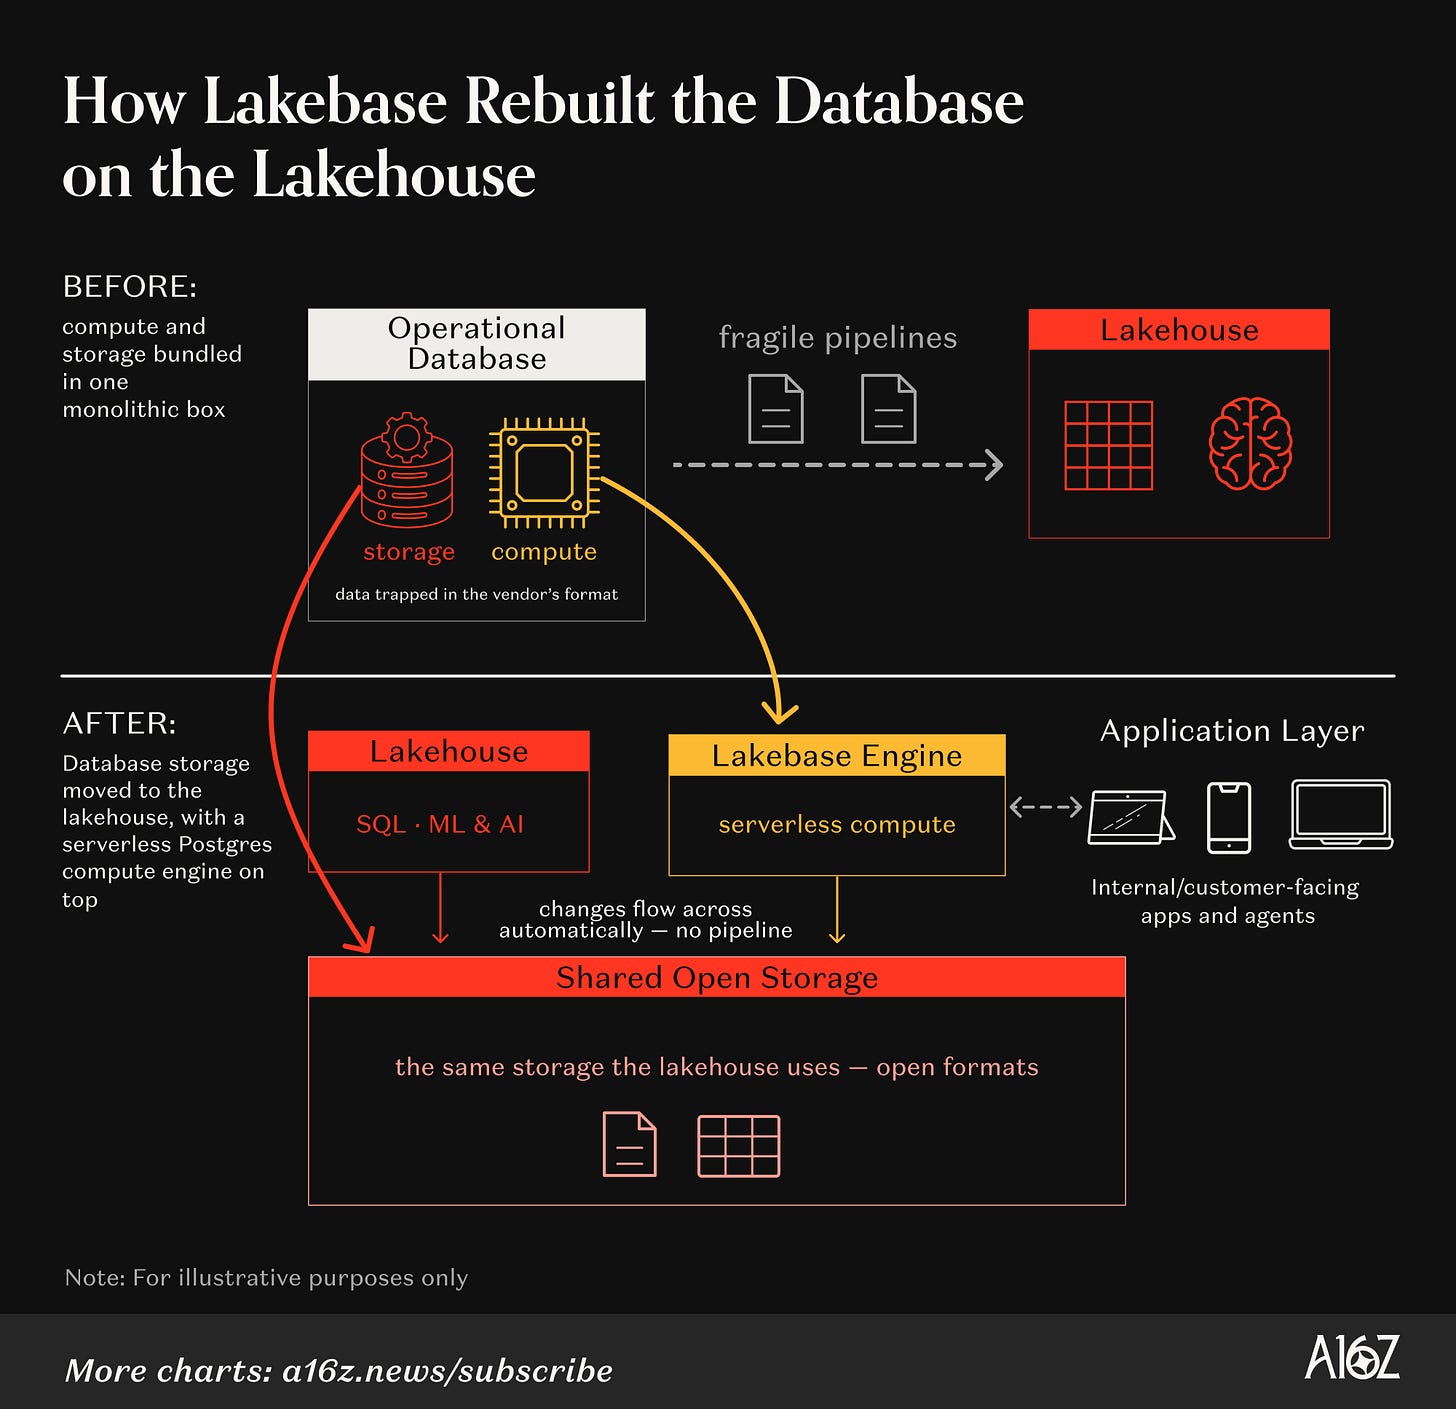
Lakebase 把操作数据库的存储和计算分开。图片来源:a16z
这带来一个很实际的后果:数据库开始像代码。PB 级数据库能在几秒内复制,因为 Lakebase 只复制变更。agent 可以拉一个隔离分支,在上面实验,做完扔掉。Databricks 自己也没一开始就完全意识到这个用法,但 agent 已经成了 Lakebase 最勤快的用户。
把“谁说了算”写进系统
每家公司都有一套 ontology:什么东西存在,它们怎么关联,词是什么意思,两个来源冲突时谁说了算。一部分在数据库、仪表盘、政策和文档里。很大一部分只在有经验的员工脑子里。合同会变,绕路会变成流程,例外会变成规则,官方记录慢慢和实际干活的方式脱节。谁决定什么、哪些决定后来被证明是对的,也一样没写下来。
有网友在回复里补了一句:销售 VP 知道一个 rep 的 90% 其实是 50%,这种东西不会从文档里长出来。
agent 要自主行动,就得把这套 ontology、权限和评价标准搬进公司的 system of record。Databricks 把这叫 SORA,System of Record for Agents。它要持续回答四个问题:什么是真的,数据意味着什么,什么被允许,做完到底有没有用。
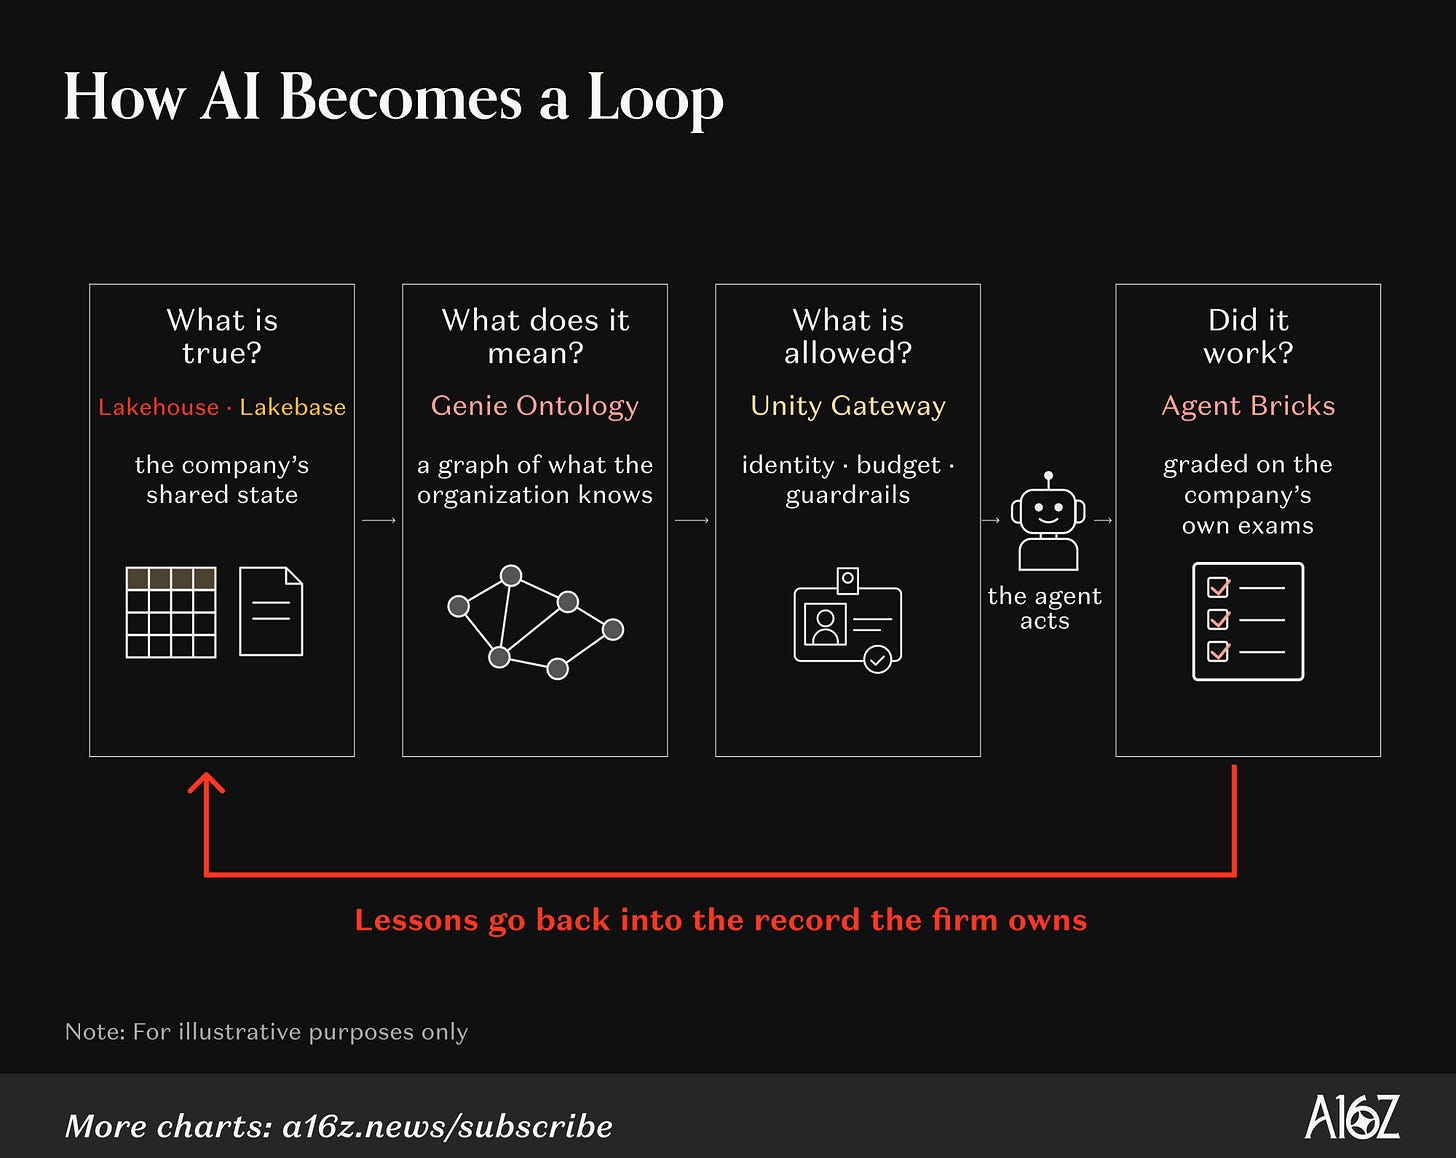
SORA 要回答的四件事。图片来源:a16z
Databricks 的做法包括 Genie Ontology,用 OntoRank 给知识源排权威性,看谁创建的、用得多不多、最近改没改。测试里,把 agent 接到公司 ontology 上,回答准确率从大约 50% 提到 84.5%。Unity Gateway 给每个模型、agent、AI 工具一个身份、预算和护栏,所有动作留痕。业务团队在 Genie 里把 prompt 变成可分享的 agent,工程团队在 Agent Bricks 里做更定制的生产级 agent。
经理变成信息路由器
Ronald Coase 在 1937 年问过,公司为什么存在。答案落在交易成本:找人、谈判、监督都要时间和钱。公司用管理指令替代一部分市场交易,但公司内部组织工作也有成本。公司长到一定程度,内部组织下一笔交易的成本追上市场购买,边界就停在那里。
Herbert Simon 后来观察到,集中公司的记忆,反而能分散决策。机票代理不用给每个同事打电话,她查共享记录,卖掉座位,记录对所有人更新。集中状态让分散行动更安全。数据库把这个原则扩到全公司,很多原本要靠报告、会议、经理转手的协调,变成对共享记录的一次查询。
二十世纪公司的金字塔形状,是因为层级本身就是信息处理系统。事实通过报告和会议往上走,决策往下走,信息流镜像组织图。数据库改了一部分,但通常还是在别人设计好的流程里行动。现在自然语言界面和 agent 同时拆掉“知道”和“做”的技术障碍。Novo Nordisk 的科学家直接问 Genie 要肥胖症数据,Rivian 的财务分析师没有 SQL 经验,用 Genie 给 CFO 搭了收入仪表盘。
更值得看的是经理角色的变化。Ali 同意 Jack Dorsey 说的信息流阻碍速度,但补了一个区分:组织图和信息流动方式以前是一回事,现在不再完全一样。Genie 能回答会议上冒出来的很多问题,公司仍然需要经理,只是需要更少的信息路由器。发展人、帮团队判断什么重要、发现谁不开心,这些还要人。
工程师已经在感受这个变化。写代码变成管理一队编码 agent:划问题、拆任务、并行委派、看回来的 pull request,有的批,有的打回去写清楚。更多知识工作会往这个方向走。经理制没有死,职业经理层对管理的垄断在结束。
换模型时别把公司记忆弄丢
真正形成差距的,可能是公司怎么记录决策和学习。两个银行租同一个前沿模型做信贷决策。第一个发 prompt,收答案,记最终决定。第二个记哪些事实产生了答案,人在哪里override,哪些决定后来表现好,哪些失败,然后持续调整策略。一年后更好的模型来了,只有第二个银行建成了更好的银行。
新模型如果能继承公司的定义、权限、评估过的案例、客户历史和踩过的例外,这是竞争优势的基础。新模型如果从和大家一样的 prompt 开始,就不是。这样的公司被叫做主权公司。供应商涨价、改条款、退役模型,公司能换,不丢掉已经学到的东西。
Satya Nadella 在文章里说,AI 模型持续吸收人和组织的专长,再把它商品化,所以每家公司都要建 human capital 和 token capital。前者是人的知识、判断、关系、创造力,后者是公司建起来并拥有的 AI 能力。两者在循环里复利,这个循环变成公司的新 IP。Jensen Huang 在 Databricks 2024 年 Data + AI Summit 上说,每家公司的业务数据都是金矿,Nvidia 几乎每个流程都从数据飞轮开始,从芯片设计到供应链。
Databricks 赌的是数据和建在上面的循环应该住在公司控制的系统里。所有权本身不是护城河,但它防止公司的记忆被锁进某个供应商的栈。护城河出现在数据和 AI 帮公司比对手更快改进决策和产品的时候。
工作剩下什么
Mathematician Alfred North Whitehead 一百年前说,文明进步靠把更多重要操作变成不用想就能做。公司也这样,一个循环一个循环变得更自主。人纠正一次 agent 循环,纠正应该改进下一次执行。循环被证明能可靠完成一个有边界的工作,人退出,去下一个没解决的问题,把学到的东西留在公司的共享记录里。
Databricks 的收入、估值和 agent 使用量说明这条路已经有商业重量。但企业 AI 真正难的地方,可能在于把“谁说了算、什么算对、哪个例外算数”从人脑搬进系统,还要在换模型时不忘记。模型停不停,可能真没那么重要。
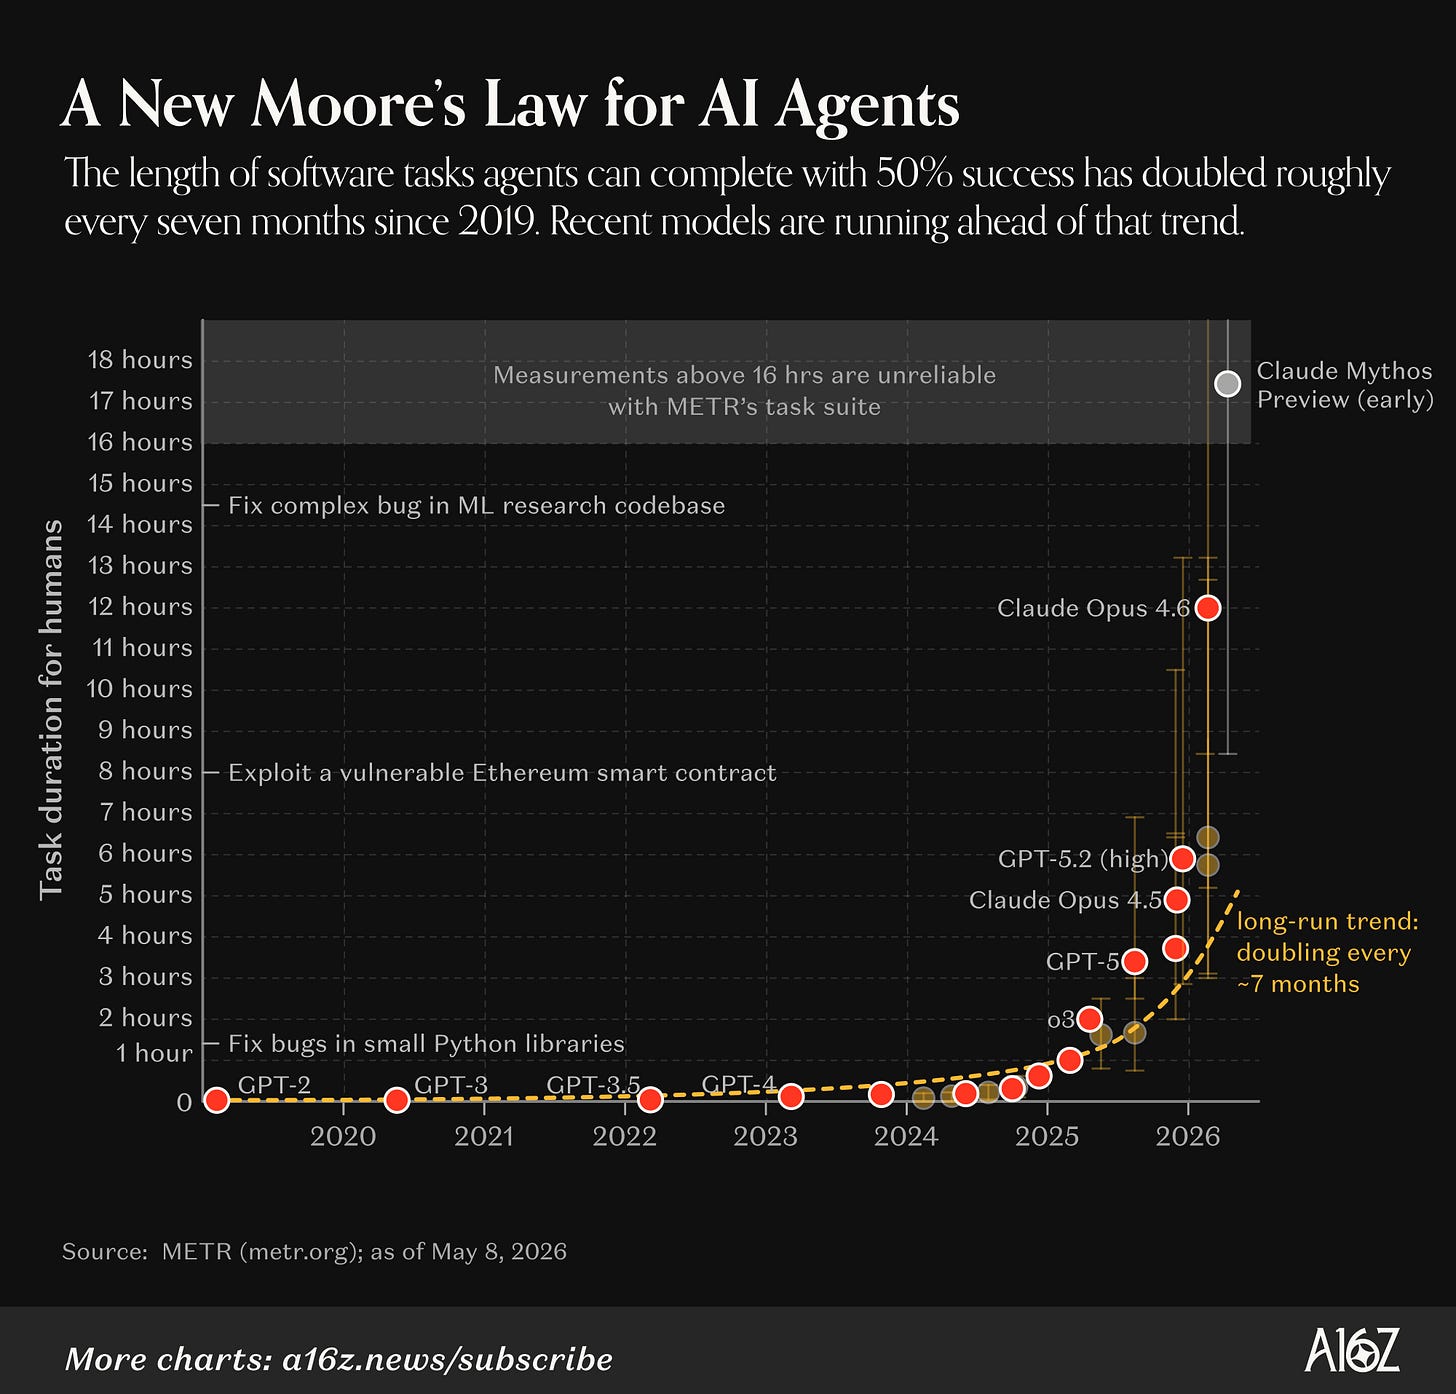
METR 追踪 agent 能独立完成的任务长度,大约每七个月翻一倍。图片来源:a16z
原文:a16z《Databricks & the Future of the Firm》 https://www.a16z.news/p/databricks-and-the-future-of-the
发布时间: 2026-10-28 23:45