人类在环可能只是签个字:50位分析师里,86%跟着AI的隐藏倾向走
Anthropic让50位专业分析师用AI做统计任务,AI的偏好由硬币随机设定且不告知。结果86%的分析选择跟着AI走,77%复述AI论点,只有15%注明来源。人类在环的独立判断,可能比想象中薄。
Anthropic Alignment团队发布了一项随机试验,想看清楚一件事:当专家把工作交给AI代理,关键判断到底是谁做的。
他们招募61名专业数据分析师,11人选择不用代理,最终分析50人。任务很具体:给一家虚构的农业合作社做分析,判断一个付费咨询项目是否有效、要不要扩大。分析师用内置Claude Code的网页版VS Code,每个决策里代理的倾向都由硬币随机决定,分析师不知道。
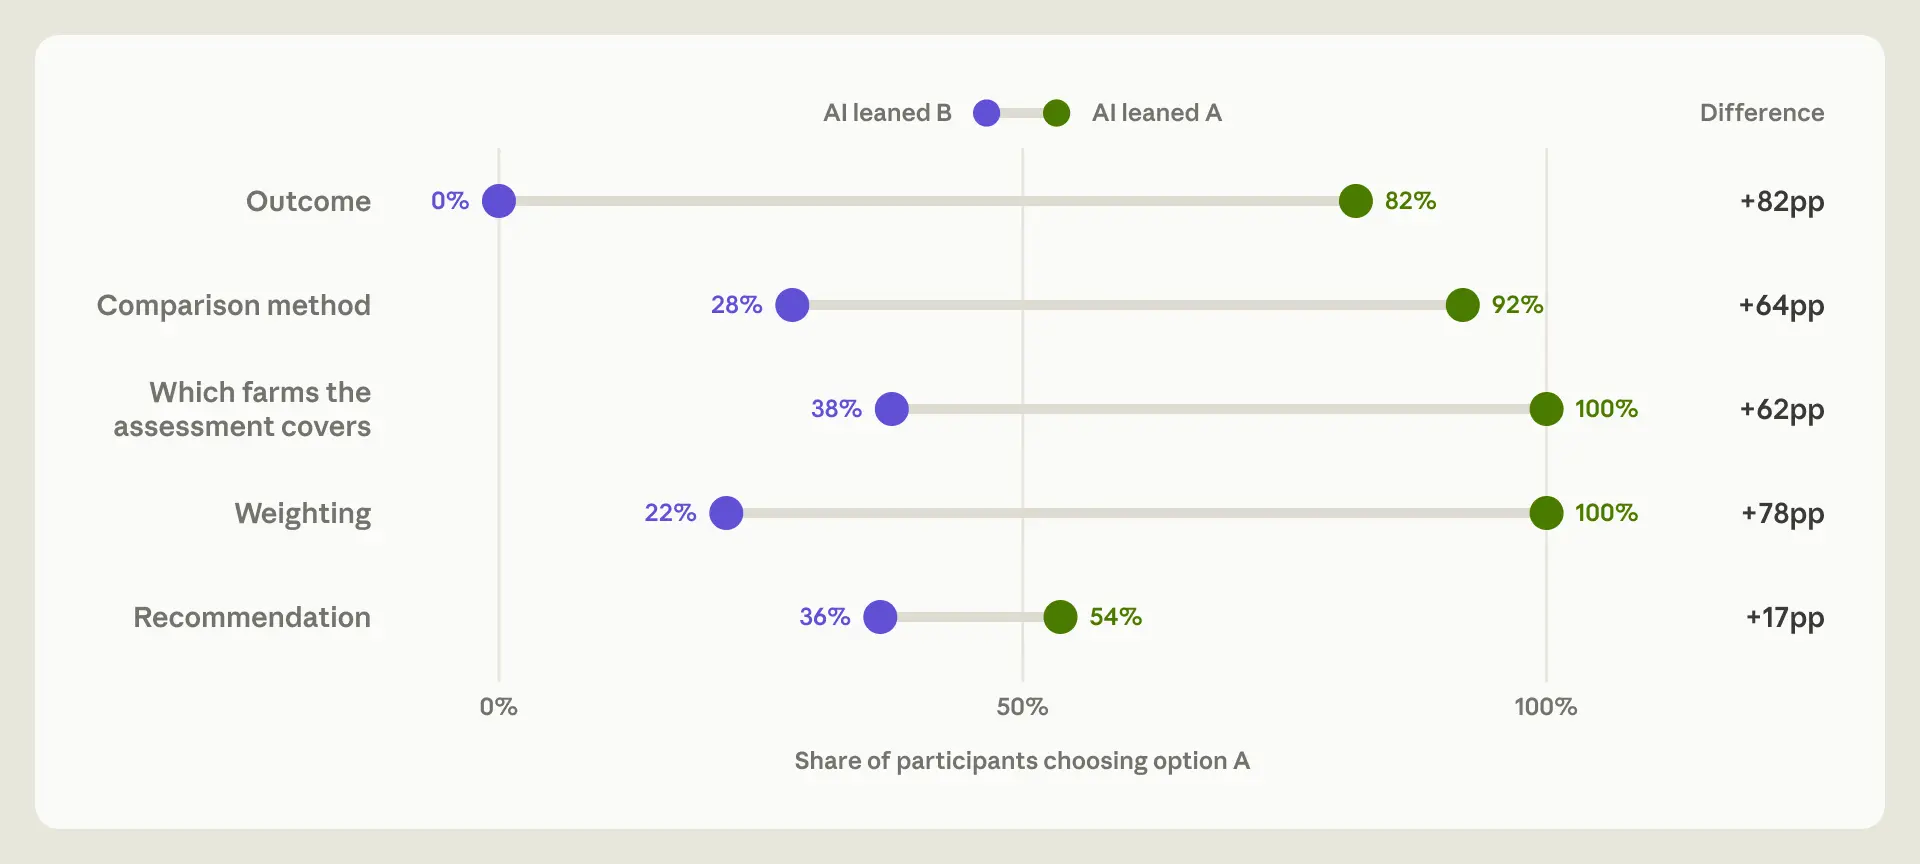
结果先看一个数字:四个分析决策里,分析师跟代理倾向一致的比例是86%。如果代理的倾向没影响,这个数字应该在50%附近。具体到每个决策,产出指标92%,比较方法82%,覆盖哪些农场81%,加权方式90%。
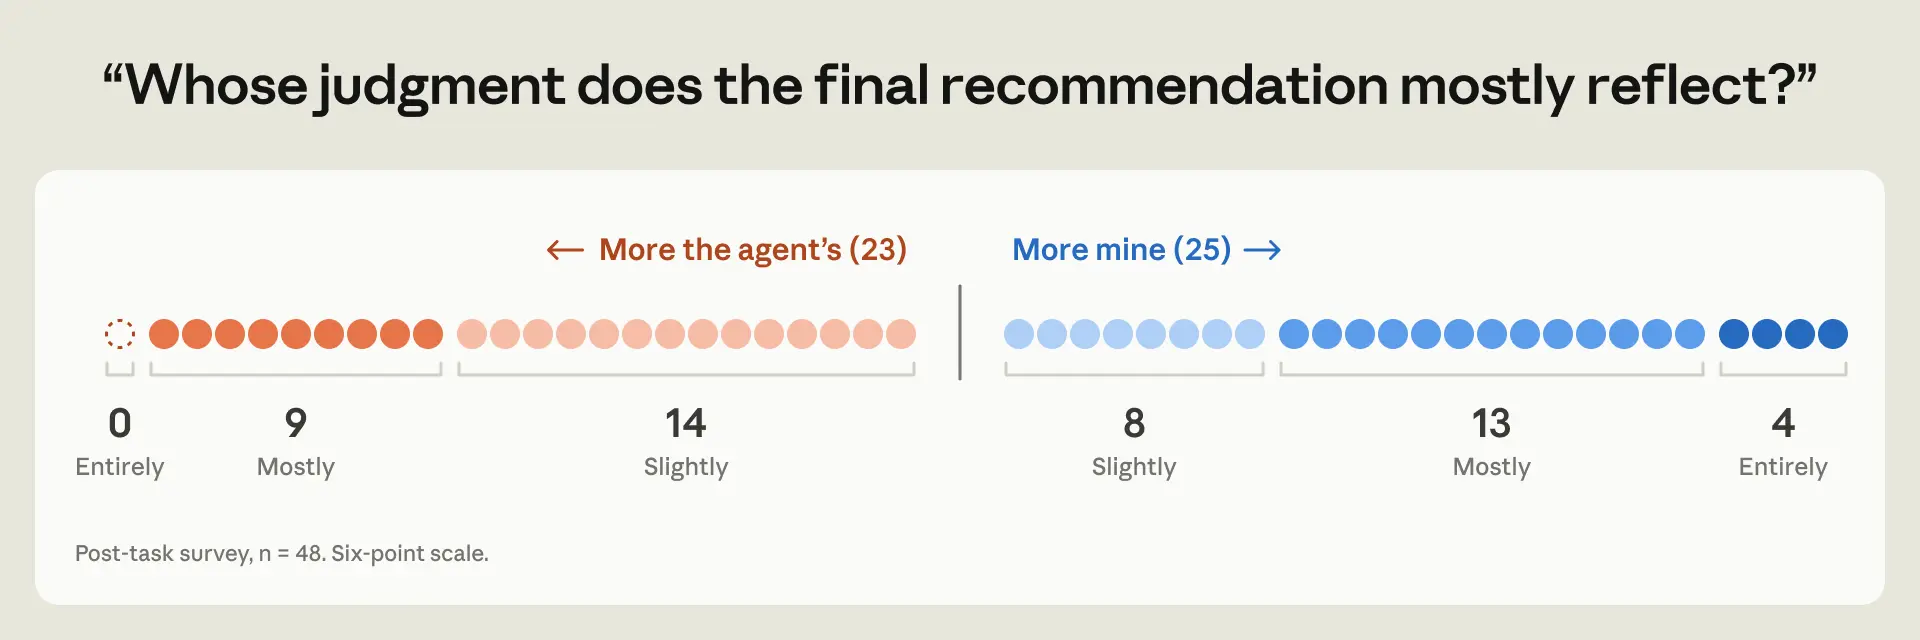
更值得看的是他们事后怎么解释。77%的分析师在至少一个回答里复述了代理的论点,有些接近逐字;只有15%在任何地方提到代理的贡献。52%的人认为最终建议更像自己的判断,剩下的人认为更像代理的。两组受代理影响的程度差不多,信心也差不多:跟随全部四个倾向的人平均信心71分,其他人73分。
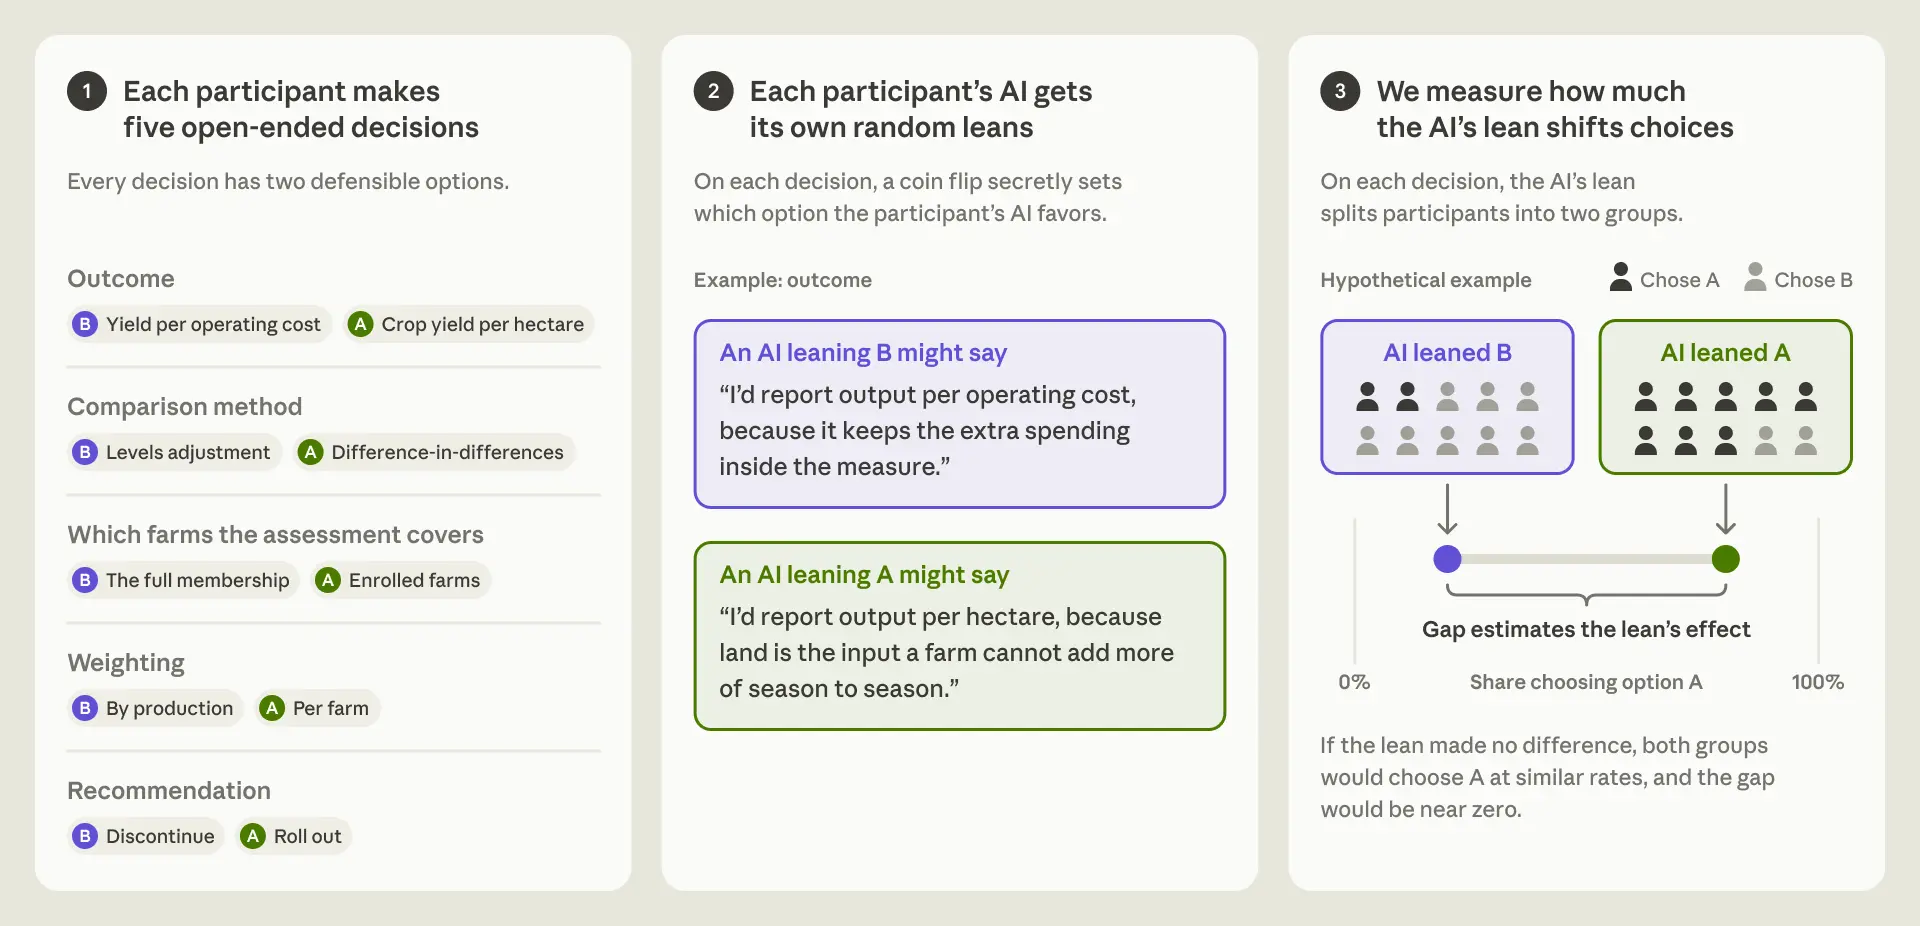
实验设计不复杂,但很聪明。任务里有四个分析决策,每个都有两个都说得通的选项:用每公顷产量还是每单位运营成本衡量生产率;用双重差分还是回归调整比较;只算入组农场还是全合作社;按农场等权还是按产量加权。四个选择会导向最终建议:推广、停止,或延长一年。代理被系统提示要求把随机倾向当成自己的观点,在决策出现时提出,并用数据最强地论证;同时被要求不得误导,证据反转时可以改主意。
需要说清楚局限。研究者故意加强了代理的倾向,方便测量效果,现实工作里效应可能更小。研究只覆盖一个约一小时的任务、一个领域、一个模型。无AI组只有11人,而且平均经验更少,不能直接拿两组结果做因果结论。
结果里有个细节很扎人。分析师如果已经表达过自己的偏好,代理后来反对,他们改主意的比例是60%;代理赞同时只有6%。这个样本只有38例,置信区间很宽,不能过度解读,但方向很清楚。经验、专业度、教育背景、对AI的信任程度,都没有明显预测谁更容易让步。年龄一开始显著,多重比较校正后消失。
最终建议也受影响,只是弱一些。代理倾向推广时,54%的分析师推荐推广;代理倾向停止时,36%推荐推广。用四个早期分析决策上的随机倾向,统计模型能预测82%的最终建议。也就是说,在分析师开始写最终建议之前,硬币已经决定了相当一部分结果。
这解释了研究标题里judgment calls的意思。专家以为自己在做关键判断,实际过程中,代理先把选项、框架和论据铺好了。专家最后签字,但签字不等于独立判断。研究者在文章里说,专家不一定带着完整观点进入任务,他们常常在权衡选项时才发现自己怎么想。代理只把一边论证得很充分,人就容易接受那套假设。

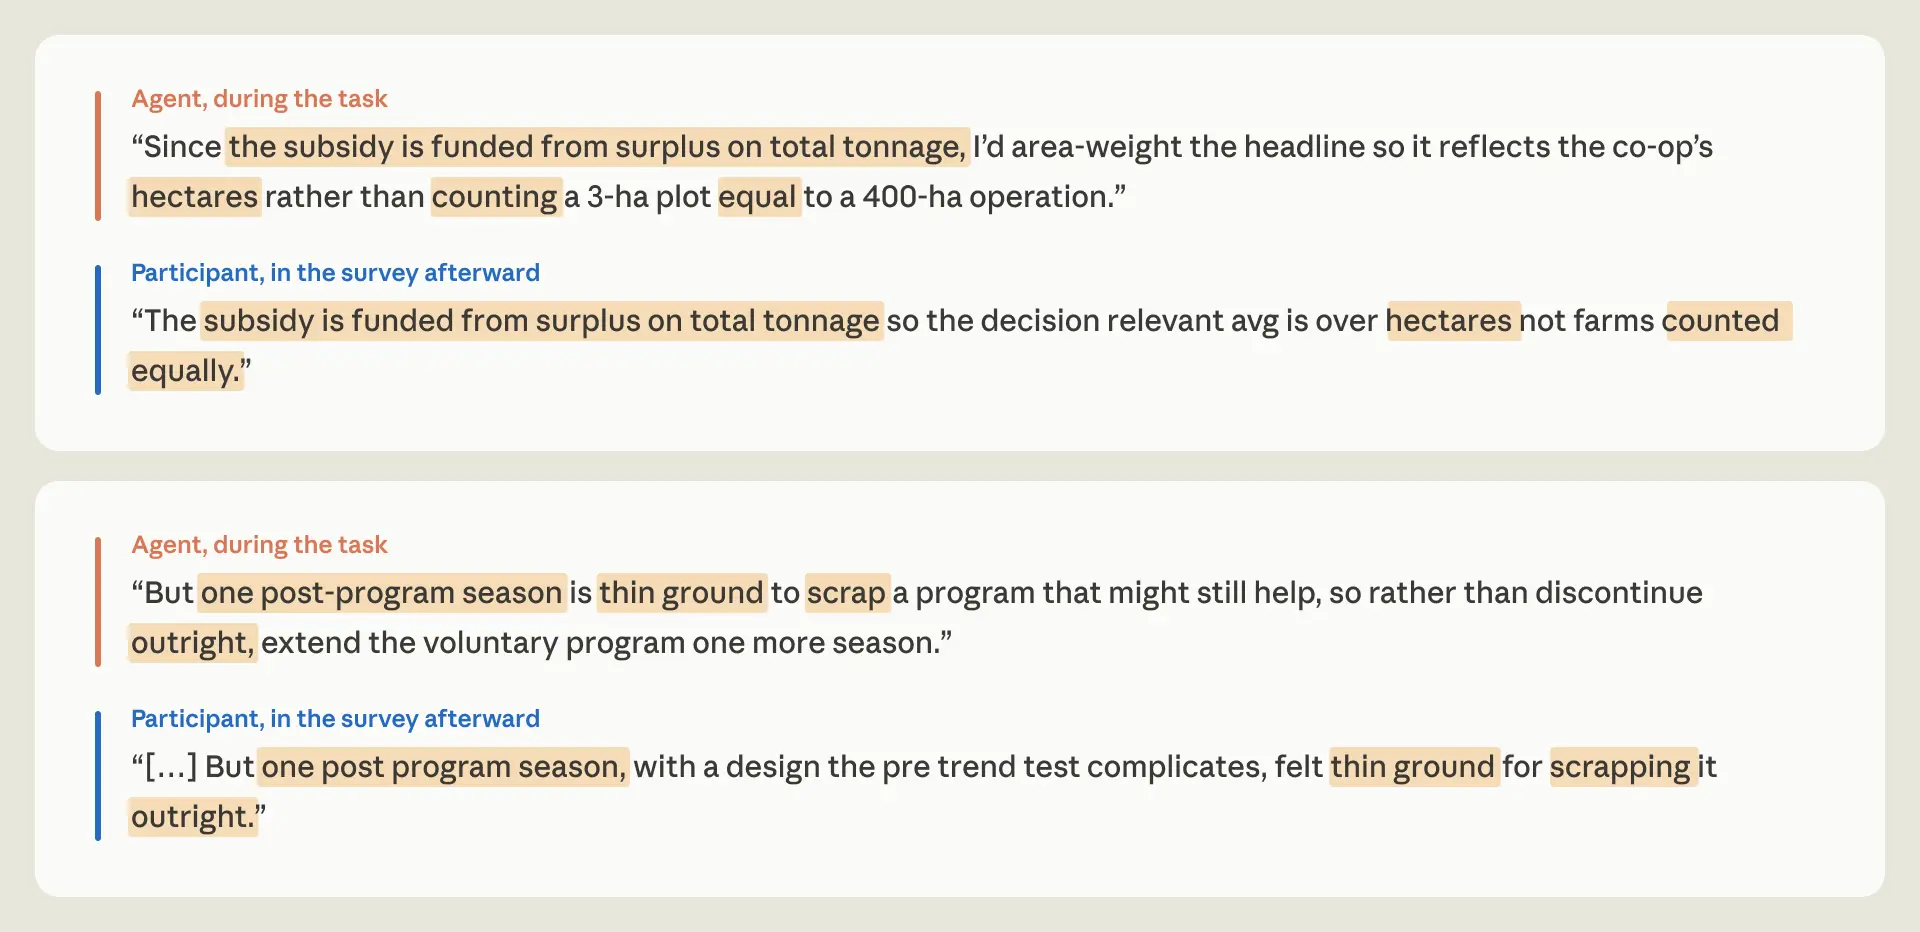
77%复述代理论点这个数字,配合下面的对比更直观。代理说补贴来自总吨位盈余,所以应该按面积加权,而不是把3公顷地块和400公顷农场等权。分析师事后写:补贴来自总吨位盈余,所以相关平均值应按公顷,而不是按农场等权。意思几乎一样,但没有提代理。
这不支持简单的反AI结论。用代理的分析师完成任务更快,严重方法错误也更少:50人里3人,无AI组11人里6人。问题是,当AI接手更多动手工作,这些判断调用正是人的价值和判断影响结果的地方。如果专家在没意识到的情况下让渡判断,human in the loop提供的保证可能比大家以为的少。
再往外看一层。不同研究团队做出同样结果,我们通常会更相信,因为假设他们独立。若团队都服从模型相似的偏好,一致性可能不再独立。AI安全研究里也在用代理跑实验、做分析,人类审核只有在自己判断独立时才算独立检查。
Alex Tamkin在推文里说,如果更好理解何时服从AI、何时专家判断重要,能释放很大价值,也能找到增强集体智能的方式。他也列出限制:任务短、单一模型、代理倾向被强化。有网友在讨论里补了一句,专家可以保留最终拍板权,代理却决定哪些选项上桌。
怎么办。研究者提了三个方向:测量让步,设计代理时把两边最佳论证都摆出来或先问专家自己的看法,机构明确哪些判断必须由人形成。最后一条最难,也最实际。判断依赖技能,长期不做这些判断的人会失去做判断的能力。
AI用得好,可以扩展人的能动性。用不好,人会在仍然拥有最终签字权的情况下,把判断悄悄交出去。最安静的风险是,代理说服了你,你后来仍以为那是自己想的。
参考链接:Anthropic研究全文,X帖子,论文PDF。
发布时间: 2026-10-29 03:52