谷歌刚发布的交互生成,开源社区七个月前就做完了?
谷歌Gemini4的即时生成交互功能,有网友翻出7月的开源项目Incantation。它用自然语言实时控制视频角色动作,跨实体迁移89%对43%,代码和Demo已公开。
谷歌最近发布Gemini4,自带即时生成交互功能。有网友翻出一个7月的开源项目Incantation,认为它做的事情几乎一样,甚至更细:用自然语言实时控制视频内容里的角色动作。
这个视频是B站up主星空-dark-法师在7月2日发的,现在有4.2万次观看。封面一句话:“也就是你可以实时和视频内容进行交互”。简介里特别说明:所有演示均由视频生成模型生成,并非基于游戏引擎构建,也不涉及code agent或显式环境编程。模型用《艾尔登法环》数据训练,基座是Wan2.2-5B。

这个项目的名字叫Incantation,论文挂在arXiv 2605.18601,作者来自上海交大、NVIDIA Research等机构。核心思路是把自然语言用作视频世界模型的动作接口。
传统交互式视频生成模型,控制信号往往来自动画ID、设备输入或场景字幕。这些信号在设计阶段就绑定了特定实体或引擎。Incantation换了一种方式:每个0.25秒的潜空间帧接收一条结构化自然语言提示,比如“玩家执行[动作A],Boss执行[动作B]”。控制多个实体,就加多个提示槽,不动模型本身。
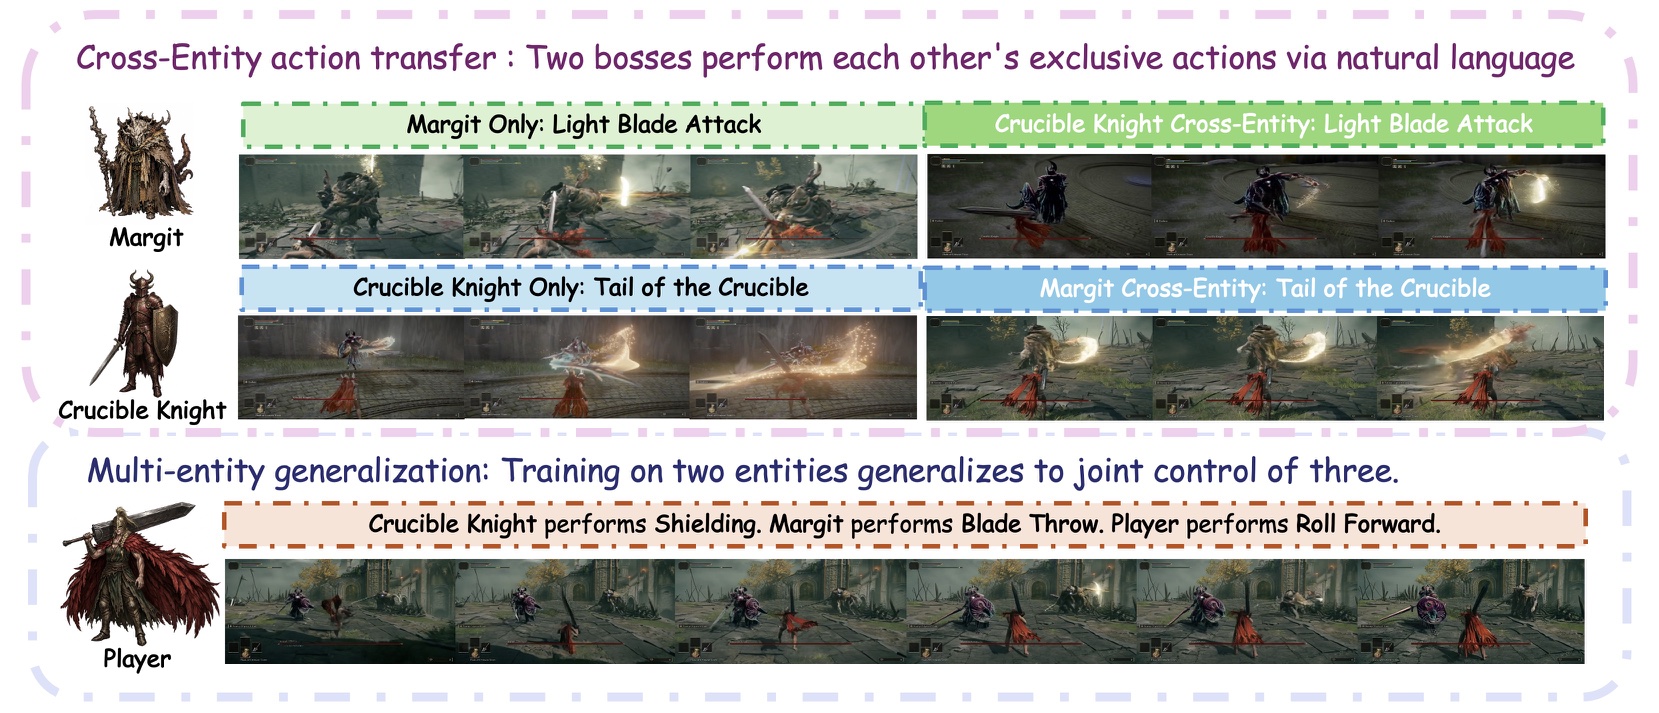
论文里最亮眼的数据是三个对比:
| 测试 | 自然语言 | Action-ID基线 |
|---|---|---|
| 已见动作 | 95% | 89% |
| 跨实体迁移 | 89% | 43% |
| 超出词表提示 | 90% | 0% |
自然语言在跨实体迁移上直接翻倍,超出训练词汇表的动作也能控制。基线的动作ID在遇到新词时完全没有输入接口。另外,模型在双实体场景训练后,可以泛化到同时控制三个实体。
实现上,Incantation做了两个关键设计。文本交叉注意力只作用于当前噪声帧,历史帧保持双向自注意力,防止当前动作提示污染已经生成的内容;滑动KV-cache则负责长视频,缓存原始键,滑窗后动态应用旋转位置编码,避免位置信息过期。学生模型通过ODE初始化的Self-Forcing蒸馏,2步推理达到163毫秒每帧,约19.7 FPS。长时稳定性也验证过:2小时rollout的FVD保持稳定。
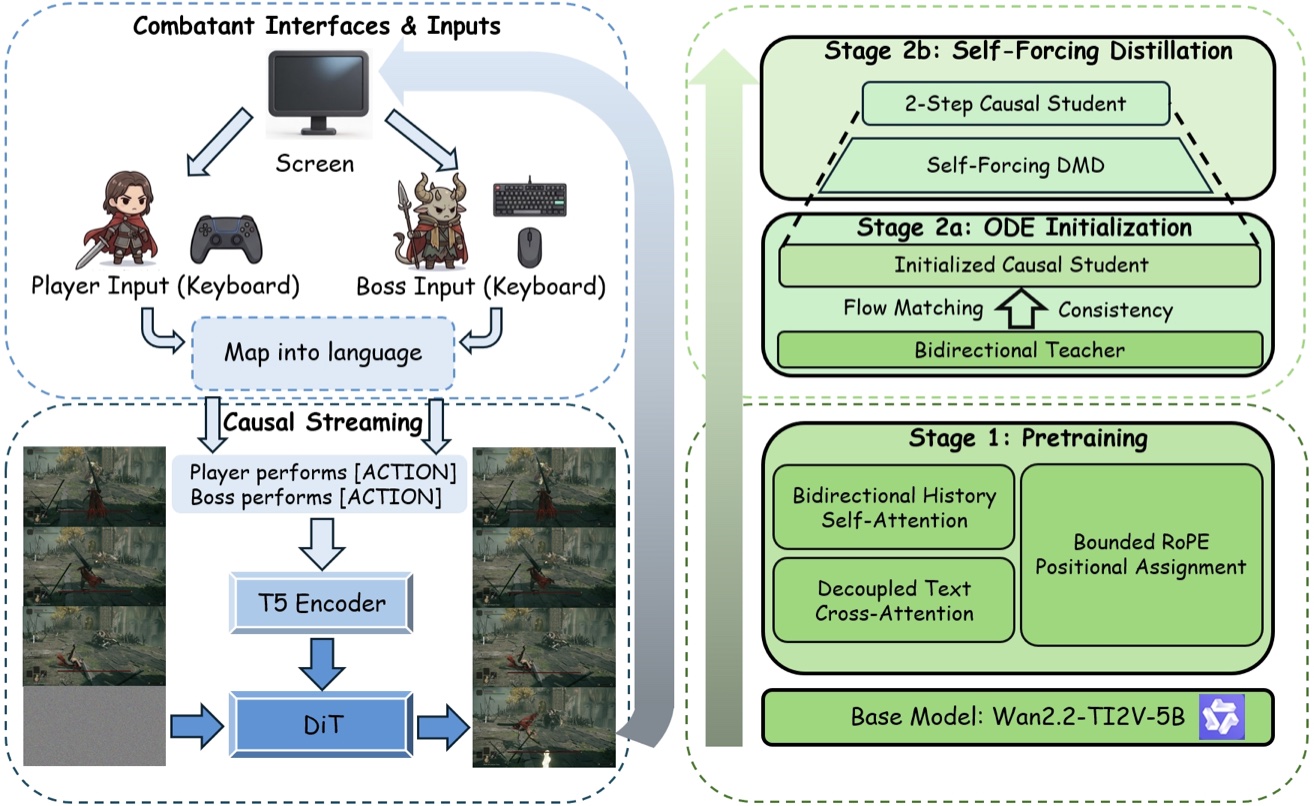
同样的架构还换到《拳皇》世界,只改了动作槽,结果也成立。这说明语言作为动作接口,并不只在单个游戏里有效。项目放出了实时Demo(reactor.inc/incantation)、代码(GitHub)和数据集(Hugging Face)。数据集包含45小时《艾尔登法环》boss战、83小时《拳皇》片段,按0.25秒粒度标注每个实体的动作。
至于谷歌是不是真的收编了那位开源作者,没人知道。但至少,大厂发布会上的“新功能”,开源社区七个月前已经给出了一个足够清晰的答案。
发布时间: 2026-10-28 14:40