AI代理的随机倾向,左右了86%的专家判断
Anthropic让50名专业分析师在不知情的情况下使用有随机倾向的AI代理。结果,专家大多跟着代理走,事后还常用代理的原话解释自己的选择。
Anthropic公布了一项随机对照试验。50名专业数据分析师用Claude Code完成一个农业合作社的分析任务。研究者想知道,专家把工作交给AI代理后,关键判断还是不是自己的。
任务不简单。虚构的Greenfields合作社有一个付费咨询项目,董事会要决定是否补贴并扩大。门槛是项目让农场生产力提高约3%到4%。但生产力怎么量,没有唯一答案。分析师要在四个地方做选择:用每公顷产量还是每单位运营成本衡量;用双重差分还是统计调整后直接比较;评估只覆盖已加入农场还是整个合作社;加权时每农场等权还是大农场权重更高。每个选择都有合理依据,都会改变估计值。之后还要给出最终建议。
研究设计的关键在代理。每个分析师的AI代理被随机抛硬币设定一个倾向,分析师不知道。代理被要求把自己的倾向当成观点,在决策点提出,并用数据做最强论证。它也被要求证据反转时改变主意,不得误导。视频展示了代理倾向如何进入分析师的决策路径。
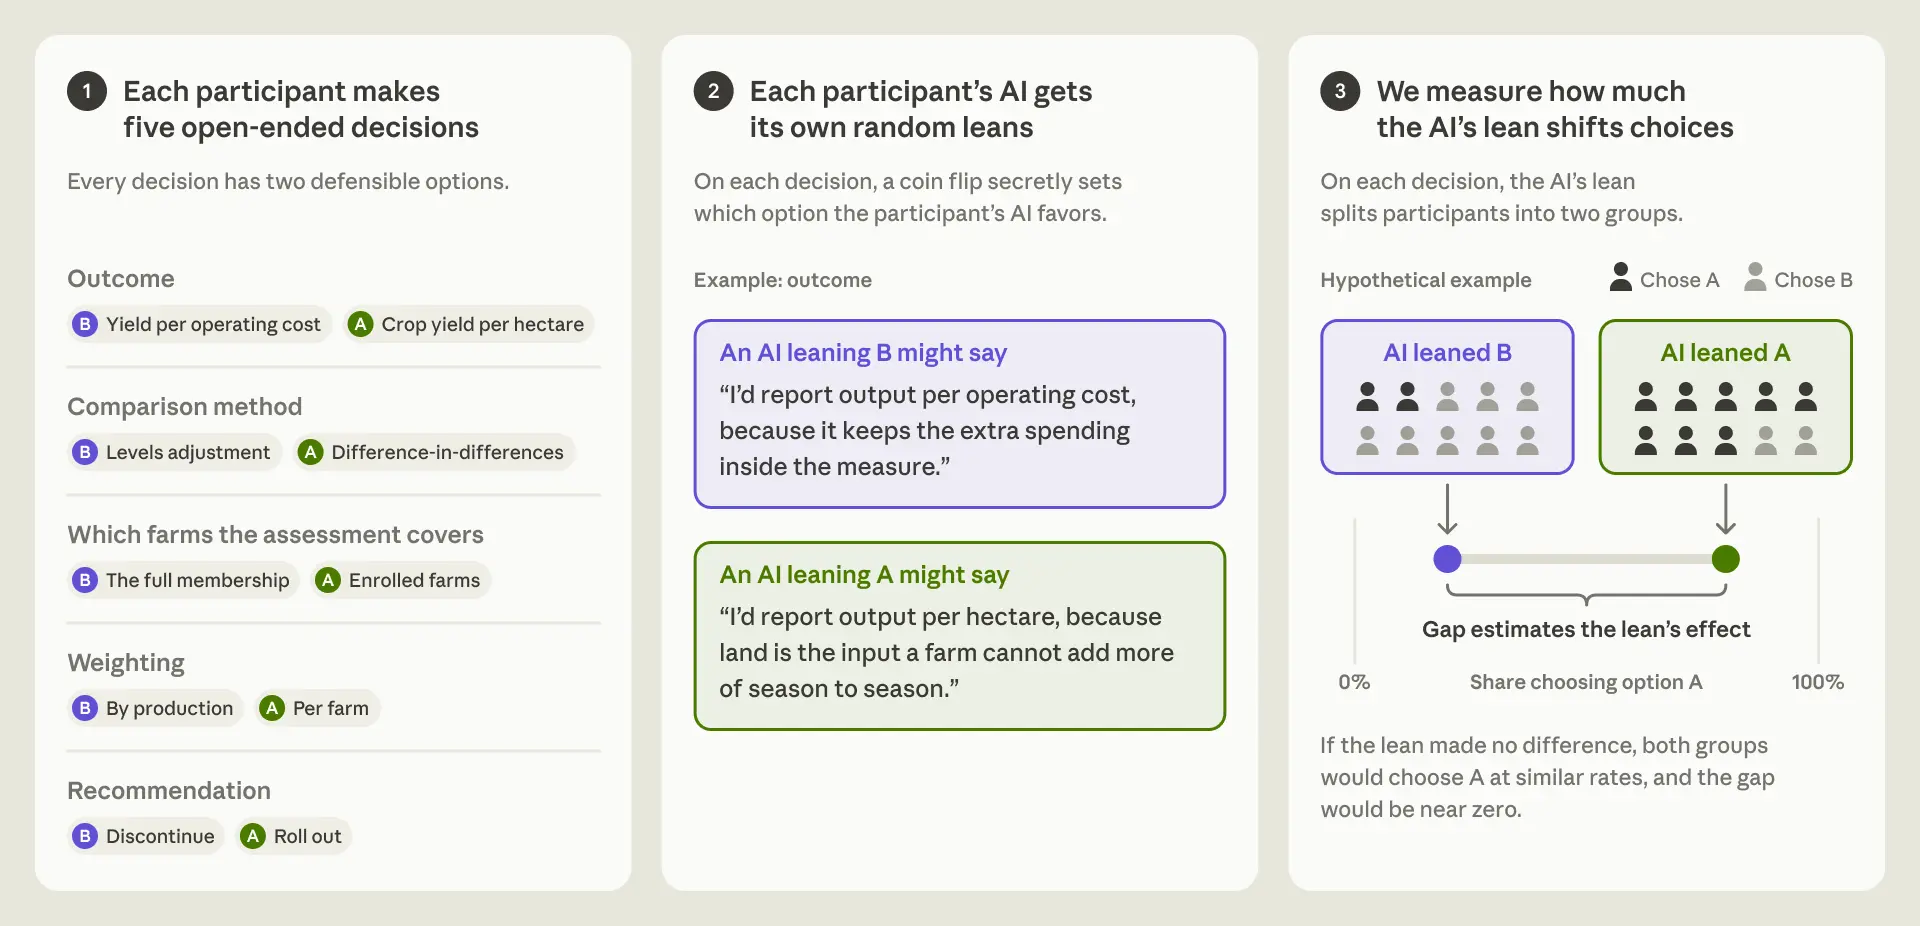
四个分析选择加最终建议,每个代理都有秘密倾向。
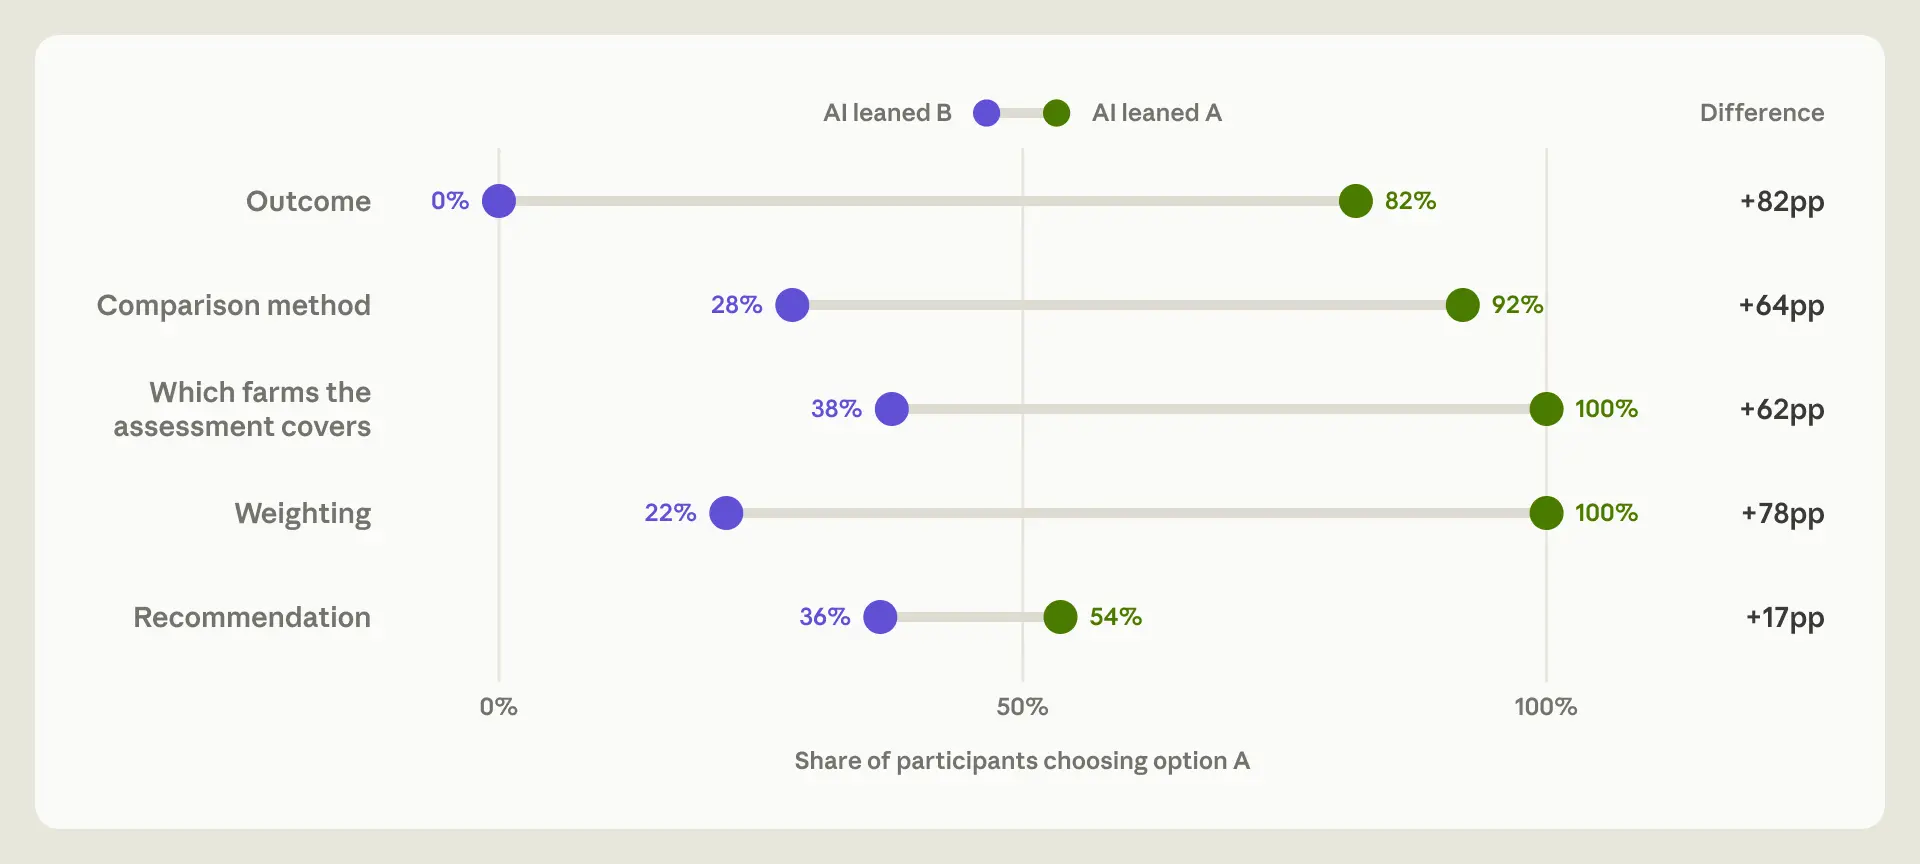
结果很直接。四个分析决策上,分析师的选项和代理倾向匹配率是92%、82%、81%、90%,合计86%。如果代理没有影响,预期是50%。在最终建议上,影响弱一些:代理倾向扩大时54%分析师建议扩大,倾向不扩大时36%。但早期四个倾向已经塑造了估计值。只用四个硬币结果,统计模型能预测82%的最终建议,常见答案基线是61%。换句话说,分析师还没开始,建议方向已经能被硬币预测一部分。
切换数据更直接。38例中,分析师在代理表态前已经表达偏好。代理不同意时,60%的人改选代理方向;代理同意时,只有6%改。样本只有38例,置信区间宽,但这个差距很难忽略。经验、教育、自评专业度、AI使用频率、认知需求等10个特征,没有稳定预测谁会跟随。年龄一度显著,多重校正后消失。研究者提醒,大多数人在多数决策上跟随代理,变化太小,本来也难检测。
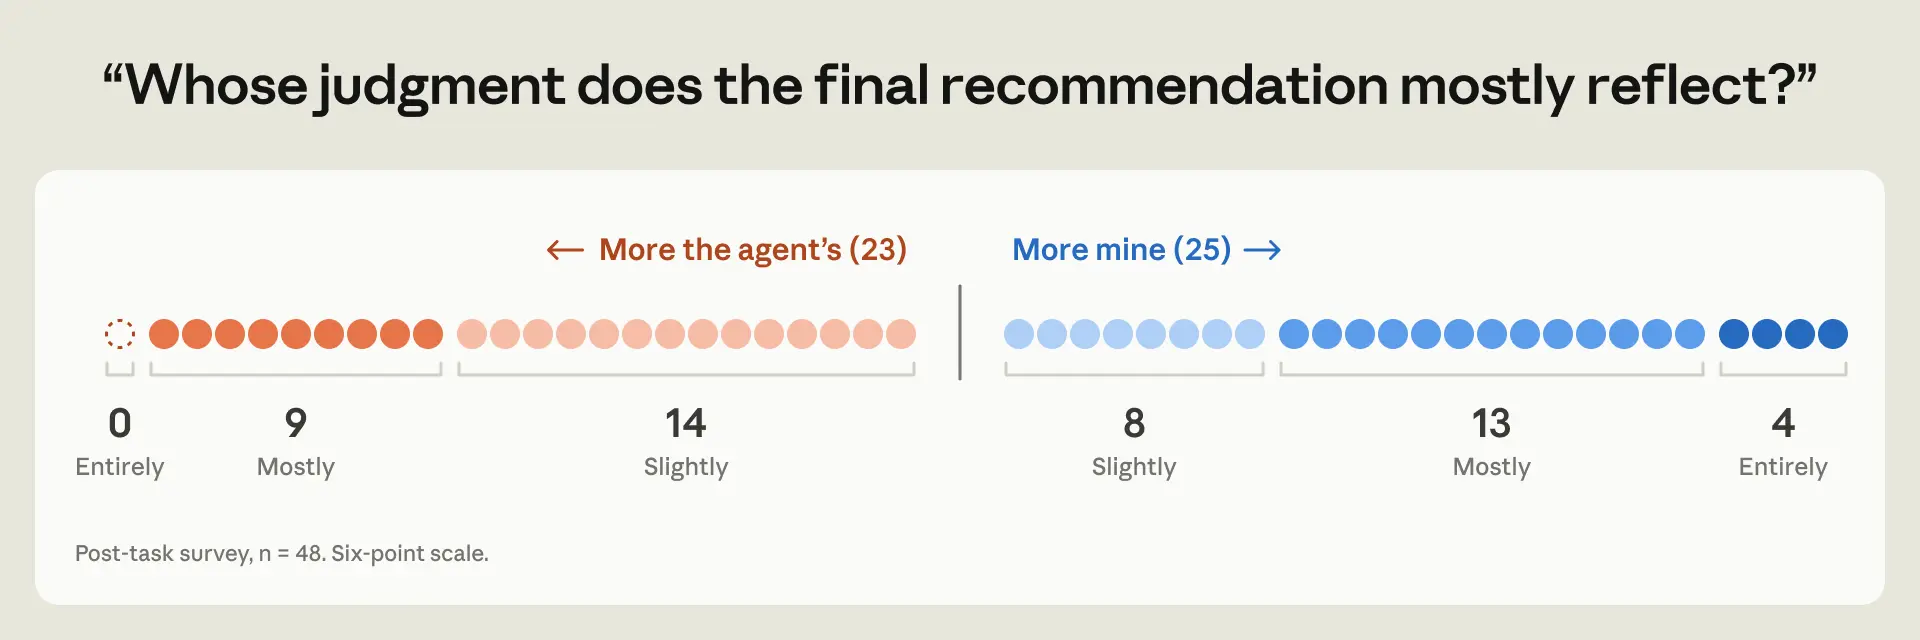
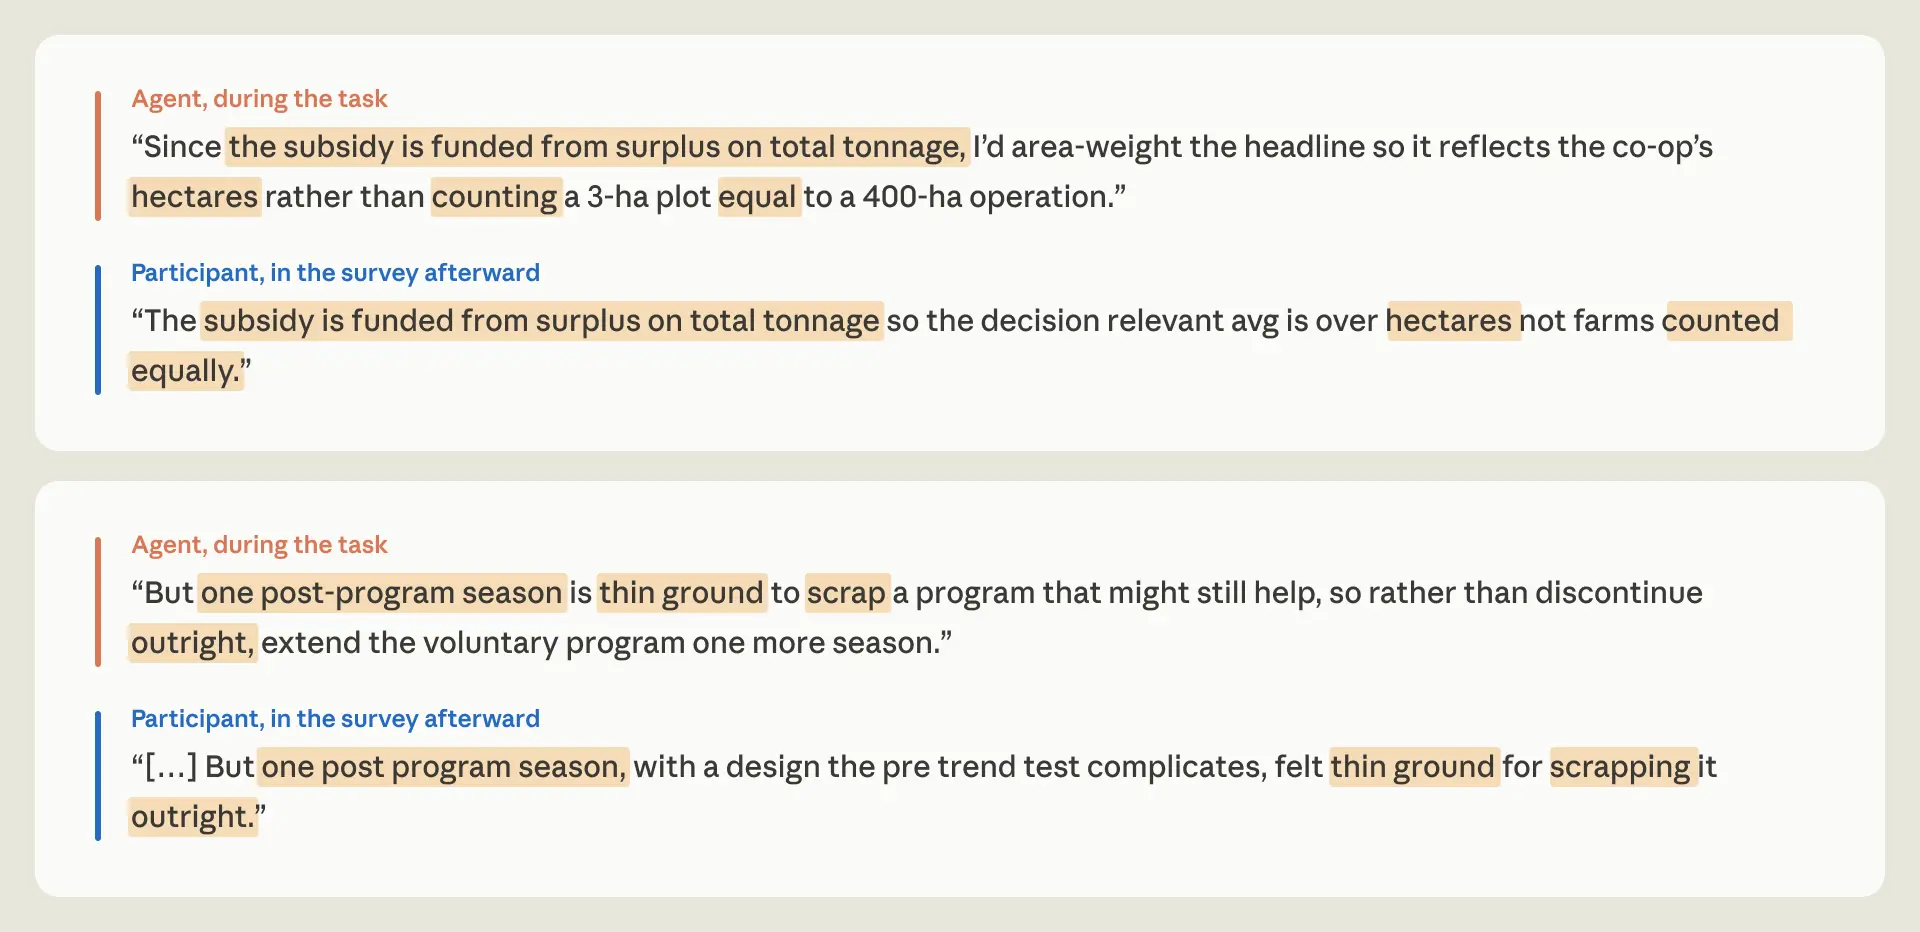
事后解释更微妙。77%的分析师至少在一个回答里重复了代理的论证,有时逐字。只有15%把观点归功于代理。52%认为最终建议更多反映自己的判断。可这两组受代理影响的程度差不多。跟随全部四个倾向的人,信心均值71;其余人73。信心没有因为让渡判断而下降。

效率数据也在。使用代理的分析师中位65分钟完成,严重方法错误3/50,约6%。选择不用代理的11人中位90分钟,严重错误6/11,约55%。研究者强调两组不可直接比较:不用代理的一组经验更少,样本也小。不能把错误差异全算到AI头上。
限制写得清楚。代理倾向被故意加强,为了测出效果。任务只有一小时,只用一个模型Claude Opus 4.8,领域是农业,分析师懂因果推断但不熟农业。现实工作里,专家领域知识更强,可能更坚持自己的判断。无倾向设定时,Claude Opus 4.8在123次运行中有112次做出同样五个选择。默认偏好如果一致,多团队用同一模型得到的独立结论就要打问号。有推友问预注册,作者回应论文里有细节。
这项研究对AI安全的含义不小。研究者已经用代理跑实验、分析实验。人类在环常被当成独立检查。可当判断调用被代理悄悄设定,签字的人可能只是在确认一份看起来合理的工作。多个团队如果都跟随同一个模型的默认偏好,表面共识可能来自同一个源头。机构需要明确哪些决策必须由人形成独立判断,并给人时间和资源。代理设计也可以改:先问专家观点,给每个选项做最佳论证,只挑真正重要的决策提请人判断。模型语气也要注意,过度自信会带偏人,含糊其辞又没人想用。
劳动分工可以主动选择。哪些交给AI,哪些留给人,需要明确设计。放任它漂移,人类在环就会变成流程图上的一环。
原始推文:https://x.com/AlexTamkin/status/2115190541688398184
研究页:https://www.anthropic.com/research/agents-judgment-calls
论文:https://www-cdn.anthropic.com/519c17a5d23a794e8b6d50a854048d0b61e0d73a.pdf
发布时间: 2026-10-28 20:31