同一张表三种解析结果,DPP写了140条规则来裁判
LlamaIndex发布Document Parsing Protocol工作草案0.1,140条规则覆盖表格、表单、图表和图示。它想解决的是:两个解析器都抓对了字,却给出不同结构,下游agent因此答错。规则本身也有争议,谁仲裁、怎么打分,评论区已经问上了。
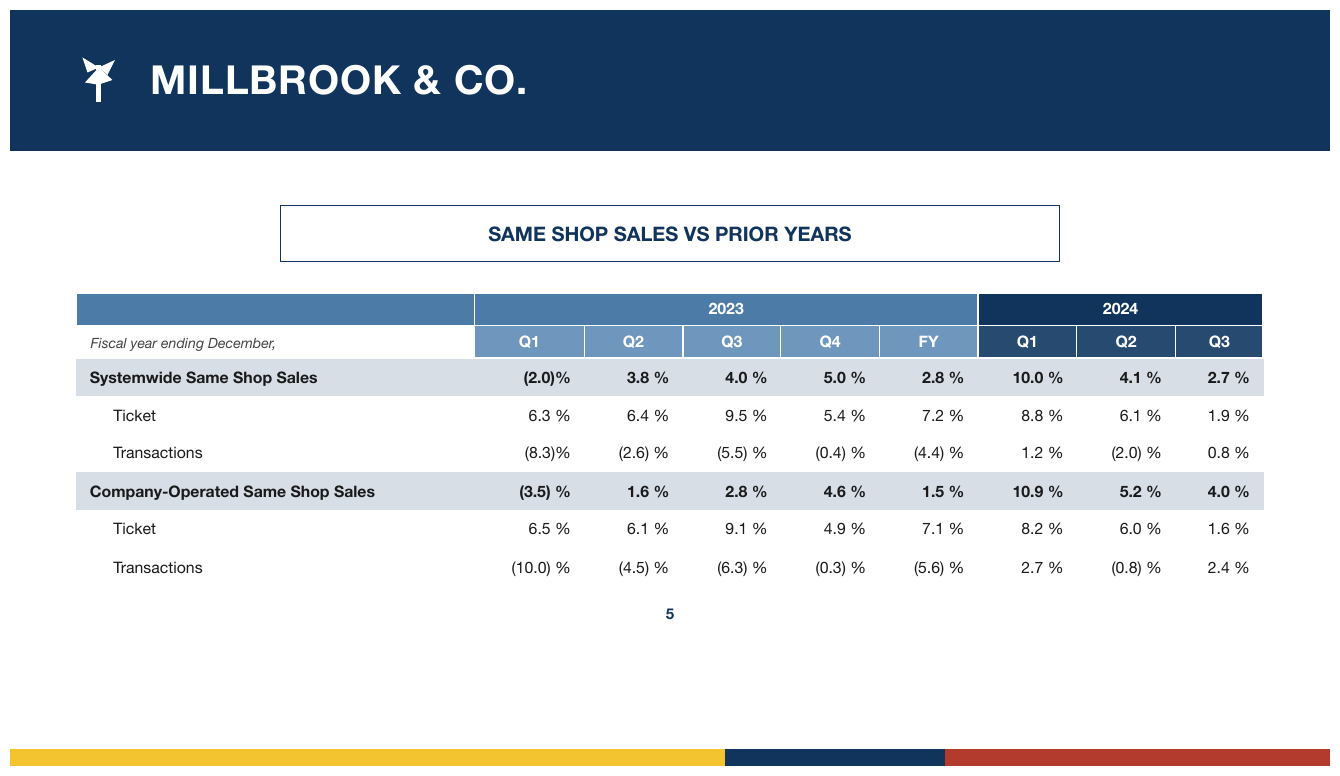
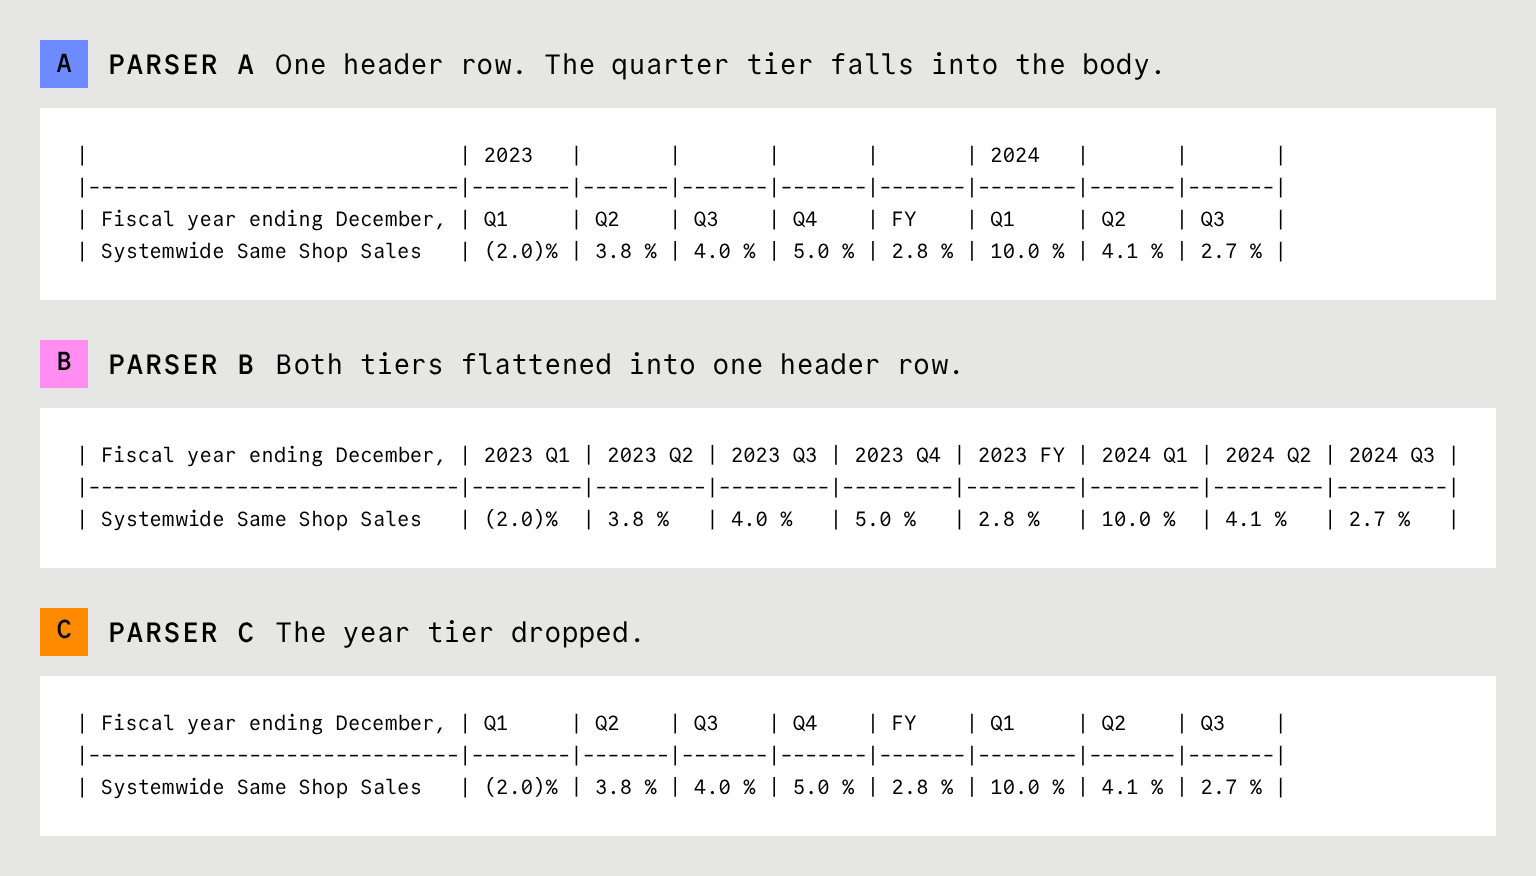
同一张销售表,有两年份表头和季度子表头。三个解析器输出三种Markdown。问agent“2024年Q2系统同店销售是多少”,A把季度塞进正文,4.1%上面没有年份;C丢掉年份,Q2对应两列;B结果对,但自己造了“2024 Q2”标签,页面没印这几个字。LlamaIndex把这三种都判错。理由简单:结构错了,数字对也没用。
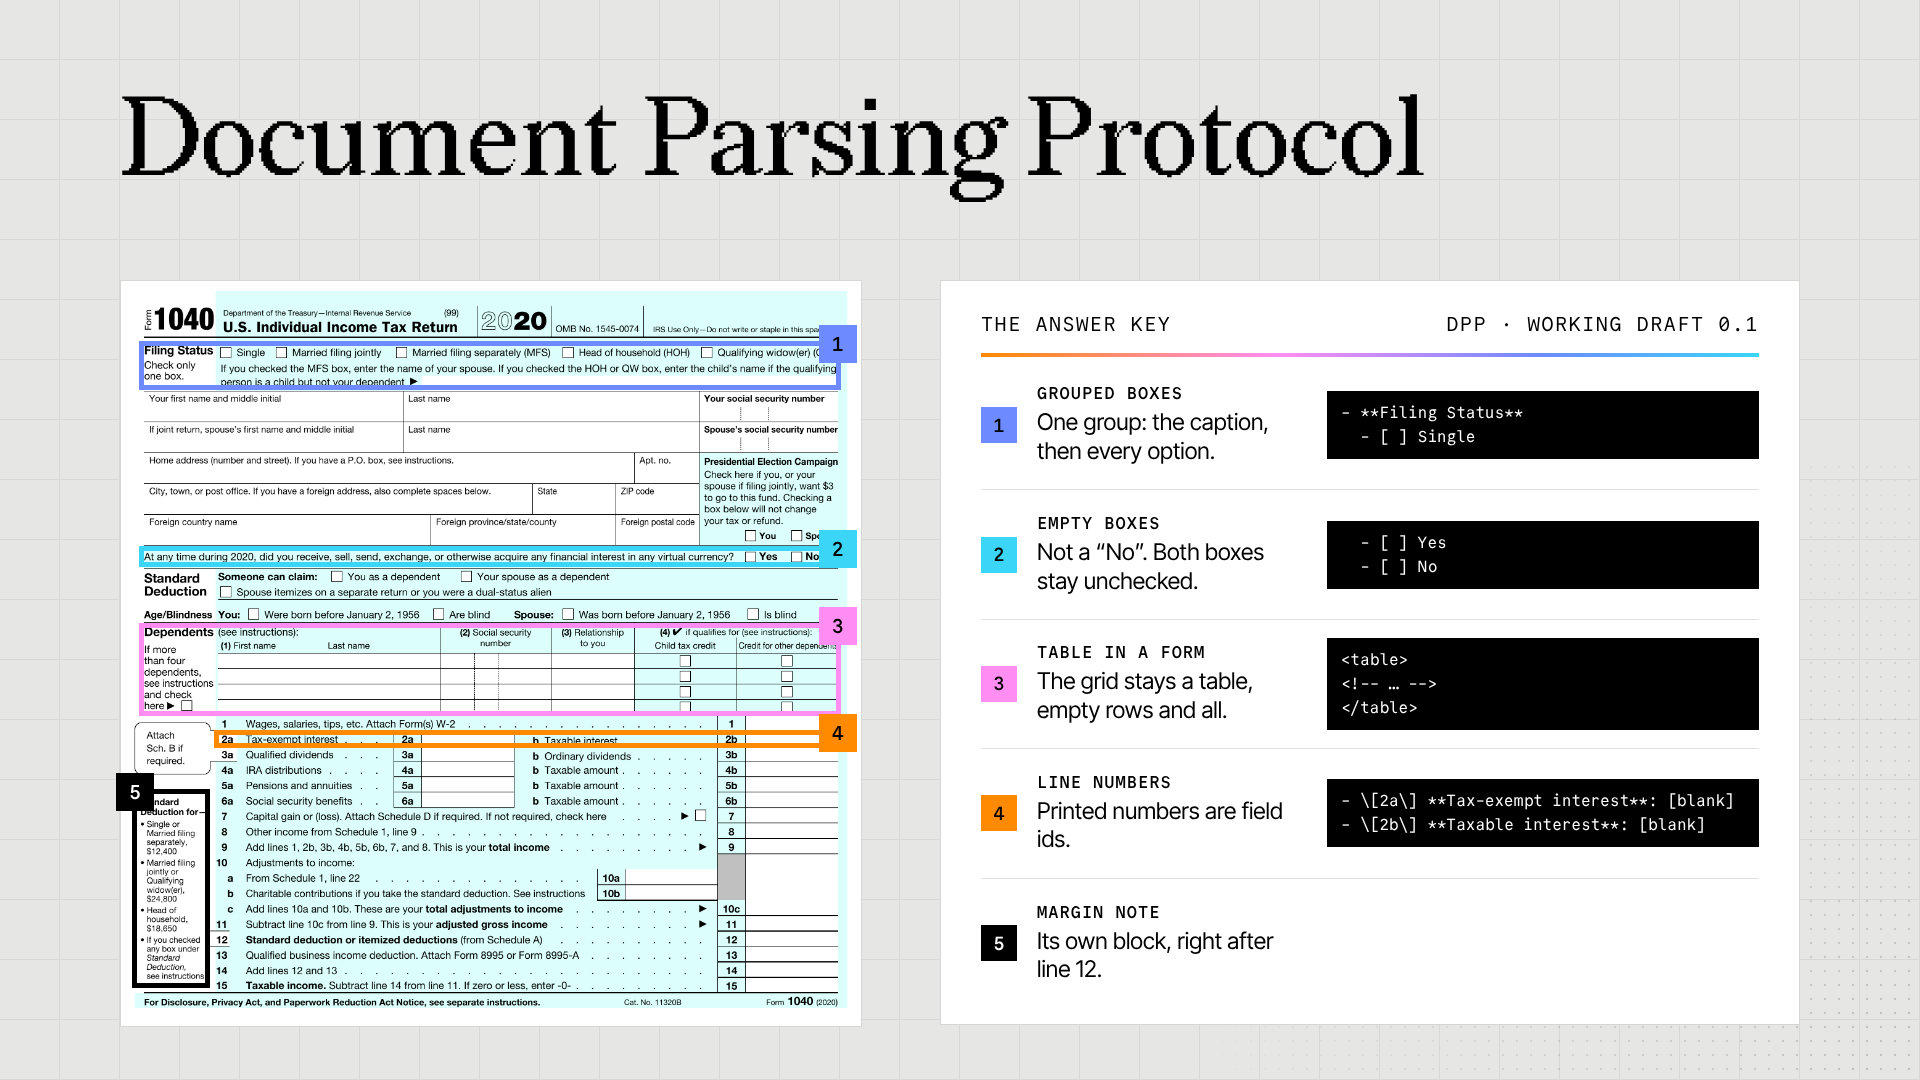
10月28日,LlamaIndex的Jerry Liu发布Document Parsing Protocol工作草案0.1。140条规则,覆盖文本、表格、表单、图表、图示,甚至化学分子式和乐谱。每条规则配示例页和期望输出。它来自ParseBench标注时用的规则集。DPP尚未做成完整评测benchmark,目前是评估指南,用来判断LLM解析文档的质量,也邀请大家讨论什么算“最好”的解析方式。
DPP的答案很具体。Markdown表格表达不了跨列表头,DPP用HTML table保留colspan,2024年下面Q1、Q2、Q3,4.1%在Q2下。表单的空字段写[blank],复选框写[x]和[ ]。表单区域是key-value list,不能因为标签和值对齐就生成两列表格。只有页面印了带框的网格才算表格。这条很关键,很多解析器会把表单字段做成表格,凭空造出页面没有的结构。图表转数值表,一行一个类别,一列一个系列,印刷值原样抄。图示能转Mermaid就转,不能就描述并保留所有标签。PDF里隐藏文字丢掉,看得见但读不出的写[illegible]。位置信息可选,sidecar给出每个元素在页面上的位置,方便回溯。

推文下有人问,140条规则里两条打架谁仲裁;有人问怎么确定性给解析器打分;有人建议输出里标注用了哪条规则,因为下游agent最怕两个解析器都合规但结构不同。还有一条评论提到第二行表头常放单位,flatten后agent拿到一列数字,不知道是欧元还是小时。这些问题DPP没全答。工作草案0.1开放GitHub,让人提issue和PR。DPP也定义了可接受差异,比如thead和tbody包不包都行,只要全文一致。但“谁仲裁”仍是治理问题,写140条规则并不能自动解决。

parseprotocol.com有指南和练习。Claude下载skill zip上传到Customize → Skills,需要code execution;ChatGPT加reference file。附页面图,粘贴站点prompt,让它按DPP解析。Apple FY2024样例页可以检查两个6485是否都保留,(565)括号是否还在。这个样例有8个解析决策的walkthrough。
DPP最有价值的地方不在140条规则本身。它把“解析正确”从各家私有品味变成可公开争论的文本。以前两个团队可以拿同一份输出打出不同分数,现在至少能指着同一条规则吵。对做agent的人,下一步更实际的问题是:当两条规则都合规、输出结构却不同时,下游怎么知道该信哪个。给输出打规则ID可能是个办法,评论里已经有人提了。DPP会不会成为标准,要看它能不能接住这些冲突。规则数量只是表面。
发布时间: 2026-10-29 03:27