Agent 真要吃掉 1000 倍 token?有人先让单任务少用 45%
Particle-1 基于 DeepSeek V4.1 Flash 后训练,在四个软件工程基准上平均少用约 45% token,单任务成本降 34.4% 到 51.6%。争论点不在模型榜单,而在 agent 规模化后的账单。
Aaron Levie 在推文里给 agent 算了一笔账:未来 agent 消耗的 token 会是今天的 1000 倍。理由不复杂,agent 要跑进工作流,处理数据,写软件,做企业安全,还要干很多现在没被自动化的活。
这个判断刚出来,Suhail 就发布了新公司 Particle 和第一个模型 Particle-1。它没有去刷一个更大的榜单,而是把目标放在 token 效率上。Particle-1 基于 DeepSeek V4.1 Flash 1017 做后训练,官方给出的结果是平均少用约 45% token,任务准确率保持在基础模型的置信区间内,任务完成时间也更快。

Particle 的定位是给开放权重模型做推理层。Suhail 在推文里说,智能正在变成世界上最重要的资源之一,但生产它的基础设施仍然昂贵且集中。与此同时,前沿模型和开放权重模型之间的质量差距在缩小。Particle 想做的事,是让智能的成本随着系统效率提升逐渐接近零。

数字先看软件工程。Particle-1 在四个基准上做了测试:Terminal-Bench 2.1、ReactBench、ADE Bench 和 DeepSWE 1.1。和前身 DeepSeek V4.1 Flash 相比,它少用 28.4% 到 52.2% 的输出 token,单任务平均成本低 34.4% 到 51.6%。pass@1 没有明显掉队。
以 DeepSWE 1.1 为例,Particle-1 平均每个任务输出 59,580 个 token,DeepSeek V4.1 Flash 是 83,246,GLM 5.3 Flash 是 98,155。单任务成本分别是 0.2211 美元、0.3368 美元和 0.6523 美元。准确率分别是 72.57%、71.15% 和 66.82%。这组数据里,省钱和任务完成速度是同一件事。
通用能力也没有被牺牲太多。GPQA Diamond 上 Particle-1 是 90.40%,基础模型是 90.91%;Tau Airlines 是 86.00% 对 88.00%;MMLU 是 86.08% 对 85.98%;BabyVision with tools 是 89.18% 对 89.60%。这些数字说明它没有为了省 token 把推理能力砍掉。
训练方法不算神秘,但细节值得技术读者看。Particle 用 Cascade RL 分阶段做后训练,训练栈基于 RadixArk 开源的 Miles,做了异步训练和 rollout、trainer 节点分离。模型上挂了一个 rank-64 的 LoRA 适配器,覆盖所有层的专家,可训练参数大约相当于模型参数量的 1.25%。策略更新用了 GSPO,学习率保持 5e-5,并且没有按组标准差归一化优势。Suhail 说长期目标是连续后训练,像发软件一样快速给模型打改进。
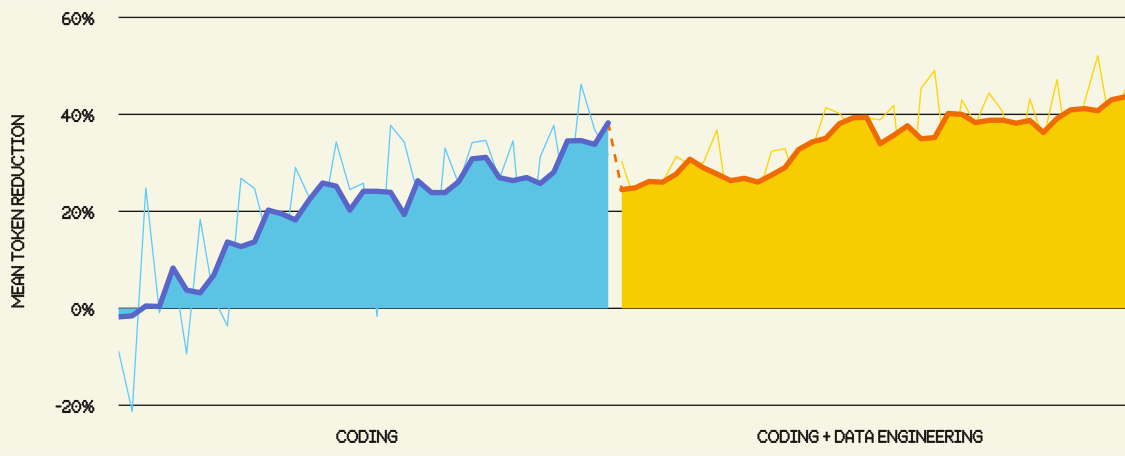
省下来的 token 主要来自推理过程。Terminal-Bench 2.1、ReactBench 和 ADE 上,大约 90% 的 token 节省来自 reasoning token。DeepSWE 1.1 上,工具调用文本也贡献了约 30%。模型的行为变化很具体:同样的动作少绕几圈,任务完成就停,少做重复检查和长篇确认,少几轮试错和修补,探索和验证更聚焦。
一个 Git 部署任务里,Particle-1 输出 15,892 个 token,基础模型是 47,006 个,少了 66.2%。两者都成功验证了分支部署,但 Particle-1 在部署检查和完成确认上少写了很多推理,最后两次确认调用从 11,445 个 token 降到 1,765 个。
另一个日历调度任务里,两个模型都用了四次模型调用和六条命令,最终结果都对。Particle-1 的节省来自更短的推理,大约 94% 的 token 节省发生在正确文件已经写完之后,完成和确认部分从 5,193 个 token 降到 1,078 个。
代码之外也有早期信号。Particle 在 Harvey LAB 的合同审查任务上试了 Particle-1,标准适配器强度下,输出 token 比基础模型少 24.6%,八份报告全部通过严格检查。把适配器强度拉到 2 倍和 4 倍,token 还能再省,但会有一到两份报告漏掉一个标准。拉到 8 倍,输出少了 78.7%,只有三份报告通过。压缩冗余分析的同时,也可能压掉有用的限定条件。
评论区没有一边倒。有回复说,1000 倍 token 只有在每 token 成本同步下降时才成立,否则只是没人批准的更大账单。有人问,这个 token 节省能不能在 Opus 级模型上复现。也有人认为,大量 agent 步骤根本不需要前沿模型,本地 27B 模型已经够用。还有一条评论盯着定价方式:当 agent 按小时跑检查,按人头订阅会显得越来越不合理。
这些质疑比发布数字更有意思。Agent 规模化之后,单任务 token 数会变成真正的价格标签。模型榜单告诉你谁更聪明,token 效率告诉你谁能被长期跑下去。Particle-1 先切的是软件工程,但它押注的方向很清楚:如果 agent 真会消耗 1000 倍 token,省 token 就不是小优化,而是能不能规模化的前提。
发布时间: 2026-10-29 05:37