Particle-1 没降单价,靠少用 45% token 把成本打下来
Suhail 新公司 Particle 发布首个模型 Particle-1,基于 DeepSeek V4.1 Flash 后训练。四个软件工程基准上输出 token 少 28.4% 到 52.2%,成本低 34.4% 到 51.6%,准确率保持相当。定价和 base 模型一样,省钱来自模型更早停手。
Suhail 的新公司 Particle 发布首个模型 Particle-1。它把重点放在 token 效率上。官网写得很直白:Particle 要做开放权重模型的推理层,快、便宜、可靠。Particle-1 基于 DeepSeek V4.1 Flash 1017 做后训练,官方说在多种任务上平均少用约 45% token,准确率保持相当。

token 是模型读写的最小计费单位。推理、工具调用、最终确认都会烧 token。对开发者,token 少意味着账单低;对终端用户,token 少还意味着任务更早结束。Particle 抓的就是这个点。Particle 选择在 DeepSeek V4.1 Flash 上做后训练,把模型往少推理、早停手、少返工的方向推。
四个基准的数据摆在一起看更清楚。DeepSWE 1.1、Terminal-Bench 2.1、ReactBench、ADE Bench 都围绕软件工程和数据分析任务。Particle-1 的输出 token 分别是 59.6k、24.8k、41.3k、9.6k。DeepSeek V4.1 Flash 是 84.2k、39.4k、67.5k、20.2k。GLM 5.3 Flash 是 98.2k、67.5k、148.1k、21.6k。差距最大的是 ReactBench,Particle-1 的输出 token 比 GLM 5.3 Flash 少约 72%。

官方汇总口径是:四个基准上输出 token 少 28.4% 到 52.2%,每个任务平均成本低 34.4% 到 51.6%,pass@1 落在 base 模型的置信区间内。以 DeepSWE 1.1 为例,Particle-1 每任务成本 0.2211 美元,DeepSeek V4.1 Flash 是 0.3368 美元,GLM 5.3 Flash 是 0.6523 美元。平均输出 token 是 59,580 对 83,246 对 98,155。准确率是 72.57% 对 71.15% 对 66.82%。这里有个反常识的点:Particle-1 的单价没有比 DeepSeek V4.1 Flash 低。官网脚注写,两者都是每百万 token 未缓存输入 0.30 美元、缓存输入 0.006 美元、输出 1.20 美元。省钱来自 token 少。单价没有变化。这个区别很重要。模型价格战打到今天,单纯降单价的空间在变小,后训练把单位任务的 token 压下去,是另一条路。
训练方法不复杂,但细节密。Particle 把后训练拆成连续阶段,按 Cascade RL 的思路先训 coding,再训 coding 加 data engineering。内部用 Datamaker 合成任务,任务按 Harbor 格式组织,交给 Terminus 2 agent 执行,并且每条任务都有验证结果的方式。训练栈建在 RadixArk 的开源 RL 框架 Miles 上,分布式异步训练,rollout 和 trainer 分节点。团队改了 SGLang rollout 引擎和 Megatron 训练引擎,减少 trainer 和推理之间的偏差。模型上挂了一个 rank-64 的 LoRA adapter,覆盖所有层的 experts,可训练参数约等于模型参数量的 1.25%。策略更新用 GSPO,学习率固定 5e-5,按 Dr. GRPO 的做法不按组标准差归一化优势。
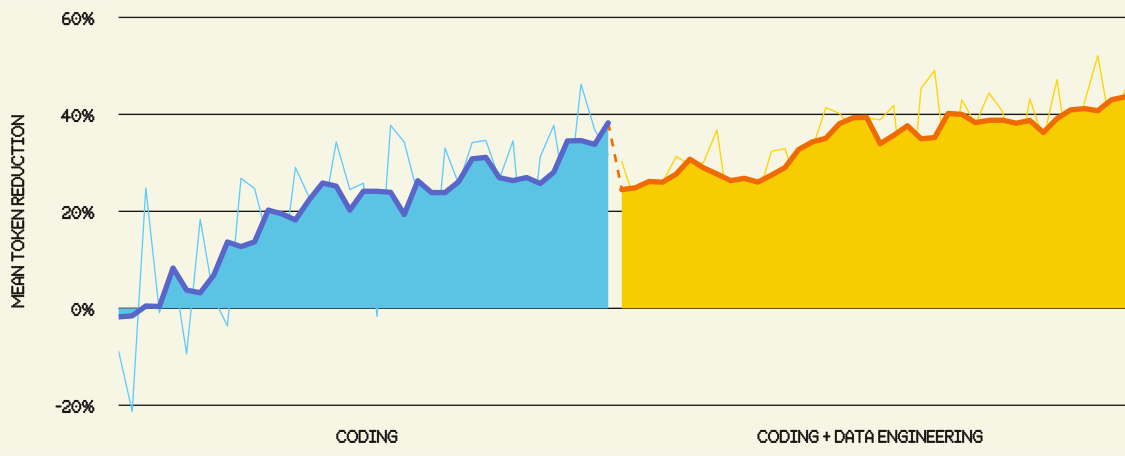
token 省在哪里,官方拆了四类:同样的动作少推理;任务完成后少反复检查;少几轮试错修复;探索和验证更聚焦。Terminal-Bench 2.1、ReactBench、ADE 上,推理 token 贡献了约 90% 的节省。DeepSWE 1.1 上,工具调用文本也贡献了约 30%。这解释了一个容易忽略的点:token 效率不只影响账单,也影响任务时延。模型少写几轮确认,用户就少等一会儿。
泛化证据还早。Particle 拿 Harvey LAB 的合同审查任务做了个例子:读四份法律文件,检查仲裁条款是否符合仲裁机构规则,写 Word 报告标出偏差、严重度和建议。标准 1x adapter 下,Particle-1 比 base 模型少 24.6% 输出 token,8 份报告都过检查;base 模型准确率 62.5%。把 adapter 强度拉到 2x、4x,token 再降 47.8%、60.2%,但各有 1 到 2 份报告漏掉一个标准。拉到 8x,输出少 78.7%,只有 3 份报告过严格检查。这个结果挺有意思:压 token 压过头,会把有用的限定条件一起压掉。合同审查只是一个任务,8 次 rollout,不能当成普遍结论,但它提醒了 token 效率的边界。
产品已经可用。Particle-1 通过 Particle API 提供,官网写支持零数据保留,托管在美国。开发者可以拿 API key 接自己的 harness 或 agent 工作流。文档在 docs.particle.ai,模型页还列了 DeepSeek V4.1 Flash 和 GLM 5.3 Flash。Particle 的招聘页在找后训练研究工程师、推理性能工程师、产品工程和销售,地点旧金山。Suhail 在推文里说,目标是让智能像电力一样可及和充足。这话很大,但 Particle-1 至少给了一个可验证的小切口:单位任务少烧 token。
评论区有人关注品牌,有人感叹发布节奏。Linus 说 2027 会是每天转头的一年。Jon Cheney 回,release notes 都快追不上,更别说都接进工作,已经开始一周只挑一个新东西认真接进真实工作。这个反应比任何口号都具体。模型发布越来越密,真正稀缺的是把某一个新东西接进流程的耐心。
想试的人可以直接去 particle.ai 拿 API key,博客里有完整评测和训练细节。链接:https://particle.ai/blog/introducing-particle-1
发布时间: 2026-10-29 04:34