SWE-bench 从 7.3% 到 27.5%,AMD MI355X 上的 agent RL 卡在沙箱和长尾
LMSYS 和 AMD 用 Miles 在 MI355X 上训练 Qwen3-30B-A3B 的 SWE agent。结果很硬:SWE-bench Verified 子集 pass@1 从 7.3% 到 27.5%,rollout 吞吐约 4 倍。报告里更有意思的是,训练慢的主因多次被误判成 GPU,实际常是长尾轨迹、CPU 沙箱和隐藏并发上限。
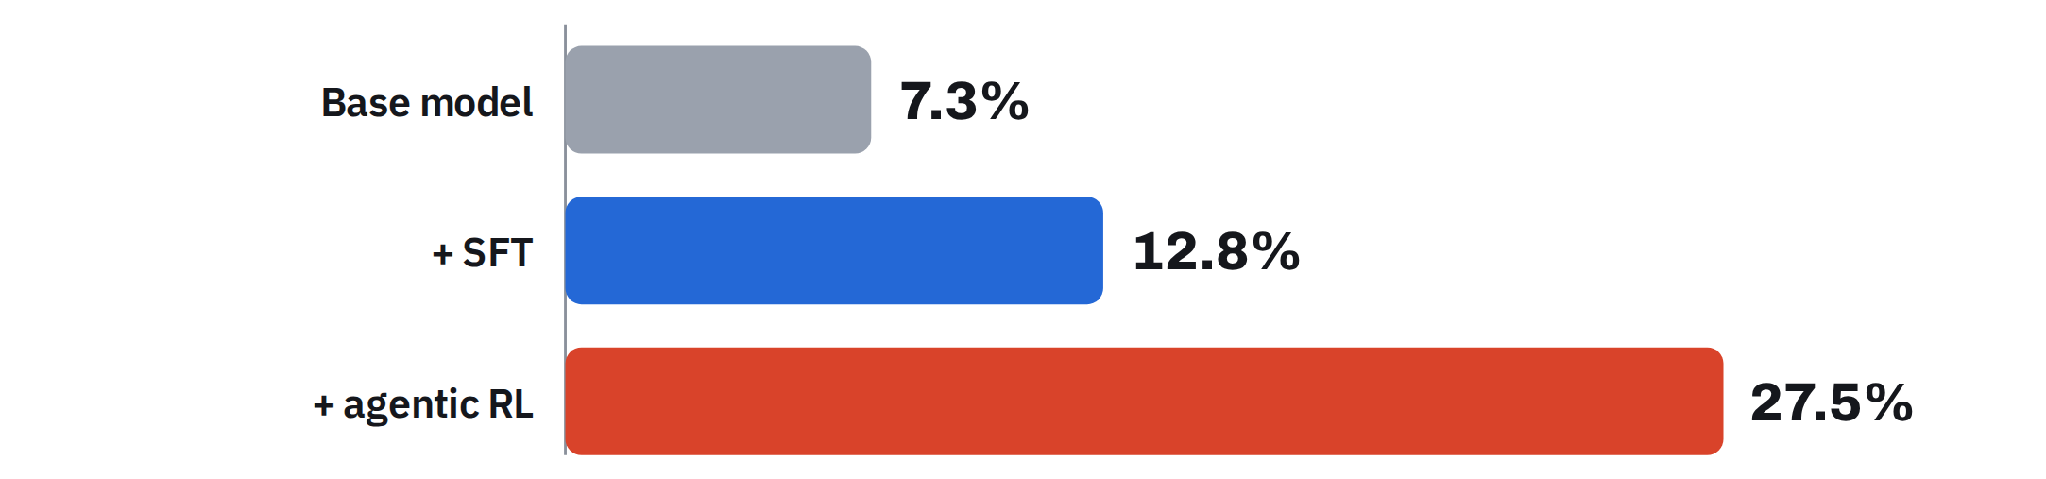
LMSYS Org 转发了一份 AMD 和 Miles 团队的技术报告:在 AMD Instinct MI355X 上,用 Miles、SGLang、Megatron-LM、Harbor 训练 Qwen3-30B-A3B-Instruct 的 SWE agent。最终在 SWE-bench Verified 的 100 个分层任务上,每题 4 次尝试,pass@1 从 7.3% 提到 27.5%。

先把增益拆开。SFT 在约 4000 条公开 agent traces 上跑一个 epoch,把 pass@1 拉到 12.8%。随后异步 GRPO 在约 1350 个 SWE-smith 任务上训练,任务来自 47 个仓库,且不出现在 SWE-bench Verified 里。RL 再贡献 14.7 个百分点,最终到 27.5%。这个增益测的是策略在 RL 阶段没见过的代码库。
Agentic RL 的样本是一整段 episode:模型读 issue,在沙箱里跑 20 到 100+ 条 shell 命令,改代码,最后仓库测试通过才拿 reward。一个 GRPO group 要等最慢的尝试结束才能打分。报告观察到同一任务两次尝试长度能差 2.5 倍。长尾直接拖住训练。
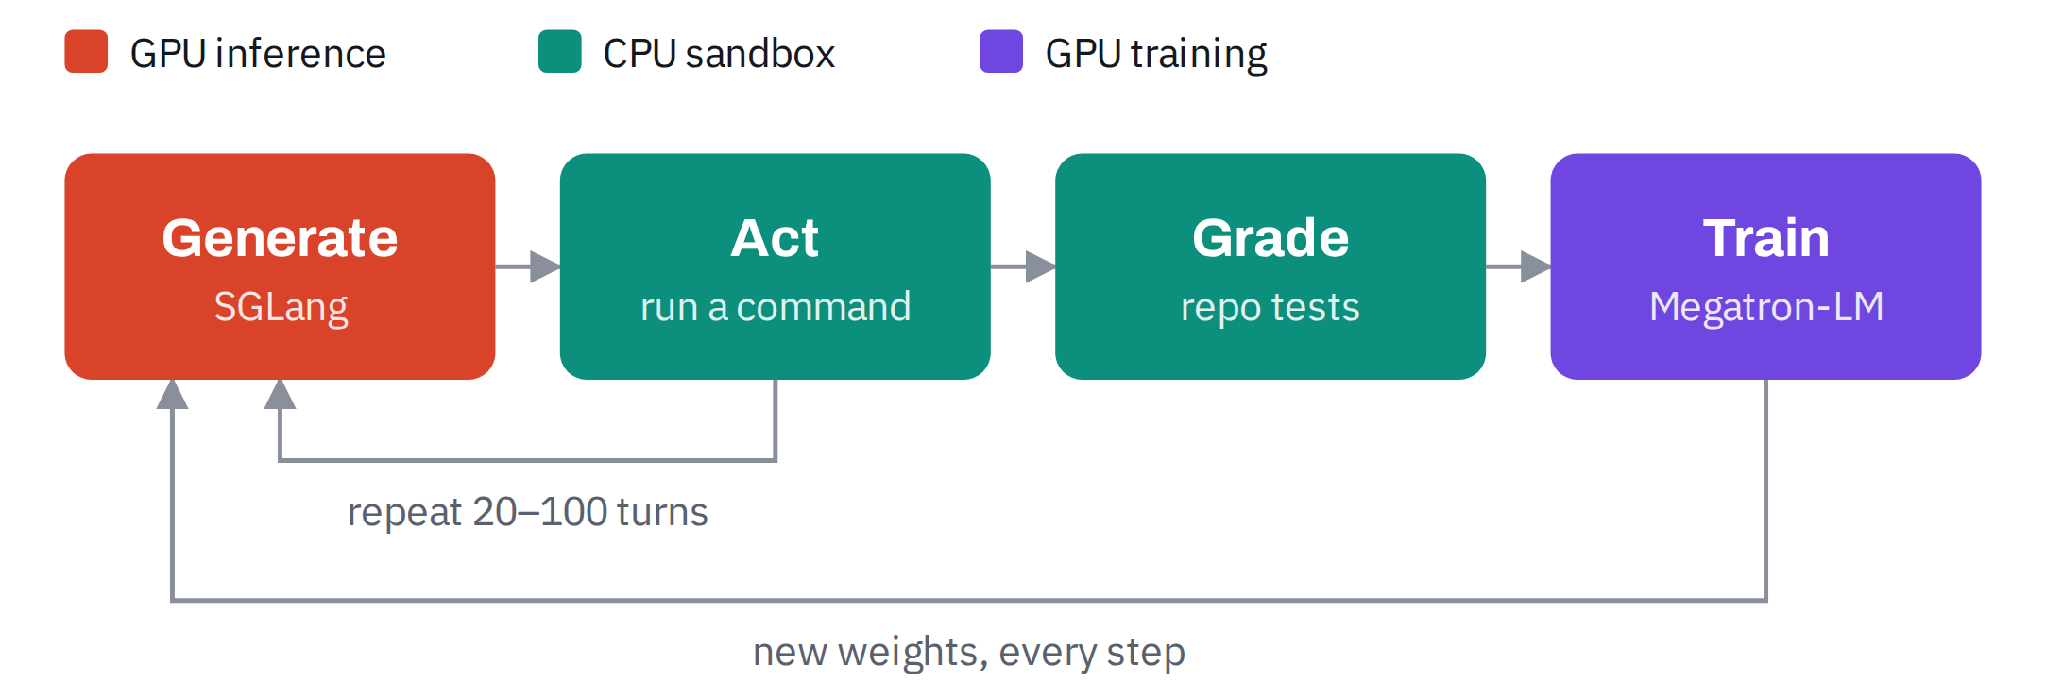
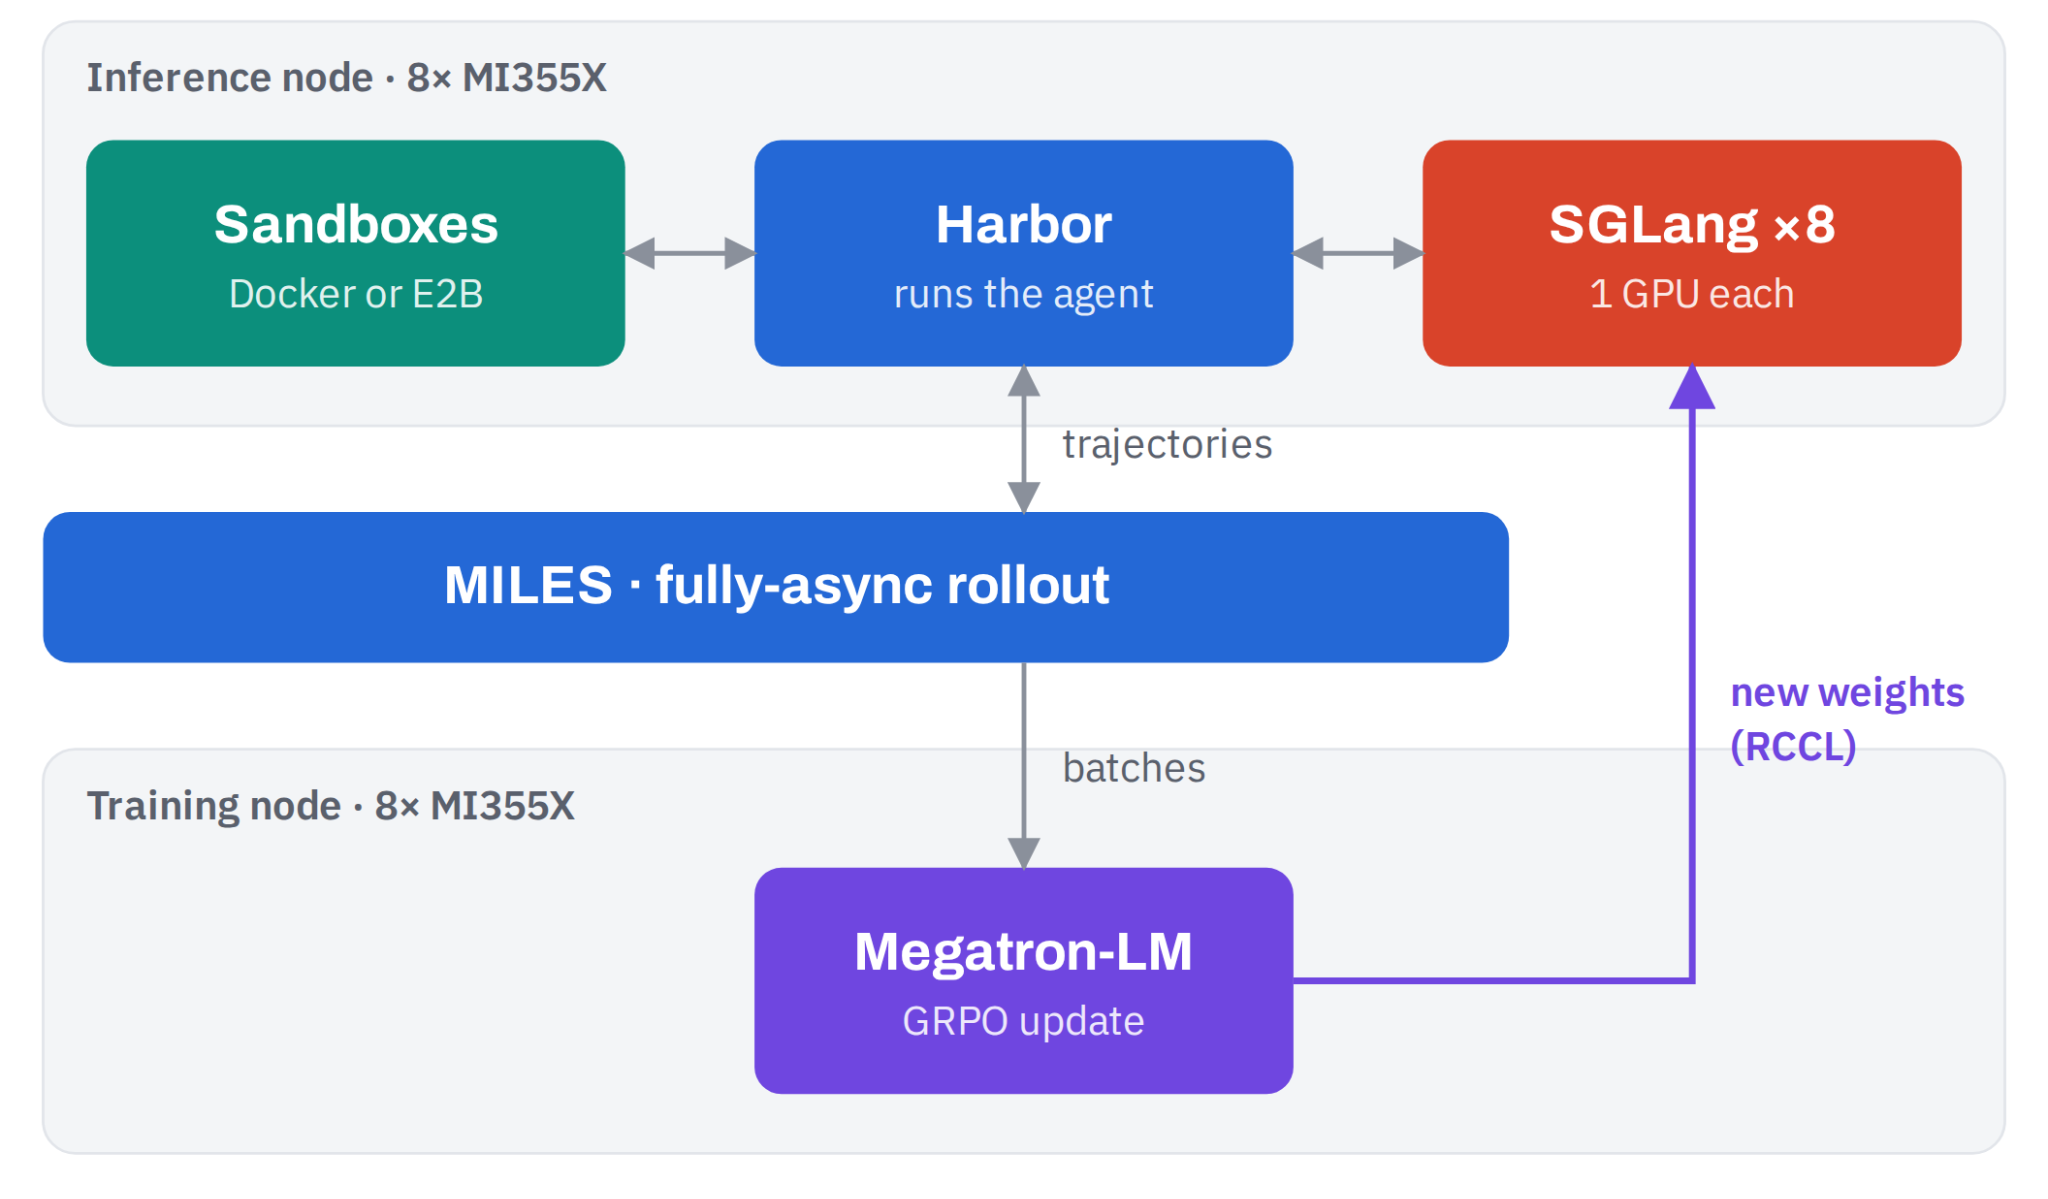
架构上,推理和训练分节点。推理节点跑 8 个单 GPU SGLang 引擎和 Harbor,Harbor 管沙箱。训练节点跑 Megatron-LM,把新权重推回引擎。训练完全异步,rollout 和训练重叠。训练器攒够完成轨迹就往前走,不等最慢的。
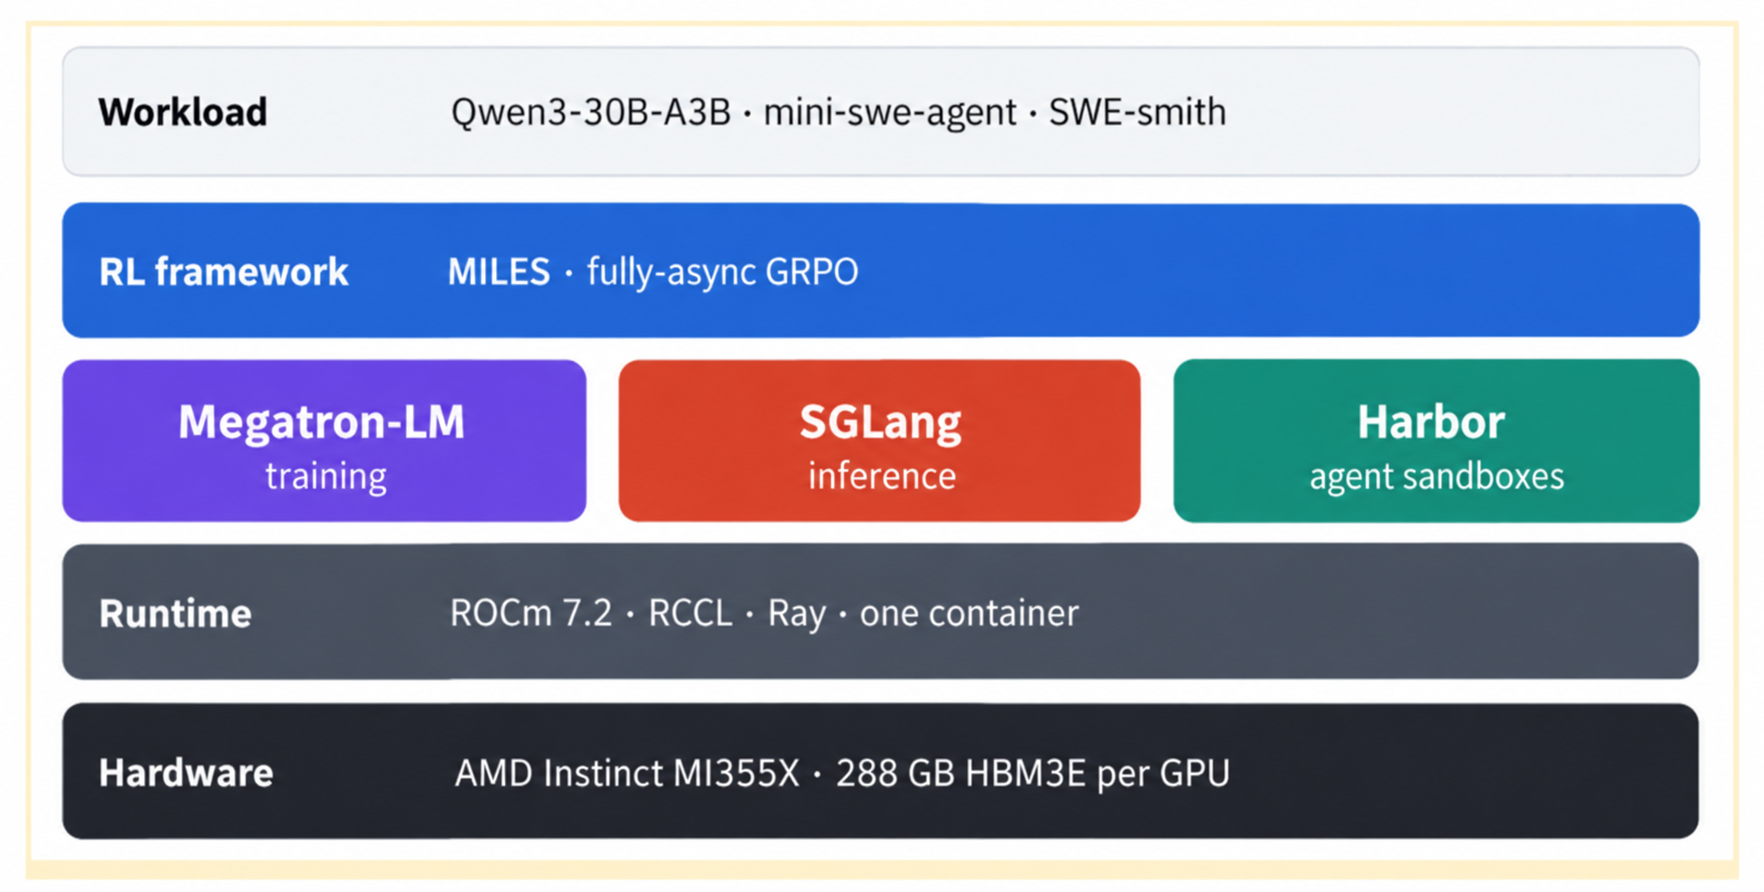
软件栈全是开源件,打在一个 ROCm 容器里:Miles 做完全异步 GRPO,SGLang 推理,Megatron-LM 训练,Harbor 管 agent 和沙箱,ROCm 7.2,硬件是 MI355X,每颗 GPU 288GB HBM3E。
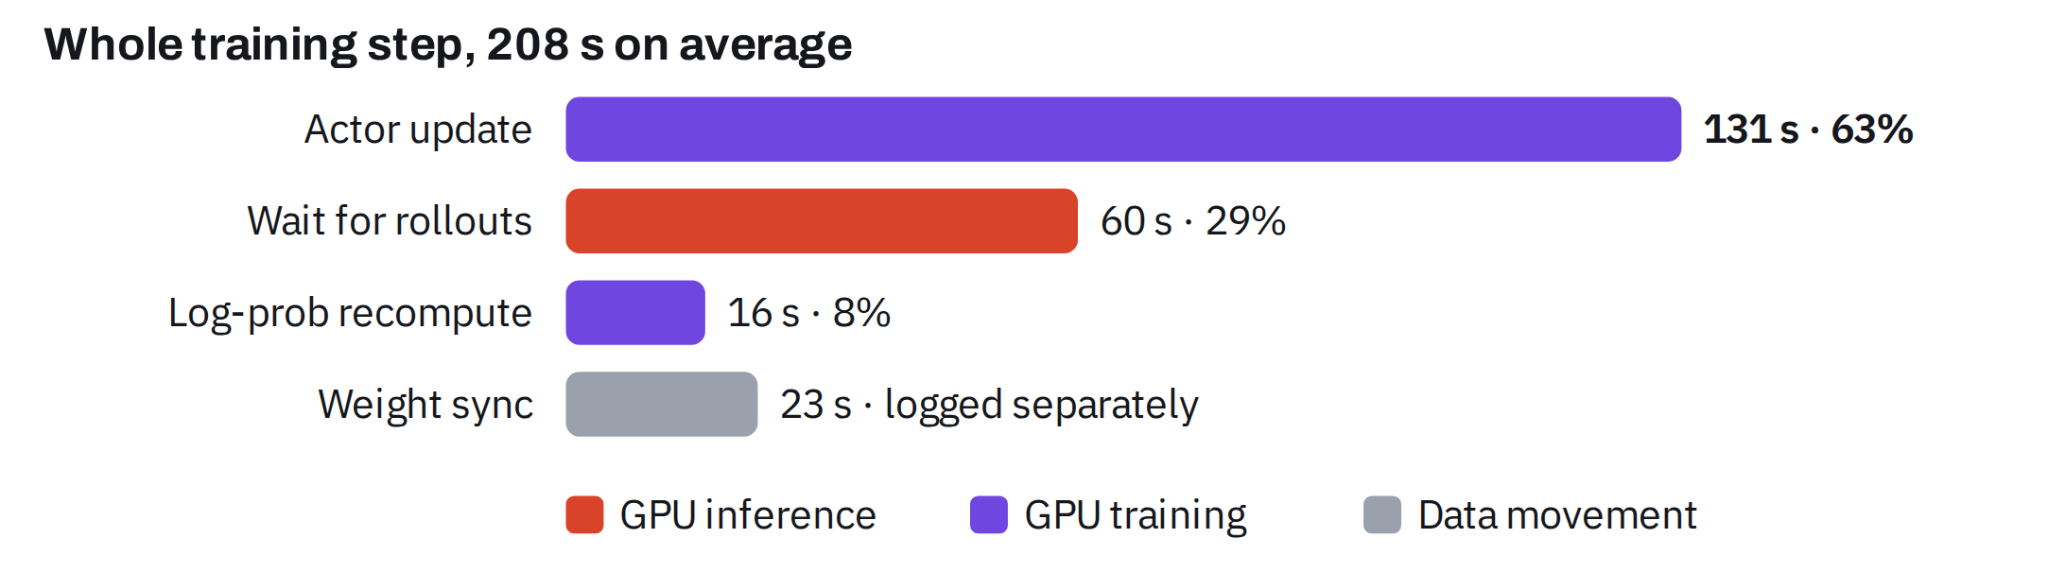
训练侧 step 时间拆解:actor update 占 63%,等 rollout 占 29%,logprob 重算占 8%。权重同步单独记账。他们用完全异步训练加更紧的长度上限,把 step 从 850 秒降到 284 秒,约 3 倍。成功轨迹不受影响。
长尾有多长。84% 的轨迹跑到 turn cap,成功轨迹中位数只需要 8 轮。32% 的 rollout 时间发生在 90% 轨迹已经完成之后。最慢的 AnyIO 尝试用了 28.8 分钟。图上看着像 GPU 在等,实际是 batch size 接近 1 的解码尾巴。
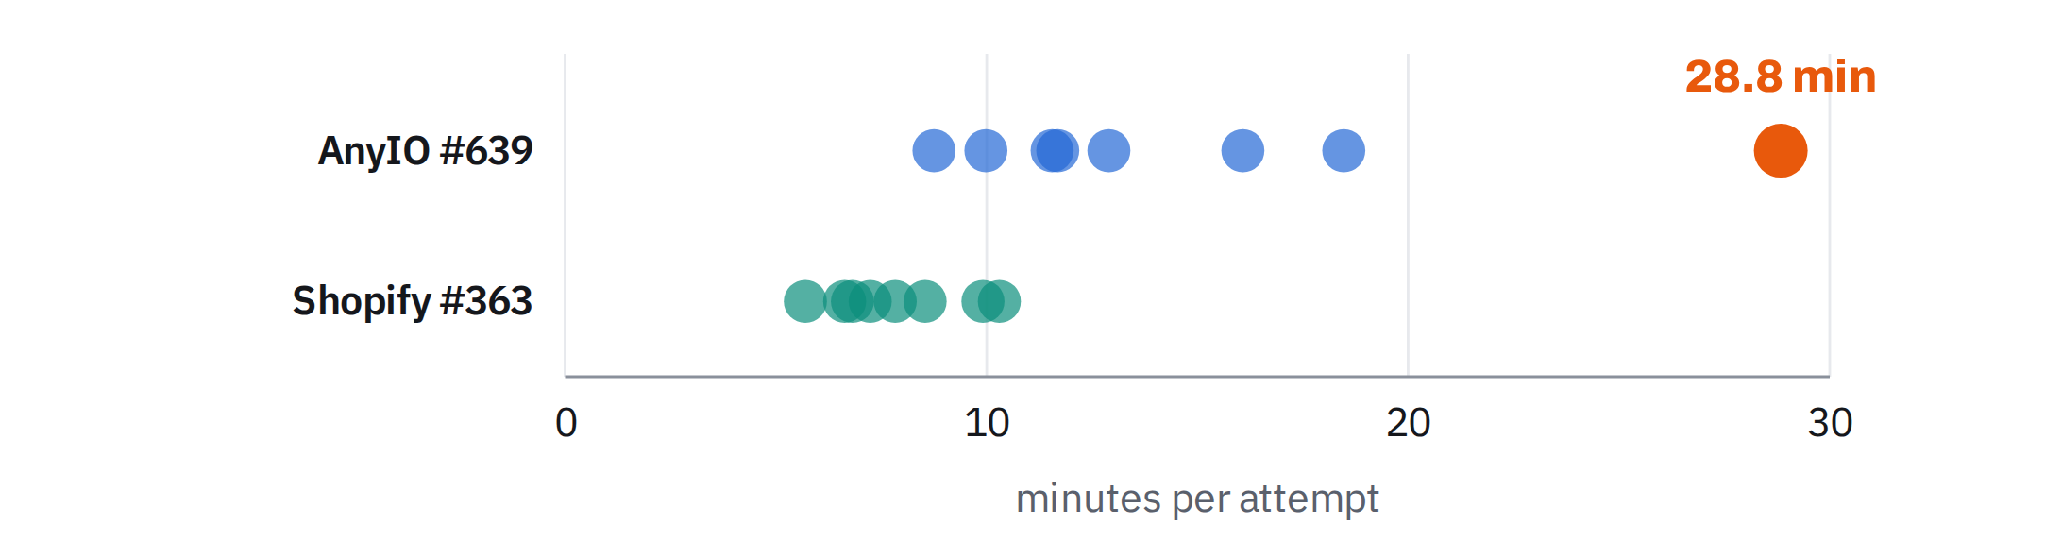
KV cache 也踩坑。64K token 轨迹按文中数字要 6.3GB KV cache。引擎没设上下文上限时,少数生成长到 113K 到 186K token,约 10 条就填满 1.5M token 的 KV cache,同引擎另外 99 个请求排队到超时。把引擎上下文卡在 64K 后问题消失。
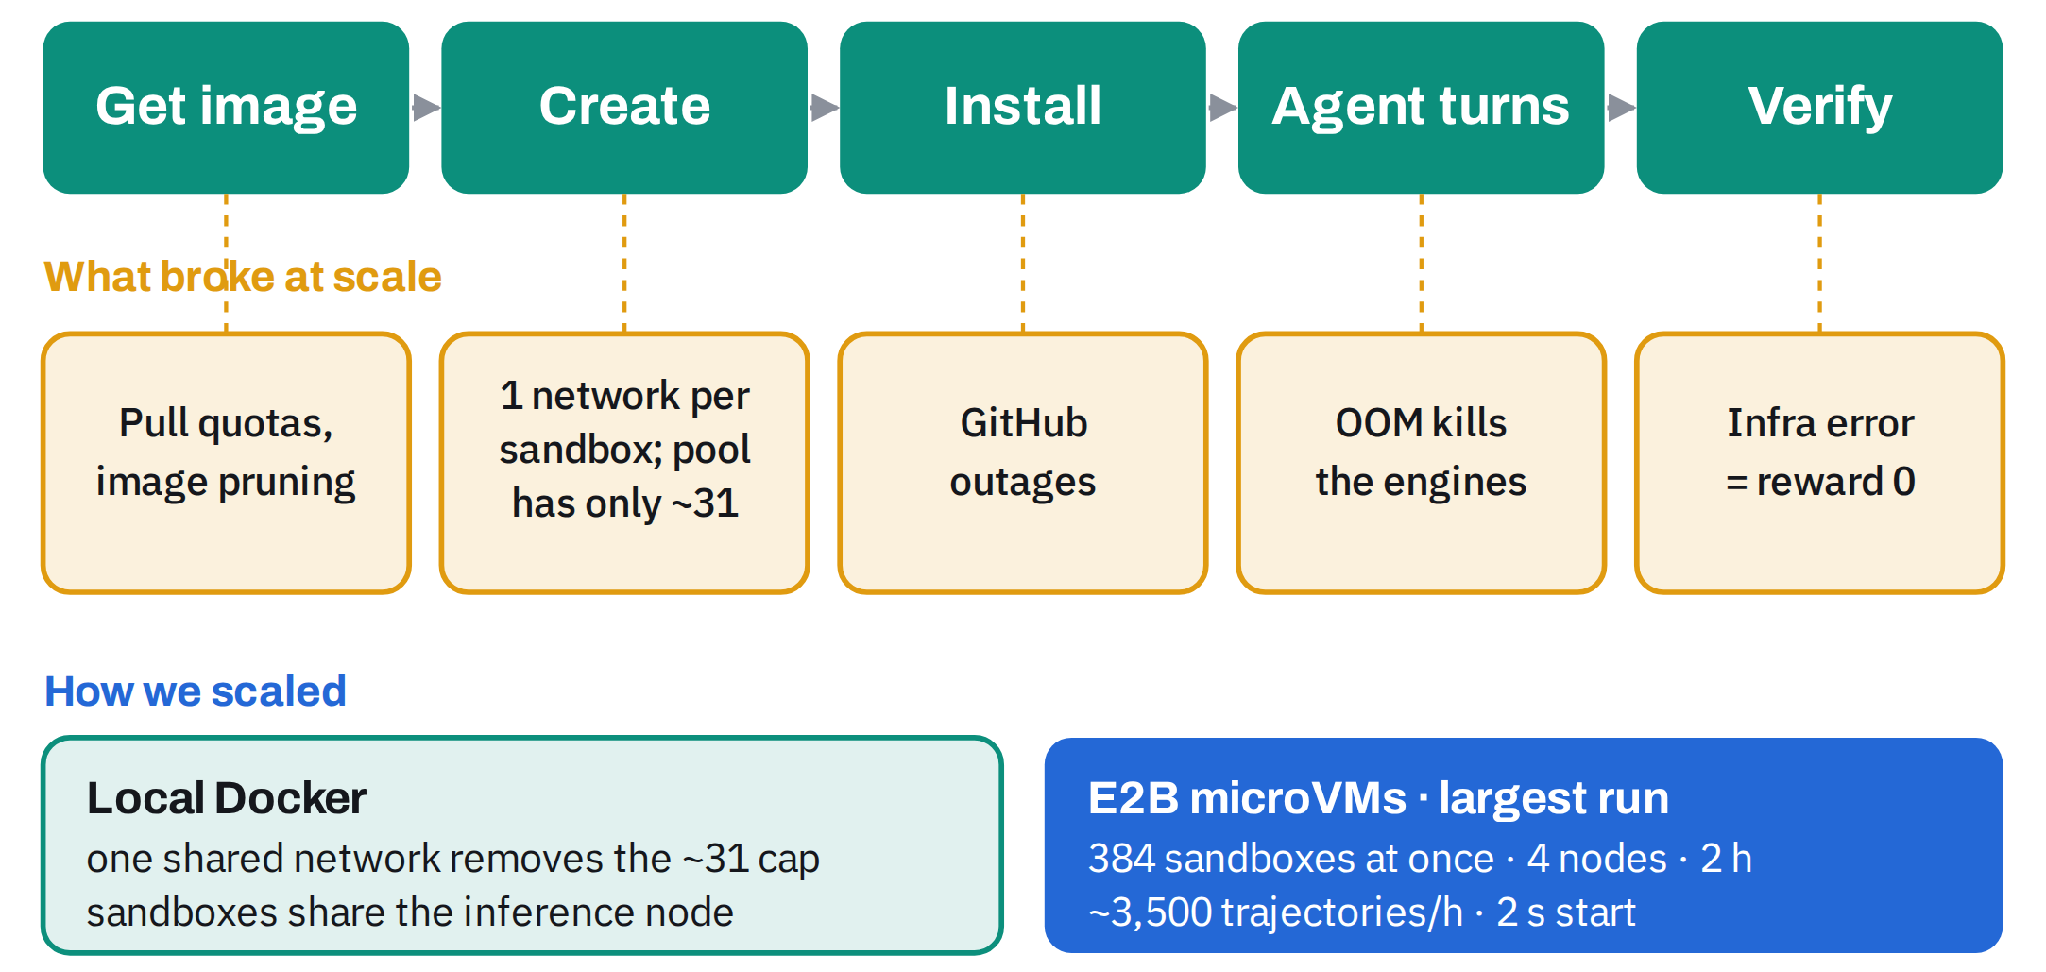
CPU 沙箱是另一条关键路径。每条轨迹要独立环境,装依赖、跑测试。上百条在飞时,沙箱就是 CPU 舰队。团队把沙箱移到 E2B 云 microVM,2 vCPU 4GB,384 条并发,4 个节点上 24 个单 GPU SGLang 引擎,每引擎 16 条。rollout 吞吐到约 3480 条/小时,约 4 倍于本地 Docker 基线。
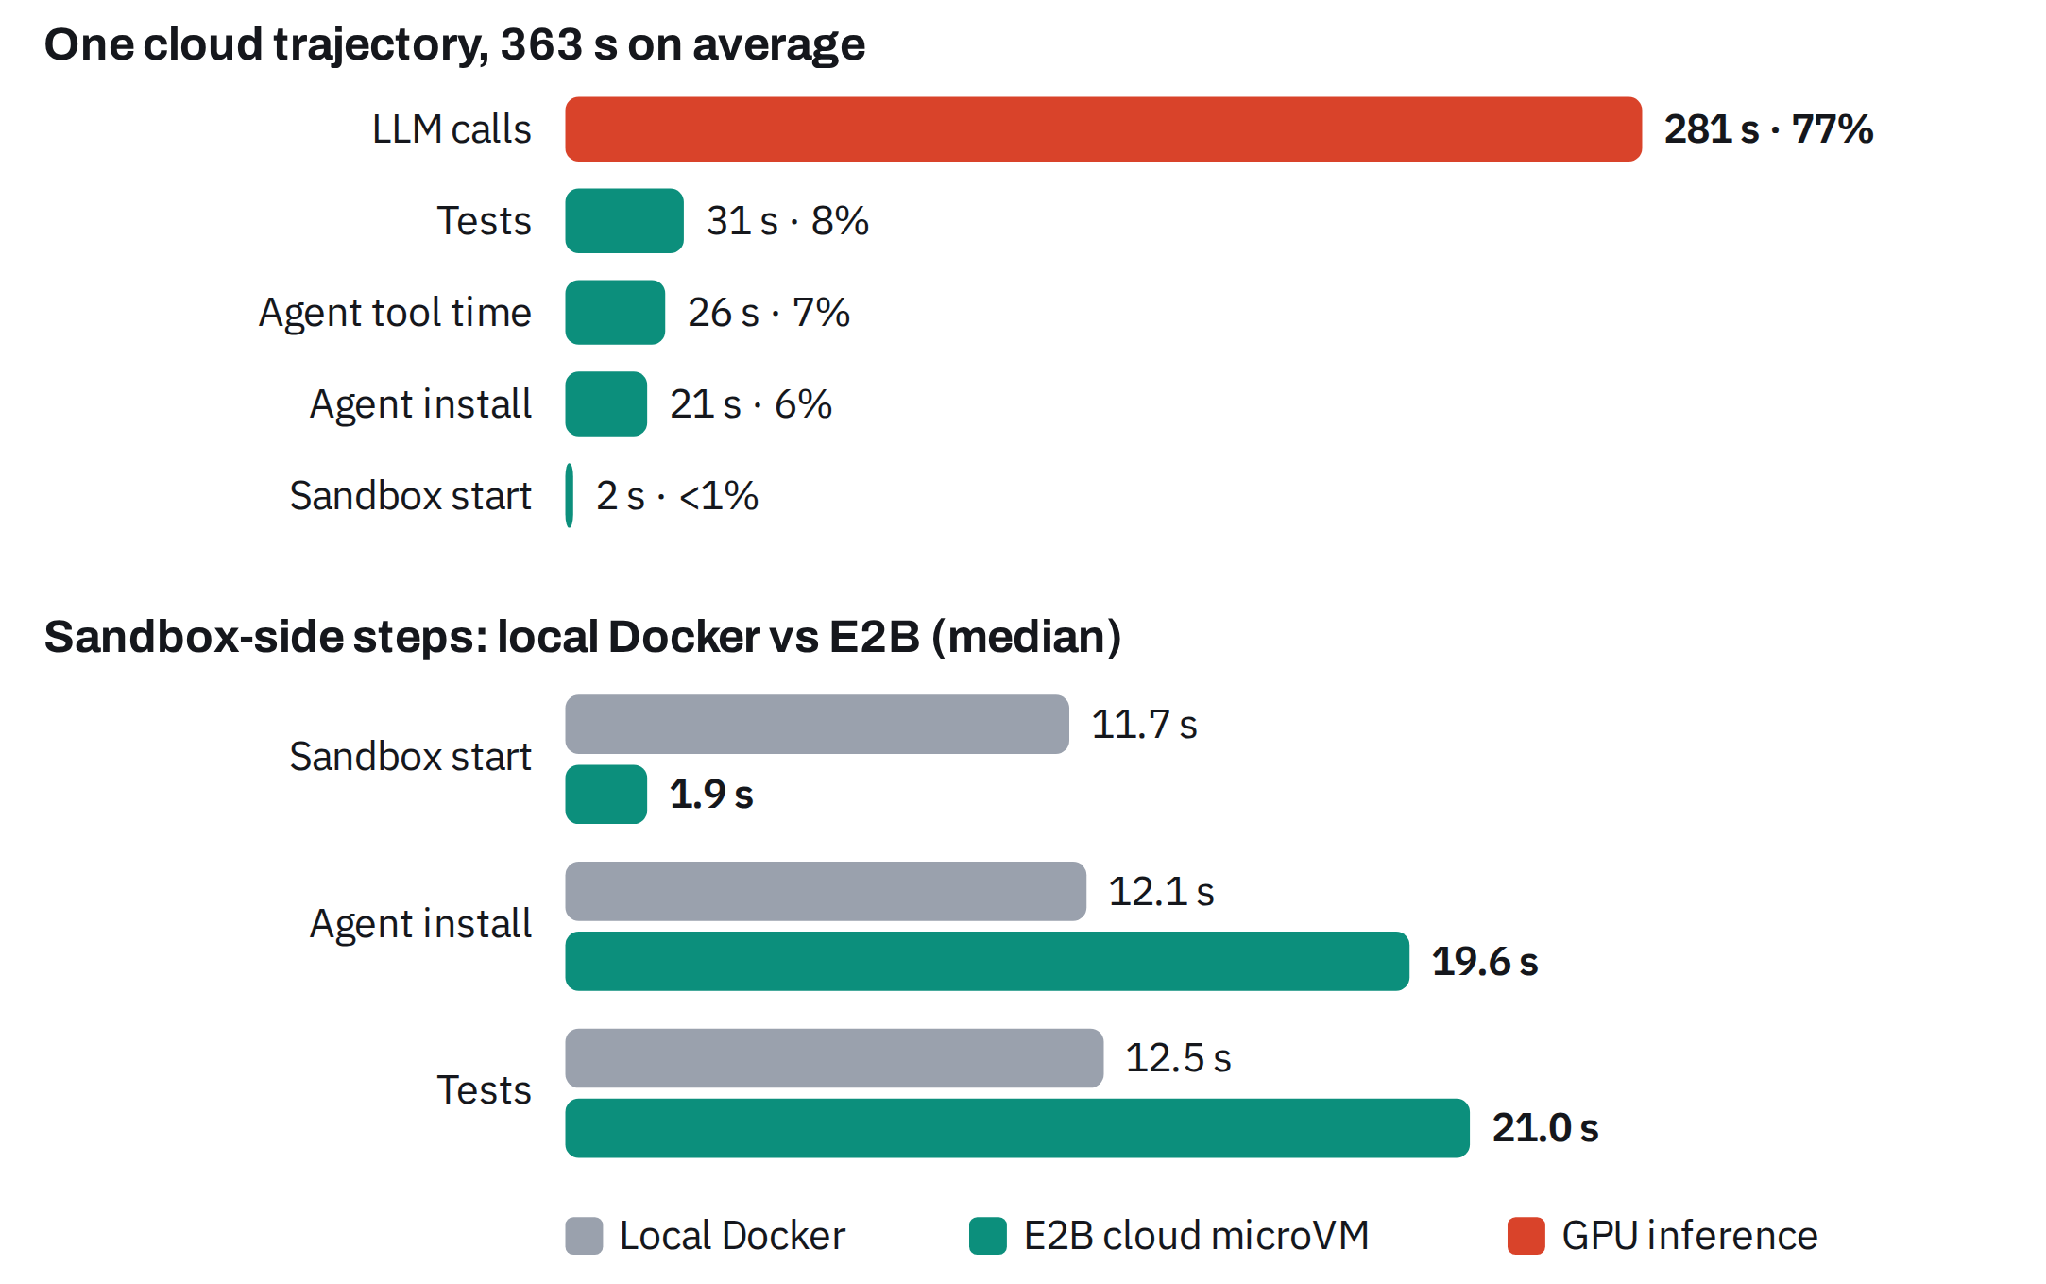
代价也清楚:云沙箱启动中位数 1.9 秒,p99 3.7 秒,384 并发下不抖;本地 Docker 在负载下 11.7 秒。装 agent 慢 7.5 秒,跑测试慢 8.5 秒,每次 LLM 调用过隧道约 0.26 秒。单条轨迹多 15 到 40 秒,占 4% 到 11%。云轨迹里 LLM 调用占 77%,测试、工具、安装、启动合计 22%。
384 并发时引擎队列是空的,KV cache 最多用 23%。限制在沙箱并发,不在 GPU。稳定状态下 2.6% 轨迹失败,300,500 次隧道 LLM 调用里 0.09% 报错。
报告里最值得抄走的一条:基础设施错误会变成错误 reward。3.1% 轨迹以基础设施错误结束,评分是 0,和改错代码一样。策略为基础设施背锅。这些失败必须记录并过滤。
他们还列了隐藏上限:每台机器最多 31 个 Docker 网络,整个集群每小时 100 次镜像下载,Miles 里 100 个 agent 连接,一个 CPU 核处理所有 agent 请求。扩并发时先撞这些固定 cap。加带宽没用,删 cap 才有用。
关键修复表:
| 修复 | 问题 | 效果 |
|---|---|---|
| 限制轨迹长度 | 失败 agent 能循环 200+ 轮,拖住 step | step 快 3 倍 |
| 移除隐藏并发上限 | HTTP 池把 agent 卡在 100;一个代理进程串行化所有 LLM 调用 | 与推理扩容、云沙箱一起贡献约 4 倍 rollout 增益 |
| 共享沙箱网络 | Docker 每节点只允许约 31 个沙箱网络 | 每节点可跑数百沙箱 |
| 引擎侧限制上下文 | 失控生成填满 KV cache | 不再 KV thrashing |
| 固定 NCCL 网卡 | 跨节点权重同步选到重复 Docker IP 后挂住 | 同步可靠 |
| 保留 HIP graphs 并加 watchdog | 罕见 GPU fault;关 graphs 吞吐减半 | 满速,自动恢复 |
吞吐结果:训练 step 850 秒到 284 秒,rollout 约 860 到约 3480 条/小时,并发轨迹约 100 到 384,负载下 LLM 调用延迟 12.6 秒到 4.4 秒。报告说明这些数字来自 2 到 4 个 MI355X 节点,模型和 RL 配方固定。约 4 倍 rollout 吞吐混合了推理从 1 个 8 卡节点扩到 3 个、云沙箱、去掉并发限制。约 3 倍 step 加速来自同一 8 卡推理节点上限制轨迹长度。两组对比分开。
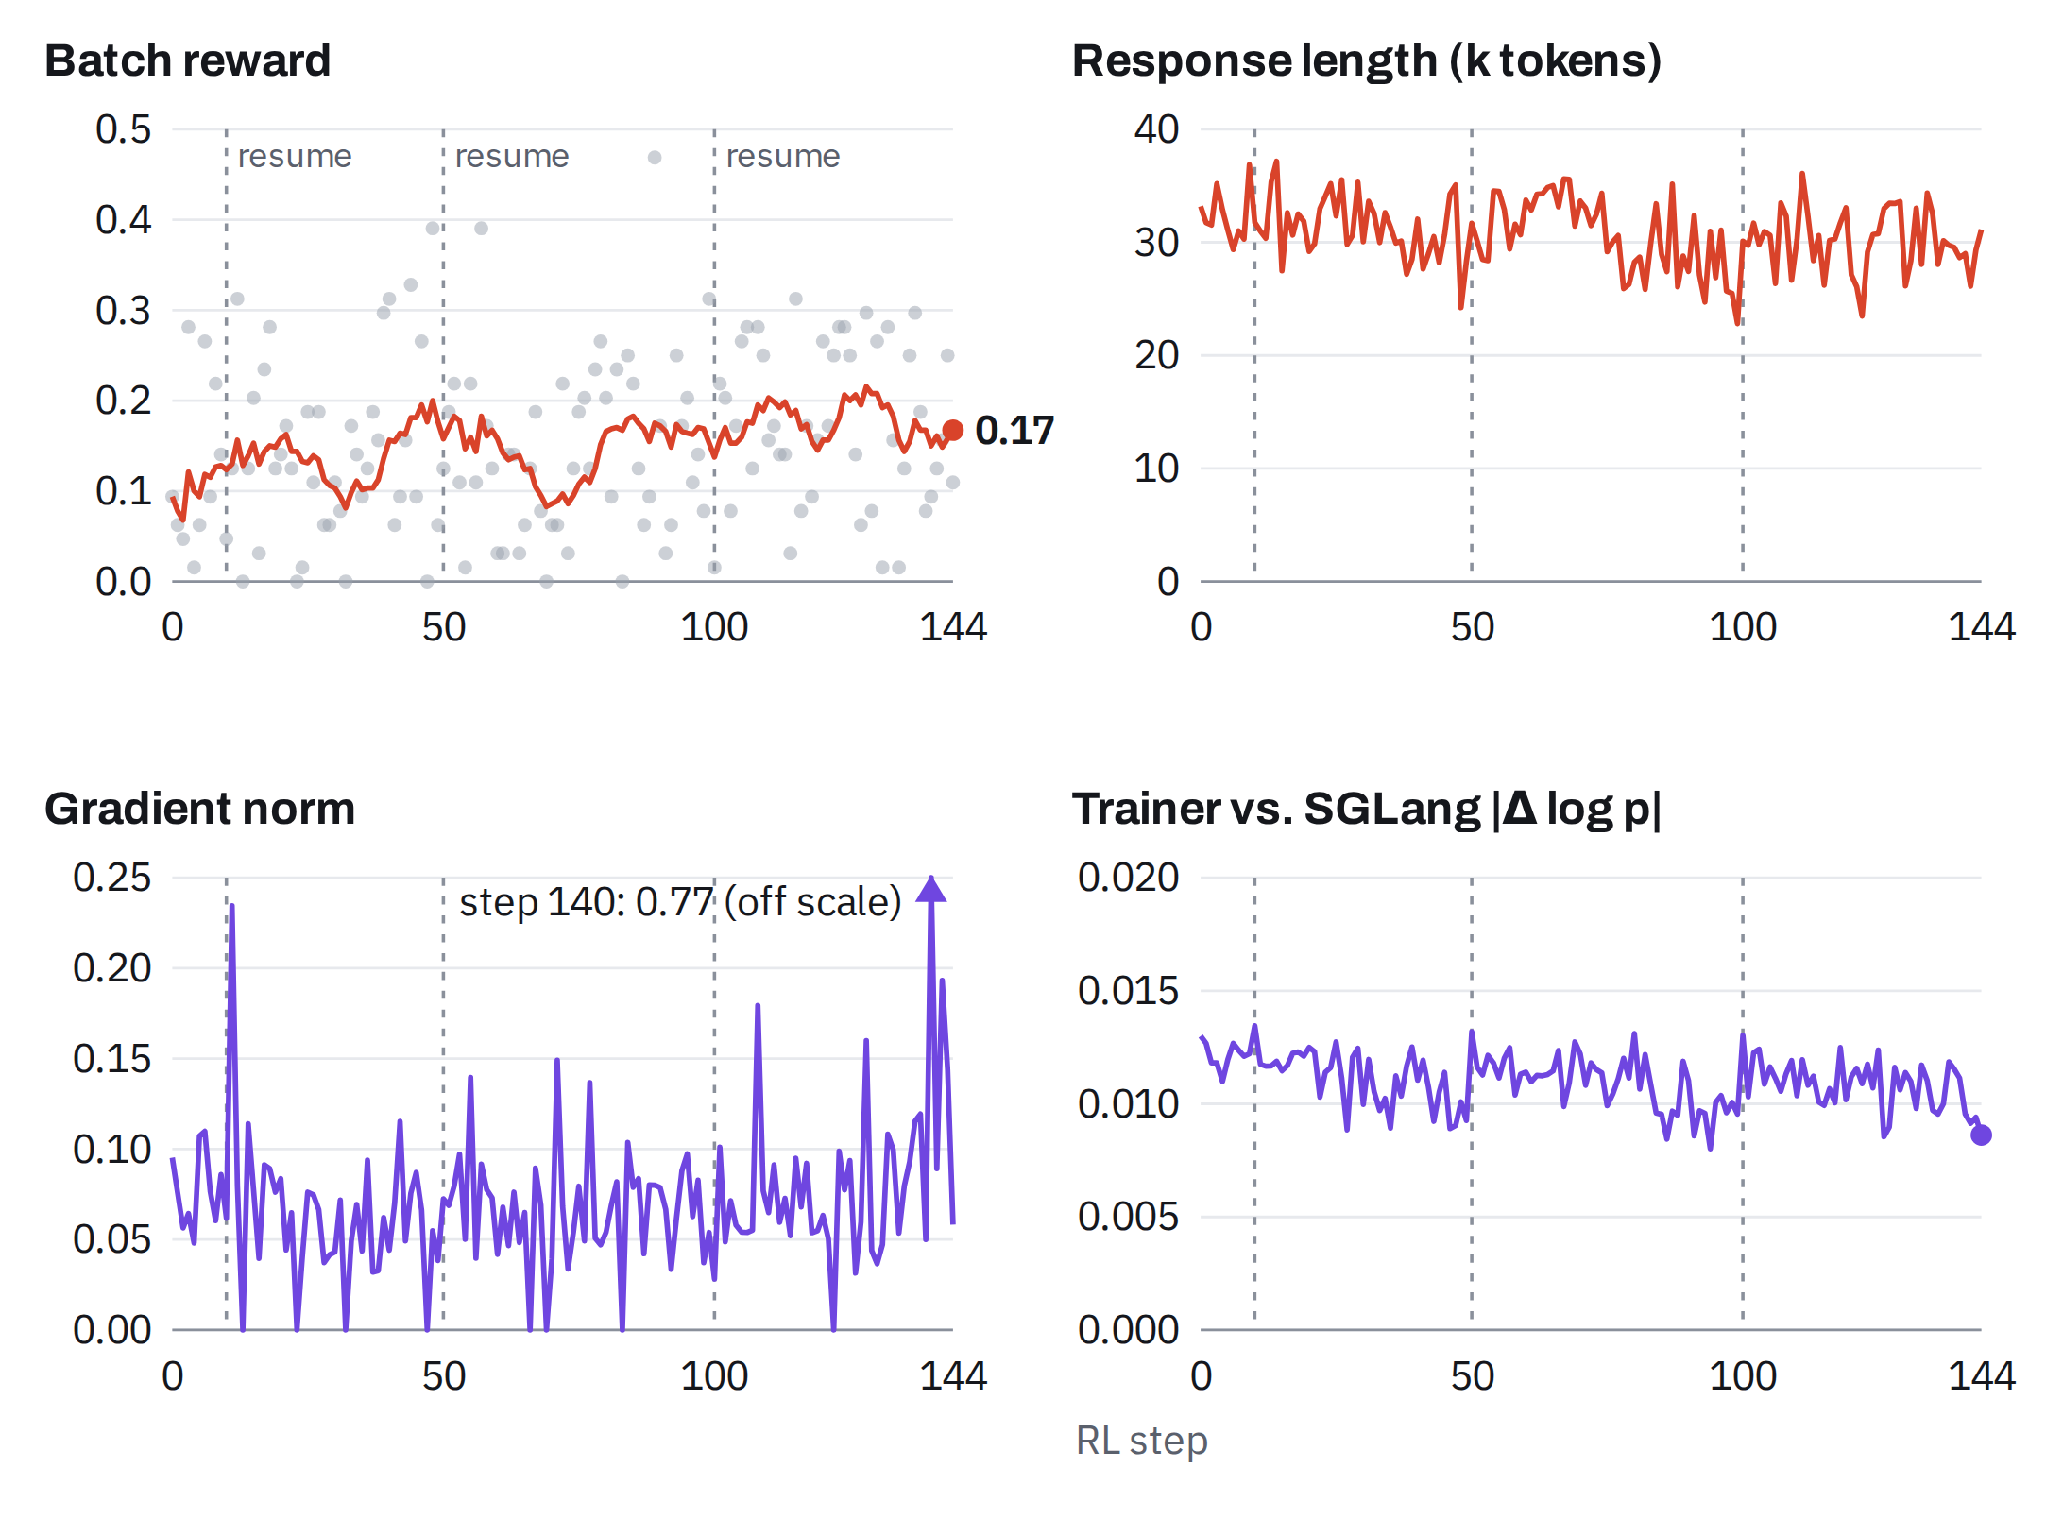
稳定性:这次 RL 跑了 145 步,从 checkpoint 重启 3 次,曲线没漂没炸。10 步平均 reward 在训练任务上从 0.13 升到 0.17。单批在 0 到 0.47 间摆,因为每批抽新任务。梯度范数中位数 0.07,第 140 步到 0.77,仍低于裁剪阈值 1.0,下一步回到 0.09。训练器和推理引擎的每 token log-prob 差平均约 0.011,重要性权重有效样本量平均 93%。响应长度稳定在每条轨迹约 30K token,没有塌向短答案,也没顶爆上下文。
结尾回到工程判断:报告里几乎所有问题一开始都像 GPU 问题,几乎都不是。长尾、CPU 沙箱、隐藏 cap、KV cache 上限,这些才是把 agent RL 卡住的地方。团队下一步要把同一配方推到 DeepSeek-V4-Flash、GLM-5.3 等模型,扩到 384 个并发沙箱以上,还要教 agent 学会提交,别一路循环到 turn cap。
来源:LMSYS Org 推文,AMD & Miles Team 报告,链接:http://lmsys.org/blog/2026-10-22-miles-mi355x-agentic-rl
发布时间: 2026-10-29 05:28