一小时会议,八个说话人,NVIDIA 的开源模型能分清谁在说
NVIDIA 发布开源权重语音模型 Nemotron 3.5 Transcribe。转录、说话人分离、翻译、音频问答塞进一个约 34B 总参数、4.3B 激活的模型里,能在自己的 GPU 上跑。它解决了什么,代价是什么,有哪些坑值得先看。
NVIDIA 今天放出了一个开源权重语音模型:Nemotron 3.5 Transcribe。模型名里的 30B-A4B 对应约 34B 总参数,每个 token 激活约 4.3B。它可以在一张 H100 80GB 上自托管,任务是把一段录音变成有用的文本。
先看它一口气做了几件事:
- 40 种语言转录
- 英语和 31 种语言互译
- 最多 8 个说话人,13 种语言支持说话人标签
- 单次录音最长 1 小时,上下文 65,536 token
- 可以给模型喂名字、技术术语做上下文引导
- 可以对录音提问,但音频问答只训练了英文
一个模型顶掉原来一条流水线里的几个环节。转录、分人、翻译、问答以前各自需要独立的模型或服务,现在一次推理,输出里带说话人标签和时间戳。
榜单上的位置
NVIDIA 的说法是:在 Hugging Face 英文 Open ASR 榜上,Nemotron 3.5 Transcribe 在开源权重模型里排第一,九个数据集平均 WER 4.71%。多语言榜 4.62%,长音频榜 10.98%。
说话人分离这条线更值得看。VoiceArena 用 cpWER 测了 14 个系统,数字越低越好。Nemotron 3.5 Transcribe 是 32.4%,排第一,比 NVIDIA 自家的 Multitalker Parakeet 加 Nemotron 3 Diarization 组合还低一点。

David AI 的 21 语言说话人分离榜上,它也是最低的 DER,18.26%,紧随其后的是专门的 Nemotron 3 Diarization 模型。

Artificial Analysis 的独立评测里,它和另一个开源模型并列开源权重第一,AA-WER 2.8%,激活参数只有对方的约六分之一。

演示用的是一部 1940 年的电影
NVIDIA 选了一段《女友礼拜五》(His Girl Friday)来演示。这部 1940 年的神经喜剧以语速极快、大量重叠对白著称。用它来展示说话人标签和重叠语音处理,意图很明显:别只看安静环境下的单人朗读。
架构和速度
模型是混合 Mamba-Transformer 的 MoE 架构,音频侧用 Transformer ASR 编码器加 Sortformer 说话人编码器,语言主干是 Nemotron 3.5 Lightning 30B-A3B。说话人信息在编码阶段就进入语言模型,生成时直接打标签,不需要事后再做一轮对齐。
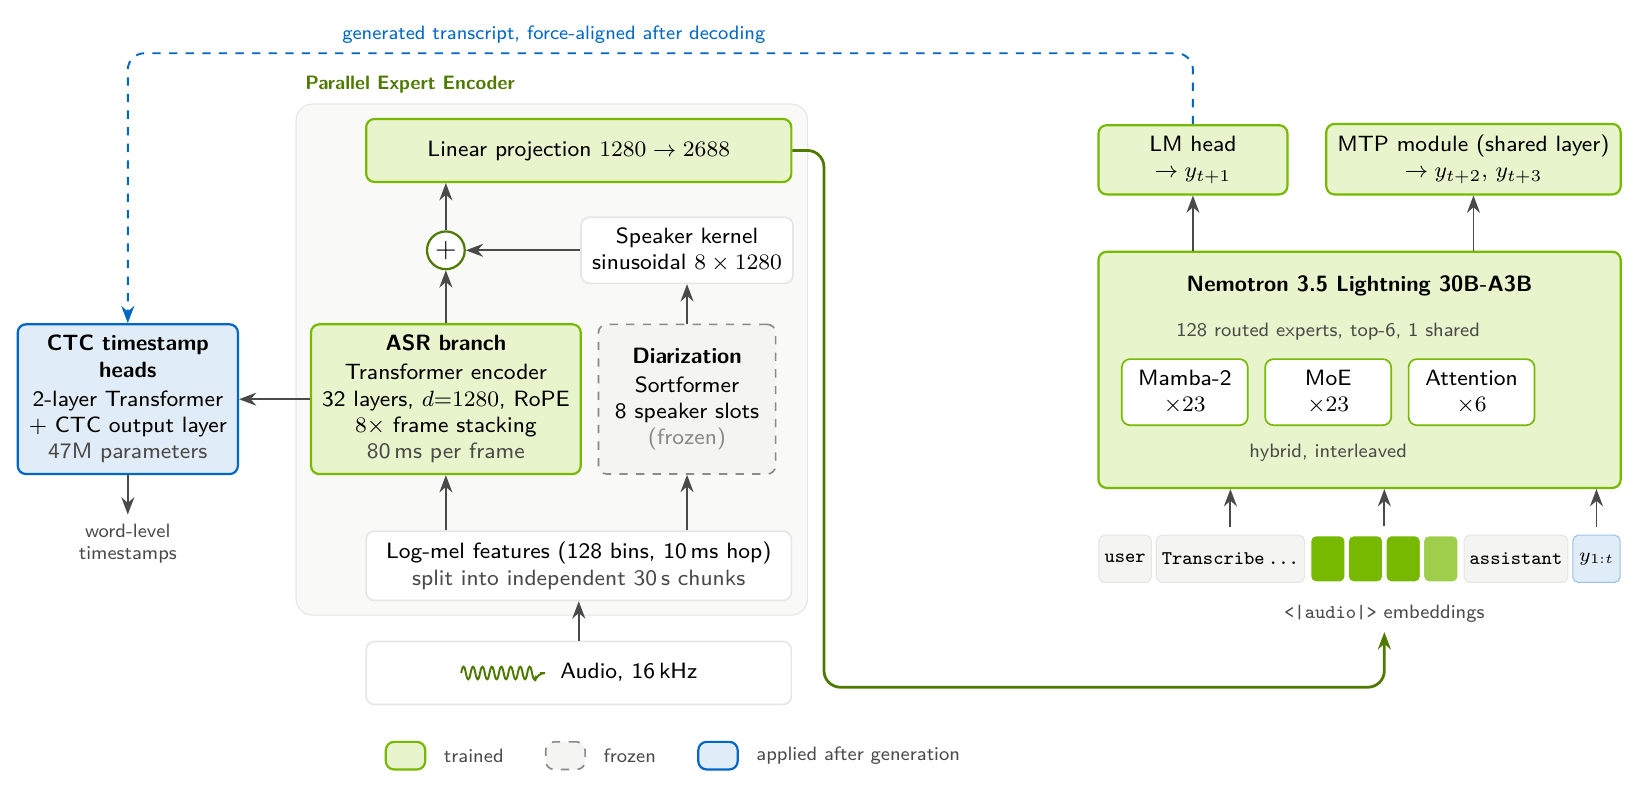
服务端用 vLLM 0.32.0 加 NeMo Speech,支持 MTP 投机解码。NVIDIA 给出的数字:在 RTX PRO 6000 Blackwell 上,NVFP4 加 DFlash2 投机解码,每秒处理 2238 秒音频,一段 30 秒录音 0.13 秒返回转写。不过这些优化还没进开源版本,开源的 vLLM 集成大概慢两倍,而且定位是模型开发用途。
本地硬件门槛不低。BF16 建议一张 H100 80GB。RTX 5090 只能用 NVFP4 量化版。有网友在回复里说这东西“fucking huge”,还有人问什么时候能量化到 6 到 8GB 内存。NVIDIA 说量化版和 NeMo-Speech.cpp 本地部署工具会稍后放出。
配套的数据集和微调
NVIDIA 同时放了 Granary v2 数据集清单:46.3 万小时,48 种语言,16 个源语料。四种可复用的数据处理阶段:音频准备、转录、任务标签生成、高保真过滤。开发者可以拿自己的录音跑同一套 NeMo Curator 流程。

医疗领域的微调案例更具体。Eka Care 的印度医生口音医疗语音基准上,开箱 WER 30.8%。换一个指定英语和拉丁字母的提示词,降到 23.8%。再拿约 153 小时合成语音、29 小时带口音英语、63 小时医疗录音做微调,留出说话人上的 WER 从 22.44% 降到 12.17%,相对降低 45.8%。整个适配过程大约 14 个 GPU 小时,一张 GB300。

这是一条完整的路径:开源权重,开源数据管线,开源微调教程,还配了一个让 coding agent 自动跑微调流程的 skill。跟单纯扔一个 checkpoint 出来不是一回事。
几个值得先看的点
有一个网友 Max Petrusenko 在回复里提了个具体问题:8 个说话人、1 小时的录音,diarization 容易在音频分块边界处出问题。模型内部按 30 秒切块处理,前面被标成 speaker 4 的人,换个 chunk 回来可能变成新标签。标签跨边界的稳定性值得实测。
另一个被反复提到的卖点是本地部署。在德国这类对会议录音有合规要求的地方,音频不出自己的机器就是采购理由。这也是 NVIDIA 这套开源策略的落脚点:把权重、数据、工具链都给你,让模型跑在它自己的 GPU 上。
音频问答只训练了英文,其他语言别指望。它也是离线模型,直播场景需要另一个模型。模型卡里还提醒,说话人标签只用于区分同一段录音里的不同人,不代表真实身份。
模型、演示和博客链接:
- 模型:nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
- 演示:nemotron-transcribe
- 博客:Nemotron 3.5 Transcribe and Granary v2
转录准确率已经卷到 4% 上下的 WER,接下来比的是谁能在同一段录音里稳定地标出八个人、跨语言、还能回答“会上做了什么决定”。这件事的难度和纯转录不在一个量级。NVIDIA 把四个能力放进一个模型,代价是 34B 的体量。对个人开发者来说,量化版什么时候到,可能比榜单排名更重要。
发布时间: 2026-10-29 15:40