H-Net 想拆掉分词器:省算力是真的,争议也是真的
Cartesia 用原始字节训练语言模型。1-stage H-Net 在 OLMES 上省约 2 倍算力,代码 OOD 最高 5.37 倍;2-stage 模型用约 1T token 追上 SmolLM3 的 11T token 预训练结果。真正值得看的是分词器藏起来的先验,以及这套方法在 DNA、视觉上的外溢。
Cartesia Research 放出一组 H-Net 结果,目标很直接:把语言模型里最后一个手写环节,分词器,拆掉。Albert Gu 在推文里把这件事说成通往“从原始数据学习”的一步,引用了 Sutton 的 bitter lesson。话说得很大,数据倒是给得挺细。
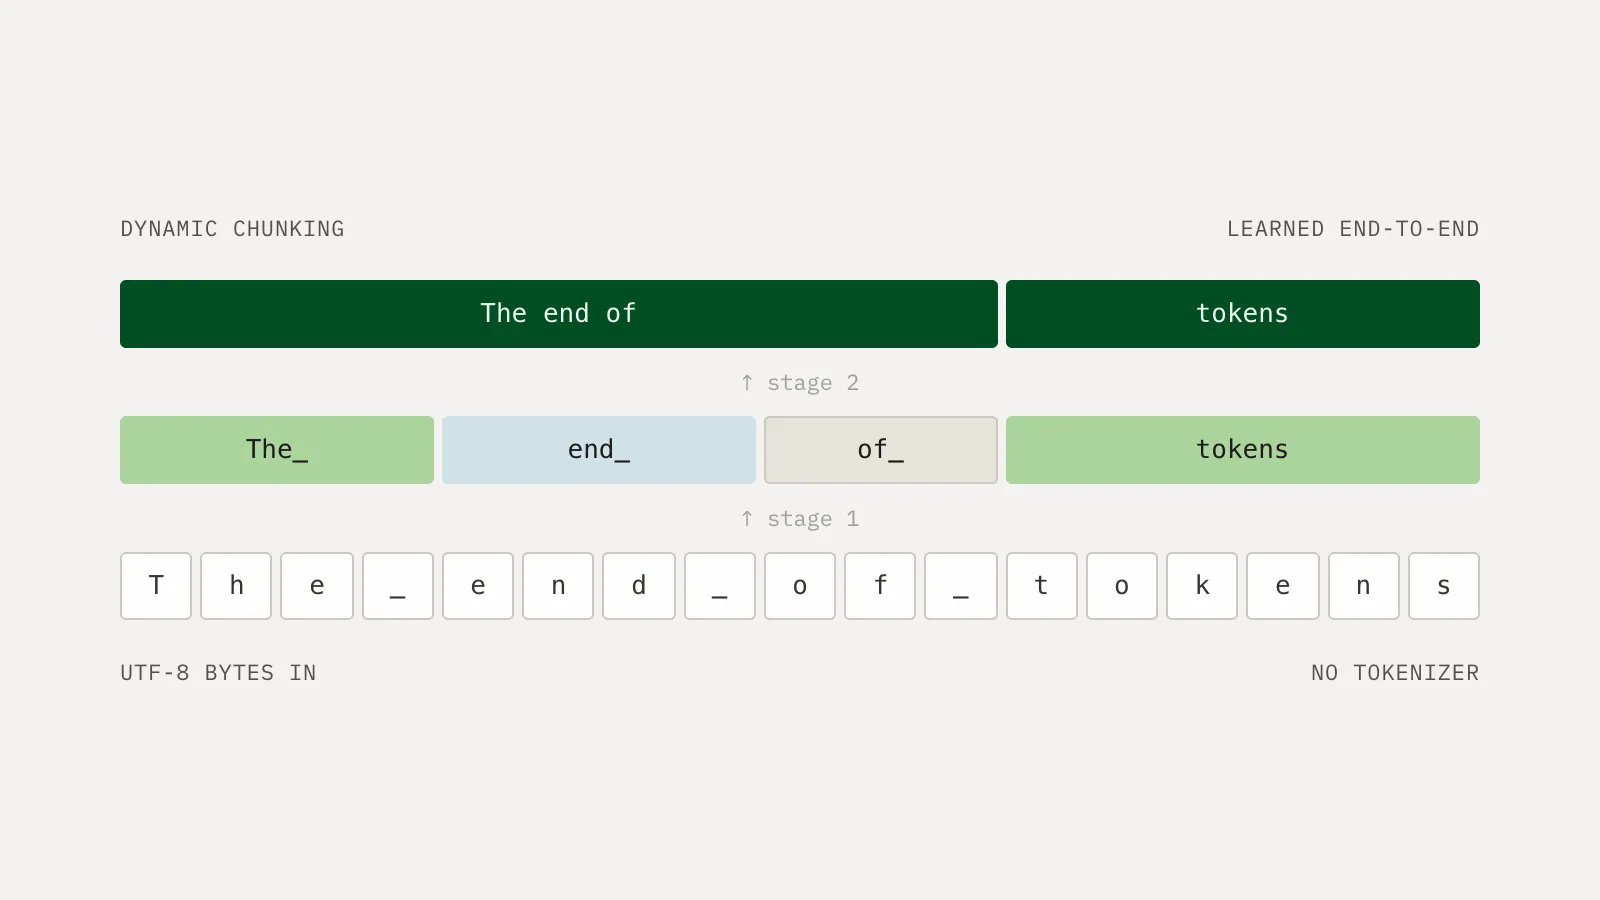
先补背景。今天主流 LLM 不直接读字节,先由 BPE 把文本压成 token,词表固定,预分词还靠正则。BPE 加上预分词,等于把“什么算一个词、数字怎么切、标点怎么绑”这些判断提前写死。Cartesia 的 H-Net 做的是动态分块:模型在训练中自己学边界,一级一级把字节压成语义块。1-stage H-Net 可以理解成把分词器换成一个可学习的编码器和解码器;2-stage 再多一层。
他们先做受控对比。只替换 tokenization 部分,backbone 和超参对齐,压缩率也对齐到 BPE 的 4.57 字节/token。1-stage H-Net 在验证集上达到同样 loss 少用 1.28 倍算力;Paloma 平均 1.83 倍,OLMES 平均 2.06 倍。代码更明显:训练集内 15 种语言中位数 2.04 倍,Go 上 2.40 倍;训练集外 10 种语言中位数 3.10 倍,Prolog 到 5.37 倍。这个方向值得注意:越难分词、越缺固定模式的分布,H-Net 的优势越大。
更大的实验用了 2-stage H-Net,3.67B 参数,和 SmolLM3-3B 按每字节 FLOPs 对齐。博客写得很清楚:H-Net 约 1T token 达到 SmolLM3 在约 11T token 后的最终平均分。推文里把它概括成约 10 倍数据和算力效率。这里要留个心眼:这是预训练评测上的结果,不是“所有任务全面 10 倍”。但账已经够具体。
第二篇博客更有意思。它把 scaling law 拆成两段:compute-to-loss 和 loss-to-loss。前者看预训练省不省算力,后者看预训练 loss 能不能迁移到下游。结论有点反常识:BPE 在 compute-to-loss 上很强,但 loss-to-loss 不如纯字节模型。去掉预分词的 BPE-NP 压缩率更高,6.03 倍,超过 BPE 的 4.57 倍,可下游迁移更差,甚至要处理 prompt boundary 的边界校正问题。加回预分词,BPE 两边都变好,说明那个常被忽略的正则步骤本身携带了很强先验。
H-Net 拿的是两边的好处:compute-to-loss 保留压缩效率,loss-to-loss 追平字节级模型。按博客表,H-Net 相对 BPE 在 compute 到 validation 是 1.28 倍,validation 到 OLMES 是 1.61 倍,compute 到 OLMES 是 2.06 倍。BLT-like 用熵代理决定分块,架构和压缩率相同,仍不如端到端学边界的 H-Net。Cartesia 的结论是边界质量和端到端训练都重要。这个结论对做架构的人比“省几倍算力”更值得看。
行为部分也有细节。H-Net 会出现 in-context tokenization:没见过的词先拆碎,重复出现后合并;代码里的变量名、重复格式会被压成大块。DNA 实验里,H-Net 在三个集合上有 5.95 到 7.06 倍算力增益,还能在人类基因组上撞出 codon 边界。视觉上,2D H-Net 在像素扩散模型里学到的 chunk 不要求空间连续,会把被前景挡住的背景区域并到一块。这些结果比语言上的数字更能说明“动态分块”不是单纯换分词器。
社区反应分成两路。有人喊 free the token,有人问论文摘要里到底发生了什么。hailports 的回复值得贴出来:语言已经被人预处理过,真正的测试是没人费心命名的数据。这个质疑很准。语言文本里到处是空格、标点、代码缩进,这些结构本身就在帮模型。DNA、音频、视觉这些领域没有现成的“词”,H-Net 的价值才刚被检验。

Jonathan Chang 在回复里问 what happened here? 截图是 H-Net 论文摘要。

短期看,分词器不会一夜消失。现有推理栈、词表、缓存、工具链都围着 token 建。H-Net 真正松动的是一个默认假设:分词器必须是人手设计、离线固定、全模型共享。它把分块变成模型内部可学习的模块,并且在代码、OOD 代码、DNA 上给出了可复现的算力账。下一步该看后训练和多模态,那才是“从原始数据学习”更难的部分。
发布时间: 2026-10-29 08:31