1.3B的OCR混进生产,靠一个2B模型给它打分
OpenBMB 把文档解析拆成两步:MiniCPM-OCR 1.0 负责认字,Jev 负责给文本、公式、表格打分。1.3B 解析器加 2B 审核模型,真正值钱的是低分内容有地方去。
OCR 最麻烦的地方是错得安静。Agents 现在成天读 PDF、发票、论文,一个表格抽错,后面每一步都带着错往下走。推文作者 elvis 给了一个例子:OpenBMB 和 ModelBest 的 MiniCPM-OCR,把解析和审核拆成两个模型。
先看解析器。MiniCPM-OCR 1.0 只有 1.3B 参数,处理中英文文档和 PDF,包括扫描件、照片、弯曲页、倾斜页和重拍文件,也支持关键信息抽取。官方给的数据:Real5-OmniDocBench 93.68,OCRBench v2 54.7。吞吐 1.2 页/秒,大约是 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍。开 DSpark 解码后,端到端效率提升 55%。部署侧支持 vLLM、SGLang、llama.cpp、Ollama,权重和微调框架都开放。
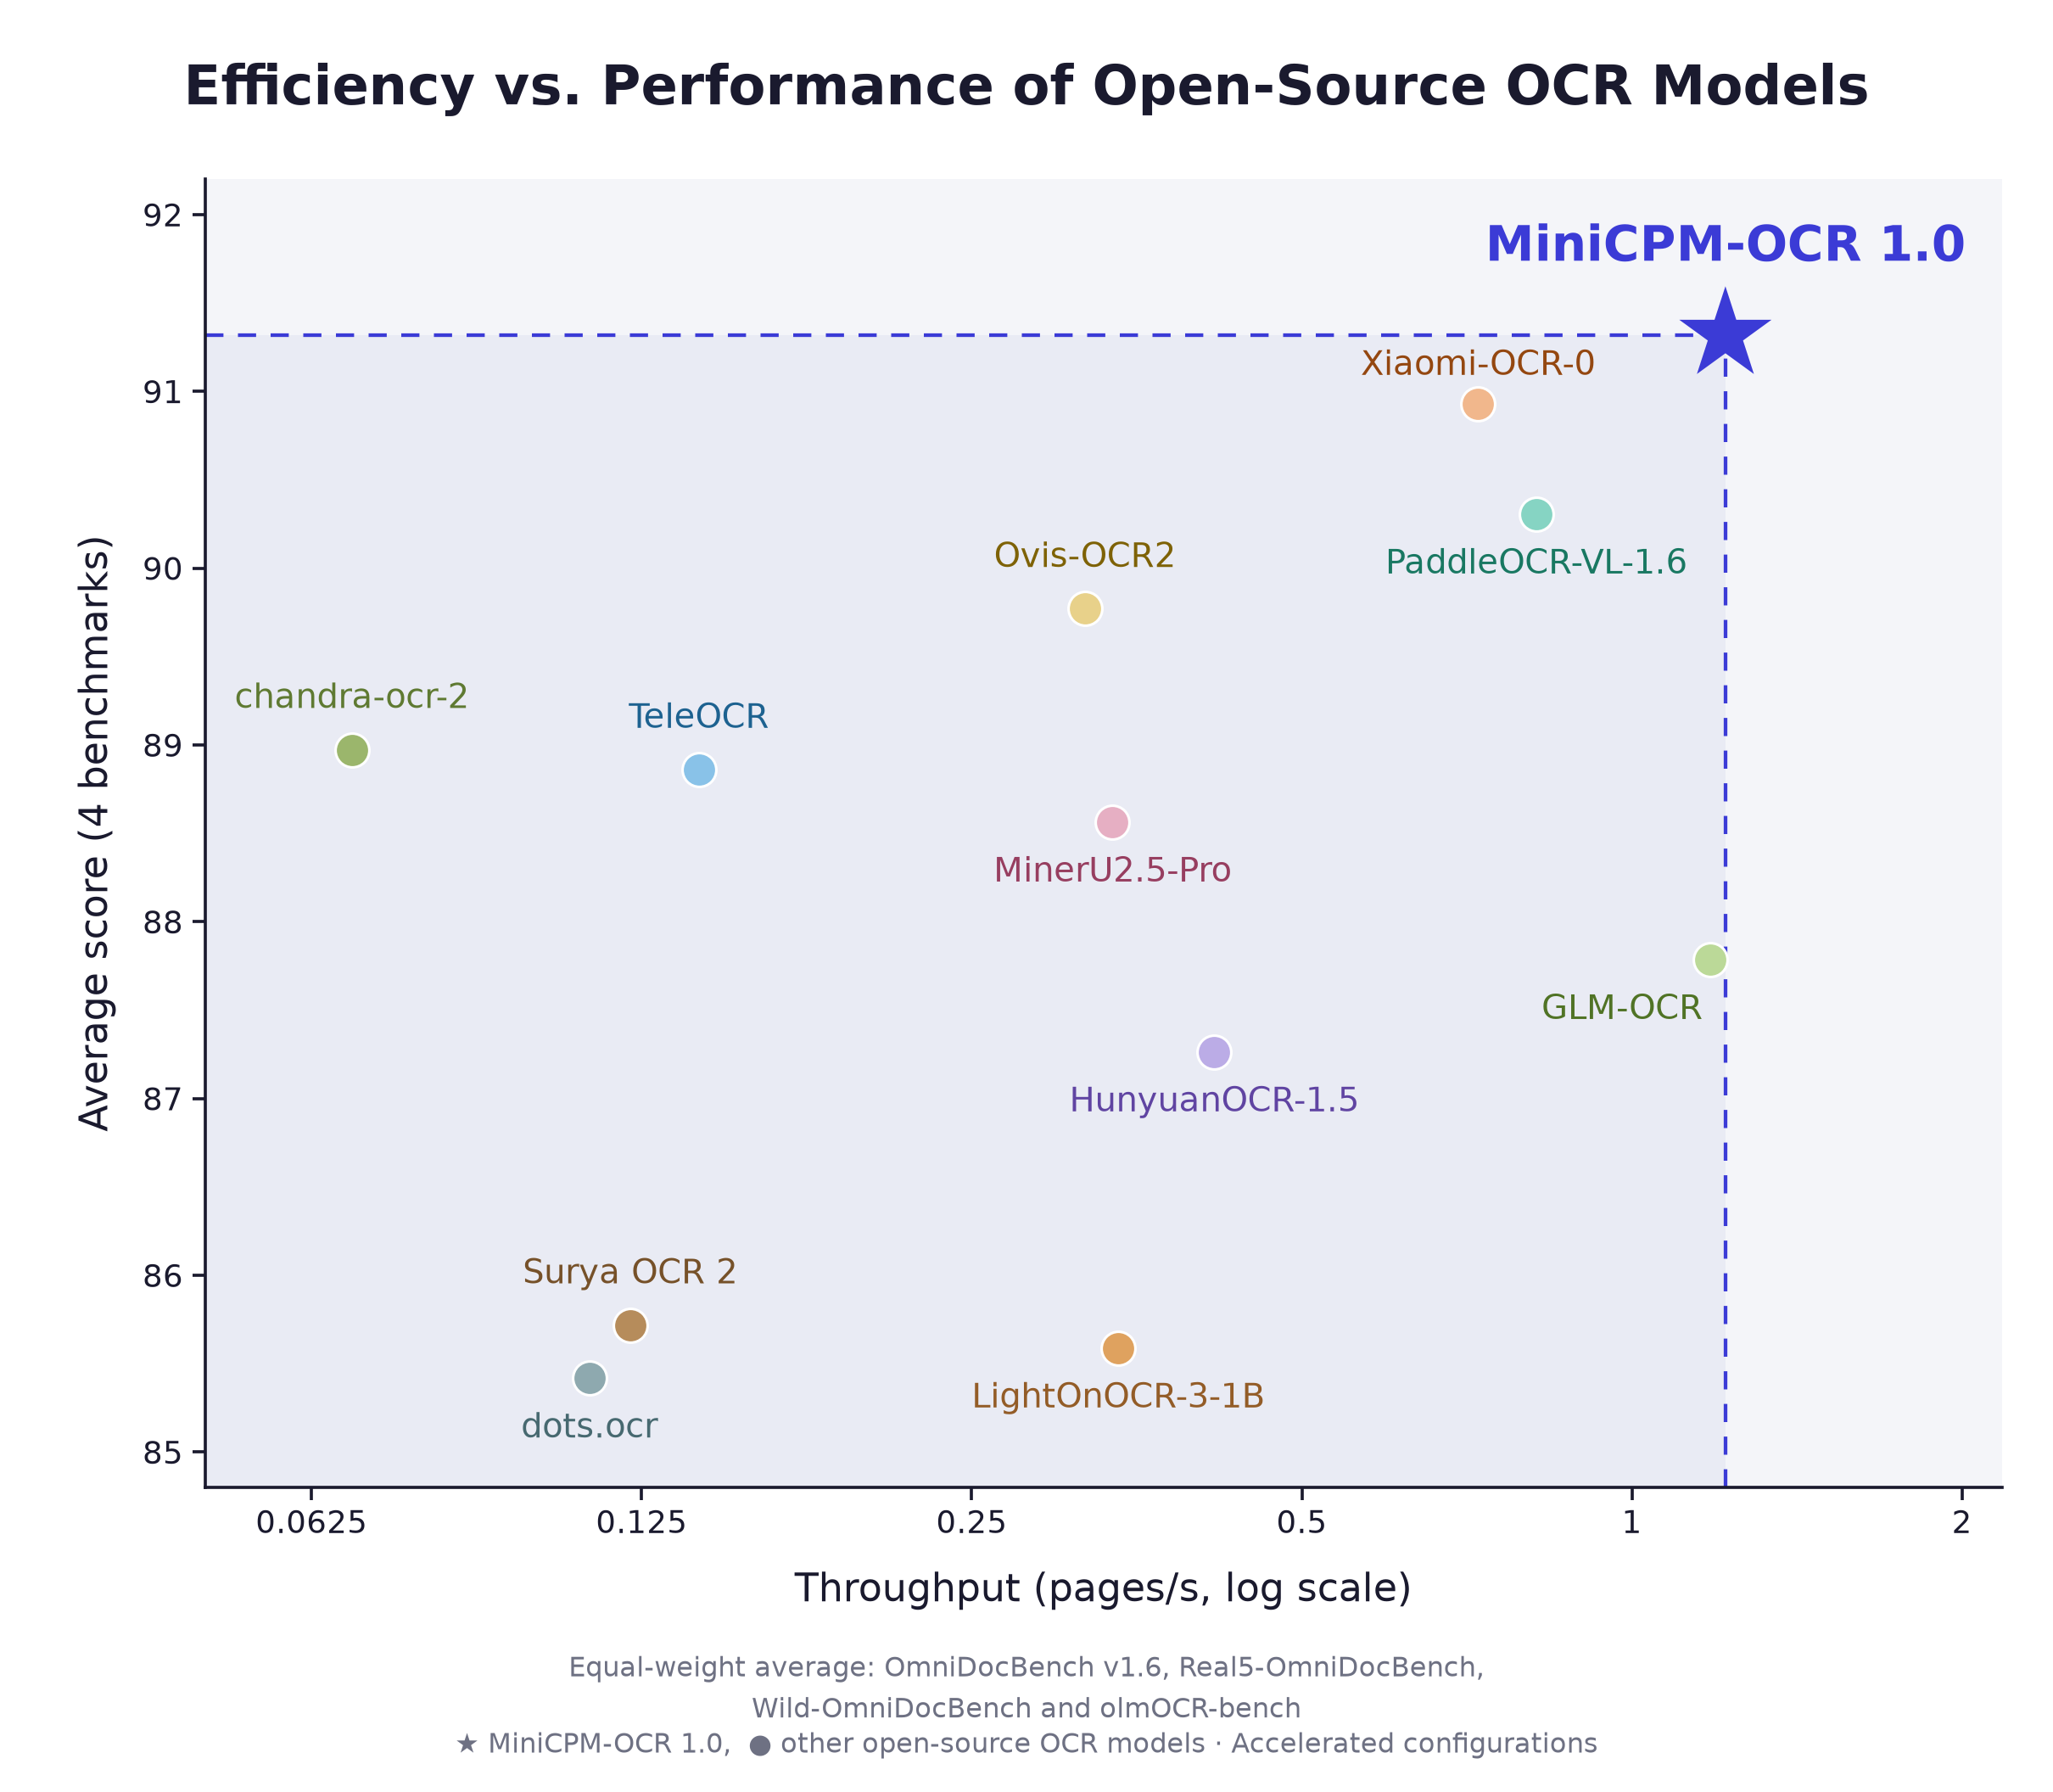
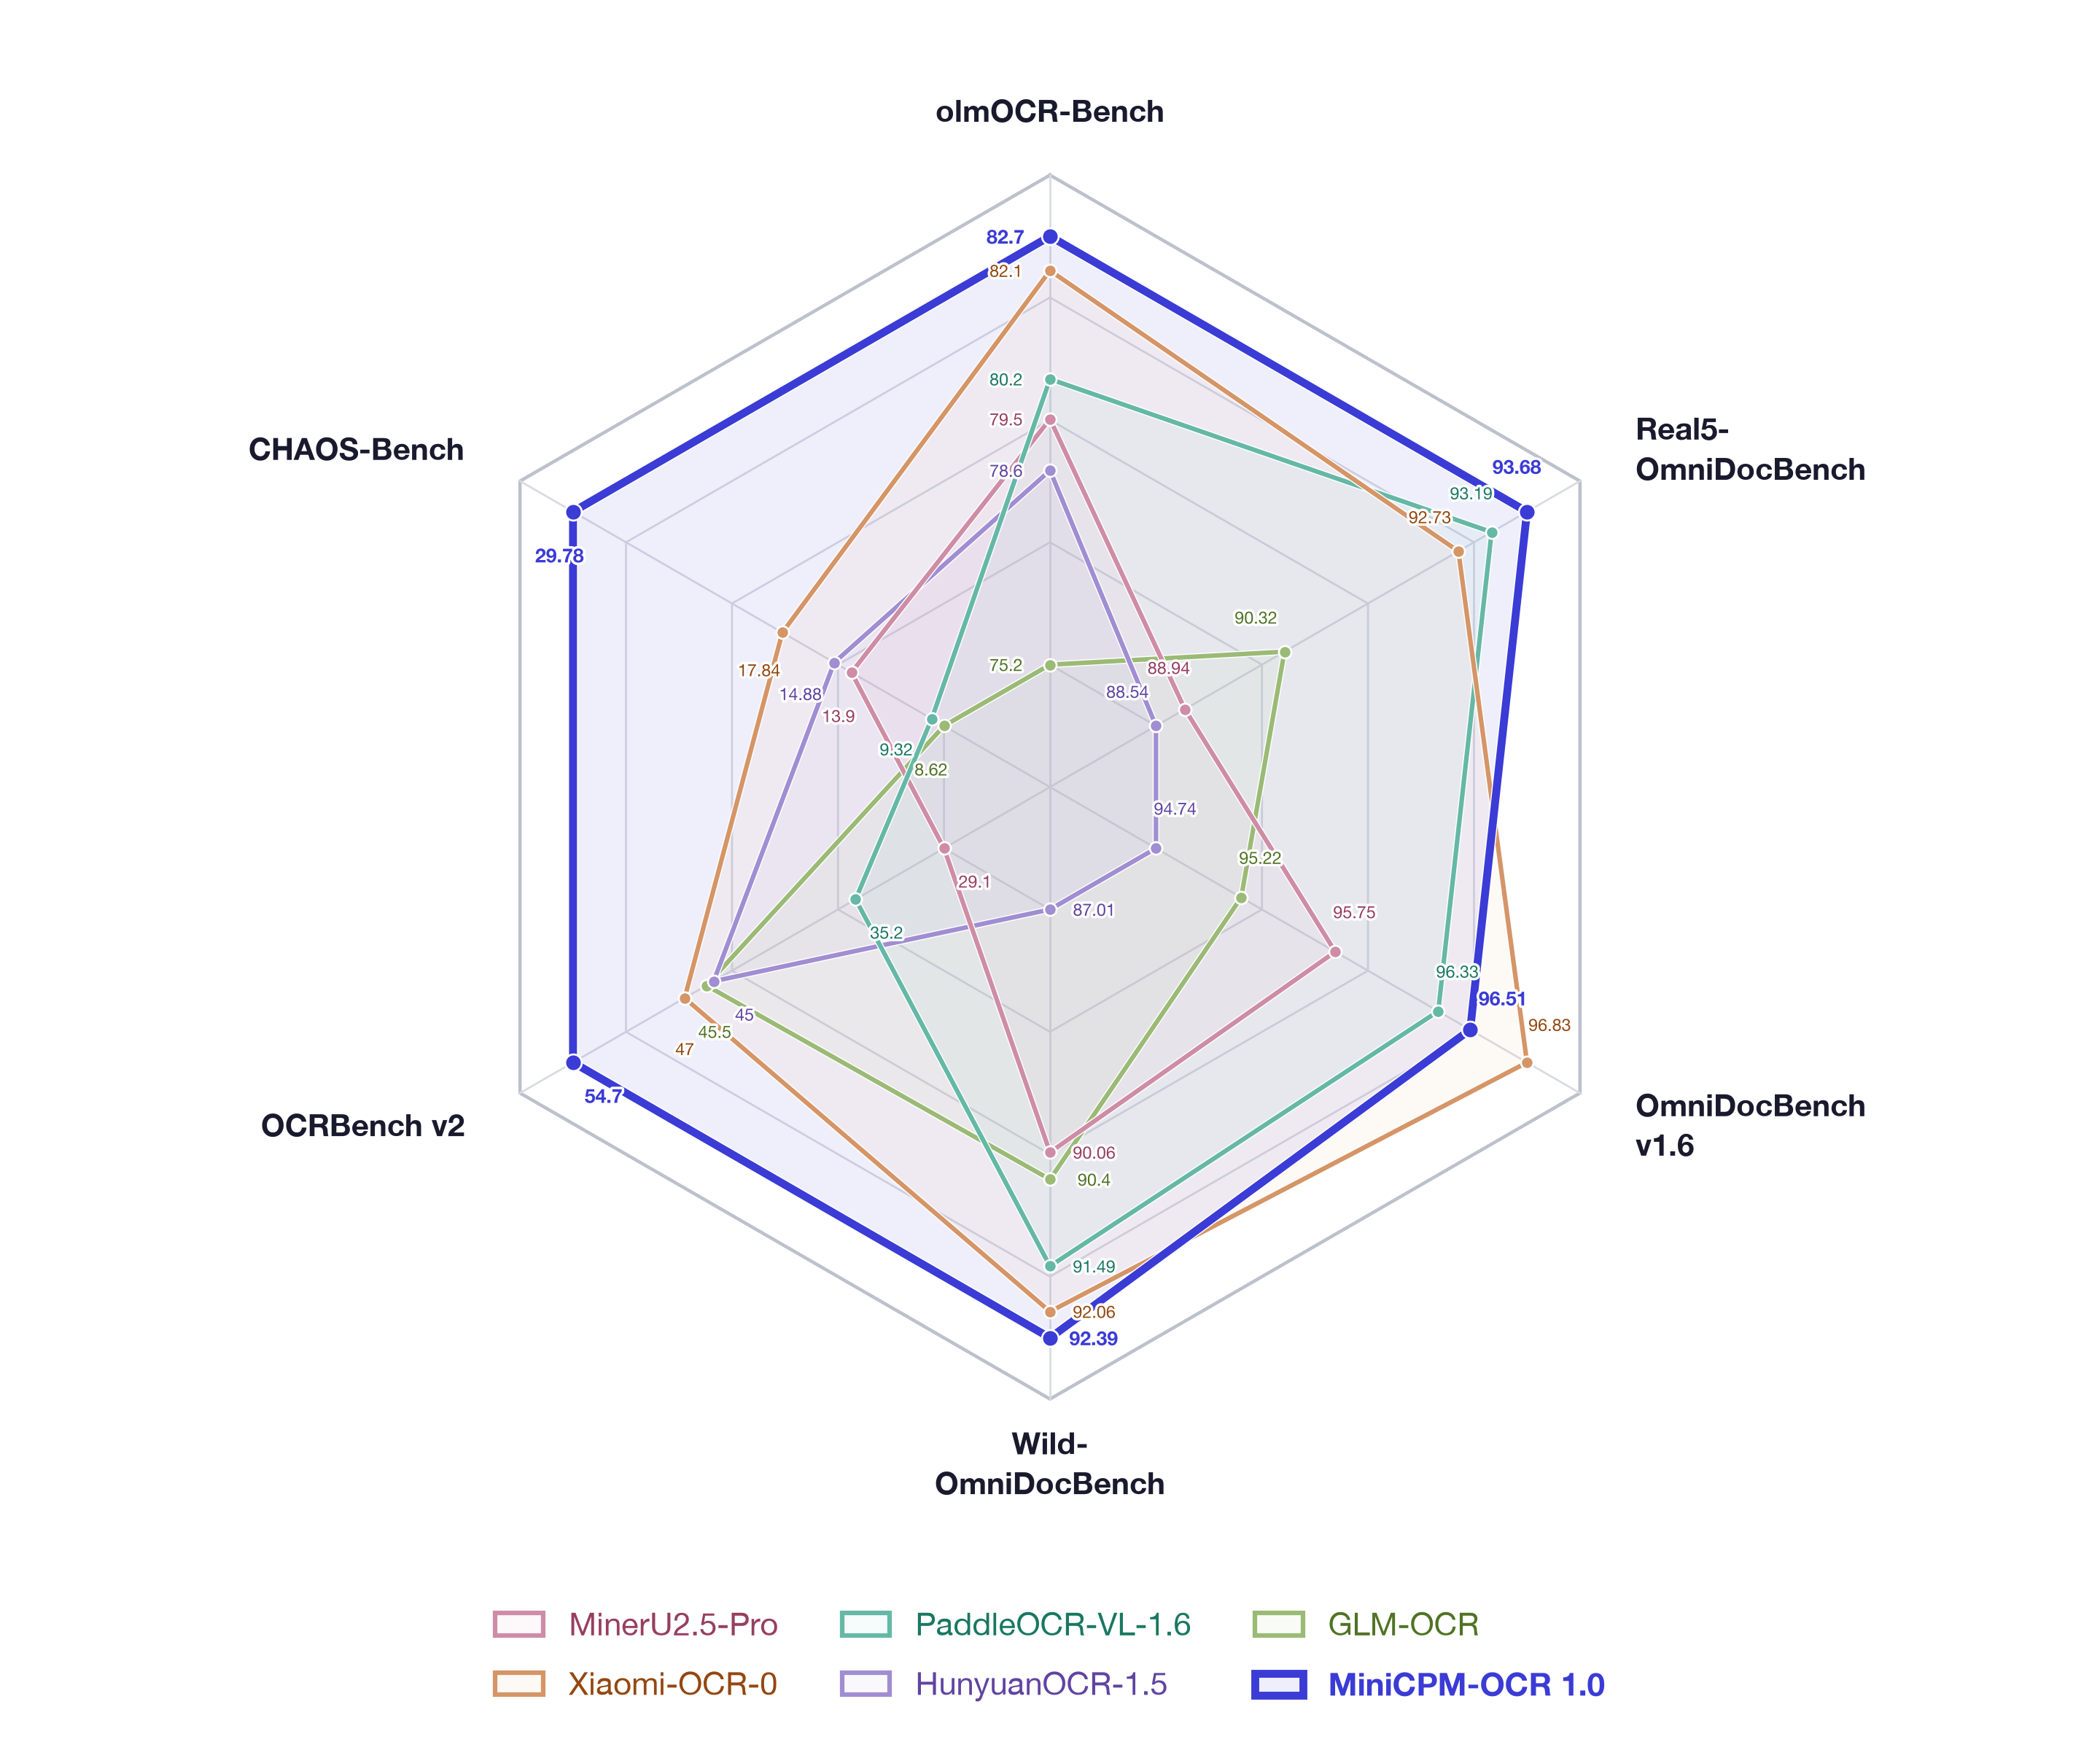
这意味着什么:一个 1.3B 的专用解析器,已经能在不少文档上跑出可用结果。但它仍然会错,尤其密集表格、公式、手机拍的纸。错法还不一样:表格错一眼能看出来,公式错一个指数,页面看起来很正常。有网友在回复里说,公式是他会先测的地方。
于是第二个模型 Jev 上场。MiniCPM-OCR Jev 是 2B 的 OCR 正确性决策模型,按区域给分,不给整页一个模糊评价。输入是一块文本、公式或表格的截图,加上候选 OCR 结果,输出 0 到 1 的分数,越高越可能正确。它不修错,只估计可靠性。这个定位很关键:修错是另一个问题,先知道哪里该看,才能把人工审核放进流程。
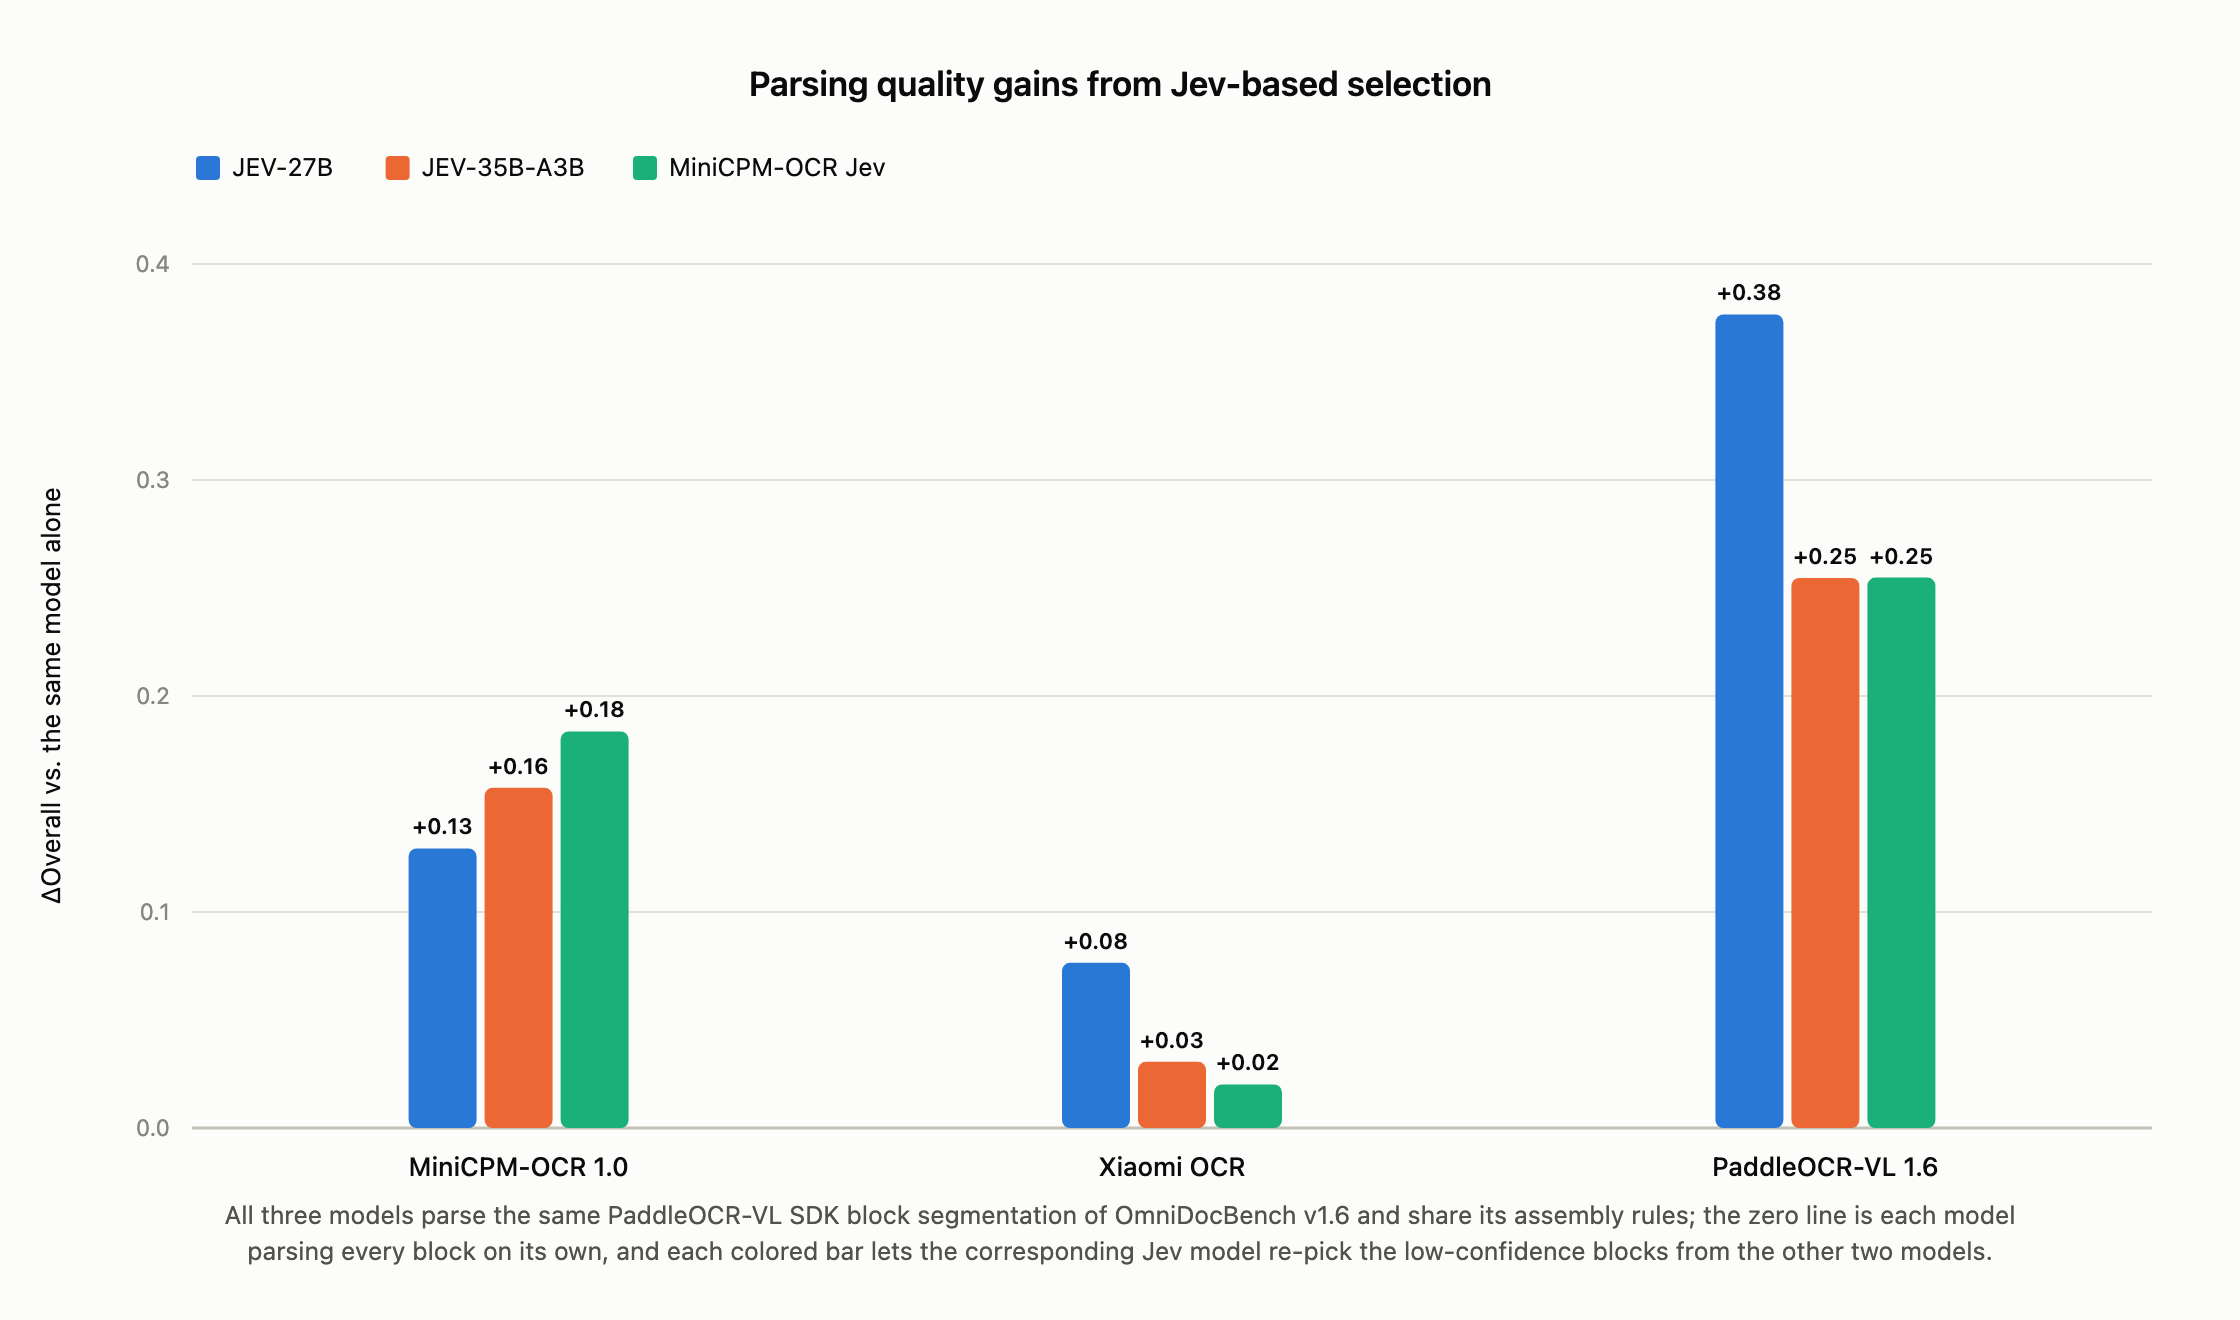
Jev 的分数可以干三件事:自动接受高分区域;把低分区域送人工或纠正步骤;同一区域跑多个 OCR 模型时,选分数最高的候选。官方数据里,Jev 在 JevOCRBench 的 AUROC 乘 100 是 93.6,高于 JEV-35B-A3B 的 90.1,接近 Qwen3.5-397B-A17B 的 93.8。换解析器后,AUROC 在 91.9 到 93.4 之间。样本和解析器组合有限,但至少说明这个 2B 检查器不是只认自家输出。
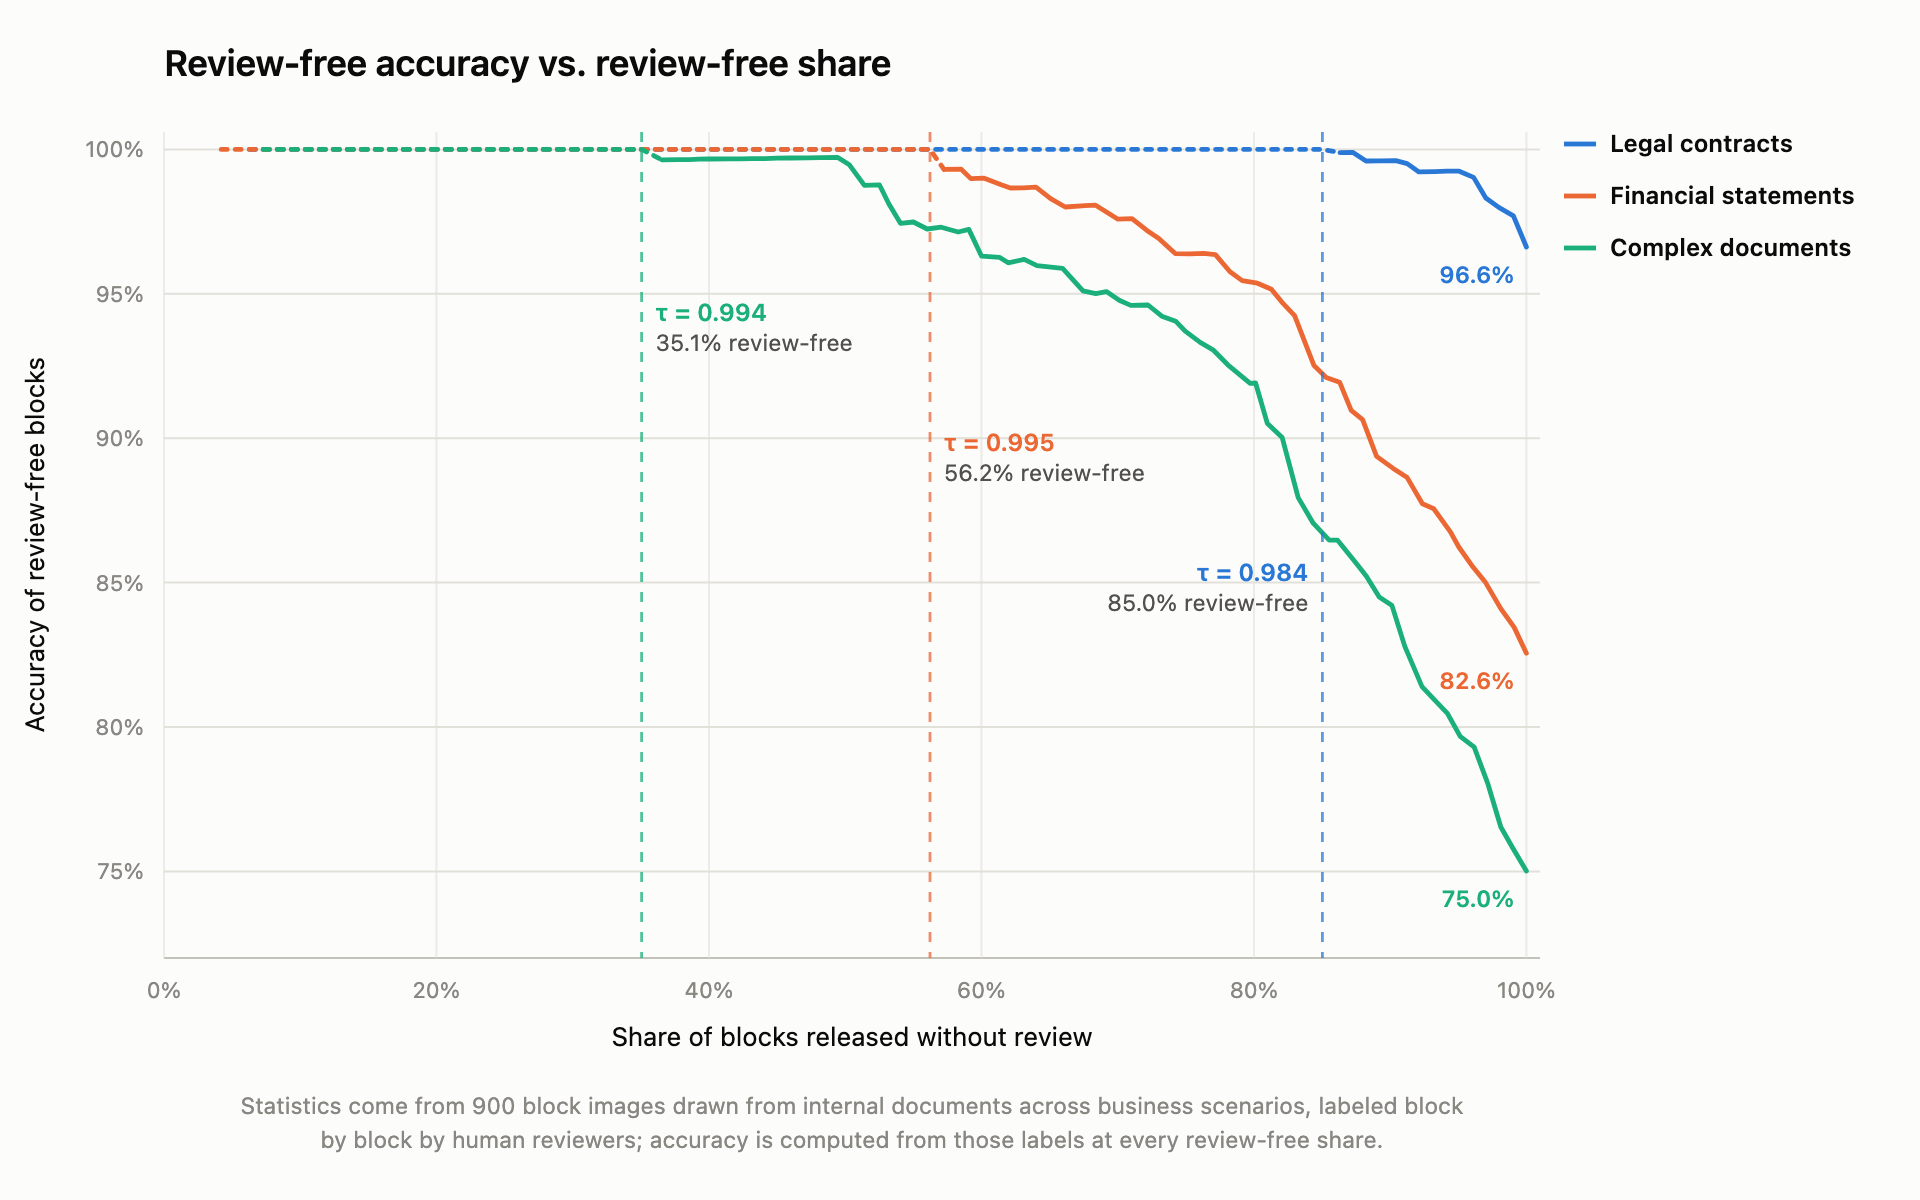
推文里的流程很简单:MiniCPM-OCR 解析,Jev 给文本、公式、表格打分,低分结果送人或者走纠正。有网友补了一句更实际的话:低分得有地方去,不然只是更漂亮的日志。另一个网友提醒,路由前先看 verdict,渲染或推理失败可能返回固定值,别把坏掉的验证器当成难文档。这个细节比榜单更重要,生产里错误路径要单独处理。
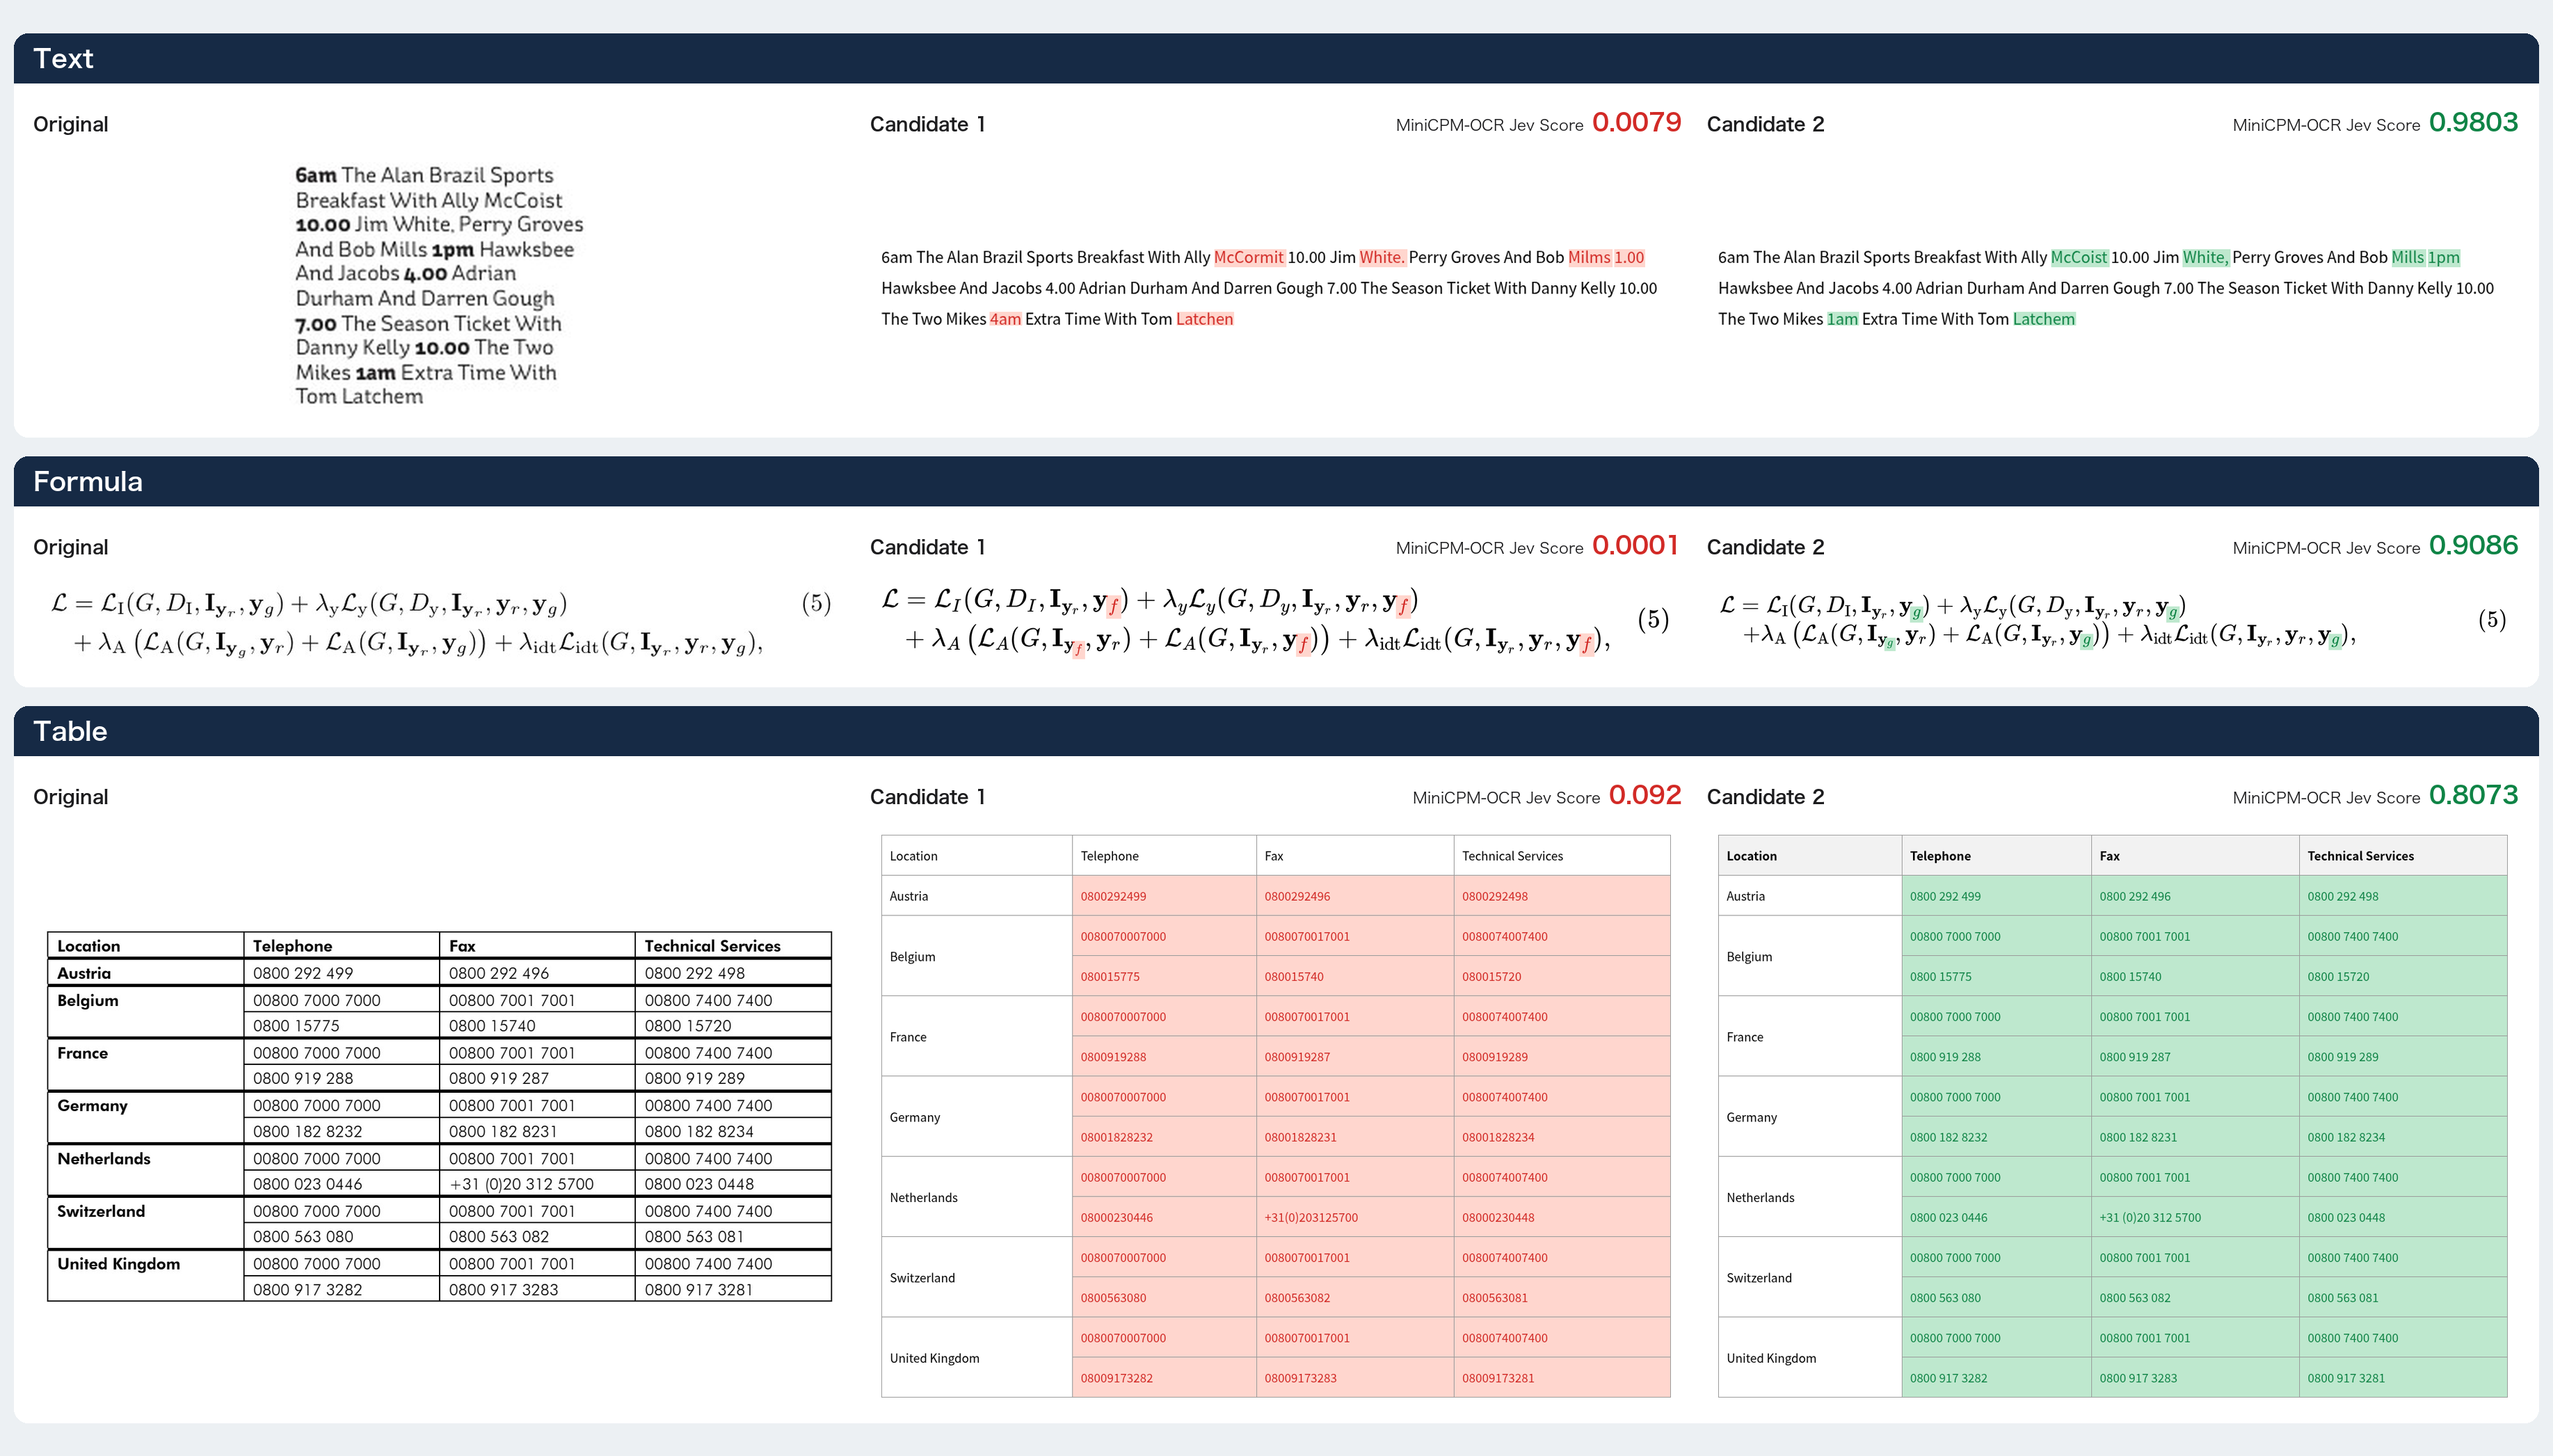
如果同一区域有多个 OCR 候选,Jev 也能做 best-of-N。前提是候选共享同一块裁图和内容边界,它只在已有候选里选,质量上限由候选覆盖决定。
中文文档的解析效果可以看这组动图,左边原文档,中间版面检测,右边 Markdown:
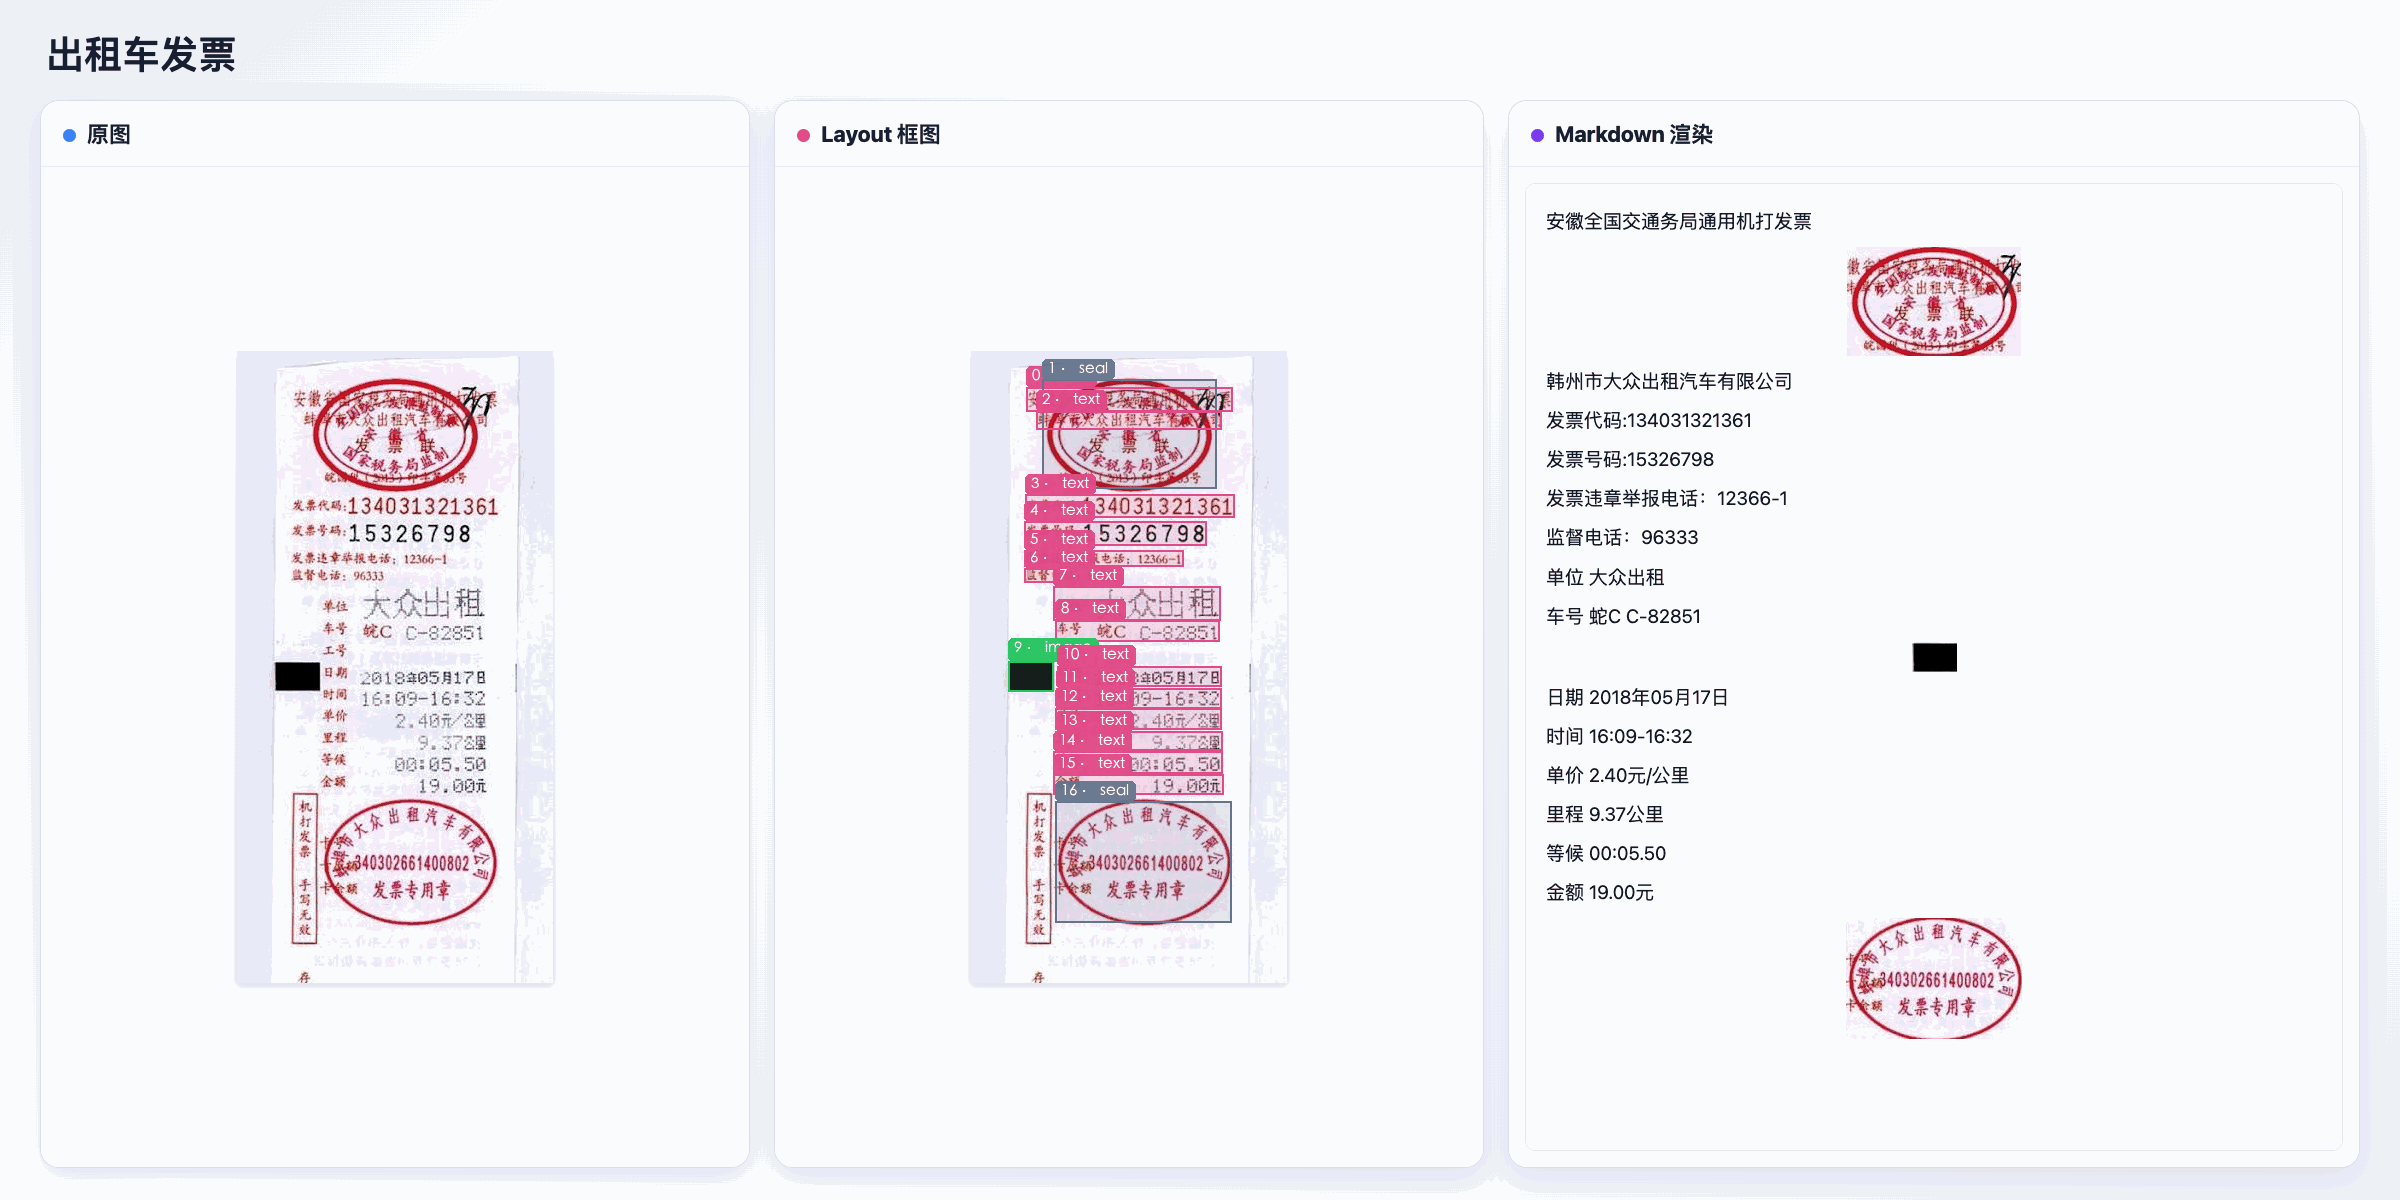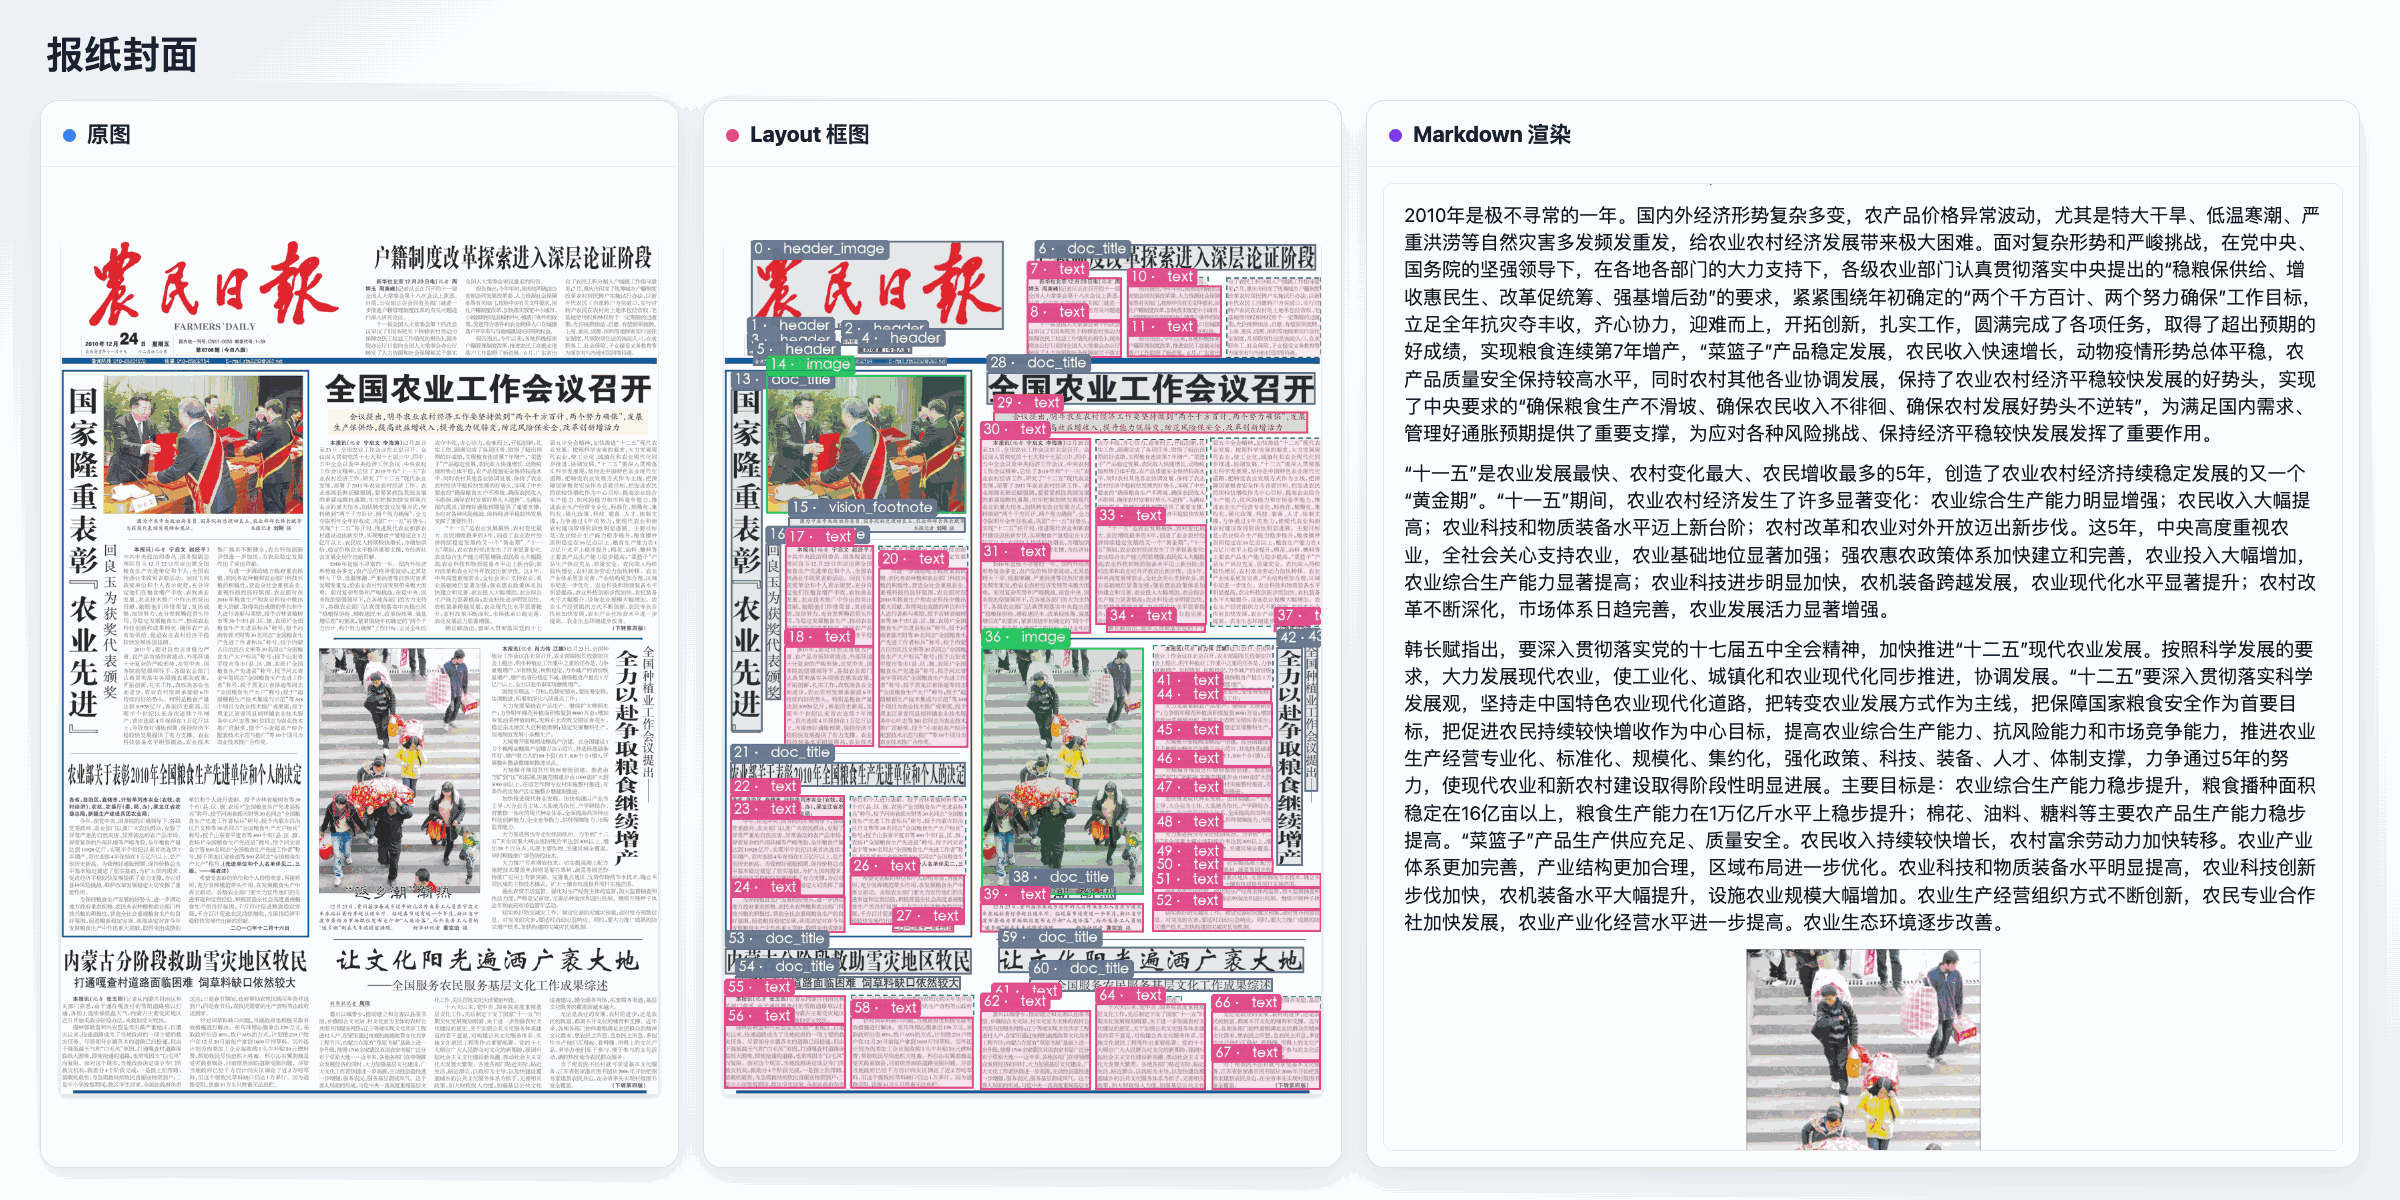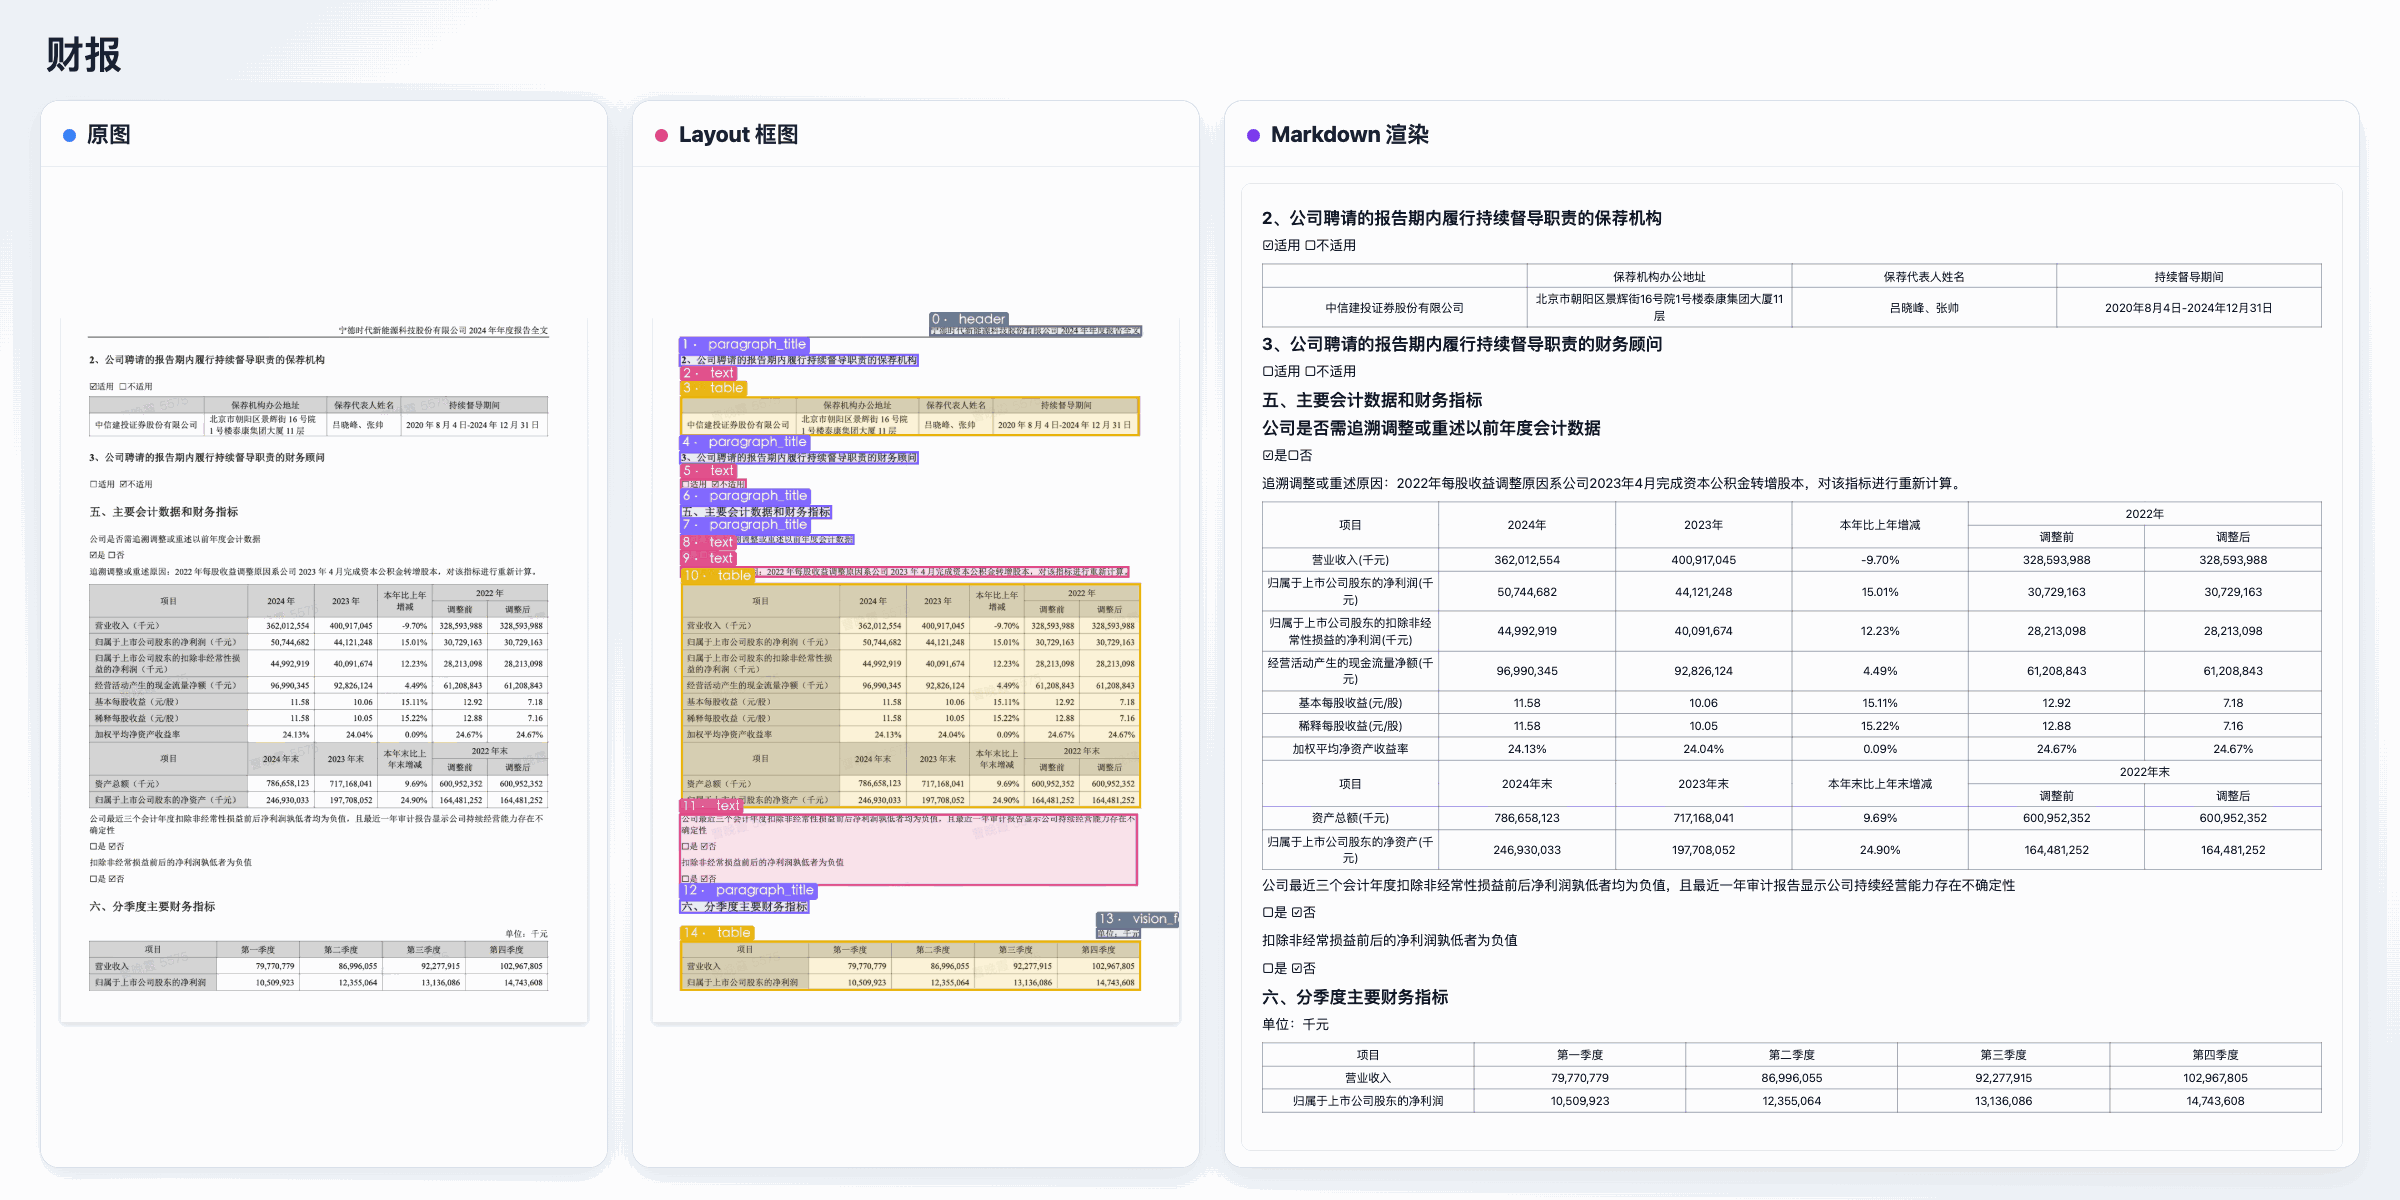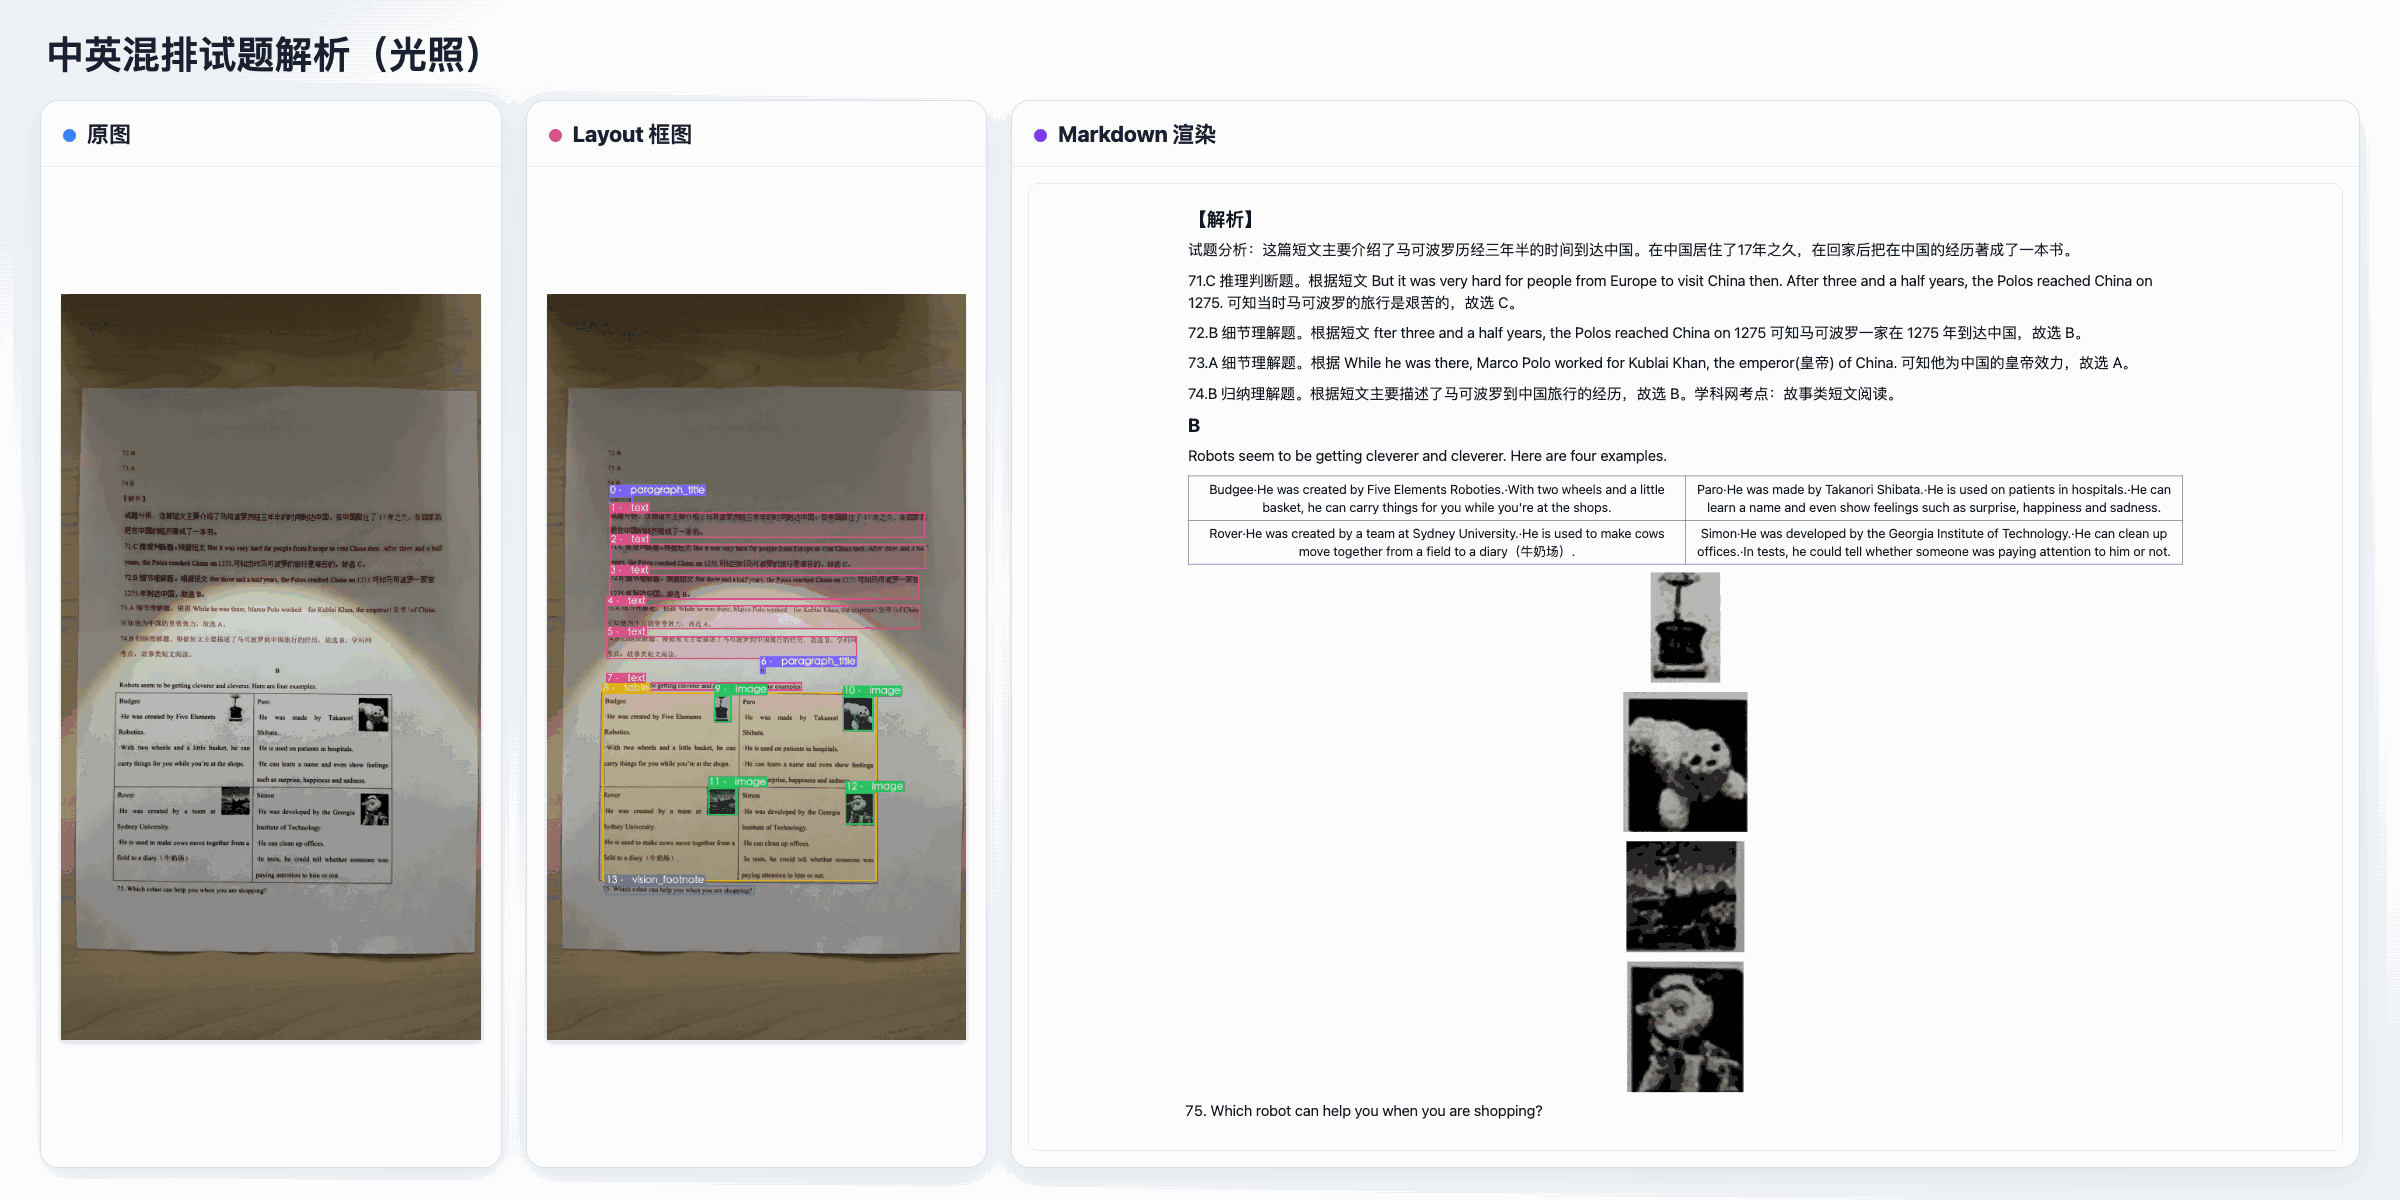
做文档 agent 的人,最该测的不是干净 PDF。密集表格、公式、手机照片,才是这套组合的考场。1.3B 解析器加 2B 打分模型的价值,不在参数小,也不在榜单多一个点。它让审核成本跟着文档脏的程度走,页数不再是主要成本。低分内容有人接,高分内容自动过,这条流水线才成立。
项目地址:
GitHub:https://github.com/OpenBMB/MiniCPM-OCR
MiniCPM-OCR 1.0:https://huggingface.co/openbmb/MiniCPM-OCR-1.0
MiniCPM-OCR Jev:https://huggingface.co/openbmb/MiniCPM-OCR-Jev
发布时间: 2026-10-29 08:42