一小时录音、40 种语言,NVIDIA 开源转录模型,实时字幕先别急
NVIDIA Nemotron 3.5 Transcribe 把转录、说话人标签、翻译和音频问答塞进一个开源权重模型。榜单很漂亮,但它不是流式模型,day-0 vLLM 也还不是最快的那套。
NVIDIA 发布了 Nemotron 3.5 Transcribe,开源权重,BF16、FP8、NVFP4 都有。它把多语言转录、说话人归因、翻译和音频问答放进同一个 checkpoint,day-0 通过 vLLM 和 NeMo Speech 提供服务。模型卡和发布帖都指向同一个定位:离线录音转写,长音频优先。
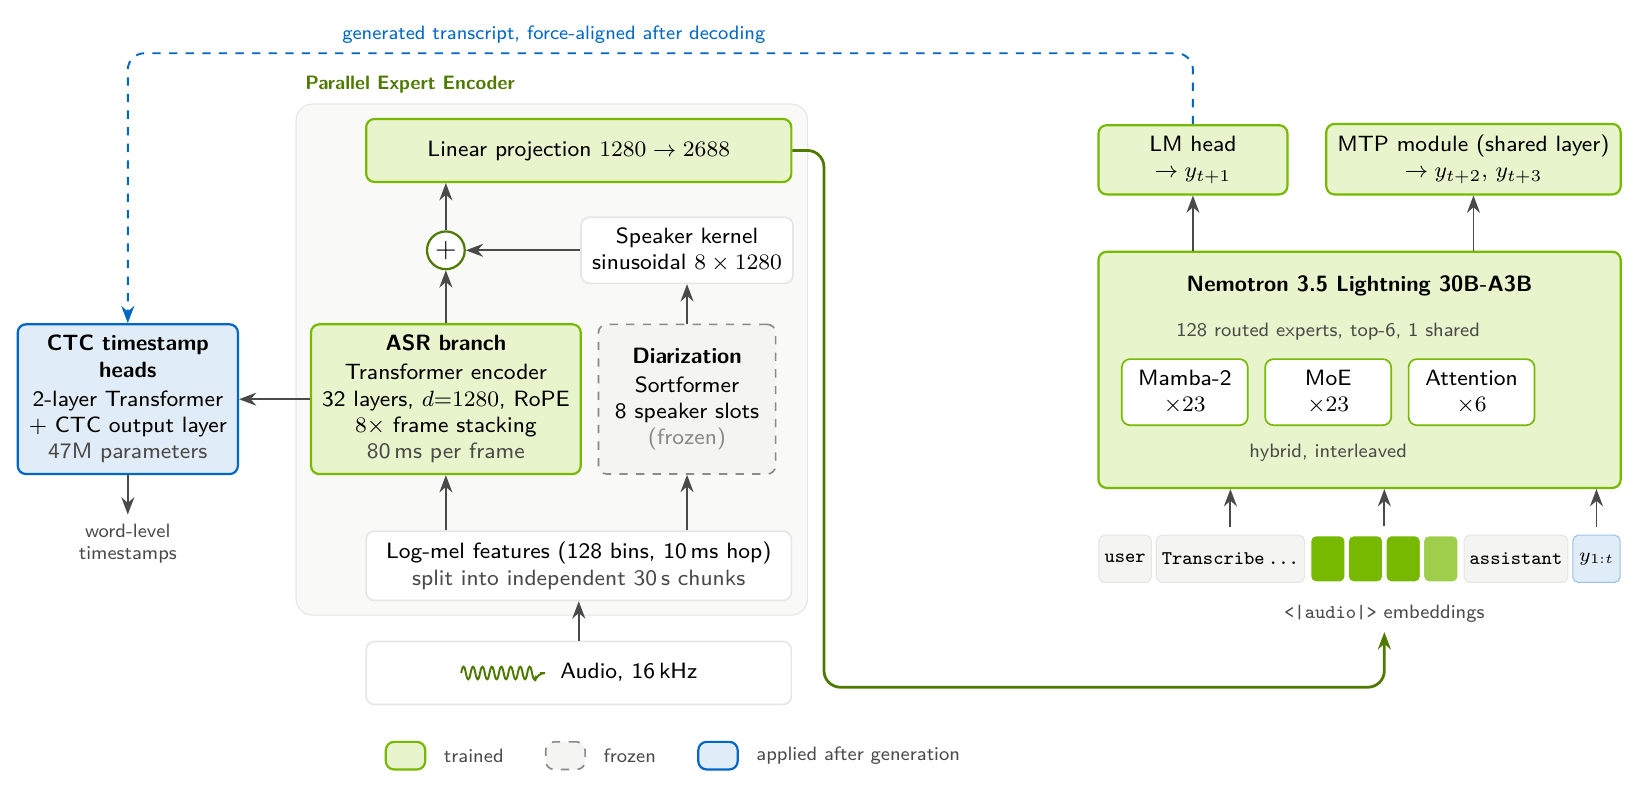
规格先摆清楚。总参数 34B,MoE 架构,约 4.3B 活跃参数,包含音频编码器。上下文 65,536 token,支持最长 1 小时录音。转录覆盖 40 种语言,31 种语言可和英语互译,13 种语言支持说话人归因,最多标记 8 个说话人。官方建议部署用 1 张 H100 80GB。
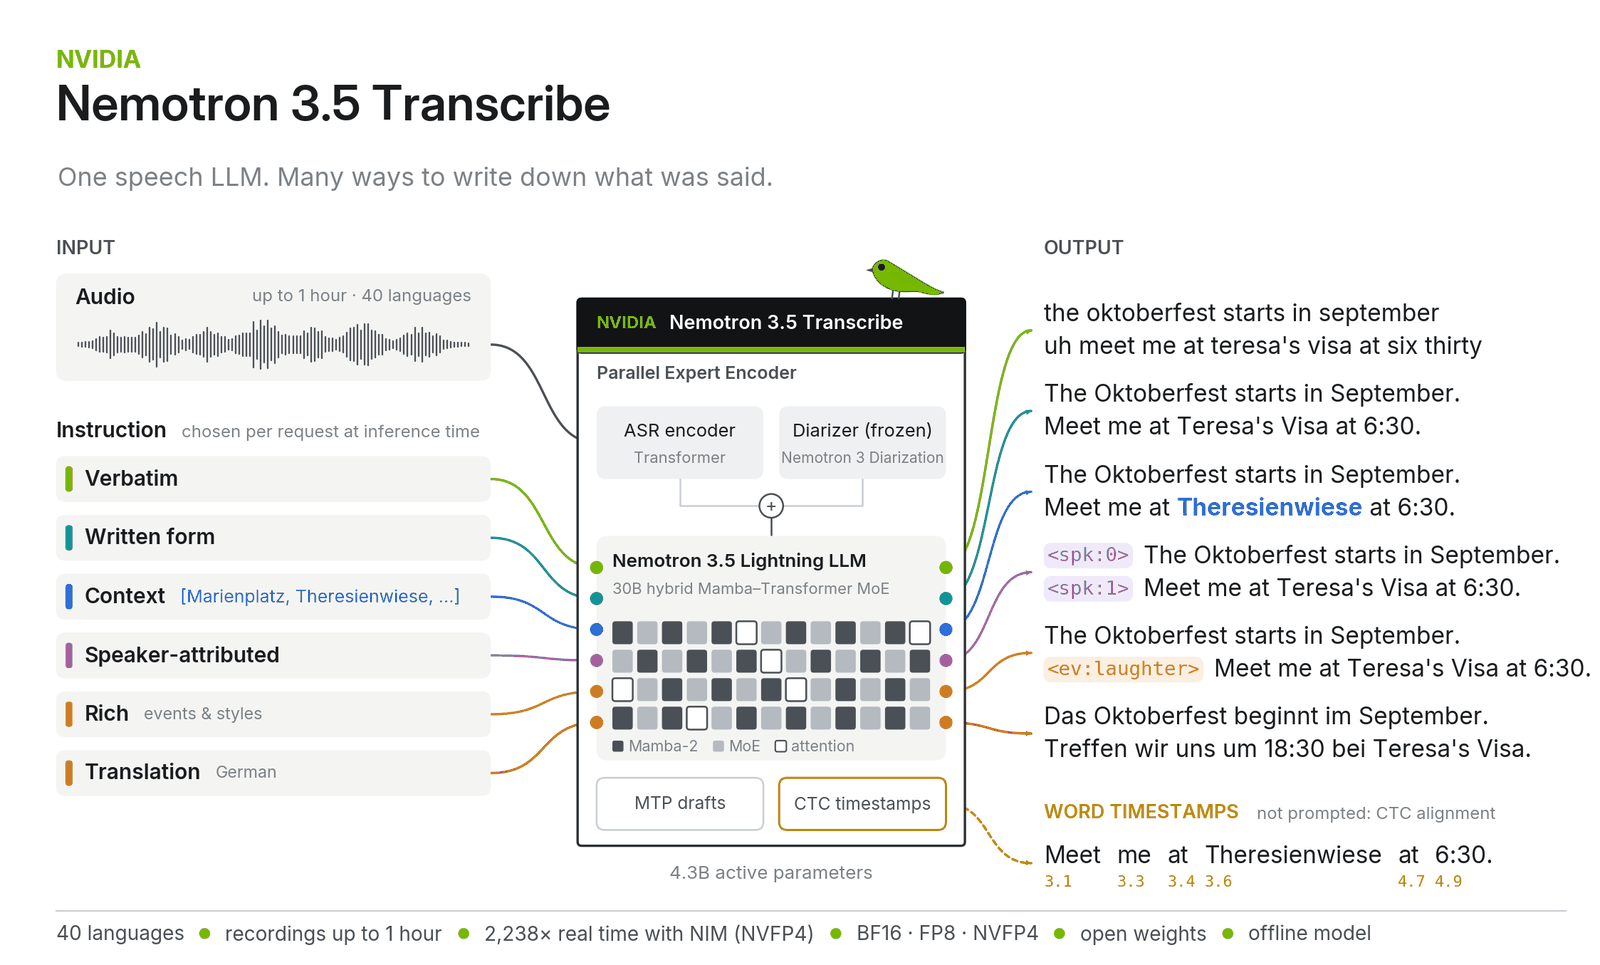
架构图也值得看。音频侧是 Transformer ASR 编码器加 Sortformer 说话人编码器,后面接 CTC 时间戳对齐头,再进 Nemotron 3.5 Lightning 的混合 Mamba-Transformer MoE 语言主干。说人话就是,说话人信息和声学特征一起进模型,生成转写时就能带出谁在说话,不用全靠后处理硬贴标签。
榜单部分,vLLM 发布帖写的是 English Open ASR 在开源权重模型里排第一,5.33% WER;多语言 Open ASR 在 7 种语言上平均 4.62% WER。模型卡后来列出的 9 个公开集均值是 4.71%,长音频均值 10.98%。两个 WER 不是一个口径,引用时别混着比。

效率这块更有意思。Artificial Analysis 上,Nemotron 3.5 Transcribe 做到约 2.80% AA-WER,活跃参数约 4B;Voxtral Small 是 2.77%,活跃参数 24B。精度接近,活跃参数约六分之一。这个对比比单纯喊第一名有用。

说话人归因是这次的主打。David AI 的 21 语言 diarization 榜上,它拿到 18.26% 总体 DER,排第一;VoiceArena 的 14 系统对比里,cpWER 32.4%,也是第一。官方放了一段会议录音示例,让模型加说话人标签、时间戳、翻译,再找 PII。


一个判断是,榜单漂亮不代表能直接替换现有转录流水线。模型卡写得很清楚,这是离线模型,不是实时流式 ASR。内部按 30 秒切块处理,不等于 30 秒延迟承诺。vLLM 帖下面有网友追问 8kHz 电话音频、串音、重叠语音下的 diarization,以及 NVFP4 和 BF16 在印度英语口音上的 WER。官方模型卡没有给这些组合的完整答案。生产环境不按榜单出题。
部署也得看版本。day-0 的 vLLM 集成在 NeMo Speech 里,要求 vLLM 0.32.0,OpenAI 兼容 chat completions,支持 MTP 投机解码。官方同时说明,这套开源集成面向模型开发,预计比优化后的 NIM 实现慢约 2 倍。100 小时音频在单张 RTX PRO 6000 Blackwell 上不到 3 分钟,用的是即将推出的 NVFP4 量化、30 秒片段和高并发,那套优化还没进开源版本。

微调链路也放出来了。Granary v2 公开清单覆盖 463,062 小时、48 种语言、16 个来源语料,配套 NeMo Speech 微调工具。医疗 ASR 案例里,完整测试集 WER 从开箱 30.8% 降到换 prompt 后的 23.8%,微调后 11.8%。在留出说话人上,最佳 prompt 基线 22.44% WER,微调后 12.17%,相对下降 45.8%。整套适配约 14 GPU-hours,一张 GB300。


限制也明确。中文普通话在支持矩阵里是 Supported,可能还需要微调;音频理解、推理和语音指令跟随只在英语上评估,别默认其他语言一样稳。说话人标签只区分录音内的不同说话人,不建立真实身份。时间戳需要开 CTC 对齐,DFlash2 投机解码那条路不支持时间戳。
想试的话,Hugging Face 有在线 demo,模型权重、Granary v2、vLLM 部署指南和微调教程都给了。Baseten、DeepInfra、Simplismart 也提供托管端点。SGLang-Omni 能整文件转录,但时间戳、说话人输出、翻译和投机解码不在那个集成里。
链接放这:
- 模型权重:https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
- 在线 demo:https://huggingface.co/spaces/nvidia/nemotron-transcribe
- 发布博客:https://huggingface.co/blog/nvidia/nemotron-transcribe-granary
- vLLM 部署指南:https://github.com/NVIDIA-NeMo/Speech/blob/main/docs/source/speechlm2/vllm_serving.rst
- Granary v2:https://huggingface.co/datasets/nvidia/Granary-v2
一句话收尾:长录音、多语言、谁在说话,这三件事 NVIDIA 这次给得很足。实时字幕和电话客服那种 8kHz 脏数据,先等更具体的评测。
发布时间: 2026-10-29 11:44