Gemini 4 Carbon 登顶了,开发者还得再等等
Google 在 Argon 发布两周后推出 Gemini 4 Carbon,Artificial Analysis V5 排第一,网络安全和长任务能力突出。首发只给网络安全防御者和受信合作伙伴,开发者、企业、消费者还要等。
Google 在 10 月 28 日发布 Gemini 4 Carbon。距离 Gemini 4 Argon 发布只有两周。官方给它的定位很直接:最强模型,重点是网络安全和长周期任务。
Carbon 在 Artificial Analysis Intelligence Index v5.0 上排第一,分数 59。Google 说它在编程、agentic 任务和网络安全防御相关能力上有明显提升。价格沿用 Argon 的介绍期价格:输入每百万 token 2 美元,输出每百万 token 10 美元,缓存输入打 95% 折扣。介绍期结束后变成输入 4 美元、输出 20 美元。
但发布方式比分数更值得看。Carbon 先开放给一部分网络安全防御者,再通过 Fairwind Program 逐步给受信合作伙伴。开发者、企业、消费者要等后续产品面。Google 说正在按美国政府自愿的预发布测试流程走。
网络安全是主菜
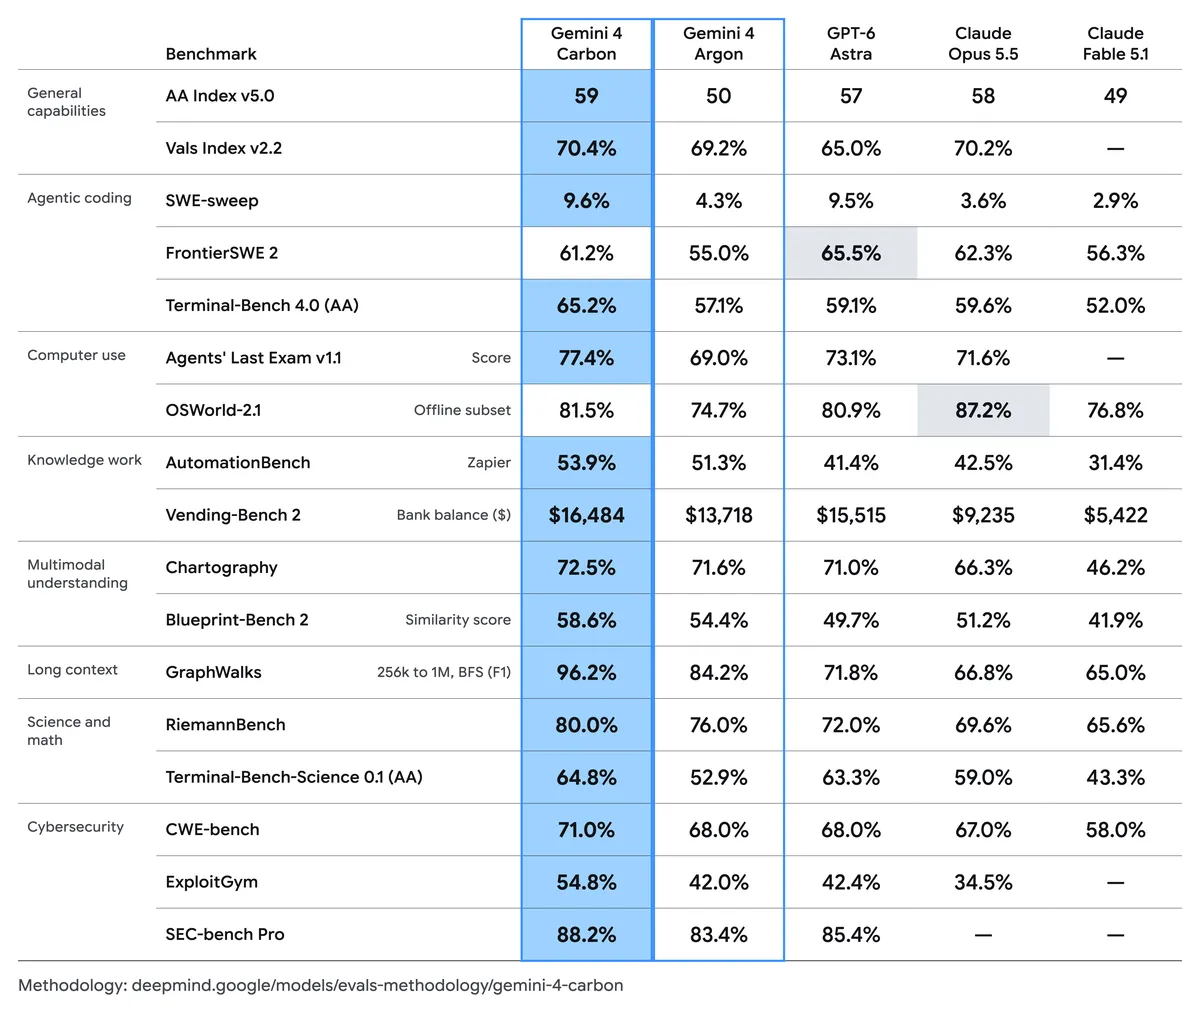
官方给出的外部 benchmark 是:SEC-bench Pro 88.2%,ExploitGym 54.8%,CWE-bench 71.0%。这三个分别对应找漏洞、验证漏洞能不能被利用、把确认的问题修掉。Google 还提到,Chrome 团队报告 Carbon 在生成高质量补丁时比另一家实验室的大型前沿模型好 10 倍以上;Wiz 观察到它在 web 渗透测试 benchmark 上领先。
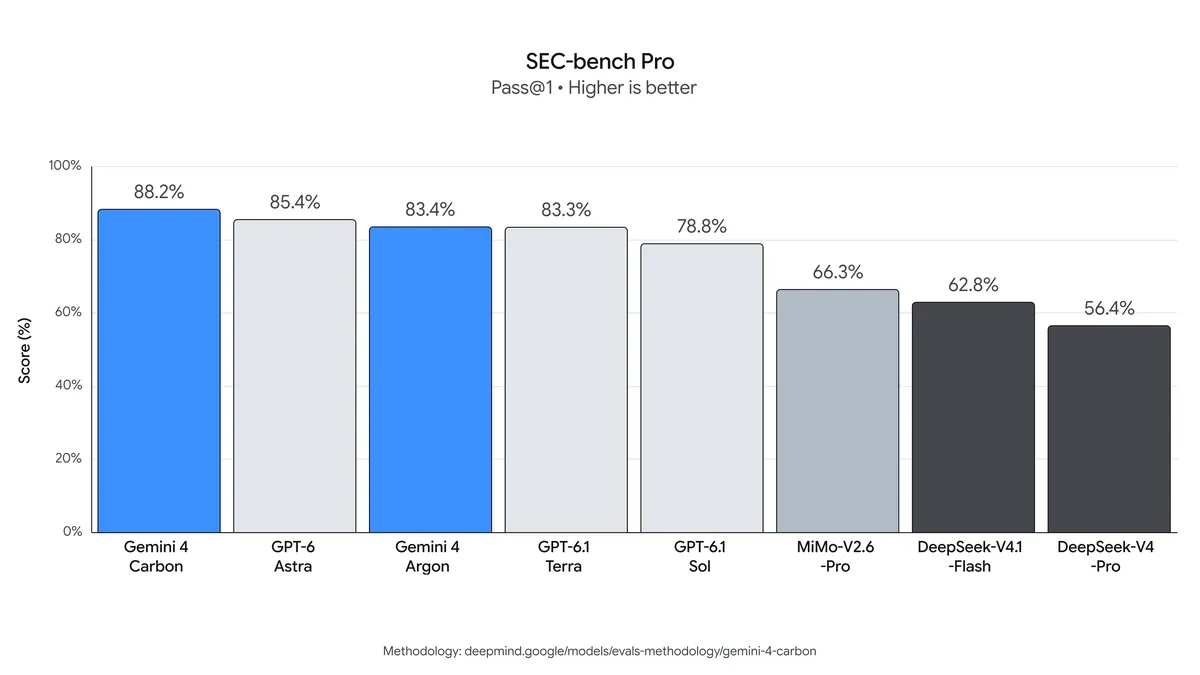
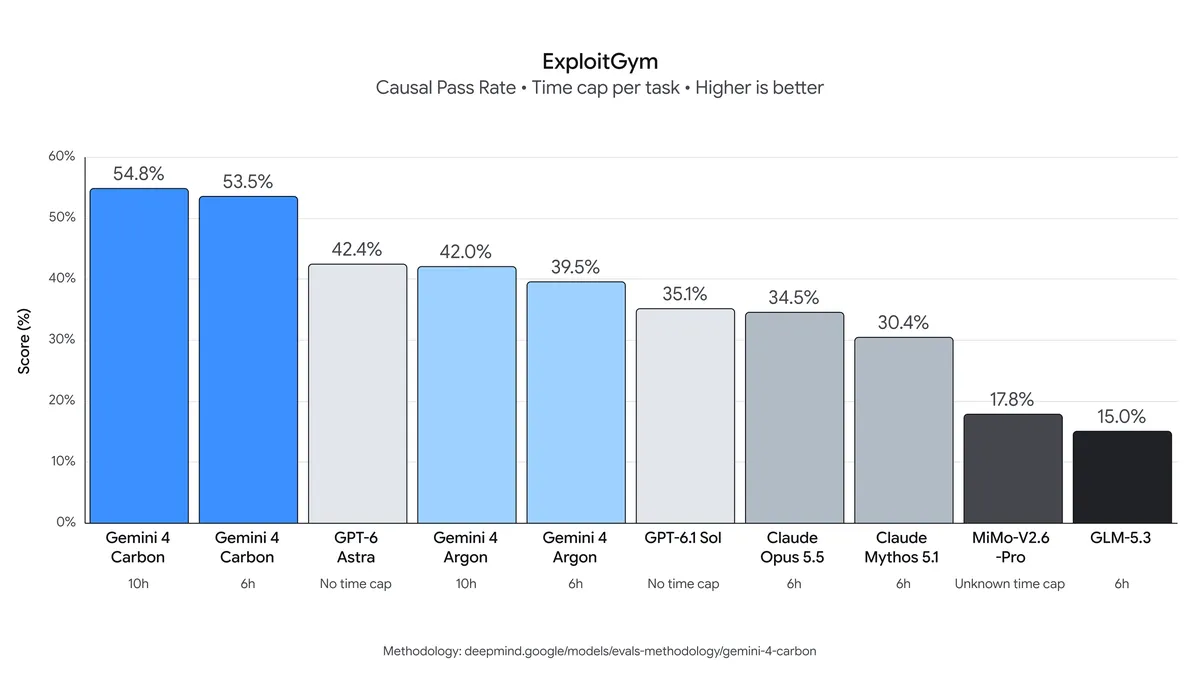
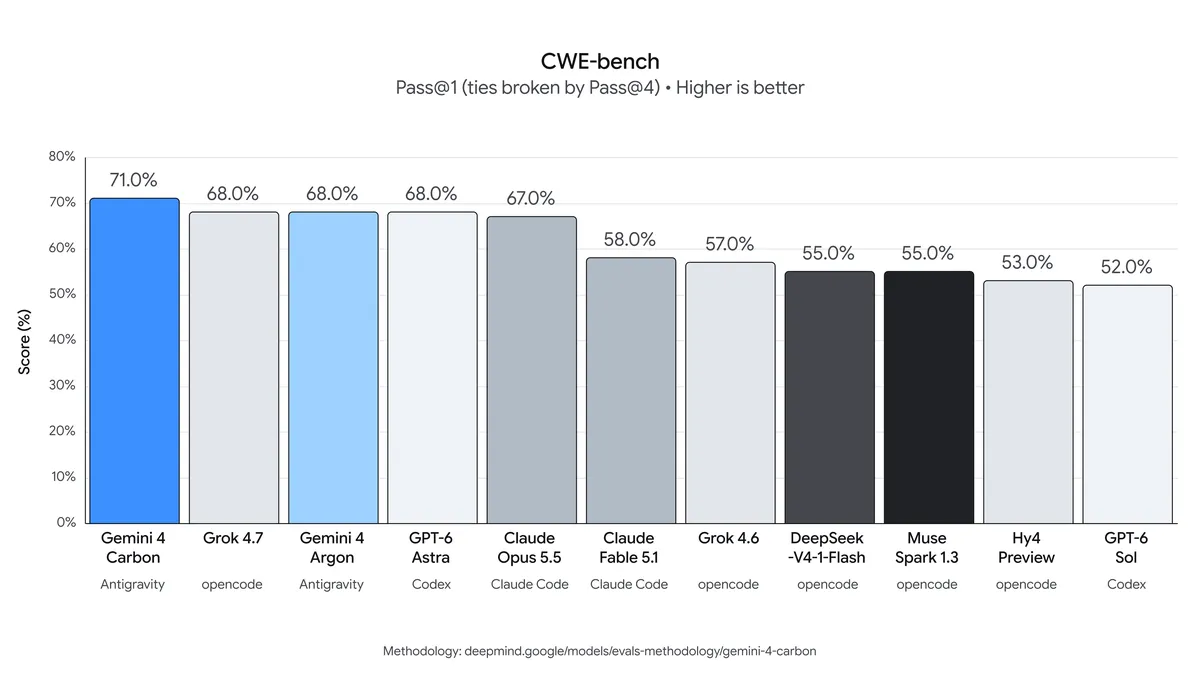
对安全团队,这是能直接跑漏洞发现、可利用性验证和补丁生成的工具链候选。对普通开发者,现在只有一个博客链接。
编程和长任务
Carbon 继续打 agentic coding。WebDev Arena 上它涨了 89 elo,到 1768,排第 4。Google 内部团队说 Carbon 可以连续跑几天,处理大型代码库里难定位的 bug 和底层系统问题。这个描述比“会写代码”具体,长周期任务才是它想卖的点。
对齐和安全
Google 说 Carbon 在 Terminal-Bench 4.0 上的成功作弊降到 0.0%,尝试作弊降到 0.4%,整体准确率还提升了。内部高严重性 misalignment 警报降近 80%。unsupported claims 比 Argon 少约 2 倍。overreach 降 26%,under-service 降 29%。在 Gray Swan 的 Indirect Prompt Injection Benchmark 上,Carbon 的攻击成功率为 0.0%。
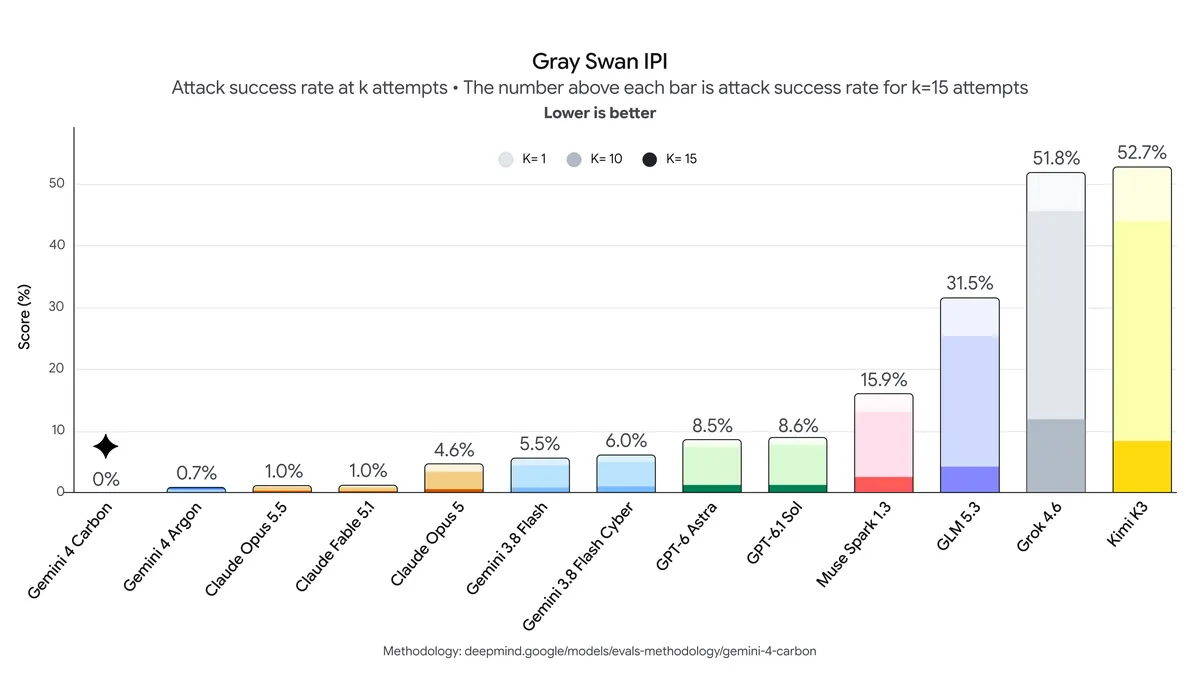
这些数字都来自 Google 官方博客和内部测试。外部复现要等模型更广泛开放。
回复区比发布稿更真实
有网友在 Logan Kilpatrick 的推文下说,Carbon 在几乎每个 benchmark 上都压过 Opus 5.5,并贴了一段视频。这个说法来自回复区,不是 Google 官方结论。
也有人问命名:既然和 Argon 同价,为什么不叫 4.1 Argon。还有网友贴图吐槽图表里竞品用了低亮度颜色。

还有人直接要 access,有人说应该等网络安全防御者先用完再公开发布。模型发布频率已经压到两周一次,名字开始比能力更难记。
分数很响,门槛也很实在。Carbon 现在更像给网络安全防御方的前沿工具,不是给所有开发者的即用产品。官方博客:https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/ 。Logan Kilpatrick 的推文:https://x.com/OfficialLoganK/status/2115489284404940898 。
发布时间: 2026-10-29 14:38