多个LLM评委打分,简单平均反而更差
UC Berkeley 的 RaRE 用置信度加权和分歧丢弃改多评委奖励。HealthBench 0.364 对最佳单评委 0.339,GPQA Diamond 0.412 对 0.406。简单平均没赢,关键在怎么处理信心和分歧。
用 LLM 当评委给开放式任务打分,再拿这个分数做强化学习,这套方法叫 Rubrics as Rewards,简称 RaR。UC Berkeley 的 Michael Tian-Yue Liu、Anne Harrington、Trevor Darrell、Yutong Bai 在论文《Judging the Judges: Confidence and Disagreement in Rubrics as Rewards》里换了个问题:单个评委换成多个评委,奖励会不会更稳。结论有点反直觉:把多个评委的分数直接平均,打不过最好的单评委;要让多评委有用,得处理置信度和分歧。
先补背景。RaR 面向的是不好用标准答案验证的任务:先给一份结构化 rubric,再让 LLM judge 按 rubric 给模型输出打分,这个分数进入 RL 训练。之前的工作多在改 rubric,或者把单个 judge 做得更强。这篇论文把注意力放到 judge 身份和 judge 组合上。
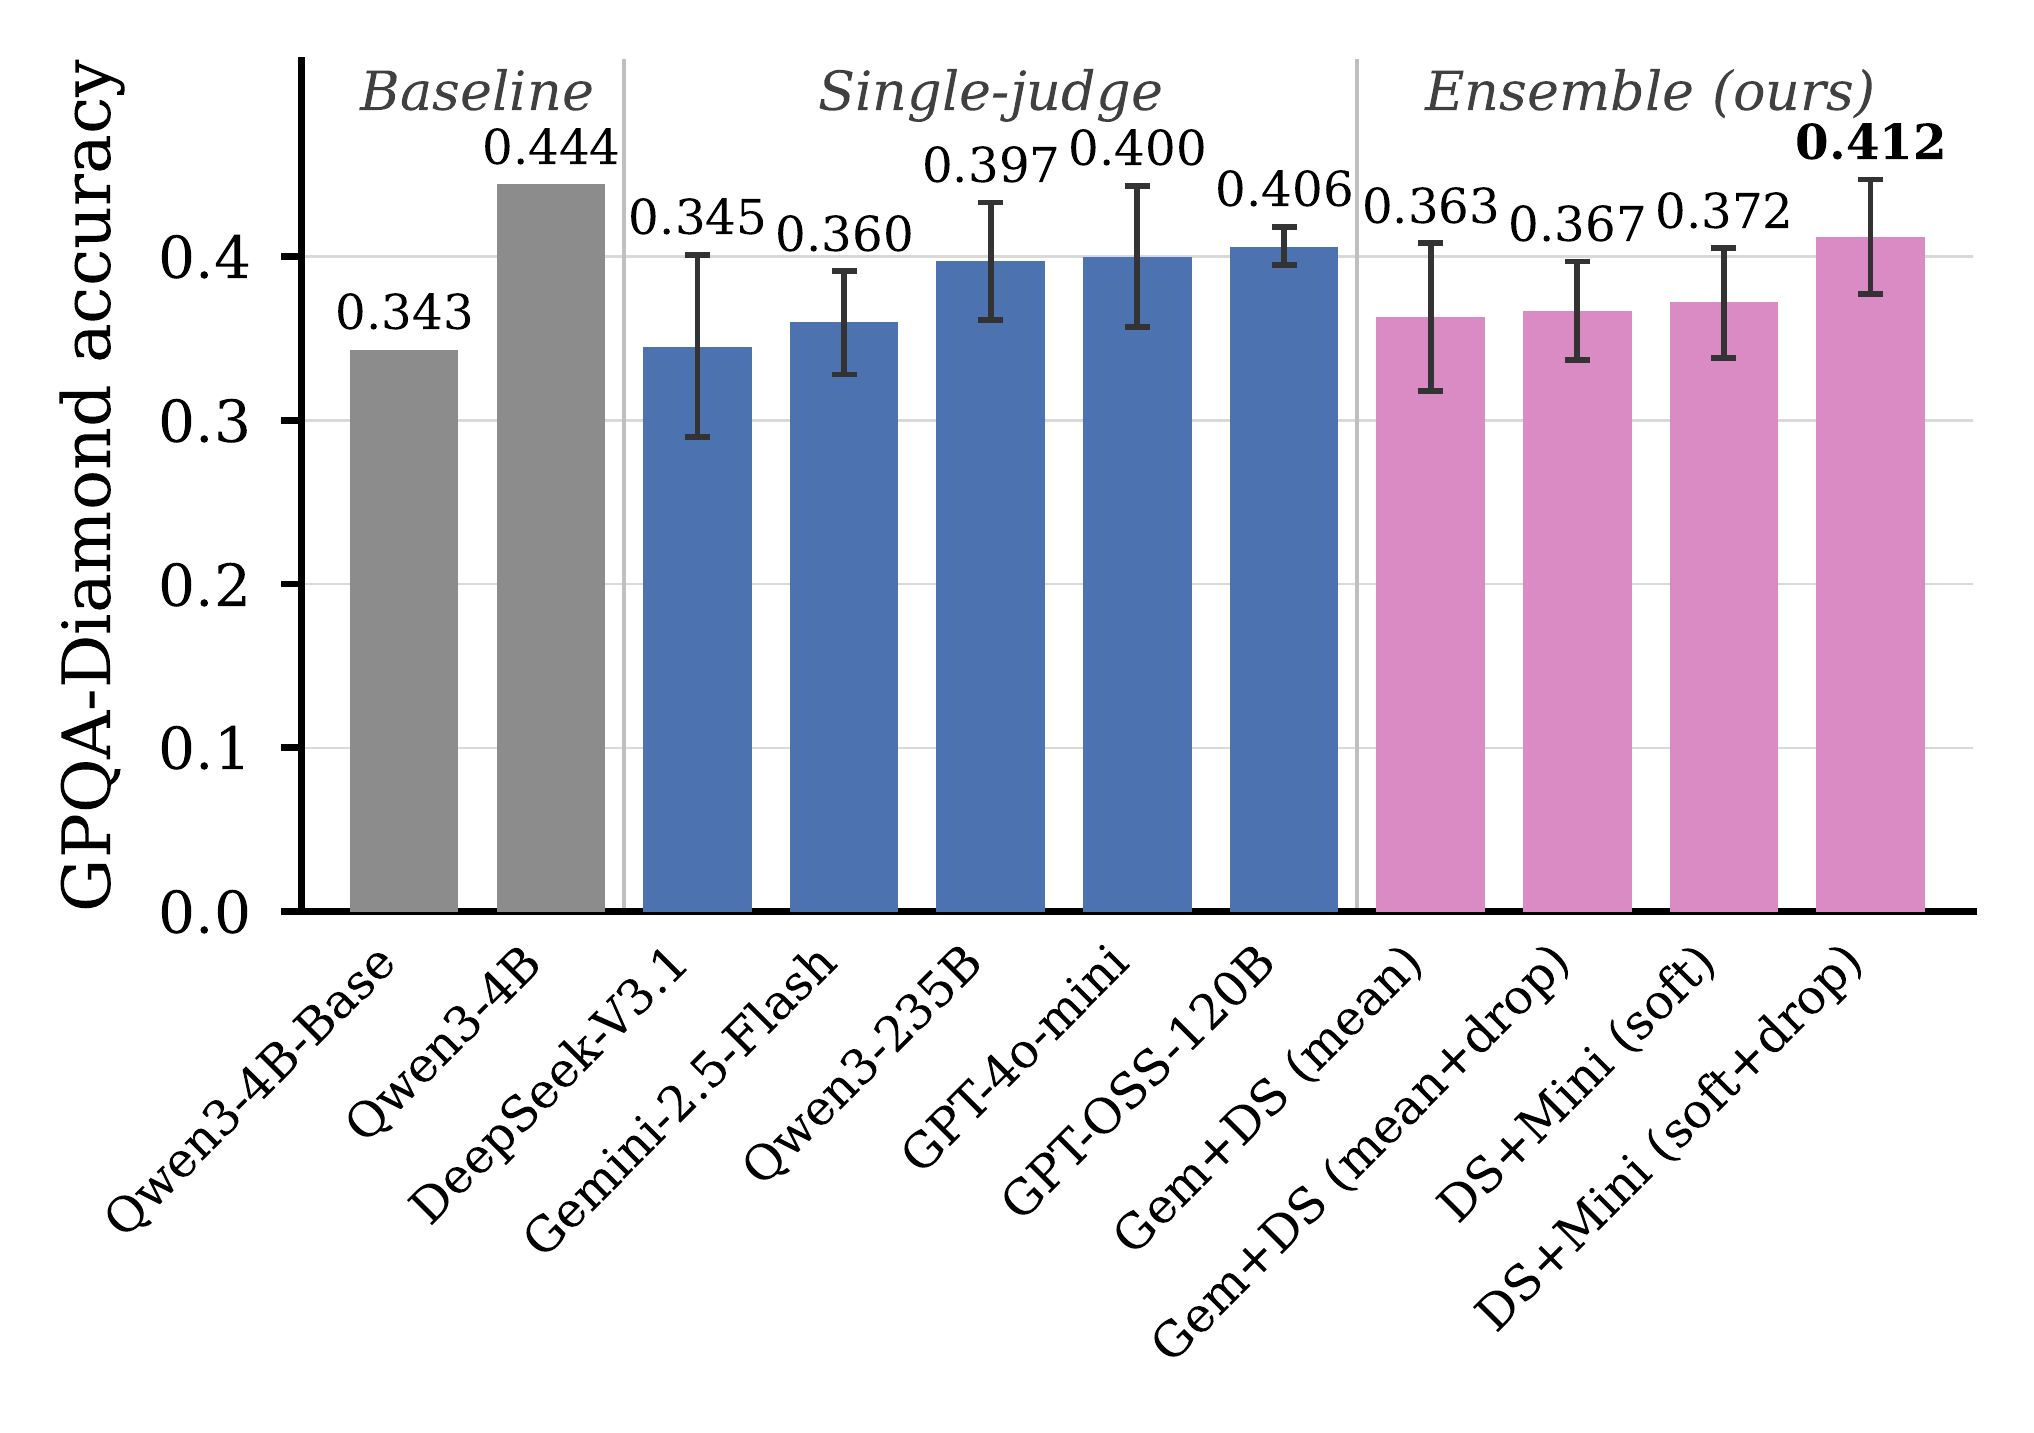
论文在 RaR-Medicine 和 RaR-Science 上训练 Qwen3-4B-Base,用 GRPO,换用五个前沿模型和开源权重模型当评委,最后在 HealthBench 和 GPQA Diamond 上评估。单评委身份带来的分数差异不小:HealthBench 上单评委分布在 0.296 到 0.339,GPQA Diamond 上在 0.345 到 0.406。HealthBench 上,未经 RL 的 Qwen3-4B-Base 是 0.257,调过的参考模型是 0.308。
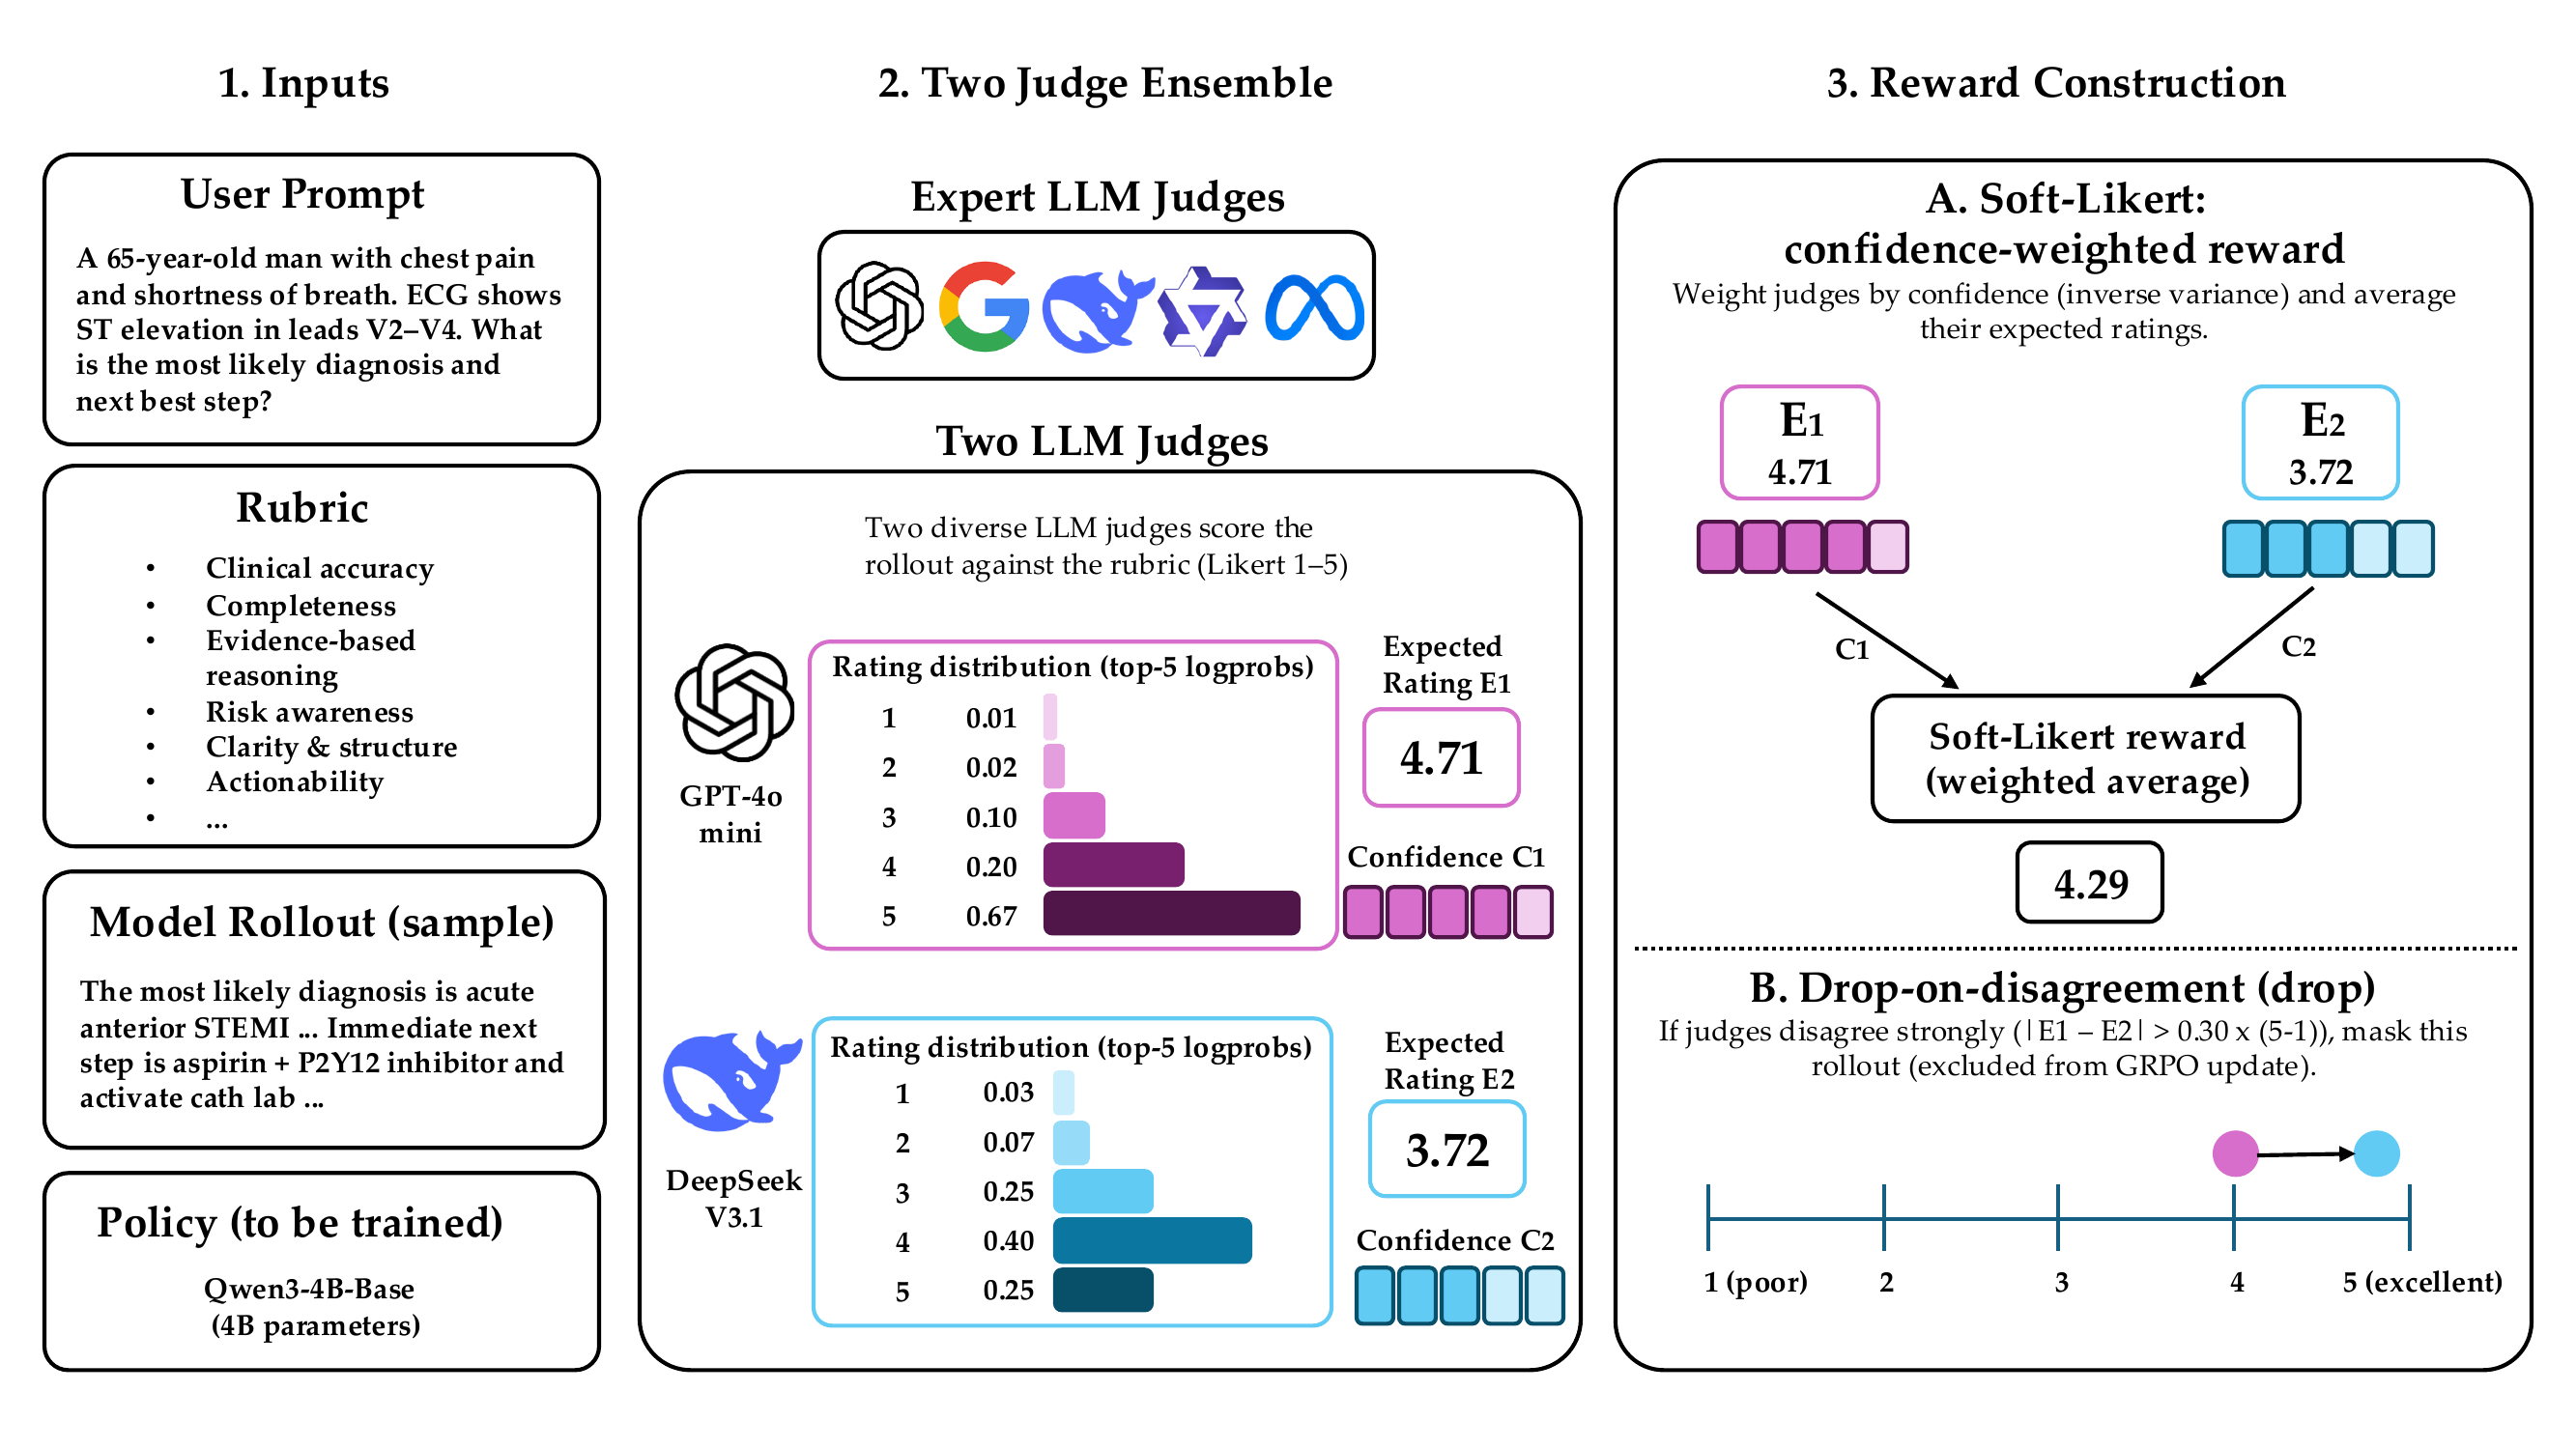
论文提出 RaRE,全称 Rubrics as Rewards with Ensembles。两个机制可以单独用,也可以叠加。
第一个是 soft-Likert reward。每个 judge 在 1 到 5 分里打分。方法读取评分数字位置的 top-5 logprobs,重新归一化后得到期望评分 E_j 和置信度 c_j=1/(1+Var_j)。奖励按置信度加权平均:r_soft = (1/L) * Σ c_j E_j / Σ c_j,L=5。更自信的 judge 权重大,拿不到 logprobs 的 judge 退回整数评分。
第二个是 drop-on-disagreement。对每个 rollout,计算评委归一化评分的极差 d=(max_j r_j - min_j r_j)/(L-1)。d 超过阈值 τ 时,这个 rollout 的奖励被替换成同组未 mask 样本的均值,GRPO 里的 advantage 变成 0,不贡献梯度。HealthBench 1K 子集上,Gemini+DeepSeek 这组在 τ=0.30 时丢弃约 5%,分数 0.330;论文最佳 RaRE 在 medicine 里用 0.30,在 science 里用 0.40。
直接平均为什么不行?论文给了数。HealthBench 上,Gemini+DeepSeek 直接平均是 0.307,低于最佳单评委 GPT-4o-mini 的 0.339。GPQA Diamond 上,Gemini+DeepSeek 平均是 0.363,也低于最佳单评委的 0.406。把分数平均,置信度低、分歧大的判断也被混进来,奖励信号被稀释。
RaRE 的组合方式不一样。最佳配置是 DeepSeek-V3.1 + GPT-4o-mini 的 soft-Likert 加 drop。HealthBench 上 0.364,对最佳单评委 0.339;GPQA Diamond 上 0.412,对最佳单评委 0.406。两个基准都超过了所有单评委 RaR 变体。
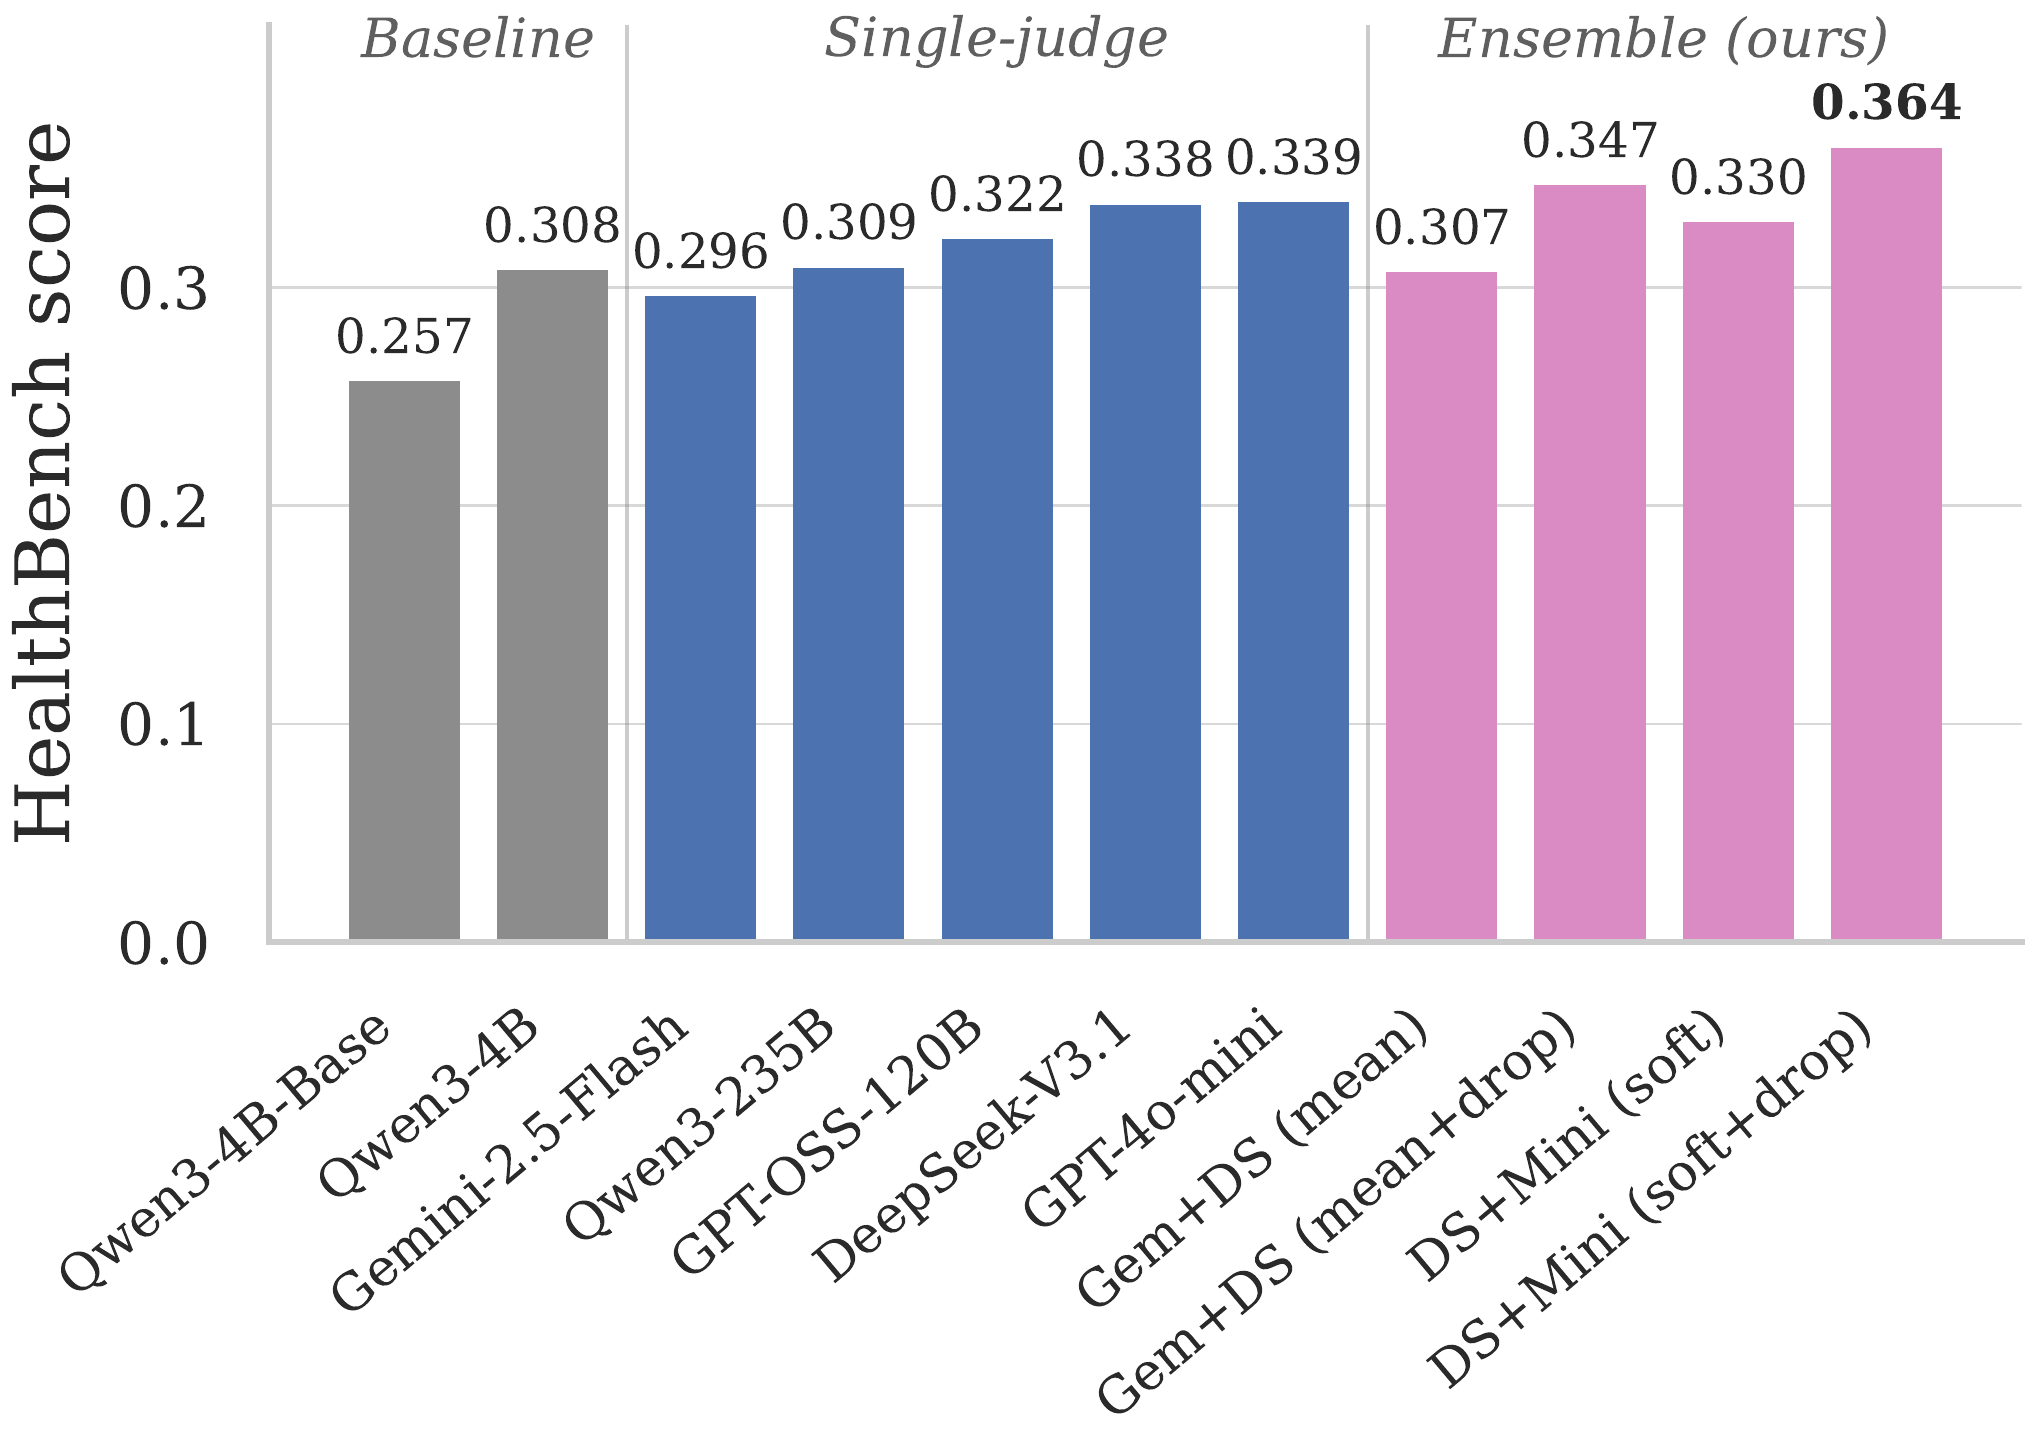

按 HealthBench 主题拆开看,RaRE 没有把各评委的长处平均掉,它继承了这些长处。DeepSeek-V3.1 + GPT-4o-mini 在 Comm.、Complex、Context、Emerg.、Global、Data、Hedging 七个主题上都拿到行内最高增益。例如 Global +0.131,Hedging +0.134,Context +0.118。

消融也能说明问题。置信度聚合从 inverse-variance 加权平均换成 top-logit 加权平均,分数从 0.336 掉到 0.214;换成 top-logit winner-takes-all 掉到 0.198,差 12 到 14 个百分点。阈值 τ 也不是越严越好:τ=0.15 时丢弃 14%,分数掉到 0.251;τ=0.30 丢弃 5%,分数 0.330。
评论区有人追问哪些 HealthBench 主题造成最多分歧,推文线程没有展开。也有人提到,关键是把分歧和信心算进去,不然评委一多可能只是把噪声平均了。还有人问有没有单独消融评委多样性和置信度加权的贡献。论文里能看到单评委、两组评委配对和置信度聚合方式的比较;更细的多样性消融,需要翻论文和代码。
代码仓库写得很具体:训练用 Slurm 脚本,单节点 8 张 80GB GPU,评估用单卡;共享配方是 1000 条训练 prompt、每个 prompt 8 个 rollout、100 步、学习率 5e-6、全量微调、max completion 1024 tokens、vLLM colocate。Soft-Likert 需要 judge 返回 logprobs;DeepSeek-V3.1 由 Together 提供时能拿到,但这个端点现在不支持了。
论文:https://arxiv.org/abs/2610.21179
发布时间: 2026-10-29 20:40