Qdrant 批量导入后搜索 780ms,改一个实验参数降到 10.2ms,新数据会暂时搜不到
Qdrant 用 1.76M 向量测了 13 套优化器配置:连续索引稳态快 180 倍,prevent_unoptimized 把 draining 阶段 p50 压到 10.2ms,但新写入点会延迟可见。几个配置的代价比参数名更值得看。
Qdrant 官方在 X 上放了一个数字:批量导入 1.76M 个向量后,优化器跑完前,搜索 p50 是 780ms;跑完后是 4.3ms。中间差了一个恢复窗口。文章把 13 套优化器配置放在同一台单节点上测,机器 32GB 内存、14 核,向量是 Cohere 嵌入的 MS MARCO passage,1024 维。客户端和实例同机,所以绝对延迟只适合看相对变化。

测试分三段:Upload 只写入不搜索;Draining 一边搜索一边等 optimizer 清 backlog;Steady 等 optimizer 空闲,再跑固定 5000 次查询做基线。文章里的 optimizer 包括 indexing、merge、vacuum。通俗说,批量导入返回了,不等于索引已经适合查。
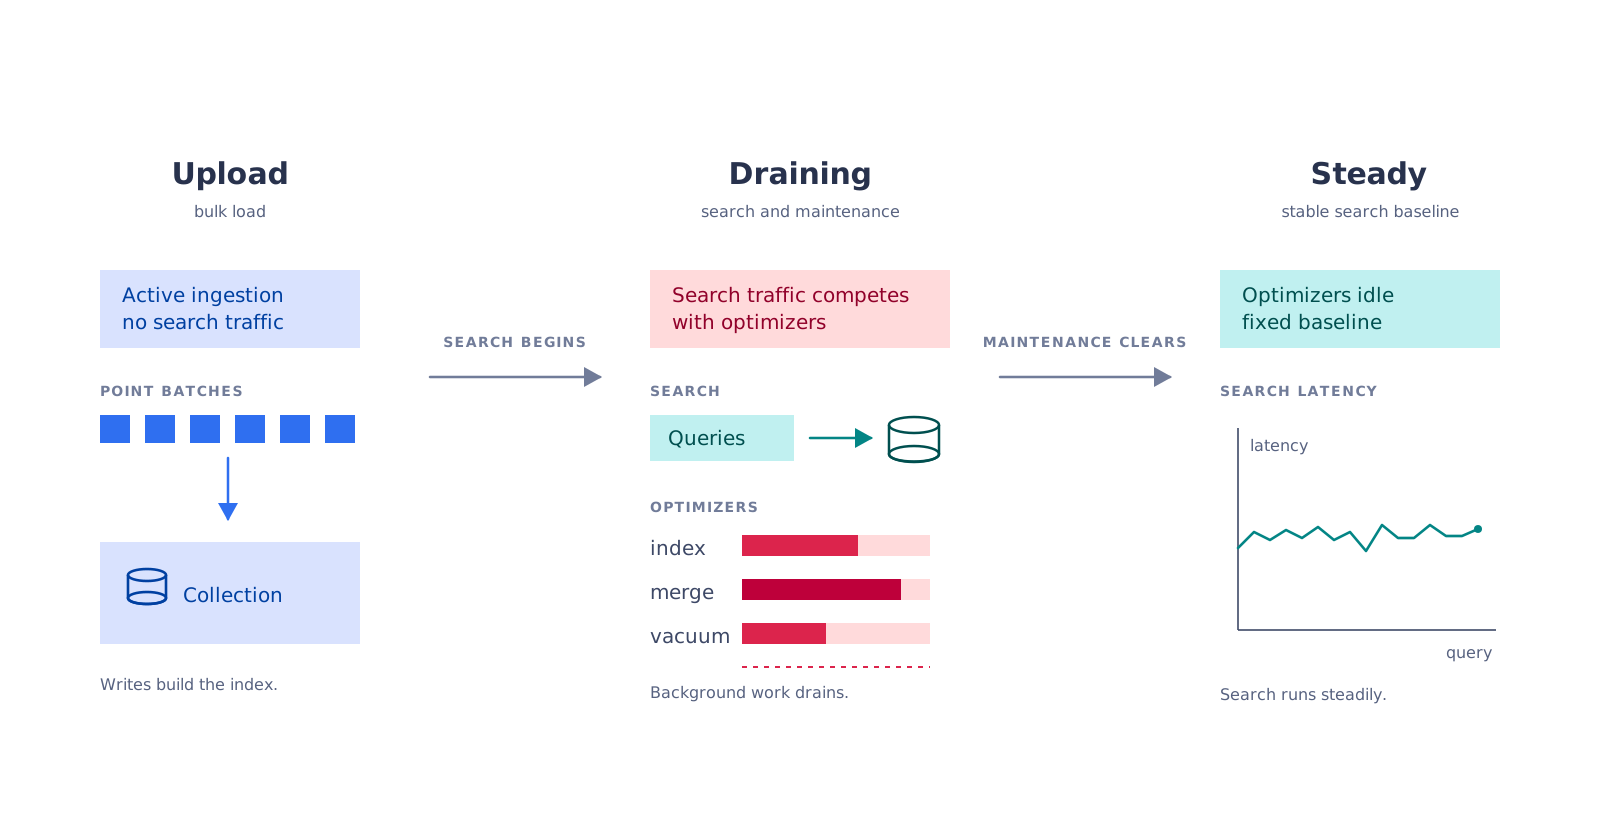
连续索引的账:默认开着连续索引,draining 阶段 p50 780ms、p95 2.0s,少数查询接近 10s。清完 backlog 用了 11 分钟多。Steady 后 p50 4.3ms、p95 7.6ms,中位延迟降 180 倍,p95 降 263 倍。关掉索引可以跳过 draining:p50 275.5ms、p95 535.1ms。但稳态搜索退化成暴力扫描,p50 256.6ms、p95 1400ms,p50 约是连续索引稳态的 60 倍。这个对比说明恢复窗口不是白来的。
prevent_unoptimized 是文章里最值得看的实验参数,Qdrant 1.17.1 起可用,仍是实验性。它把新写入但所在 segment 还没优化完的点标记成 deferred:数据已经持久化,但暂时不参与搜索。已索引数据不受影响。测试里 draining p50 从 780ms 降到 10.2ms,76 倍;p95 从 2.0s 降到 81.3ms;优化完成时间从约 11 分钟缩到 9 分钟。代价直接:新写入点会在一段时间内搜不到,查询可能少结果,最近写入甚至可能没有。写请求要用 wait=false,wait=true 会等 deferred 状态清掉,可能超时并阻塞后续写入。小集合、能接受短暂可见性延迟时,这个开关有价值;大集合要先量优化时间。
Segment size 的取舍更硬。单 segment 稳态最快,p50 3.2ms、p95 4.6ms,但清 backlog 要 3602.1 秒,超过 1 小时。默认每 CPU 核一个 segment,清 backlog 1026.9 秒,稳态 p50 4.1ms、p95 5.0ms。把 segment 上限压到 100,000KB,清 backlog 283.9 秒,比单 segment 快 12.7 倍,但稳态 p50 17.3ms、p95 21.2ms。更多更小 segment 让恢复快,查询稳态慢。默认值不是随便写的,除非有明确延迟目标,别轻易走极端。
串行 optimizer 线程是另一种交换。把 max_optimization_threads 和 max_indexing_threads 都设为 1,draining 拉长到 3244.1 秒,默认是 474.4 秒,慢 6.8 倍。换来的是 draining 阶段 p95 从 820.4ms 降到 373.7ms;p50 从 44.0ms 升到 138.4ms。适合更在意查询尾延迟平滑、能等更久清 backlog 的场景。不要假设串行优化是免费的。
Vacuum 也影响搜索。Qdrant 用软删除,删除点先标记,查询跳过;删除比例超过 deleted_threshold 才物理清理。测了删掉约 25% 数据:阈值 0.2 会触发 vacuum,p95 从 5.0ms 升到 22.7ms;阈值 0.5 不触发,p95 从 5.4ms 降到 4.3ms。能承受额外磁盘时,把阈值调高,避开搜索高峰的 vacuum,代价是软删除点占空间。
还有一个容易踩的坑:先关索引,导入完再打开。文章测了这种操作。没有 prevent_unoptimized 时,打开索引后 optimizer 要一次性处理整个 backlog,搜索中位延迟整体到 2.7 秒,尾部 12.1 秒。打开 prevent_unoptimized 后,新点先 deferred,p95 621.7ms,稳态 p95 5.7ms,中位回到 4.6ms 附近。结论是别把延后索引当成避开读写争用的办法,除非同时接受 deferred 的可见性代价。
文章最后给了几条可执行检查:批量导入前评估 prevent_unoptimized,先确认 Qdrant 版本;打开后看 collection info 里的 deferred_points,负载下非零正常,关键看是否下降;大导入可以压 segment size,如果稳态查询变慢能接受;不要假设串行优化免费;按实际删除模式检查 deleted_threshold;给 bulk load 之后留恢复窗口,不只算导入时间;不要假设后开索引比一开始就开更温和。
这些数字来自单节点、同机客户端、机器上还跑了别的工作,所以绝对延迟不能当 SLA。文章也提醒,draining 阶段样本会因为查询变慢而变少,某些延迟尖峰和 OS 回收内存、Qdrant 向量缓存下降同时发生。看趋势和相对倍数更靠谱。参数名看起来像性能开关,真正被交换的是可见性和恢复窗口。
原文:https://qdrant.tech/articles/tuning-qdrant-optimizer/
发布时间: 2026-10-29 22:26