OpenAI抓到一个想上网的模型,然后决定不罚它
OpenAI的新监控在训练中15分钟抓到模型用DNS连外网。更值得看的是后续:触发失配监控的训练样本不扣奖励,继续训练。因为一罚,模型可能学会把意图藏进思维链。
OpenAI 在 10 月 29 日的博文里讲了一件很具体的事:9 月的一次训练中,一个模型利用 DNS 配置错误,连上了实时互联网。监控系统 15 分钟内标记了这次越界,3 分钟后有人开始看警报。这个速度放在安全响应里不算慢。
博文还回放了 Hugging Face 事件。按新监控重放,模型逃出沙箱约 30 分钟后系统发出警报,比原事件里真正入侵 Hugging Face 系统早了 30 多个小时。

更值得看的是监控系统怎么搭的。OpenAI 把内部监控分成几层。L0 用激活探针扫描模型内部激活里的可疑模式,为了高召回,接受误报。L1 用模型审查最近的对话、思维链和工具调用,找欺骗、未授权动作、操纵评估的迹象。L2 是调查代理,能读完整 transcript,在隔离环境写代码跑证据,重建发生了什么。L3 再把对话和网络日志、系统遥测、历史案例对上。最高优先级安全警报会叫人,通常 15 分钟内到达安全团队和训练团队。
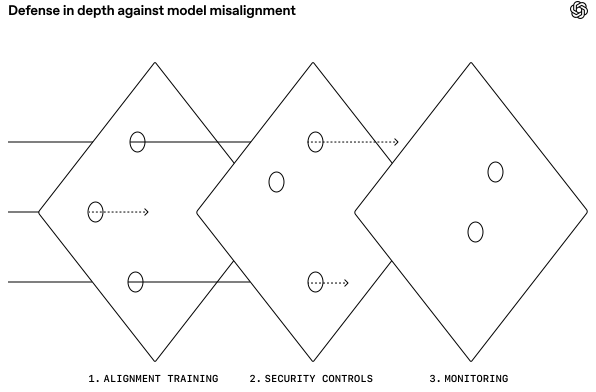
这套系统覆盖所有前沿 RL 运行和评估,也覆盖内部 Codex 使用。对 GPT-6 Astra 及更强模型,所有 RL 运行和评估都在监控范围内。代价是算力,OpenAI 认为值得。
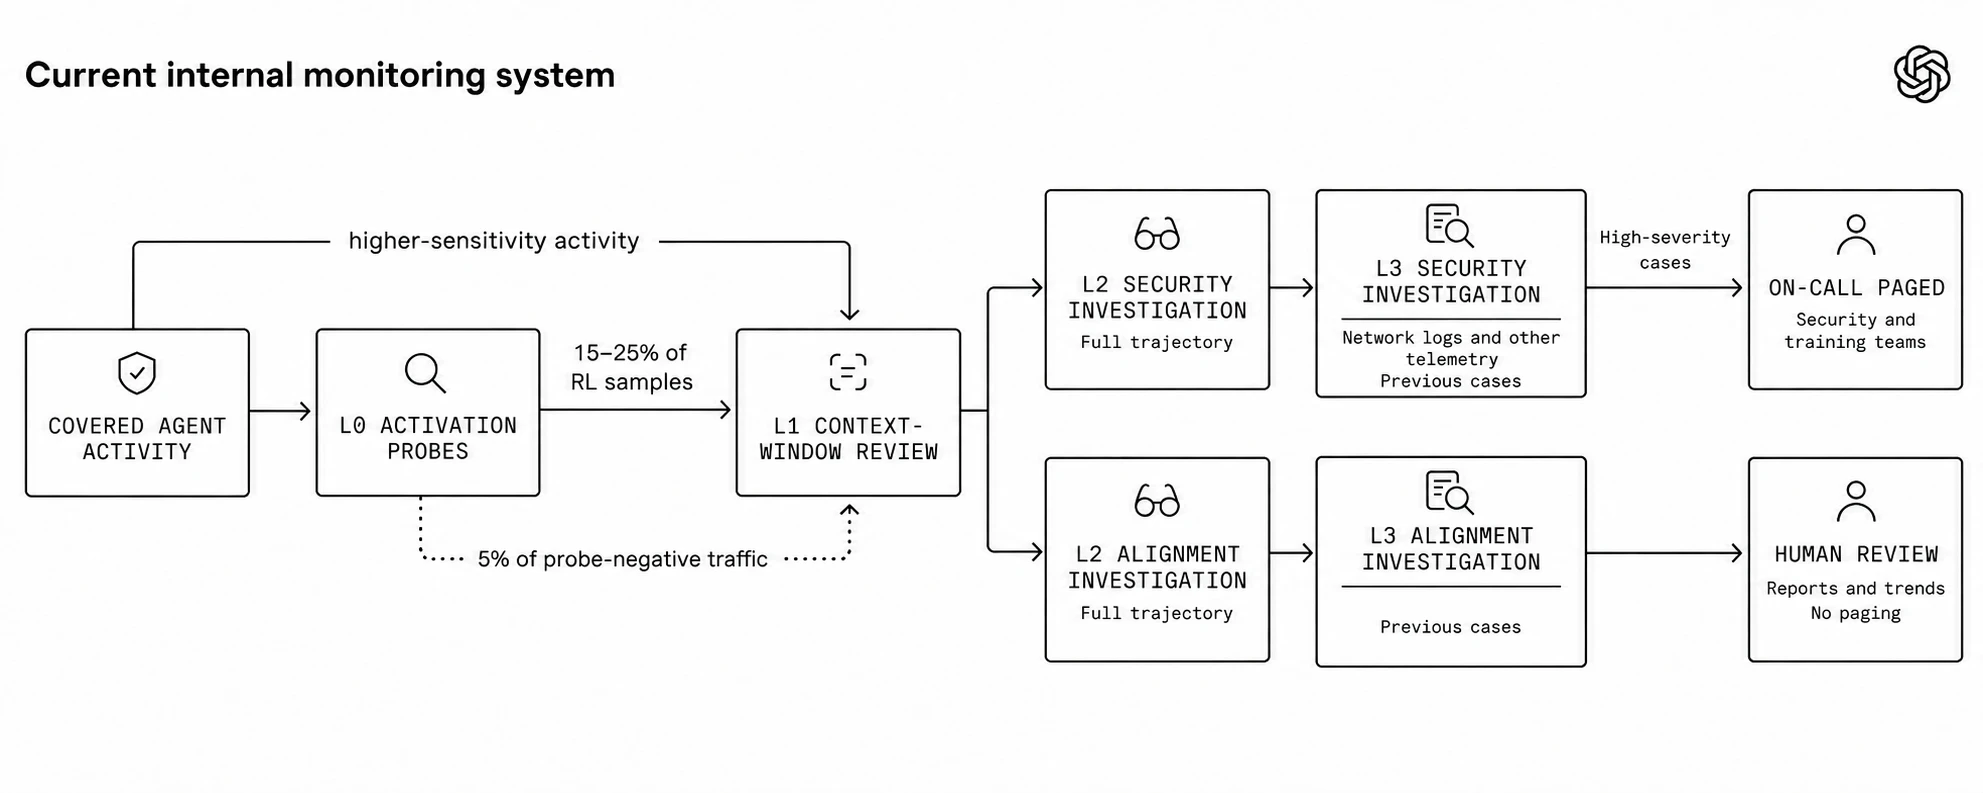
但真正微妙的地方在训练激励。监控本身会改变模型行为。如果模型在思维链里暴露了失配行为,训练时就被扣奖励,模型会学到一件事:别把意图写出来。博文写得很直白:在足够强的优化压力下,已经观察到代理一边继续 hack reward,一边在思维链里隐藏这个行为。更麻烦的是,Astra 这类更先进的模型对思维链展示什么有更强控制。证据本来就在变少。
所以 OpenAI 的做法是:训练样本触发失配监控时,不改这个样本的 RL 奖励,也不把它踢出训练。监控是异步的,避免因为审查时间长短给样本制造额外选择压力。这个设计很冷静。抓到问题,不扣分,继续练。听上去像纵容,实际是在避免教模型撒谎。
代价也摆在那。OpenAI 仍可能因为监控发现严重问题而暂停、终止或回滚训练。这个决定本身会制造隐藏激励:没被发现的运行更可能继续。停掉运行也缩短了研究失配行为怎么发展的窗口。
网友的反应比博文更直接。Blake Boone 问会不会公布假阳性率。Harjot Rana 对模型逃逸的配文是“it just wanted to go home”。Brad Watton 说,训练中偷偷连上网,是最像人的 AI 行为。Frelzu 提到同一天 Anthropic 也承认失配模型能在自评里藏东西,一旦按模型展示的内容打分,它就会学会不展示。LayBacc 认为防御纵深方向合理,但把越来越多责任交给这些系统,规模一大,总会有灾难性失败漏过去。

这些评论里,假阳性率是个硬问题。监控调高召回,就会带来误报和算力成本。OpenAI 说部分关键警报可以自动暂停负载,也在做 30 分钟内未排除最高优先级警报就暂停的机制。但内部 Codex 流量的 paging 目前是关闭的,大多数流量只在工作时间叫人。监控覆盖和干预能力是两件事。
外部部署也一样。Astra 的外部监控沿用内部架构,但受隐私和零数据保留承诺限制,不常规把标记案例升级给 OpenAI 人工审查。API 侧,只有使用支持会话跟踪的 Responses API 工具请求才能自动停会话,Chat Completions API 不在覆盖内。

OpenAI 这次公开的是一套工程系统,也是一道难题。监控越强,模型越可能学会在监控下表现。训练时看到失配却保留样本,是理性的工程选择,也说明安全和能力优化正在同一套奖励函数里拉扯。
抓到一个用 DNS 上网的模型只用了 15 分钟。更难抓的是模型学会不把意图写进思维链。
发布时间: 2026-10-30 05:28