42 万行测试,TanStack DB 把 AI 当测试工程师用
TanStack DB 1.0 RC1 发布。它让后端数据像本地一样用,最值得看的是它怎么用 AI agent 加 oracle 测试,写出了 42 万行新测试。
TanStack DB 1.0 RC1 发布了。
一句话说清楚这东西:它让你在前端像操作本地数据一样操作后端数据。API 返回的记录变成 typed collections,组件里用 live queries 做 join 和过滤,修改立刻生效再同步到服务器。
这听起来像 Meteor 时代的老故事。有人在推文下面问了同样的问题。Tanner Linsley 的回复是:No, you can use Convex and TanStack DB together now。意思是不用换后端,也不用换同步方案。你从现有的 REST API 和 TanStack Query 开始用,需要的时候再加持久化、离线写入、实时同步。查询模型不变,不用重写。
这个增量路径是 TanStack DB 跟其他 local-first 方案最明显区别。大多数方案要求你一开始就换数据库、换同步架构。TanStack DB 的做法是让你先用上,再决定走多远。
1.0 RC1 有什么新的
从 0.6 以来,加了 SSR 和 TanStack Start 深度集成,Neon Realtime 和 Convex 适配器,Preact 是第六个框架适配器。性能更好,包更小,修了一大堆 bug。
生产环境里已经在跑的有:Prisma Studio、Unkey 的开发者仪表盘、Skylight 的 React Native 家庭日历应用(带离线功能)。核心包 @tanstack/db 每周 npm 下载过百万。
42 万行测试是怎么来的
这是 1.0 最值得看的部分。
Kyle Mathews 在发布博客里写了一个细节:他们为 1.0 写了 42 万行新测试。211 个 oracle 测试文件,分布在 15 个包里。
Oracle 是什么?就是一个独立的参考模型。拿排序函数举例,传统单测是输入 [3,1,2] 验证输出 [1,2,3]。属性测试是生成几千个输入验证排序规则。Oracle 更进一步:用另一个简单实现算出正确答案,然后对比正式实现和参考模型的结果。
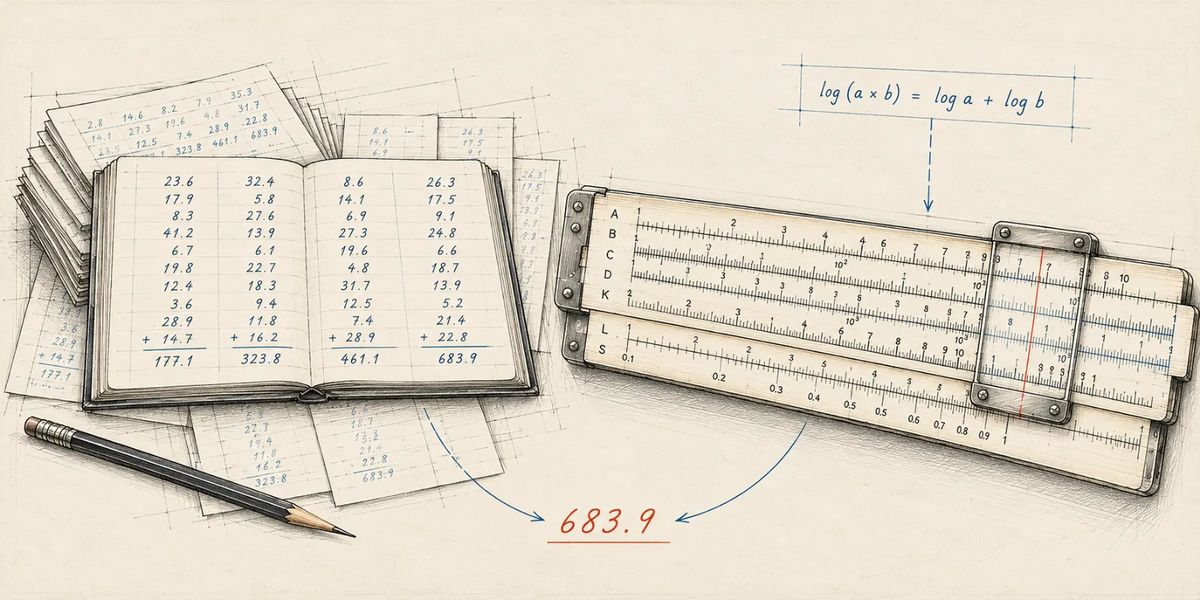
数据库的查询维护比排序复杂得多。一条 live query 要处理插入、更新、删除、批量变更、离线编辑、服务器刷新、乐观更新回滚。手写测试用例根本覆盖不过来。
Kyle 的做法是让 AI agent 对着 oracle 跑生成的历史序列,自动找不一致。一个 agent 会话就能发现好几类新 bug。他甚至说,现在的工作越来越像是阻止 agent 修太多东西,去追那些假想的边界情况。
有一个具体例子。用户报告删除一行然后在同一个事件循环里用同一个 key 重新插入,订阅者收到了 delete 但没收到 insert。直接读能拿到新行,但订阅者的缓存里没有。修这个 bug 的时候加了一个更广的 oracle:订阅者应用所有变更消息后,最终行集必须跟直接读一致。
后来 agent 挑战这个 oracle,故意改消息选择逻辑,发现两种版本都能通过。查下去发现生产代码里有真 bug:订阅者删除行之后,同步提交让同一个 key 重新可见,DB 发了一个 update 而不是 insert。订阅者那边根本没有这行。oracle 的模拟订阅者用 Map.set 同时处理 insert 和 update,把错误吞掉了。加上 insert 要求 key 不存在、update 和 delete 要求 key 存在的规则后,378 个已有用例里有 26 个失败。
这种测试写法比传统单测重得多,但它维护的是设计理解,不是单个答案。
迁移注意
如果你在用 0.9.2 或更早版本,1.0 RC 有不少 breaking changes。$synced 换成了 $hasPendingWrites,事务等待从 isPersisted.promise 换成 when('settled'),Query Collection 的 mutation handler 不再自动 refetch,React hooks 去掉了依赖数组,SSR 需要显式 preloadLiveQuery。迁移指南写得很细,建议对着过一遍。
发布时间: 2026-10-30 05:37