一次生成一串token,速度提升5.7倍,质量还没掉
自回归模型一次前向只吐一个token,延迟随规模变贵。Felix Draxler等人的Parallel Language Models在预训练阶段加入并行解码目标,1.3B模型后训练后在数学、代码、指令遵循上匹配同训练自回归模型,推理快2.3到5.7倍。
自回归语言模型有个默认设定:一次前向只吐一个token。生成一段回答,模型要反复调用自己,延迟随模型规模一起涨。Felix Draxler等16位作者在2026年10月19日提交的论文里提出Parallel Language Models,简称PLM,想让模型在一次前向里生成一串互相一致的token。推文里写,This will change how LLMs be trained。
推文视频把生成过程放慢60倍:蓝色token由一次PLM调用一起提出,绿色token被验证器接受,灰色token是自回归模型还要继续走的步数。
方法上,PLM把并行文本生成看成变分自编码器。推理时,并行解码器把一组随机辅助变量映射成一段连贯序列,一次调用完成。辅助变量承载token之间的依赖。训练时,PLM配一个自回归编码器,把每个训练token映射到能解码回它的辅助变量。最大化数据似然的ELBO,最后化简成标准自回归损失加并行重建损失。编码器和解码器共享全部Transformer权重,只有输入嵌入不同。
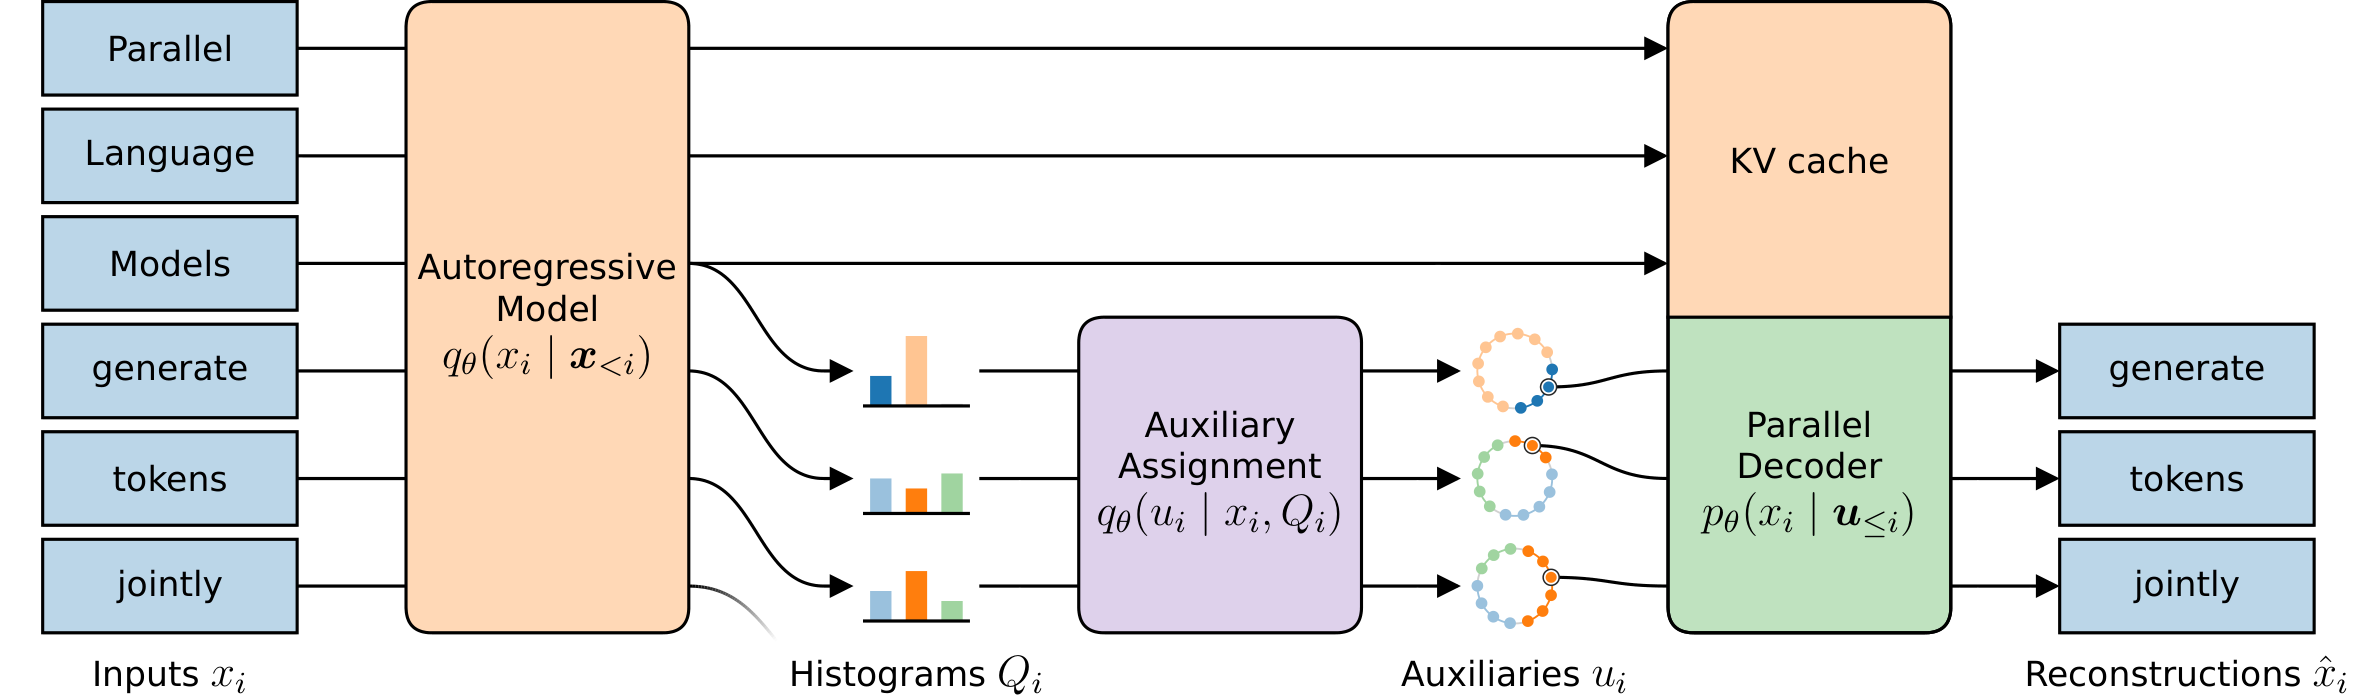
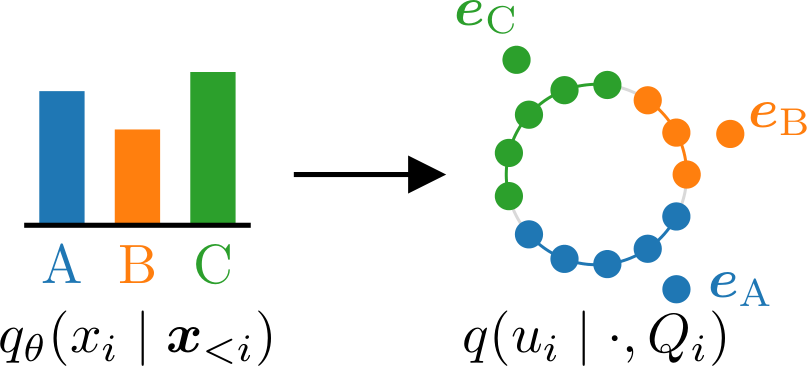
辅助变量是嵌入空间里一组固定的单位向量。每个辅助变量分配给最相似的token嵌入,并带一个每token偏置,让属于某个token的辅助变量份额等于自回归编码器下该token的概率。项目页把它叫加权Voronoi划分。这个设计利用了token嵌入之间的相似性。
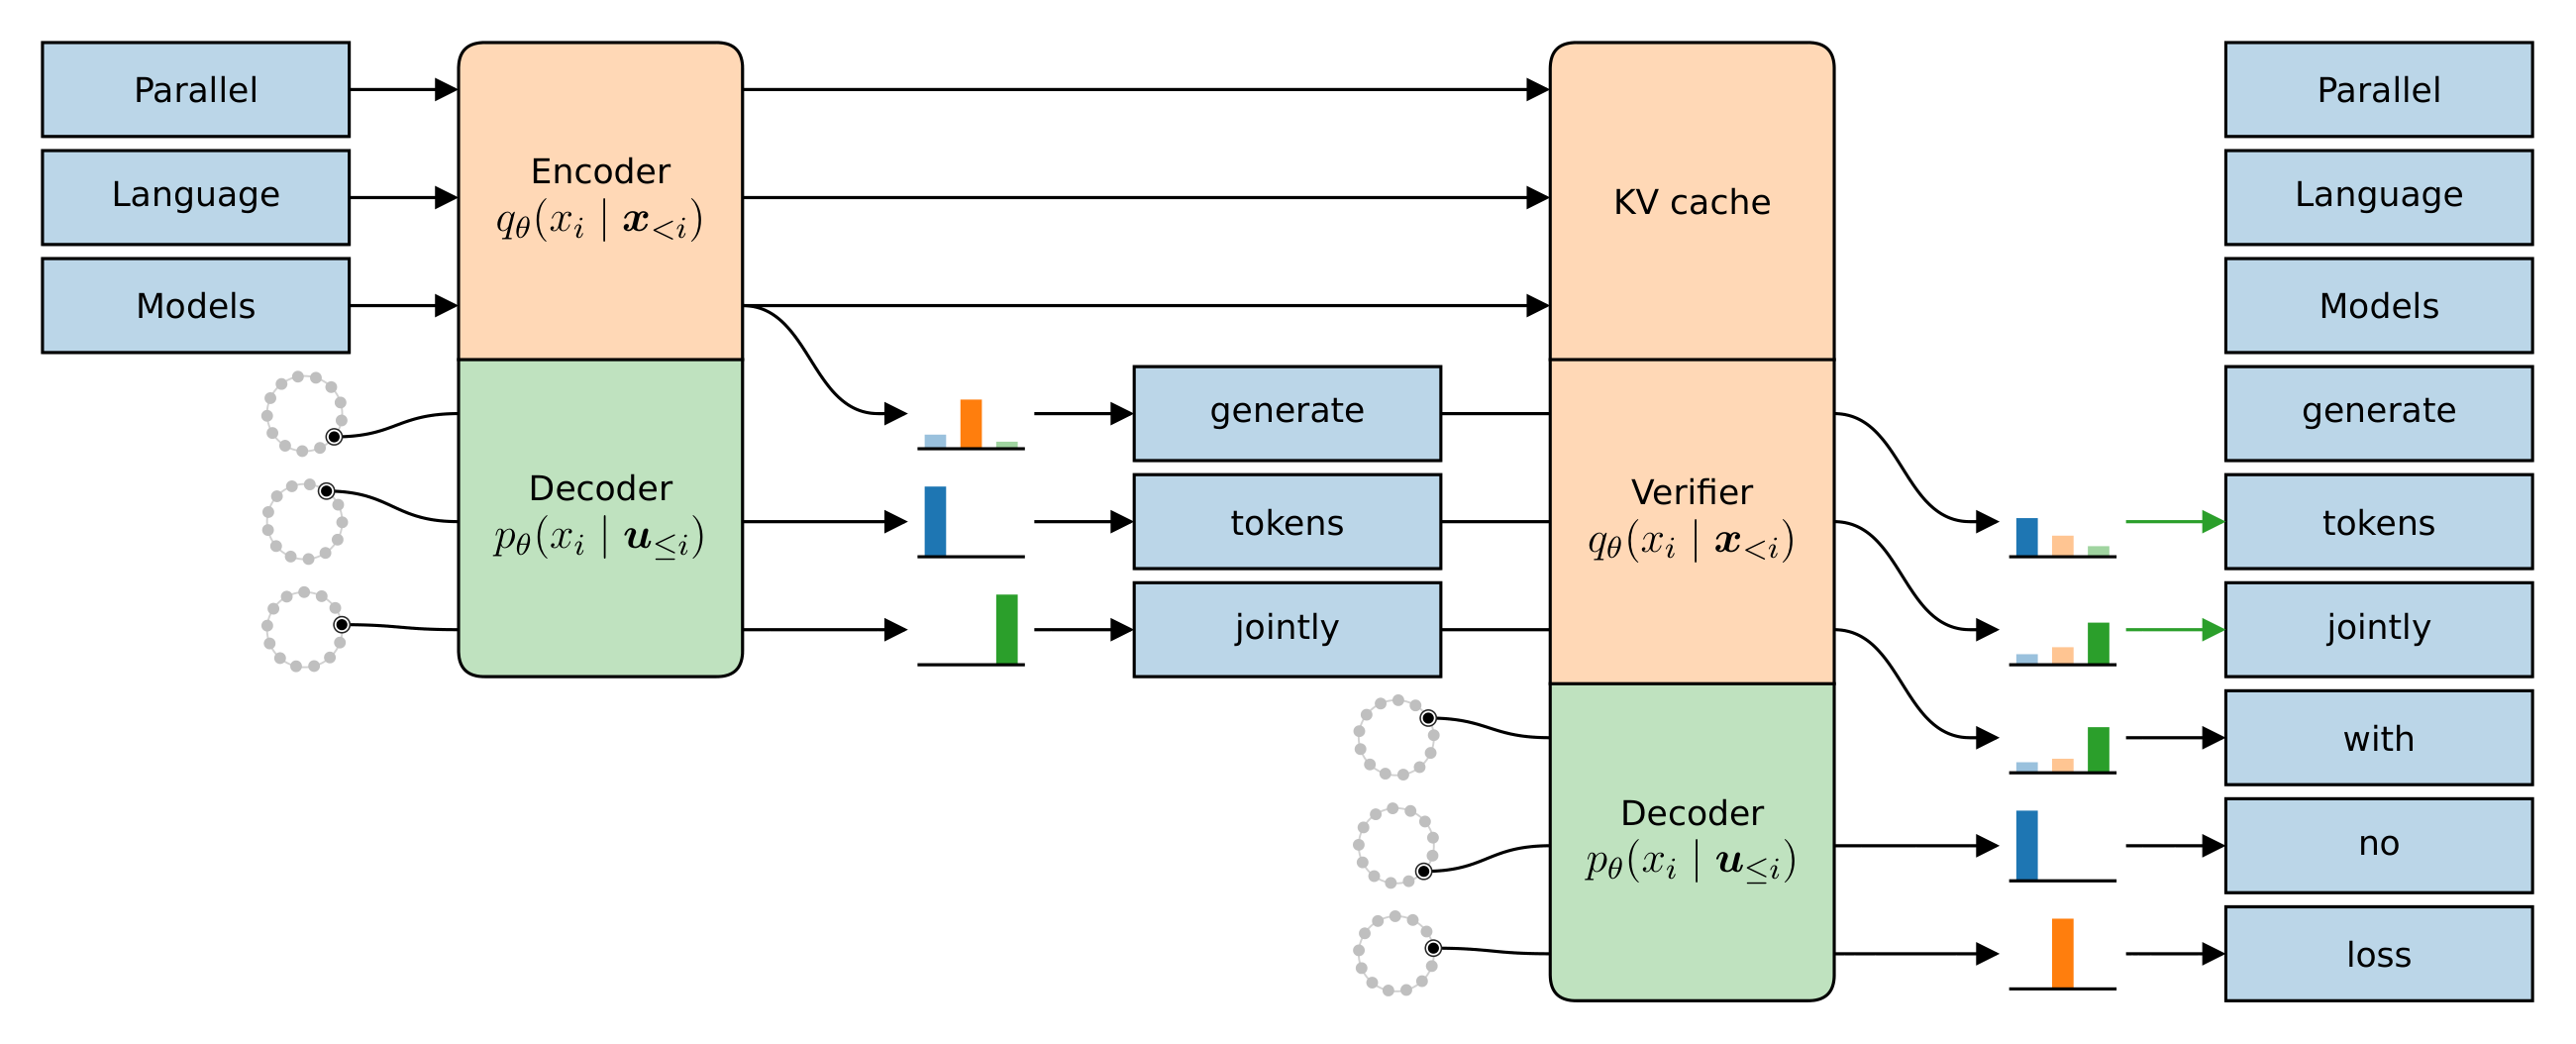
推理时,随机抽辅助变量喂给解码器,解码器一次提议一个token块。下一次调用里,编码器验证这些提议,解码器同时提议下一块,两件事在一次前向里完成,项目页说这是适配Quadratic Decoding。除了精确验证,他们用放松接受规则,保留编码器下概率足够高的提议token。在可比质量下,平均多接受46.5%的token。
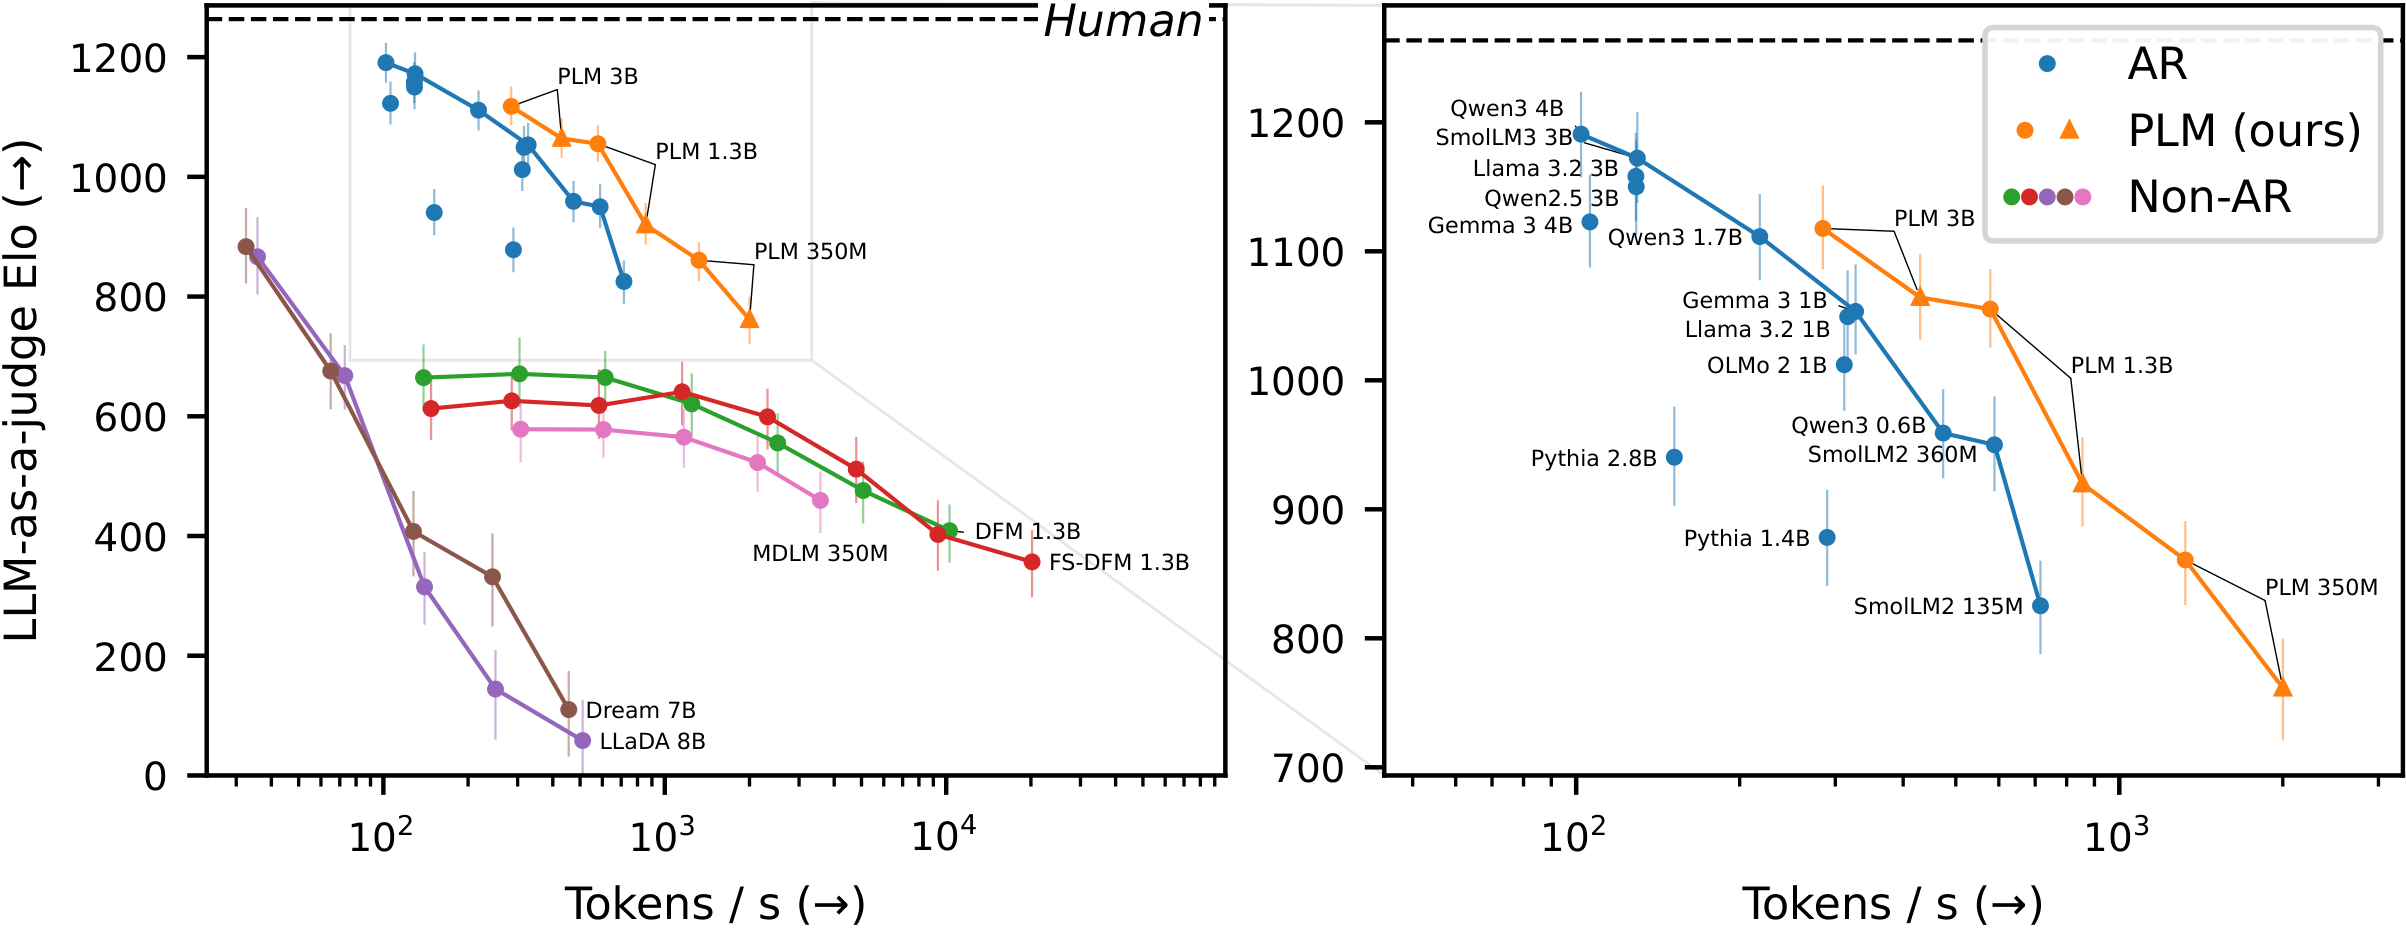
结果:预训练阶段,80M到3B参数上,PLM接近自回归预训练损失,加速随模型规模呈幂律。预训练后,PLM在文本续写上比同推理速度的自回归模型更好,训练token量只有25B到300B,而对比模型用了数万亿token;也优于测试的离散扩散模型,包括少步模型。后训练用SFT和DPO后,1.3B PLM在数学、代码、指令遵循基准上匹配或超过同后训练自回归模型,推理快2.3到5.7倍。3B模型质量更高。规模越大,正确重构的token量增长也呈幂律,模型更并行。β控制质量与并行的权衡。
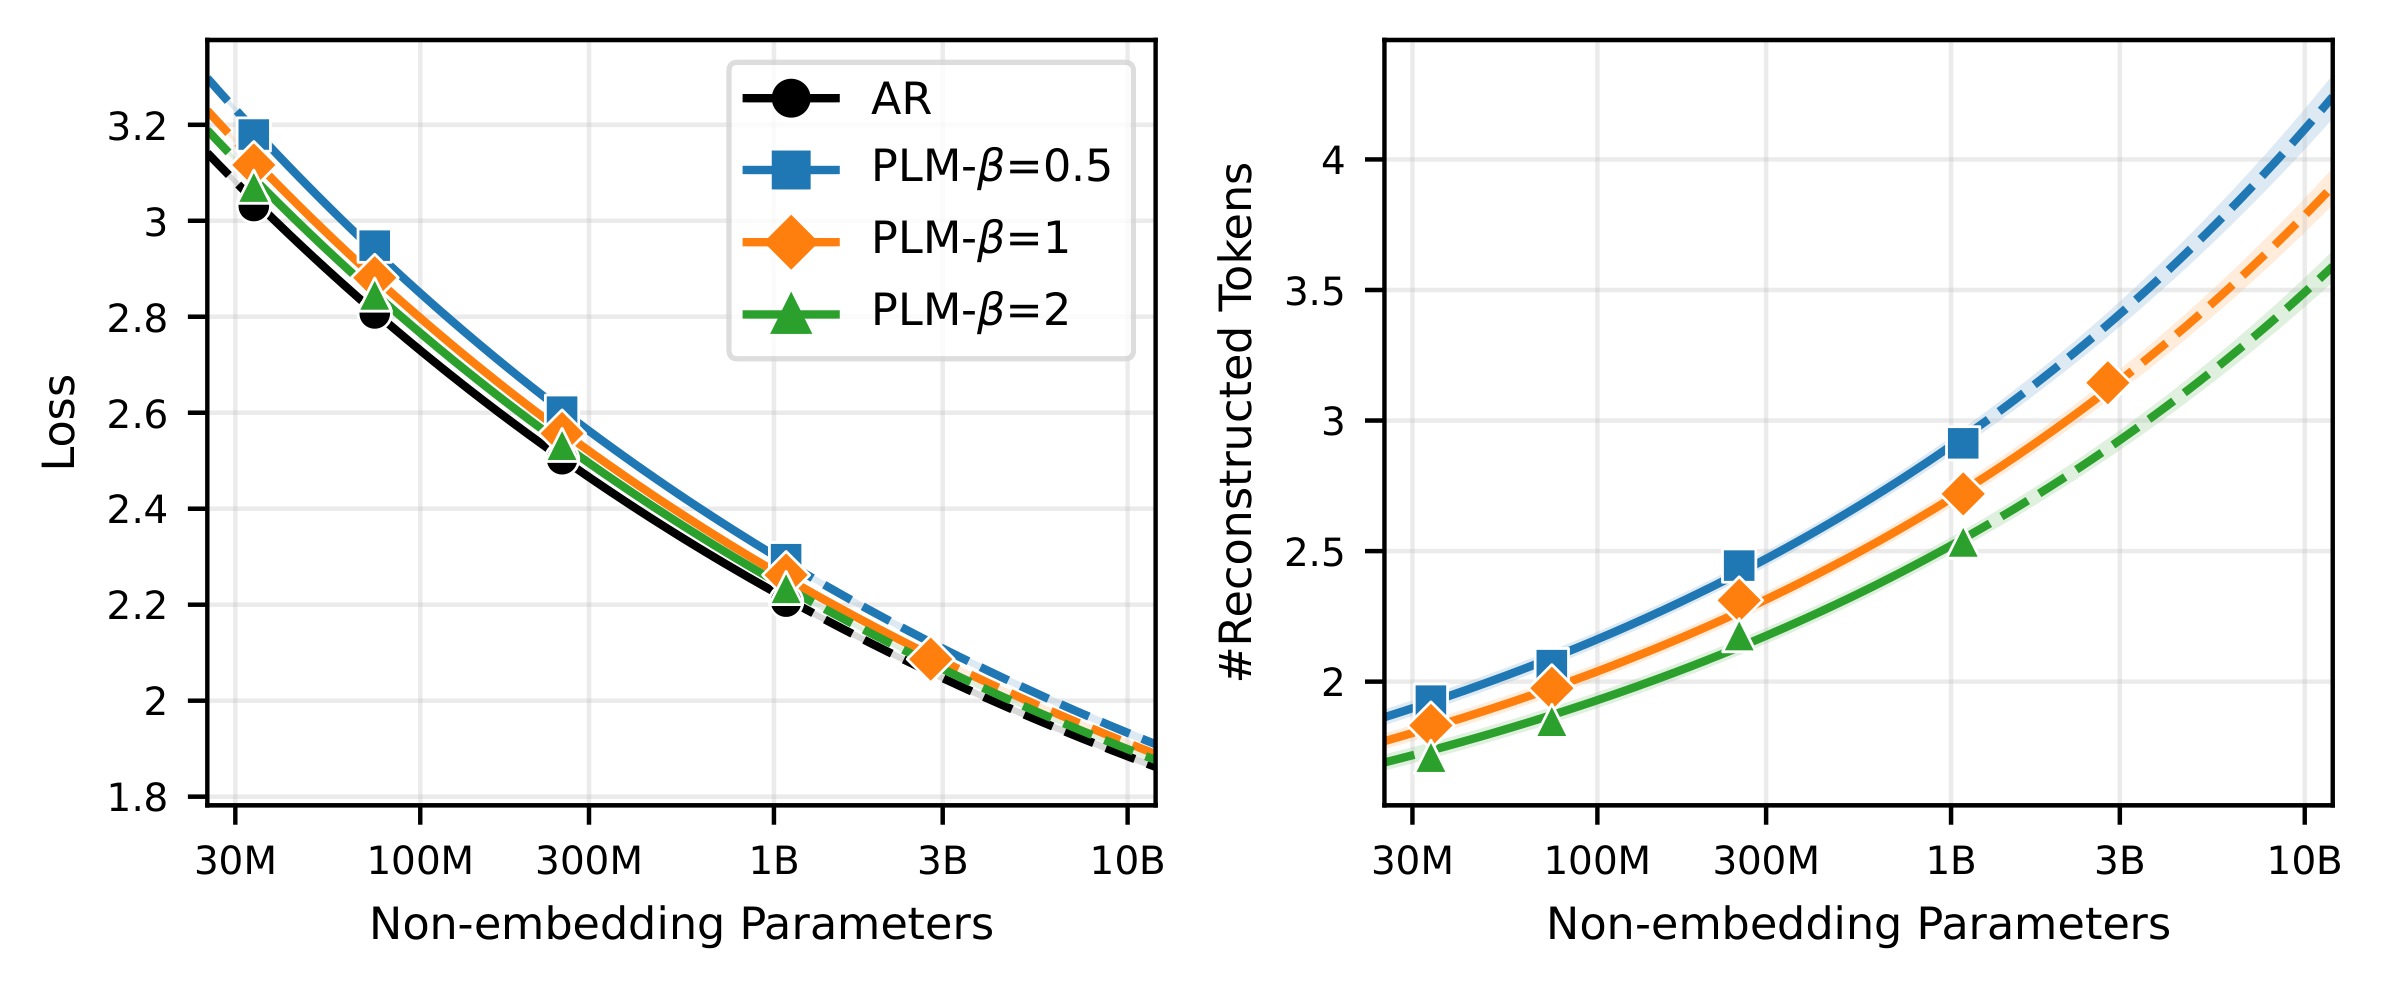
判断:并行生成常被拿来说延迟,但不少方案在质量上退让。PLM值得看的地方在于,并行解码损失进了预训练目标,验证和提议还能同一次前向完成。它没有绕开自回归,编码器仍然在训练里承担自回归损失。代价是训练目标更复杂,辅助变量分配和接受规则都要调。代码已放在GitHub。对做推理服务的人,5.7倍是直接诱惑;对做预训练的人,更关键的问题是,规模变大后并行度按幂律涨,这条曲线能不能继续。
论文:https://arxiv.org/abs/2610.26693
发布时间: 2026-10-30 08:29