0.8B 的 OCR 模型拿了第一,小米自己说理解比解析难
小米开源 Xiaomi-OCR-0,0.8B 参数,Real5-OmniDocBench 95.24 排第一,五个 OCR VQA 平均 83.2 超过 Qwen3.5-2B。权重、推理代码、MCP 服务、Agent Skill 全部开放。技术报告里有个反常识的结论:解析已经卷到接近饱和,理解才是真正吃参数的部分。
小米在 10 月 30 日开源了 Xiaomi-OCR-0,一个 0.8B 参数的文档理解模型。权重、推理代码、交互 demo、MCP 服务、Agent Skill 一起放了出来,Apache-2.0 许可。
它的卖点不是又一个 OCR,是把文档解析、关键信息抽取(KIE)、OCR 视觉问答(VQA)塞进同一个轻量模型。对需要本地跑的 agent 来说,这一点比单纯的榜单分数更实际。
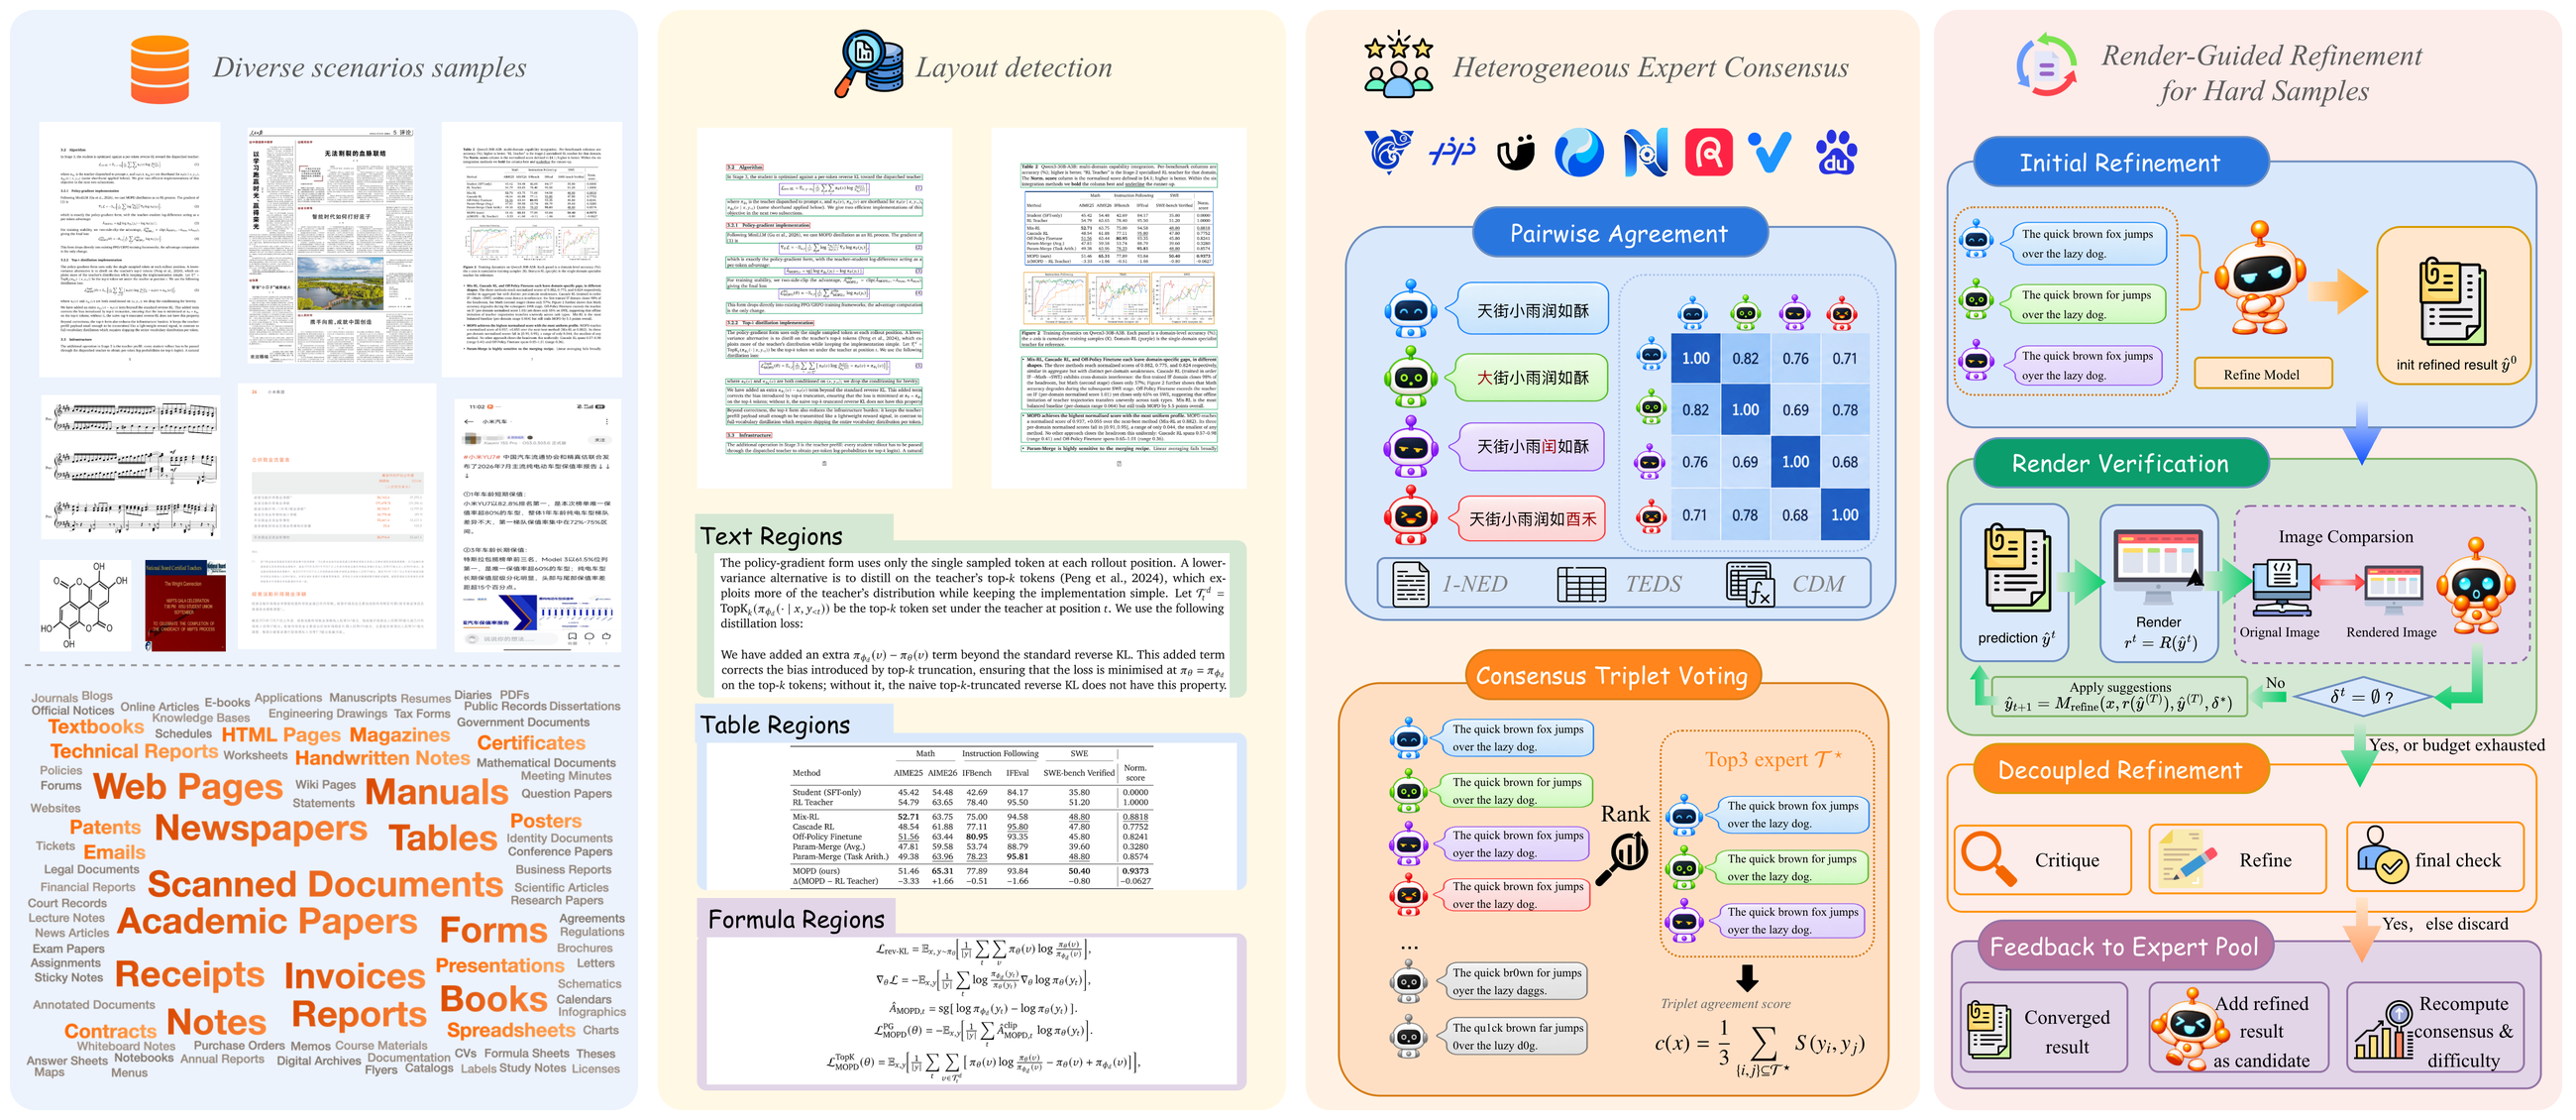
底座是 Qwen3.5-0.8B-Base,训练语料约 1.7 亿样本,流程分三步:Q-Mask 文本锚定做细粒度文本和位置对齐,OCR-centric 继续预训练铺开多任务能力,再用混合任务强化学习(Mix-RL)在难样本上用可验证奖励往上推。
指标
- Real5-OmniDocBench 95.24,排第一
- OmniDocBench v1.6 96.83,第二,仅次于 1.2B 的 TeleOCR 的 96.87
- Wild-OmniDocBench 87.94,第二
- UniMER-Test 公式识别 97.84
- PubTabNet 表格识别 92.27 TEDS
- 五个 OCR 视觉问答平均 83.2,超过 Qwen3.5-2B 的 80.9
- 历代手写和书法 Chronicles-OCR 73 分,和 Seed 2.0 Pro 的 72 分打平
文档解析这一项里,0.8B 的身位比较清楚。OvisOCR2 同尺寸 96.58,PaddleOCR-VL-1.6 0.9B 96.33,GLM-OCR 0.9B 95.22。小米在 Real5 上拉开了更明显的差距。
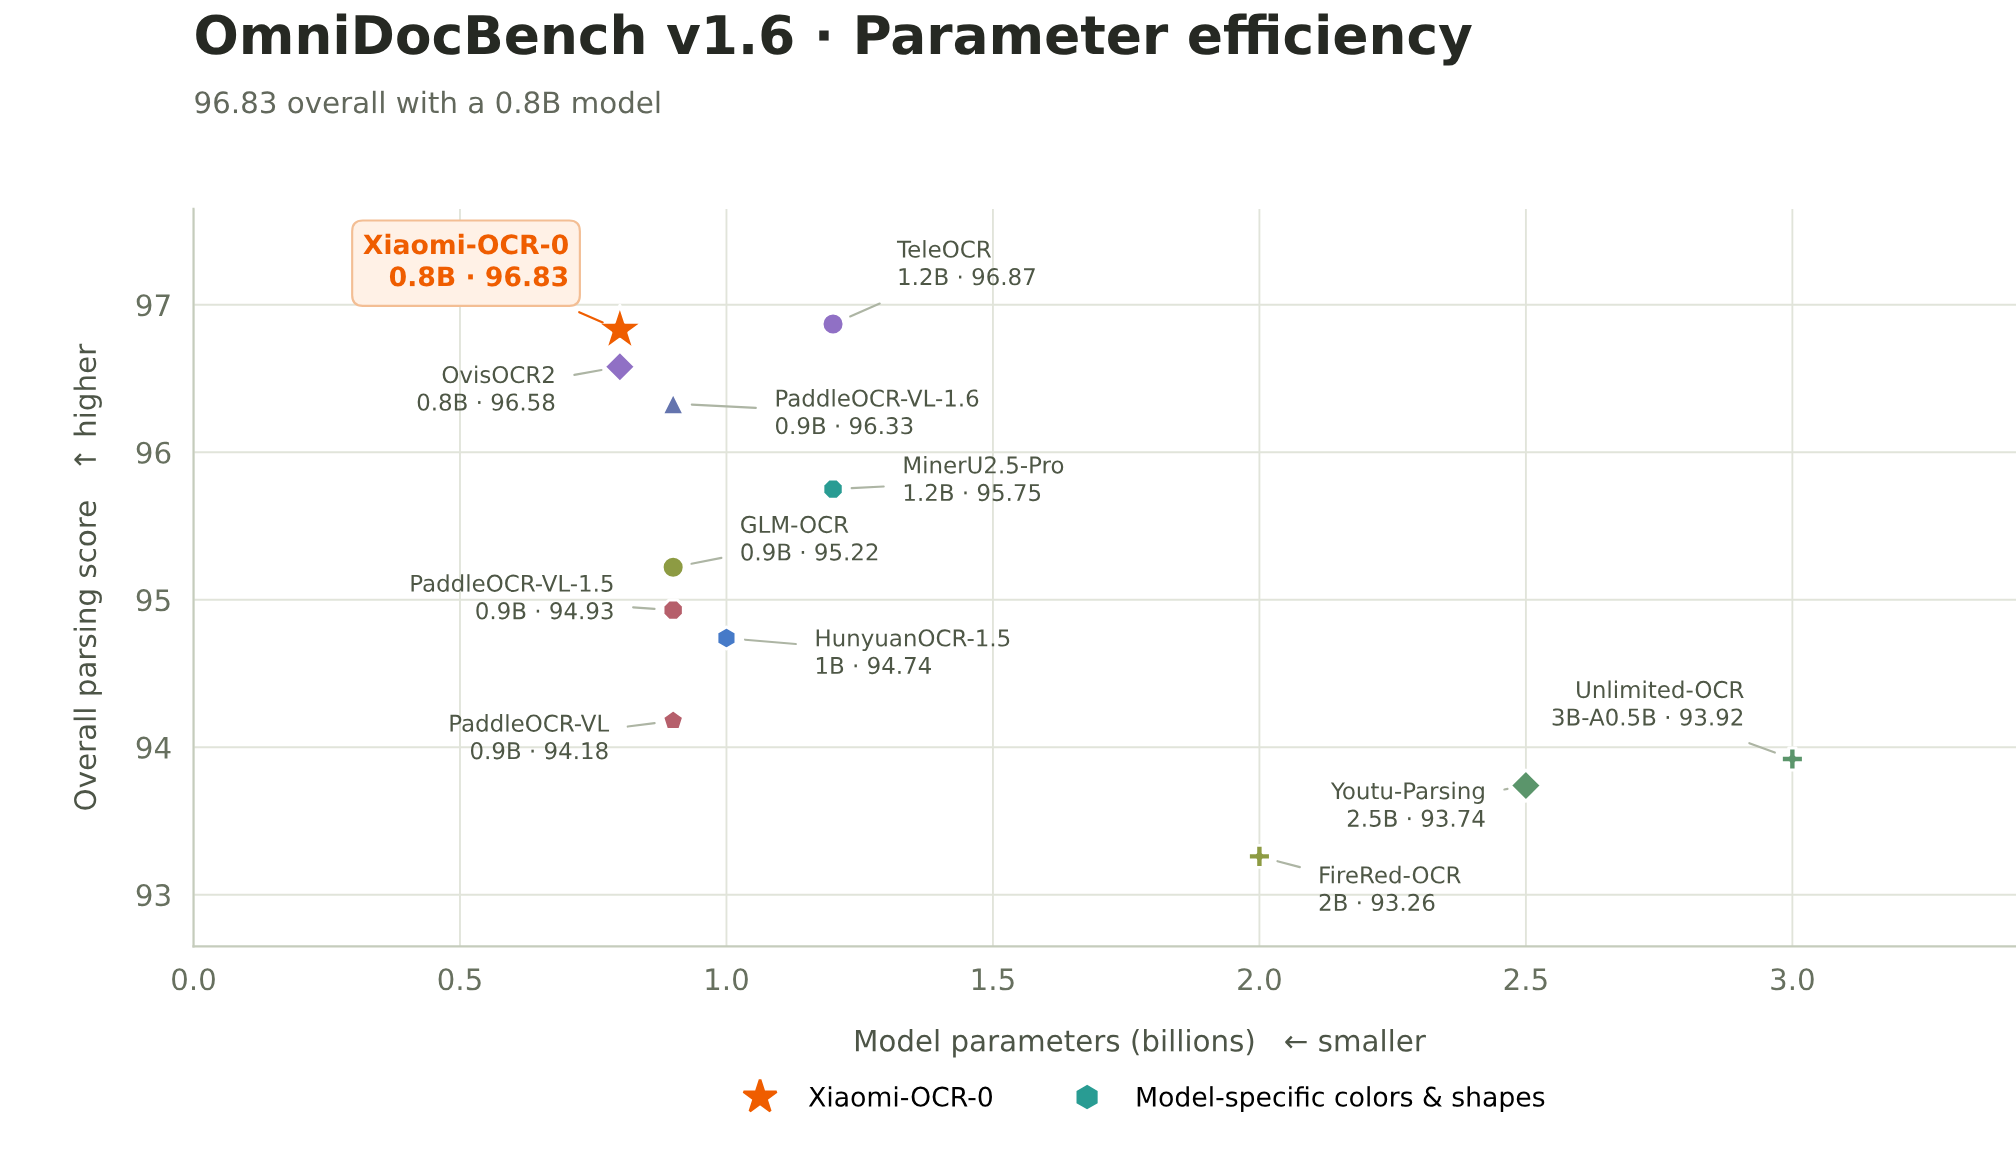
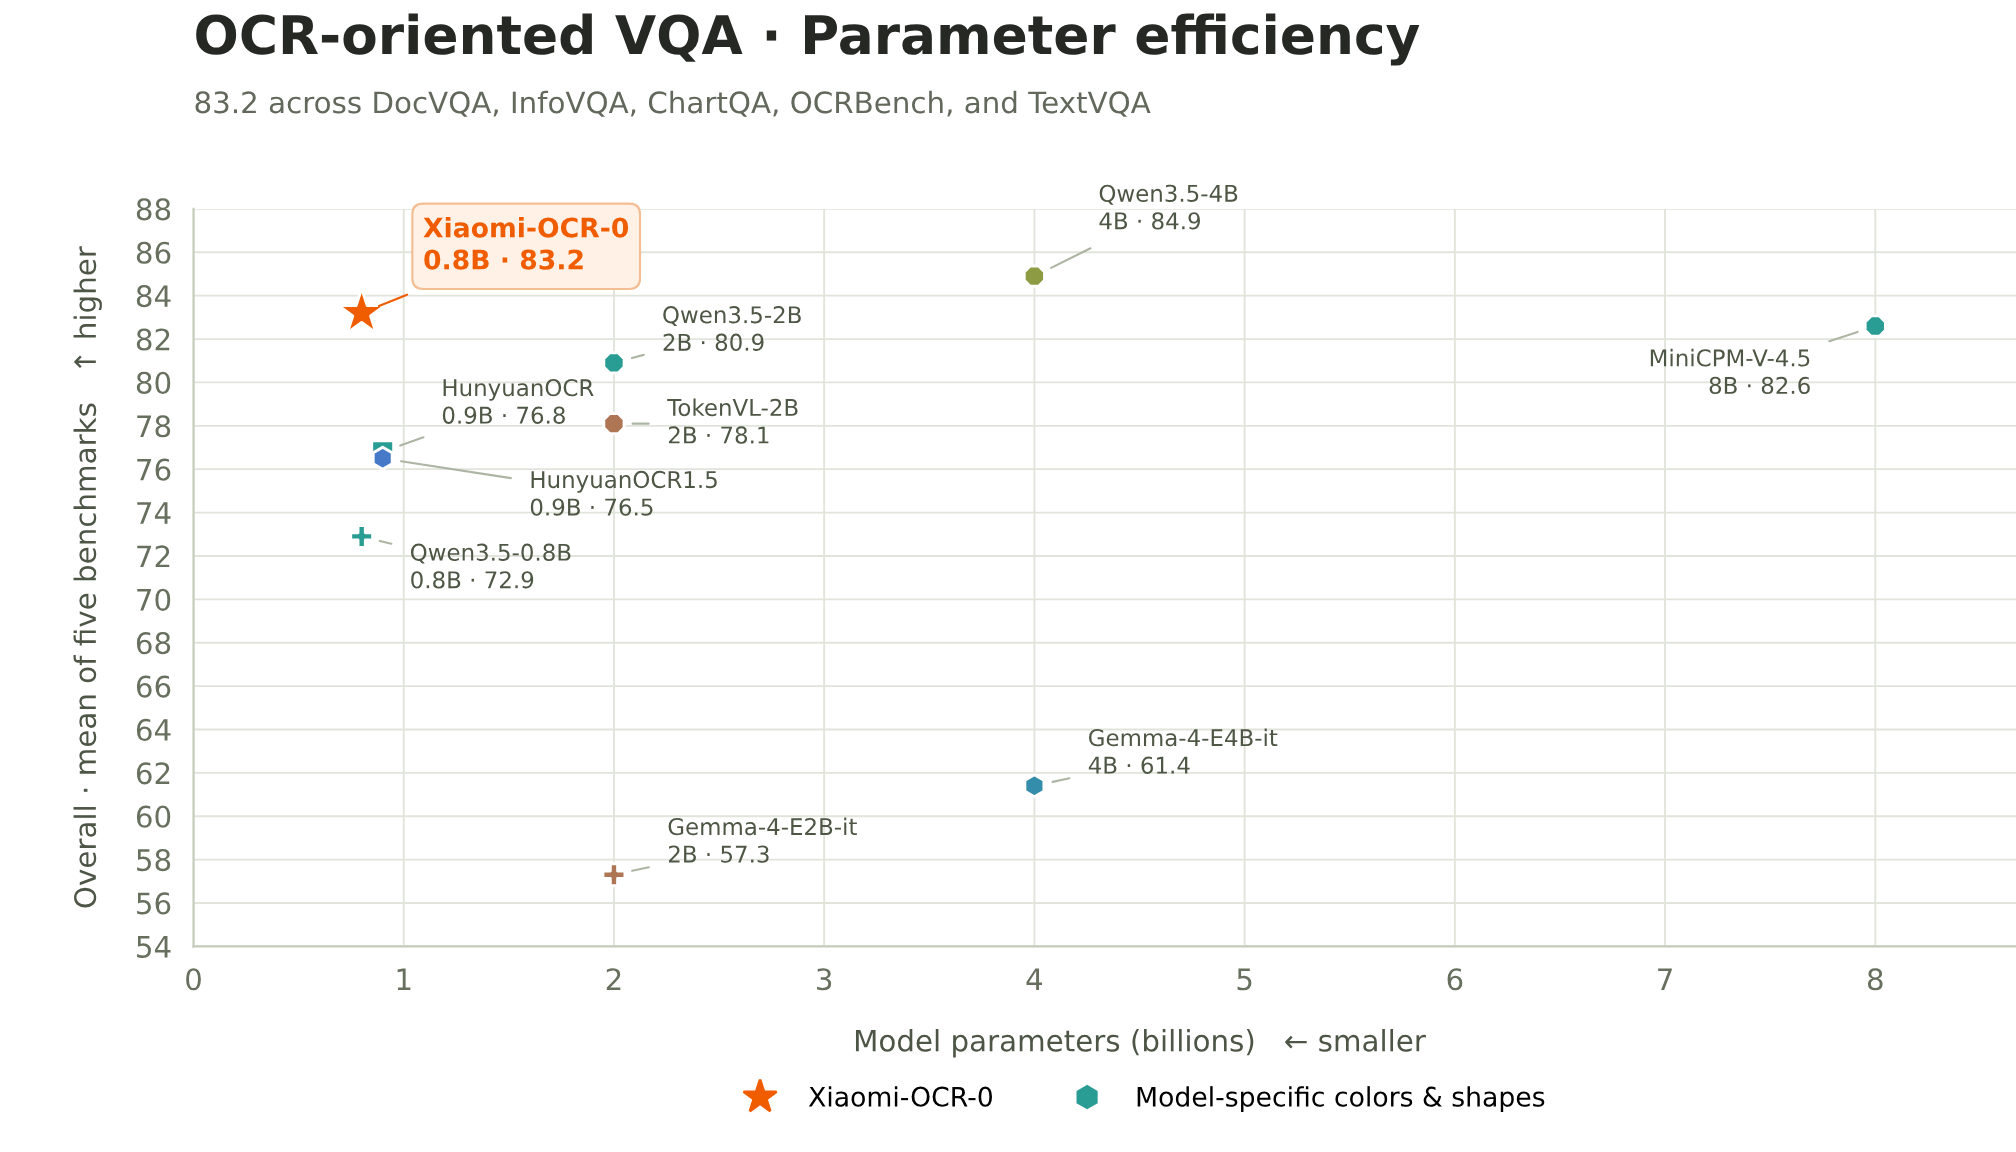
技术报告里更值得看的三个结论
榜单之外,技术报告放了几个训练观察,反而比分数有意思。
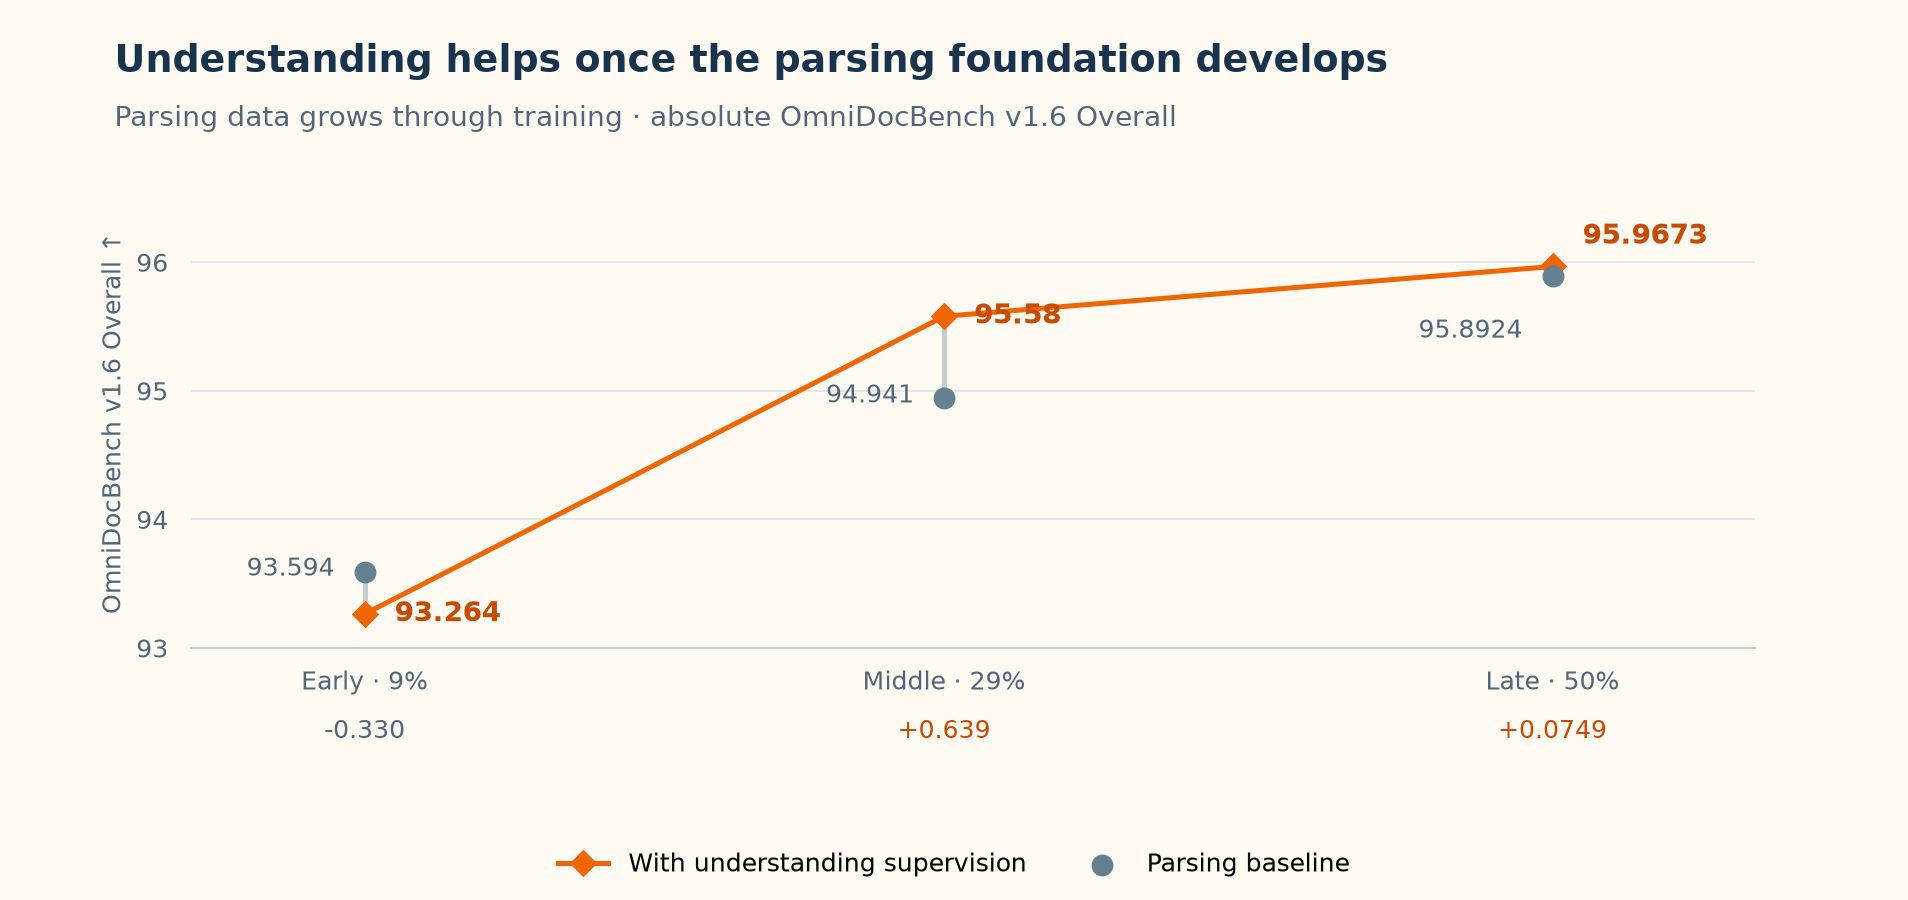
第一,解析能力强到一定程度之后,加理解数据能反哺解析。 早期阶段的增益是 -0.330,中期是 +0.639,到了更强的后期基线还有 +0.0749。三个阶段分别用了 9%、29%、50% 的解析数据,每个增益都是对应当阶段解析 baseline 测的。
第二,理解比解析难得多,也更吃参数。 从 0.8B 拉到 4B,理解任务涨了约 4.9 分(88.1 对 83.2),解析只涨了约 0.15 分(96.9745 对 96.8277)。同样走 CPT 对齐数据,教师和学生各自专精一个领域。理解这一侧的提升空间还很明显,解析这边接近饱和。
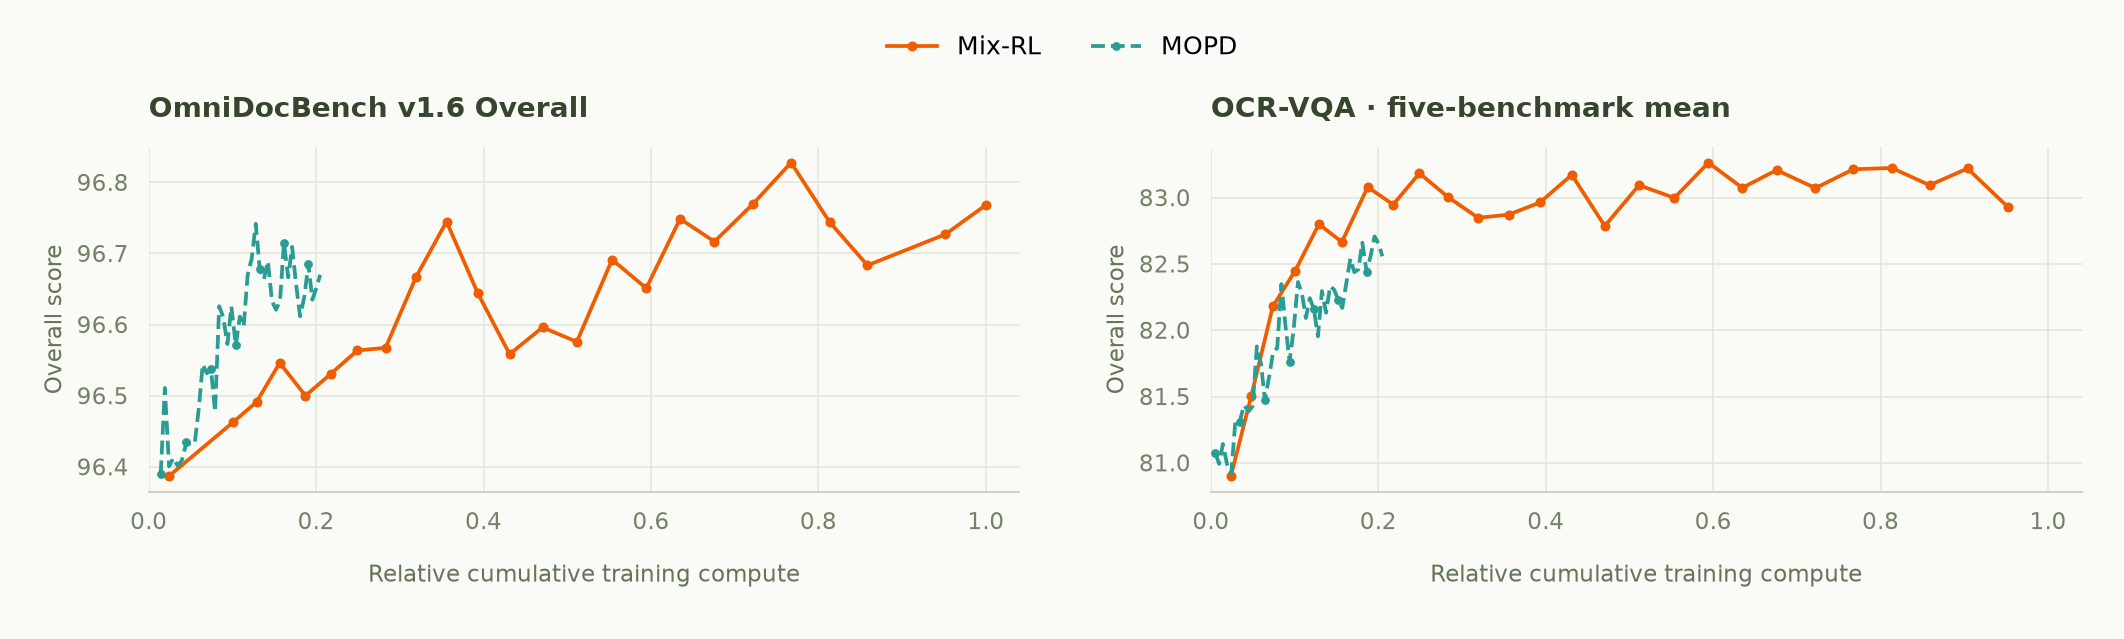
第三,训练策略的取舍。 MOPD(一个解析教师加一个理解教师)收敛快,但 Mix-RL 训得更久,峰值更高。
数据侧的做法也写清楚了。一个异构专家池生成候选标注,池里包括 PaddleOCR-VL-1.6、MinerU2.5-Pro、GLM-OCR、dots.mocr、HunyuanOCR-1.5、TeleOCR、OvisOCR2、Qianfan-OCR。用 Ensemble Triplet Consensus 按池内一致性排序,挑出三专家共识子集,不确定的样本送回去重做。专家意见不一致时,把候选标注渲染回图像,和源区域对照,专门抓表格和公式的结构错误。
实际能干什么
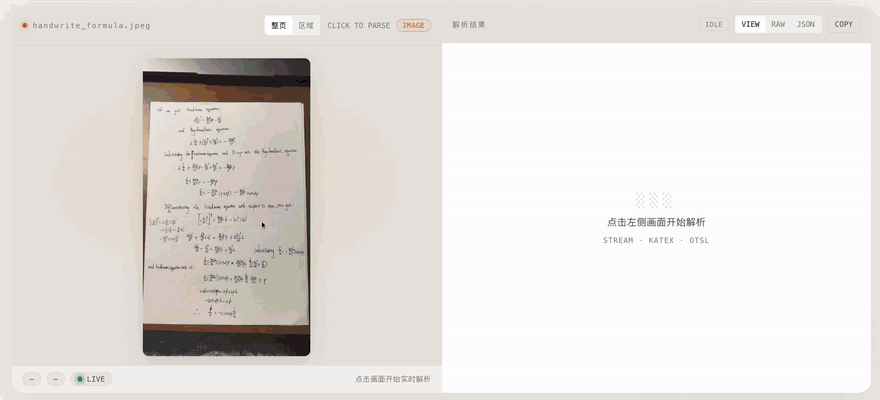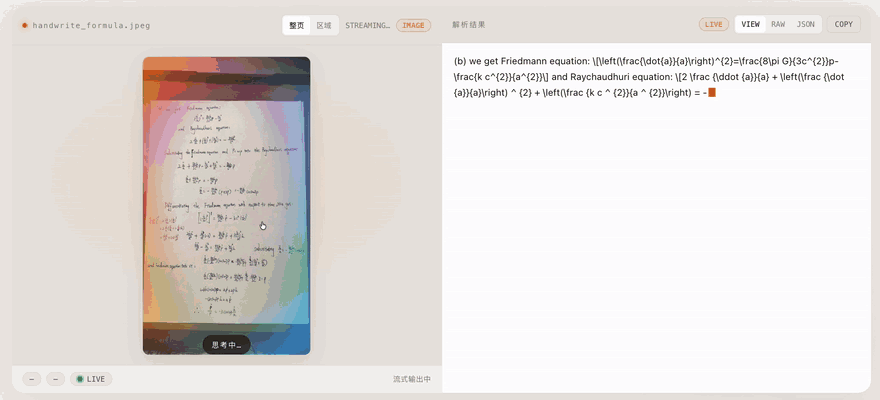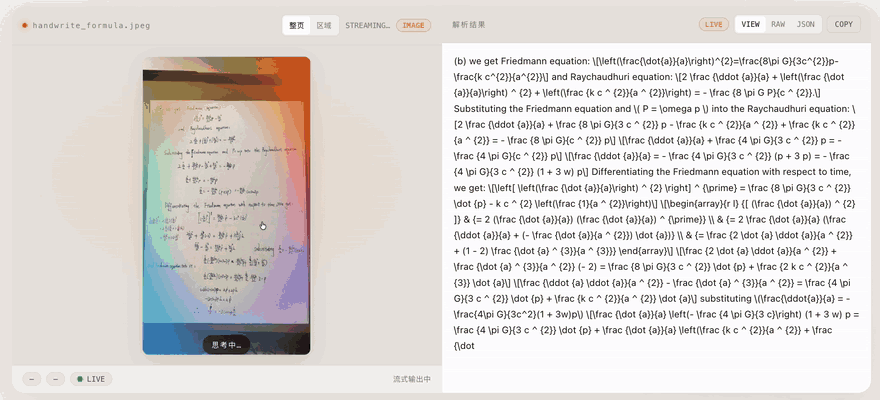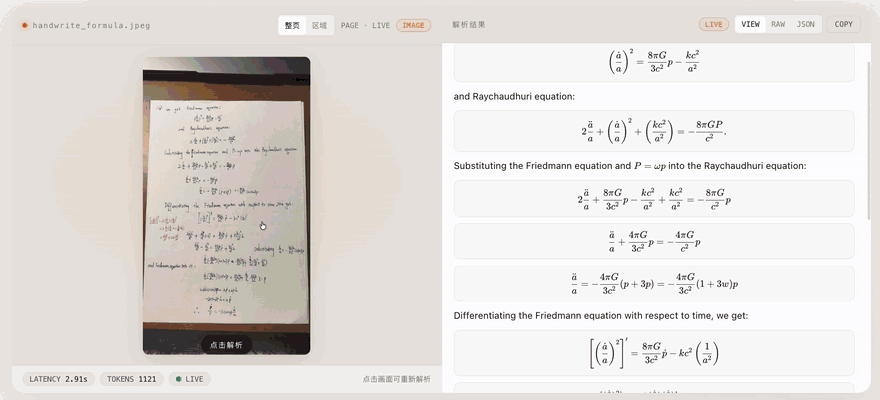
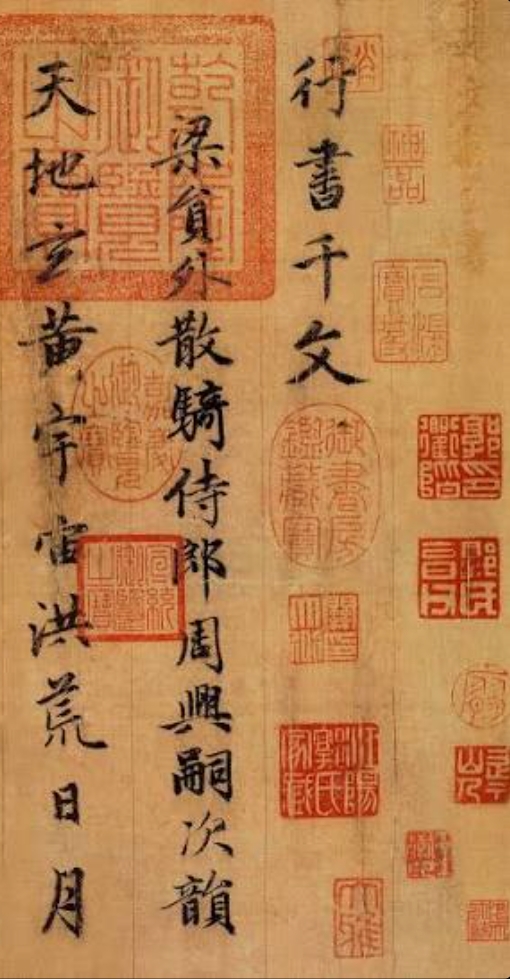
官方给了几段样例。稠密数学页整页解析,输出 Markdown,表格转 OTSL,公式用 LaTeX,按阅读顺序组织。手写推导也能转 LaTeX。行书《千字文》能读出「行书千文 梁貟外散騎侍郎周興嗣次韻 天地玄黄宇宙洪荒日月」。
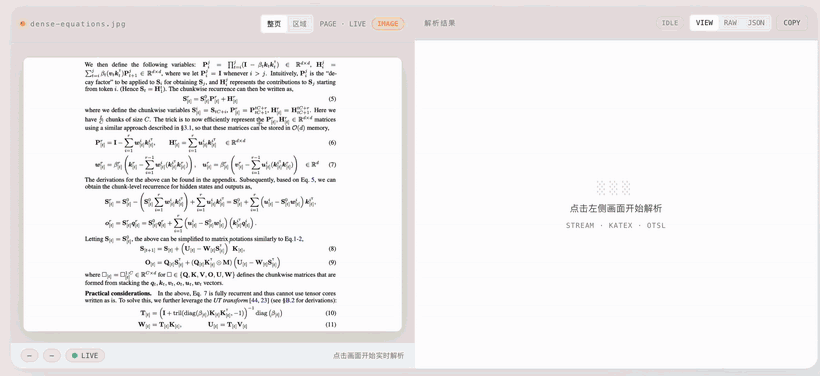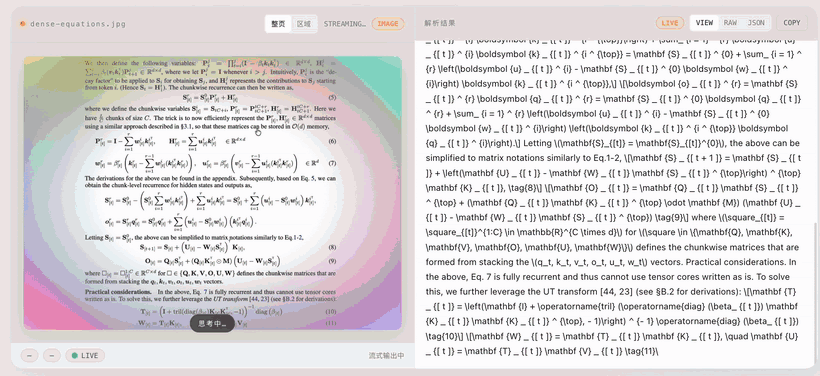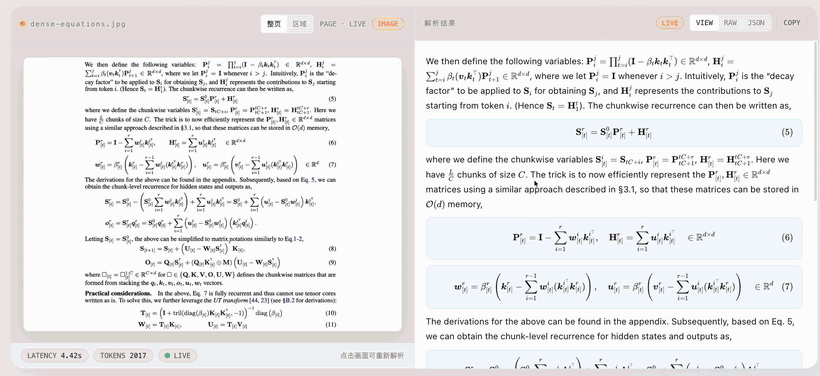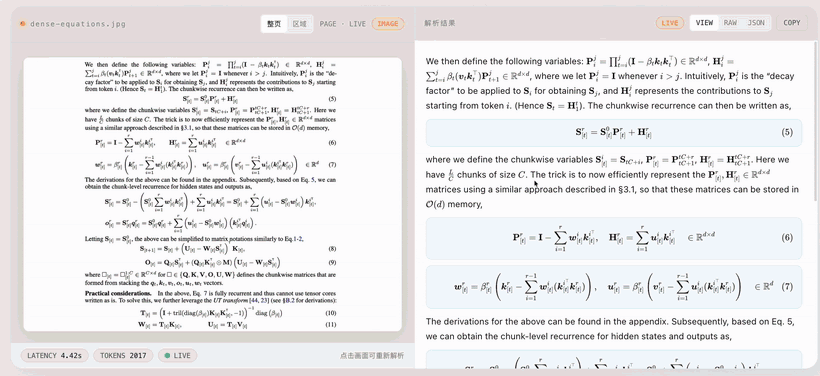
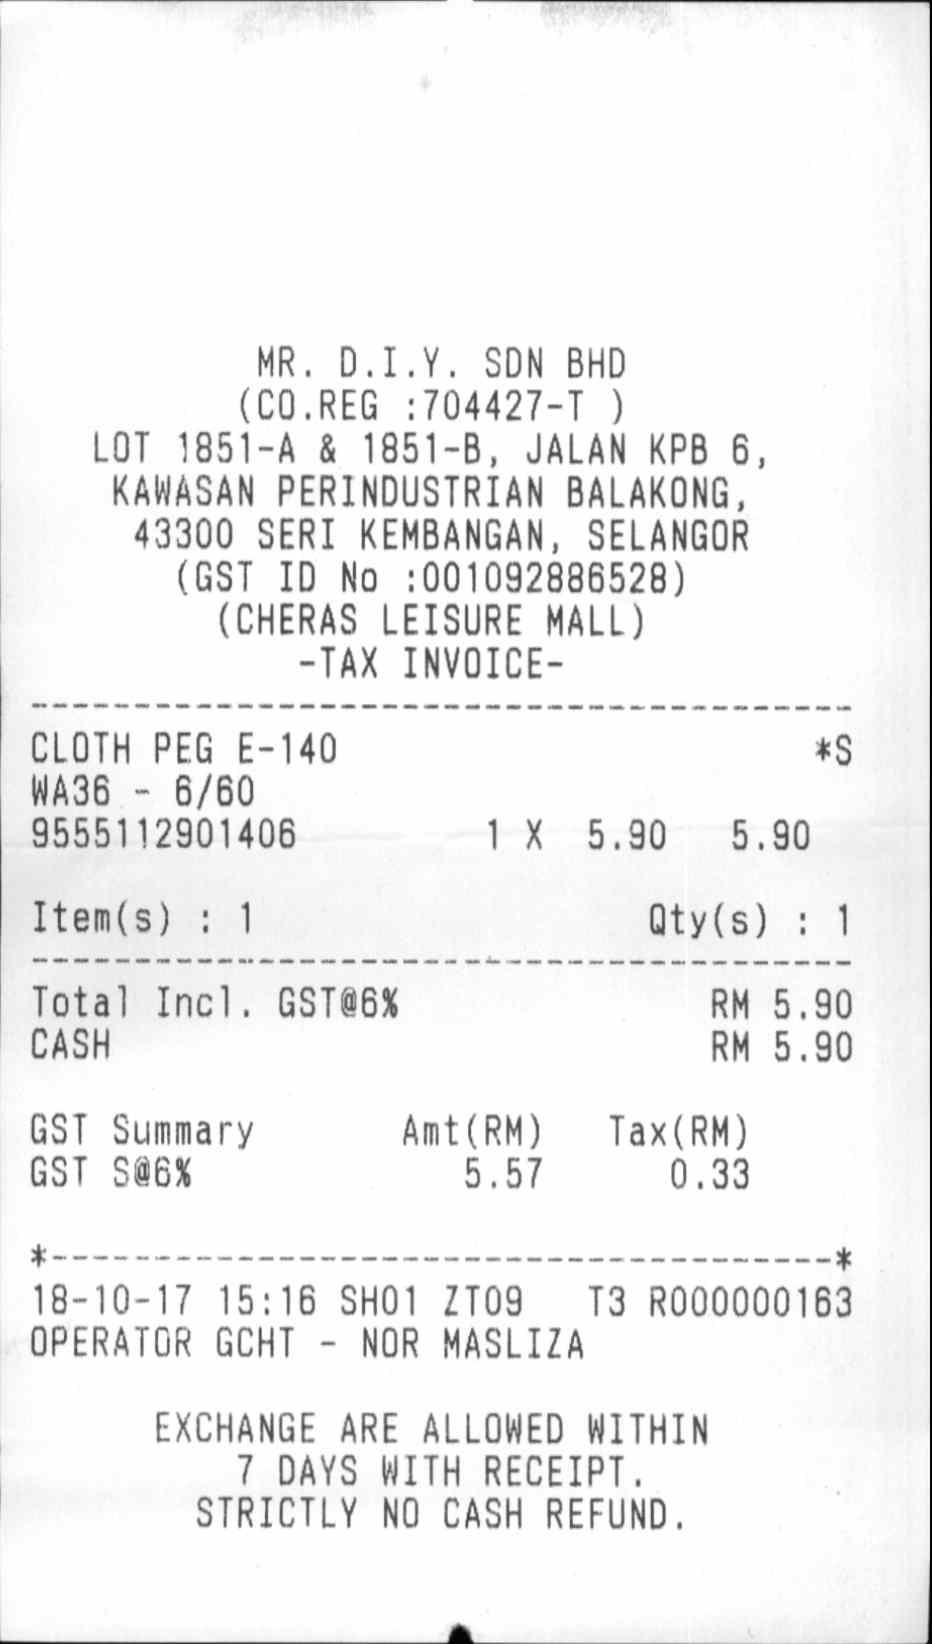
KIE 走 JSON schema。给它一张马来西亚收据,指定 date、seller_address、seller_gst_id、seller_name、total_amount、total_tax 六个字段,能直接吐出结构化 JSON。
怎么跑
最省事的路径是把 SKILL.md 丢给 agent,让它自己装环境、拉权重、配推理运行时、注册 MCP。SGLang、vLLM、Ollama 三选一。
Ollama 那条是社区贡献的 BF16 GGUF 包,约 1.8 GB,Mac 上也能跑:
ollama pull longwayxu/xiaomi-ocr-0:bf16
但注意,光 pull 不够。图像预处理、非思考 prompt、解码参数这些步骤要靠仓库里的 MCP 服务或浏览器 demo 自动套上,单独拉模型不配置这些,结果会和官方对齐检查不一致。
手动装的话是 Python 3.10 以上,克隆仓库后起 SGLang 或 vLLM 服务,再跑 demo:
git clone https://github.com/SeerRay-Lab/Xiaomi-OCR-0.git
cd Xiaomi-OCR-0
python -m sglang.launch_server --model-path SeerRay-Lab/Xiaomi-OCR-0 \
  --host 127.0.0.1 --port 8000 --context-length 16384
另一个终端起前端,开 http://127.0.0.1:8787,支持中英文、整页和区域解析、KIE、VQA、PDF 解析。区域解析要额外装 PaddlePaddle、PaddleX 和 PP-DocLayoutV3。
资源都在这里:
- 模型权重:https://huggingface.co/xiaomi-research/Xiaomi-OCR-0
- GitHub:https://github.com/xiaomi-research/Xiaomi-OCR-0
- 在线 demo:https://huggingface.co/spaces/loongwayX/Xiaomi-OCR-0-demo
- 技术报告:https://arxiv.org/abs/2609.36136
一些冷水
发布推文下面的回复比官方文案更有信息量。
有网友说报纸识别不行,删除线也处理不了。这不是个别现象,整页解析和区域解析在复杂版面上的取舍本来就难。官方自己也写了,场景文字、手写、书法、古籍、不规则版面建议走整页解析,因为区域切分一旦切错,上下文就丢了。
还有人贴了张截图,说等了一小时还没出结果。

HF Space 只有一个 A100 实例,排队和冷启动都算在里面。要稳定用,还是本地跑。
另一个实际问题是语言覆盖。官方 demo 有中英文,但模型卡和报告没有把支持语种列清楚。有网友直接在推文里问,暂时没看到明确答复。
值不值得看
如果你在做 RAG 前置的文档处理、票据抽取、扫描件结构化,0.8B 这个体量意味着它能跑在很多原来跑不动视觉语言模型的机器上。MCP 服务和 Agent Skill 一起开源,说明小米瞄准的是 agent 工作流这个场景,不只是刷榜。
但解析分数接近饱和这个事也提醒一件事:OCR 这条赛道,把字认对已经不算核心竞争力了。谁能理解版面背后的结构,谁能在问答里用上这些结构,才是下一步的差异点。
技术报告里那句「理解需要更多参数,也更难」,比 95.24 这个数字更值得记住。
发布时间: 2026-10-31 06:37