模型权重里塞进一台 RISC-V 电脑,内存是它自己的 DeltaNet 层
Qwenputer 在 Qwen3.5-4B 的权重里编译进 11 层 RISC-V CPU,用 Gated DeltaNet 状态当内存,能在前向传播里跑 C 和 MicroPython。基准接近外挂 Python 工具,模型卡还给出文件系统和约 90% 的改变事实回忆率。
Divyansh Agrawal(X 账号 @divagr1925)放出了 Qwenputer:一个把 32 位 RISC-V CPU 编译进 Qwen3.5-4B 权重里的实验模型。CPU 占 11 个 transformer 层,插在 Qwen 自己的 32 层前面;这些层的权重不靠训练,由编译器算出来。模型用自己的 Gated DeltaNet 状态当 RAM,能在前向传播里跑 C 和 MicroPython,不依赖外部运行时。
模型卡写得很直接:它没有走插件、工具或沙箱那条路。CPU 是 RV32IM + Zba + bignum 协处理器的组合,能通过官方 riscv-tests。模型结构仍是 stock Qwen3_5ForCausalLM,只改 config。隐藏维度从 Qwen 的 2560 扩到 3968,词表加入 230,324 个 trace token。Hugging Face 页面标 9B 参数,bf16 下 18.8GB,大部分是零填充,计算机部分约 100 万非零权重。作者说在 bf16 下是精确的。
关键在 Gated DeltaNet。Qwen3.5 每 4 层里有 3 层用 Gated DeltaNet,作者把这些层变成 RAM:用 one-hot key 选中地址并覆盖一行,再用 one-hot query 读回来。gate 和 write strength 设成 1 时,单行可精确覆盖和读回,状态大小固定,聊天变长也不膨胀。CPU 的寄存器、内存和程序计数器就放在 DeltaNet heads 里。
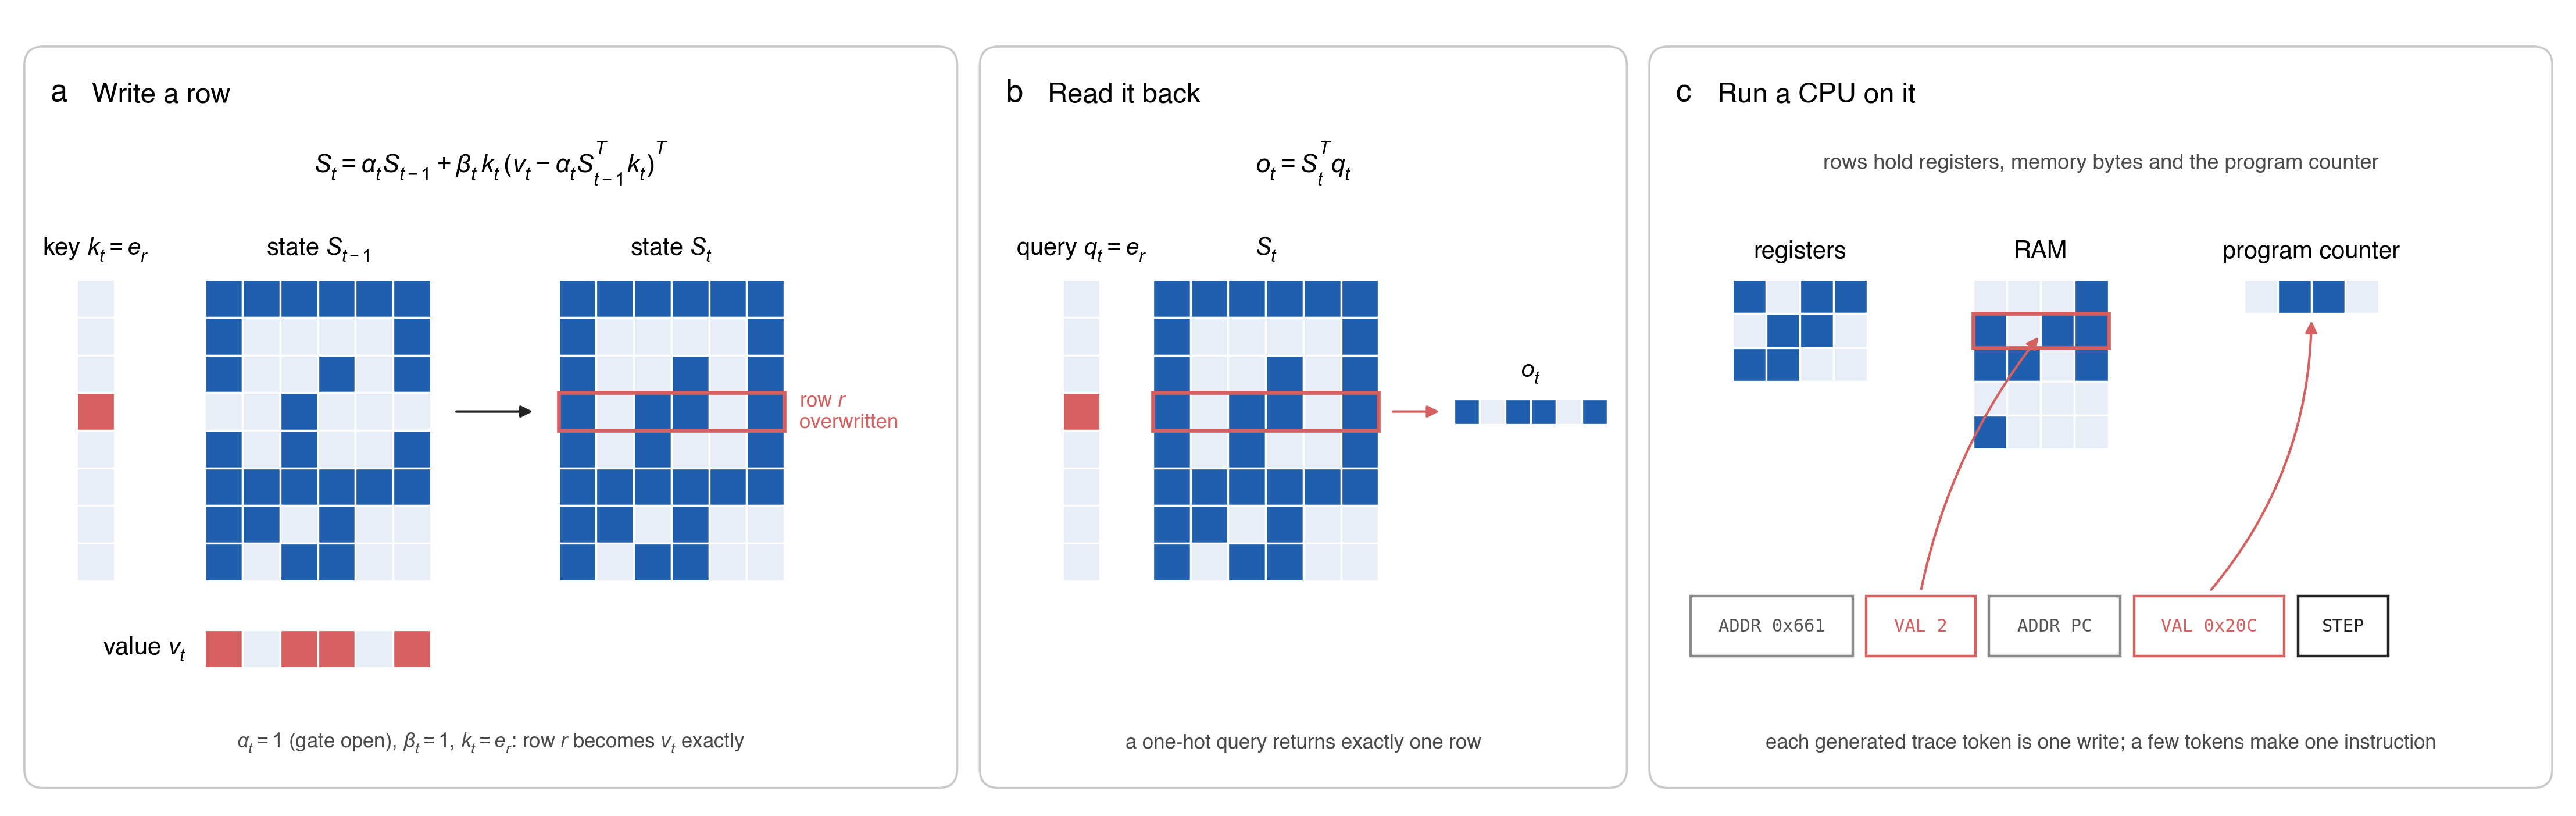
运行方式也绕开了常见工具调用。Qwen 像平时调用工具一样写一个 <tool_call> 块给 calc,但模型外部没有执行器接手。计算机层读取这个调用,在 RISC-V CPU 上跑,模型自己逐位写出 <tool_response>。作者在 L4 上用 Triton executor 跑到约 3,200 trace tokens 每秒。每个 token 仍来自权重。
文件系统也塞进 GDN 状态。聊天后保存状态,下一次加载,文件还在。作者给的数据是,改变事实后的回忆约 90%,把旧聊天重新粘贴进上下文的做法约 30%。
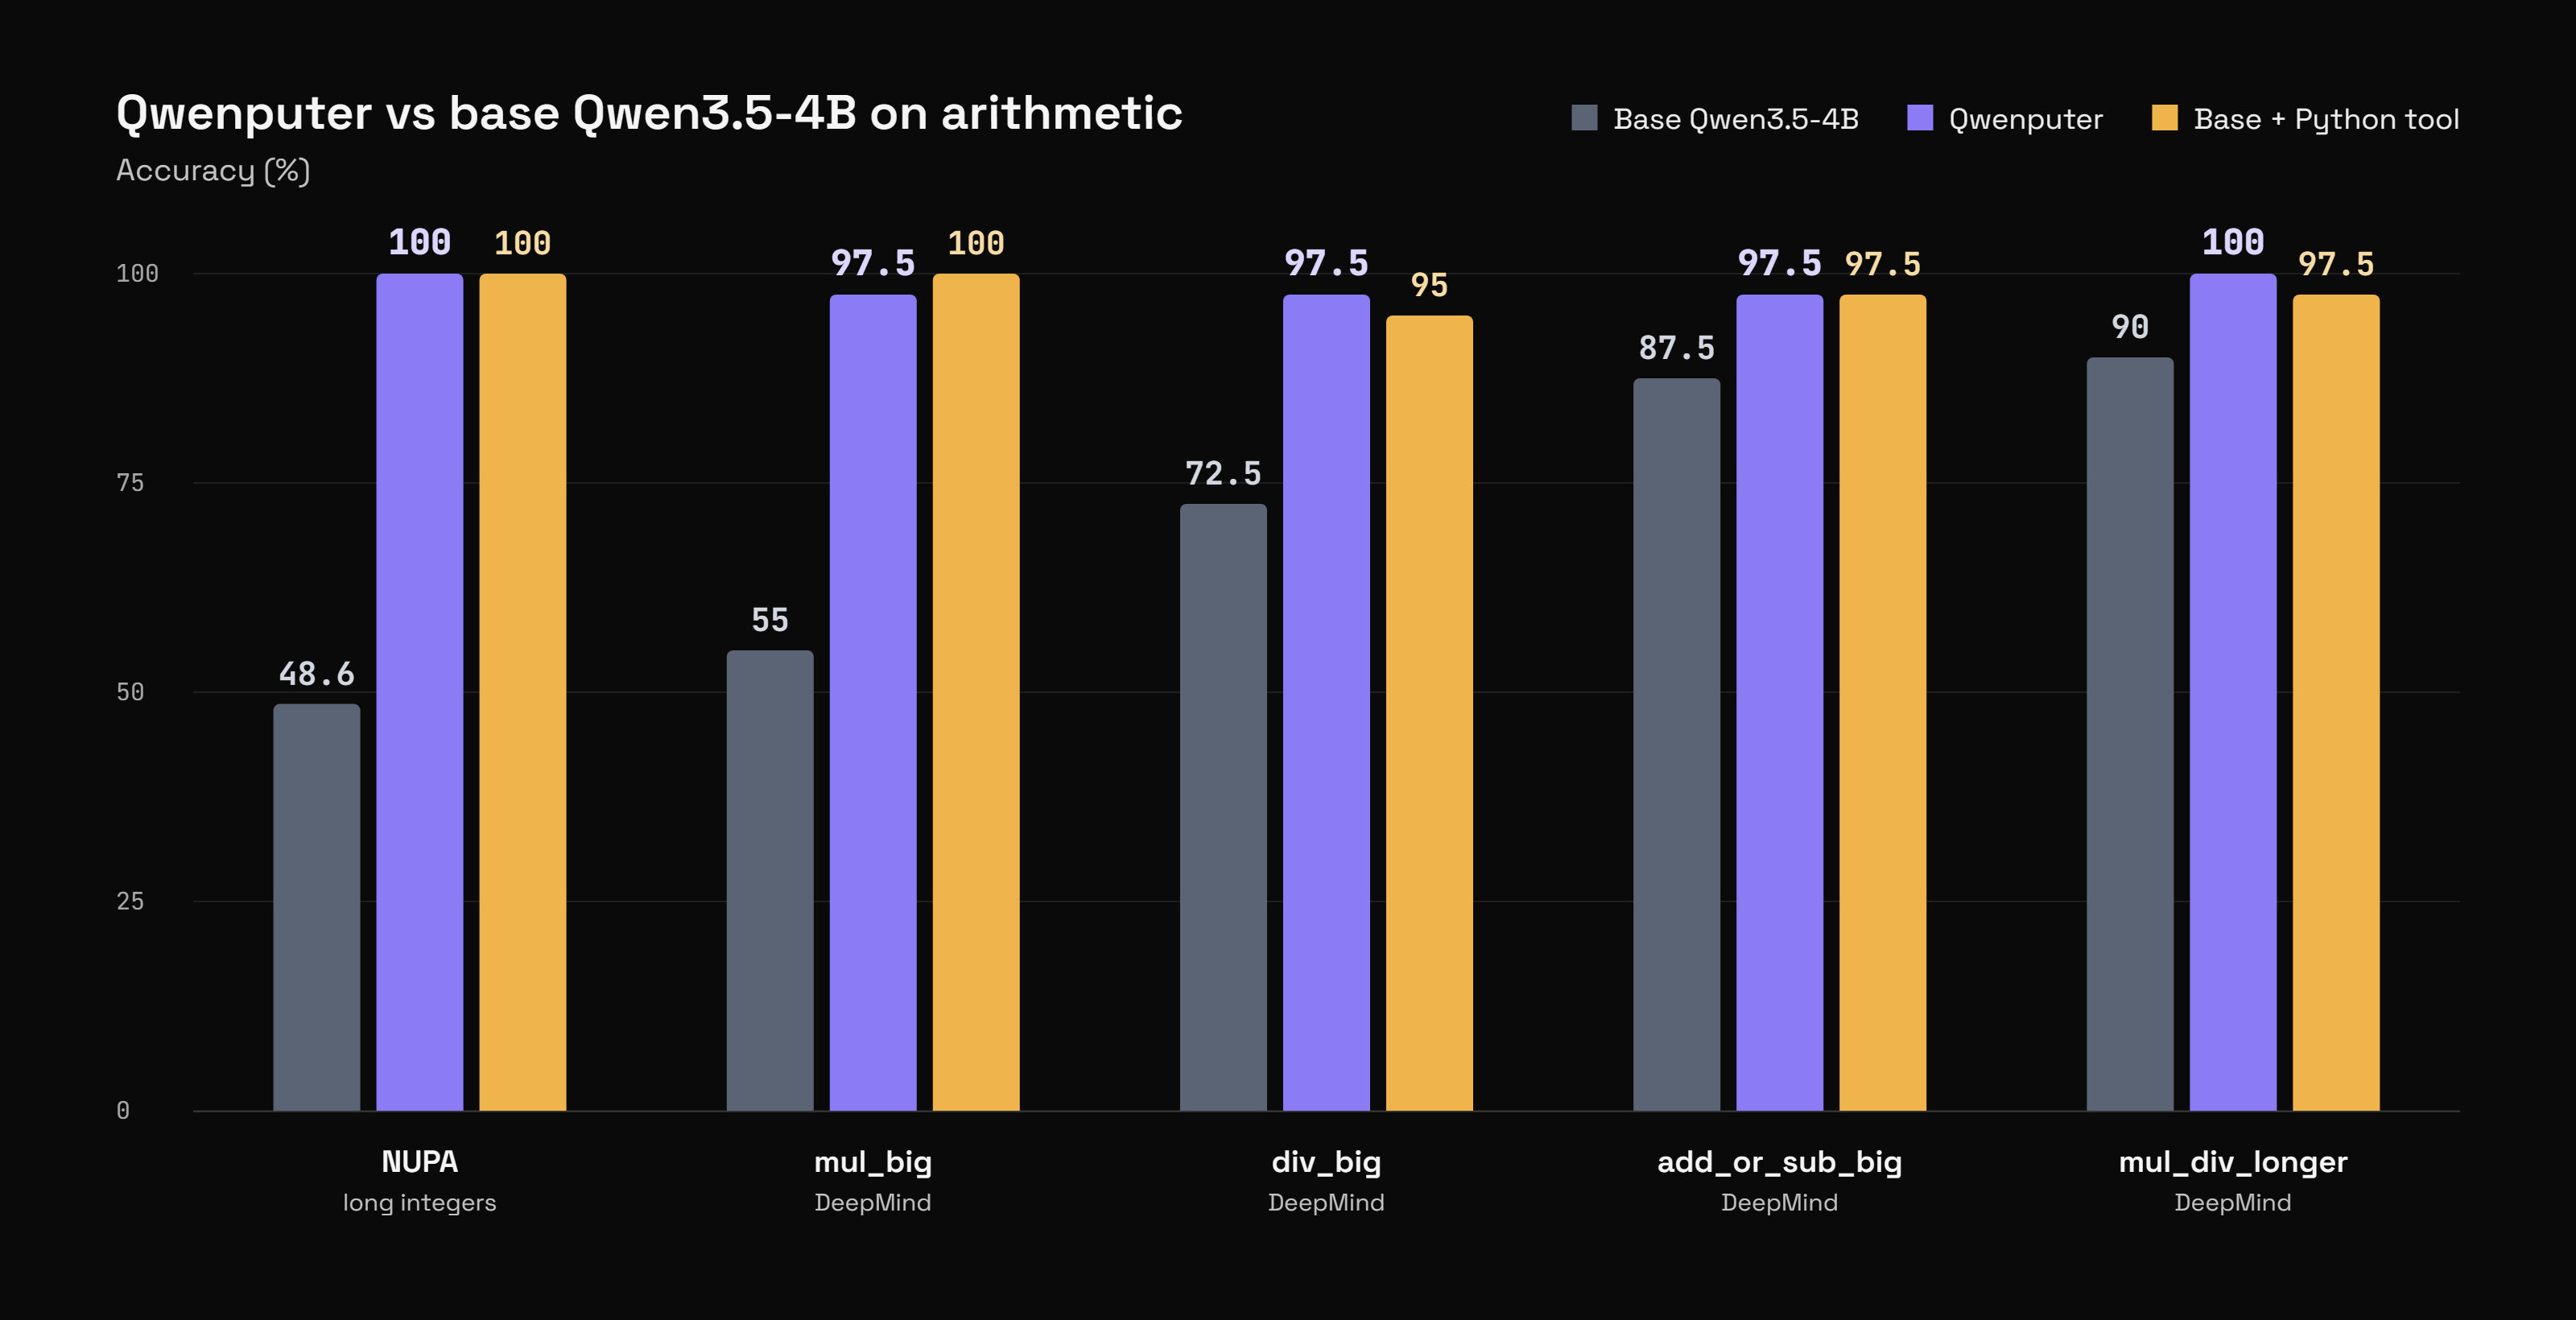
基准结果如下,贪心解码,每组 40 题:
| 基准 | Qwen3.5-4B | Qwenputer | 外挂 Python |
|---|---|---|---|
| 合成整数运算 | 75.0 | 97.5 | 97.5 |
DeepMind mul_big | 55.0 | 97.5 | 100 |
DeepMind div_big | 72.5 | 97.5 | 95.0 |
DeepMind mul_div_multiple_longer | 90.0 | 100.0 | 97.5 |
DeepMind add_or_sub_big | 87.5 | 97.5 | 97.5 |
NUPA 上 Qwenputer 拿到 100%,base Qwen 是 48.6%,和外挂 Python 打平。作者还回放了约 230,000 个计算机输出位置,和参考机器模型比对,零不一致;Qwen 的文本行为与 base 的 KL 是 6e-4,噪声底是 5e-4。
项目已经放出了在线 demo、Hugging Face 权重、ModelScope 权重、文件系统模型、代码和博客。模型卡里还有一条容易忽略的限制:18.8GB 的 bf16 模型大部分是零填充,CPU 本体只有约 100 万非零权重;速度按 trace tokens 计,不能直接等同于外挂 Python 的端到端延迟。
有网友在转发里感叹,现在连电脑都能下载了。这个说法有点夸张,但 Qwenputer 把计算单元和模型权重压进同一个前向传播,确实把模型、运行时和工具之间的边界往前推了一步。
发布时间: 2026-10-31 07:40