机器人学不会长任务,缺的是自己搞砸后的数据
斯坦福团队I3L让操作员在部署中直接接管机器人,把纠正帧喂回训练。8个任务成功率全部到90%以上,同样100条轨迹,纠正比额外演示平均高35.6个百分点。
机器人做长任务,失败常常从一个小误差开始,滚到后面收不住。斯坦福团队的新工作I3L盯的就是这段最后一公里:策略在离线演示里表现不错,部署后遇到没见过的状态就退化。Fei-Fei Li在推文里把问题说得很直接,长程机器人任务的last-mile gap。
I3L全称是Iterative Interactive Imitation Learning for Whole-Body Mobile Manipulation。它的硬件叫JoyLo+。操作员平时不用管,电机驱动的leader臂跟着策略走;手一握触摸感应手柄,接管双臂、躯干、底座和夹爪;松开,策略从纠正后的状态重新规划。物料清单估算,Franka配置约1087美元,R1 Pro配置约1257美元,不含机器人本体、税、运费、线缆、紧固件、轴承和安装件。设计、CAD、代码、模型和数据集都开源。
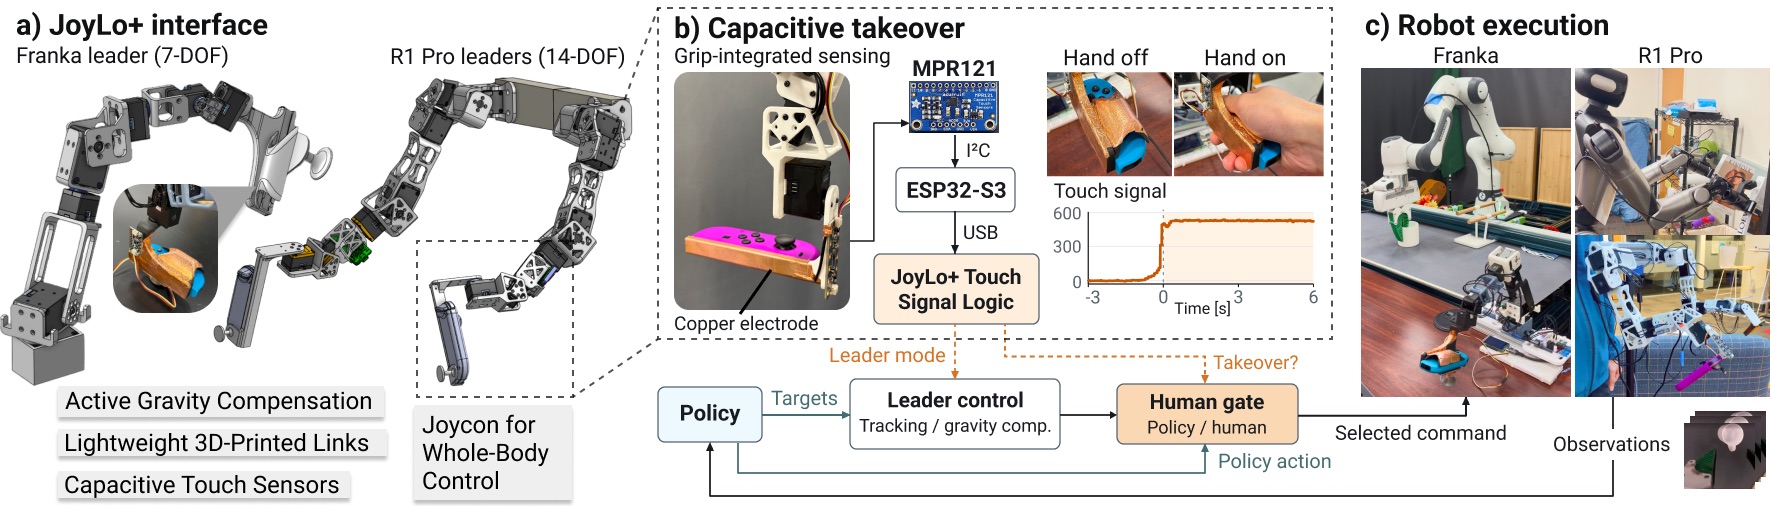
这套东西解决的是数据分布问题。离线模仿学习从遥操作演示里学,演示覆盖不到的状态,策略没见过。长程任务把复合误差放大,全身移动操作还要协调手臂、躯干和底座,穷举演示不现实。Wensi Ai在推文里写,长程放大误差,全身协调又让失败难纠正。
训练流程不复杂,但细节关键。每轮部署上一轮策略,通过JoyLo+收集带标签的rollout。HG-DAgger过滤后,只保留原始演示和主动干预帧,干预前和on-policy帧都排除。每轮从同一预训练检查点重新训练,不接着上一轮权重。早期失败修掉后,纠正自然往后段运输、放置转移,形成失败模式课程。说白一点,纠正数据把训练集中到策略真正会掉进去的状态。
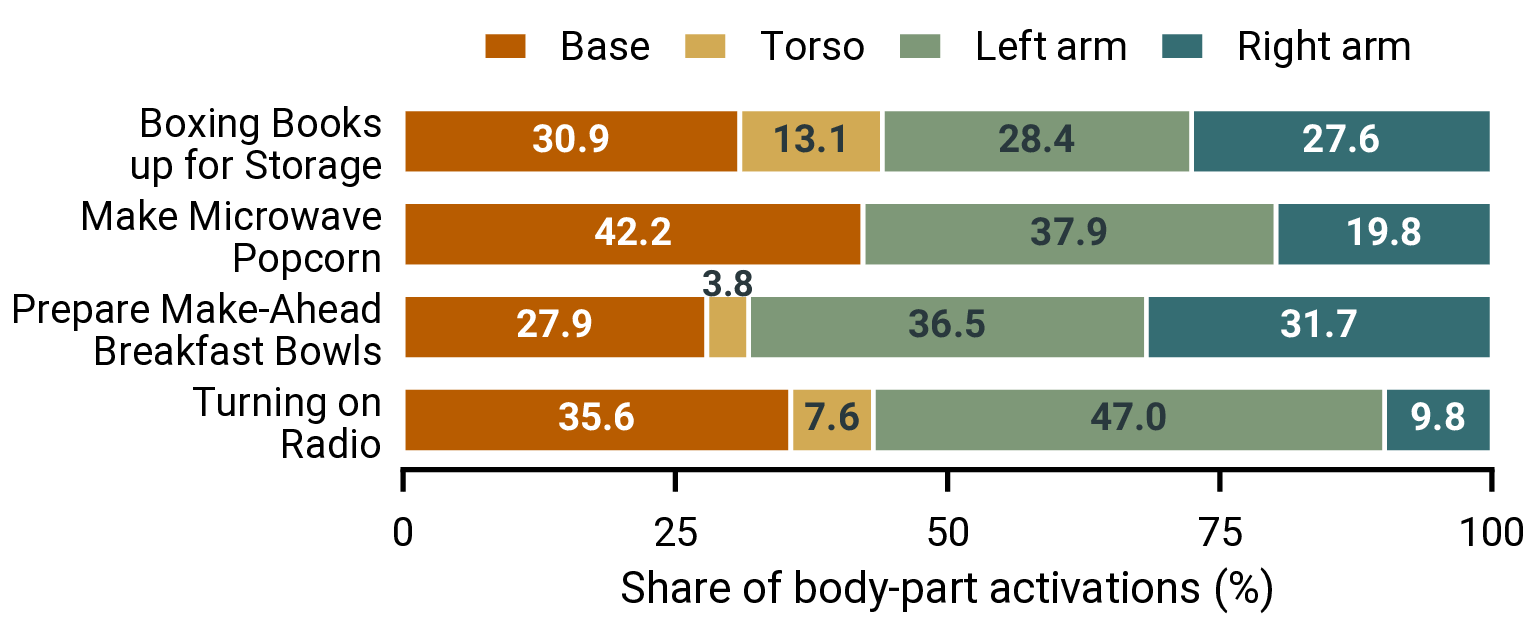
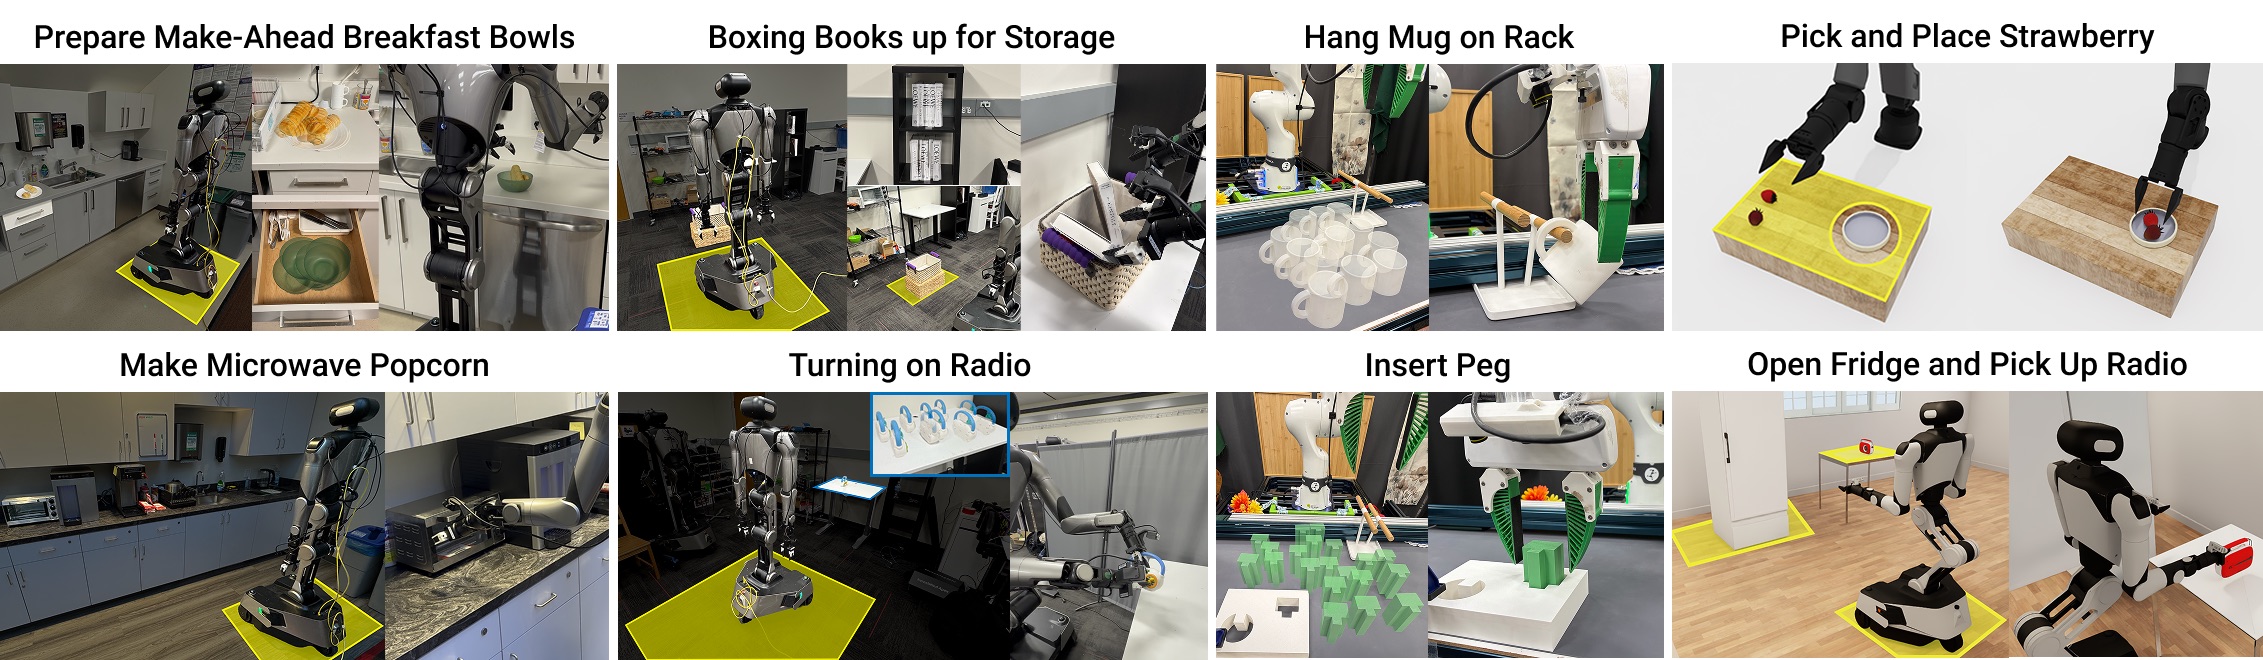
数据:8个任务,3种机器人,包括4个长程全身移动操作。基线平均提升68.3个百分点,每个任务至少90%成功。同样100条轨迹预算,纠正比额外演示平均高35.6个百分点。四轮后,每个episode平均接管时长降72%。三名不同遥操作经验的操作员在Franka挂马克杯任务上各跑三轮,每轮25个episode,干预负担都降,免接管episode都在累积。策略比较里,四轮HG-DAgger在两个模拟任务上最终成功率最高,但轮数多不保证更好,怎么从纠正里学同样关键。
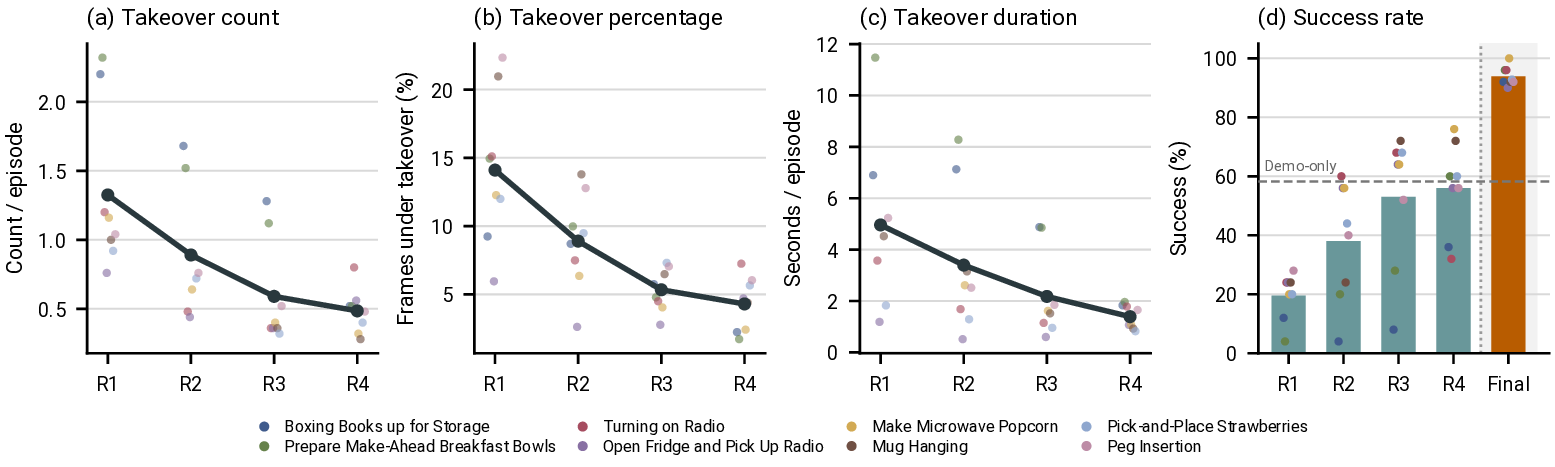
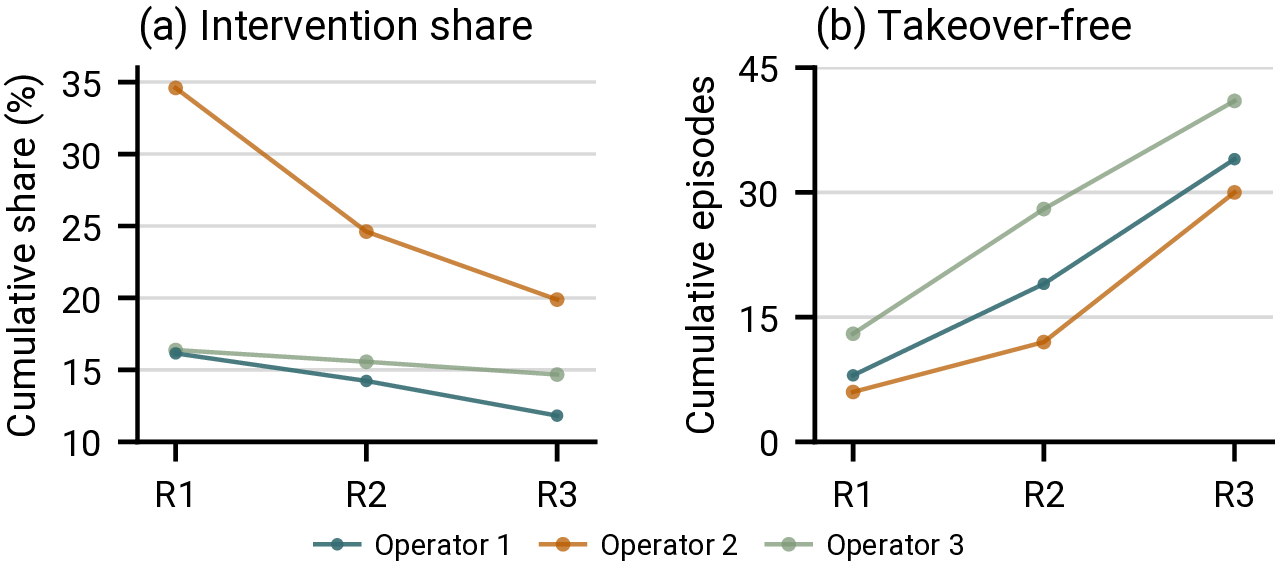
Adam P在回复里说,只从完美演示里学过的机器人,从没见过自己搞砸。这句话点到了。额外演示是正确示范,纠正数据是在错误边上拽回来。后者更贵,因为要人盯着,但它对准了部署时真正发生的失败。这套系统没有绕开人,只是让人出现在最该出现的地方。接管时长降了72%,人仍是成本。任务值不值得这么调,是另一个问题。
项目网站:https://i-3l.github.io/
论文:https://arxiv.org/abs/2610.17748
代码:https://github.com/i-3l/I3L
模型和数据集:https://huggingface.co/I3L
发布时间: 2026-10-31 08:42