RAG 答错,别急着换模型:先修检索,失败率降了 67%
Anthropic 的评测把 top-20 检索失败率从 5.7% 压到 1.9%:contextual embeddings、BM25 和 reranker 各贡献一段。LangChain 生态里这套链路有现成组件,LangSmith 负责在线评估,盯住文档变化带来的静默衰减。
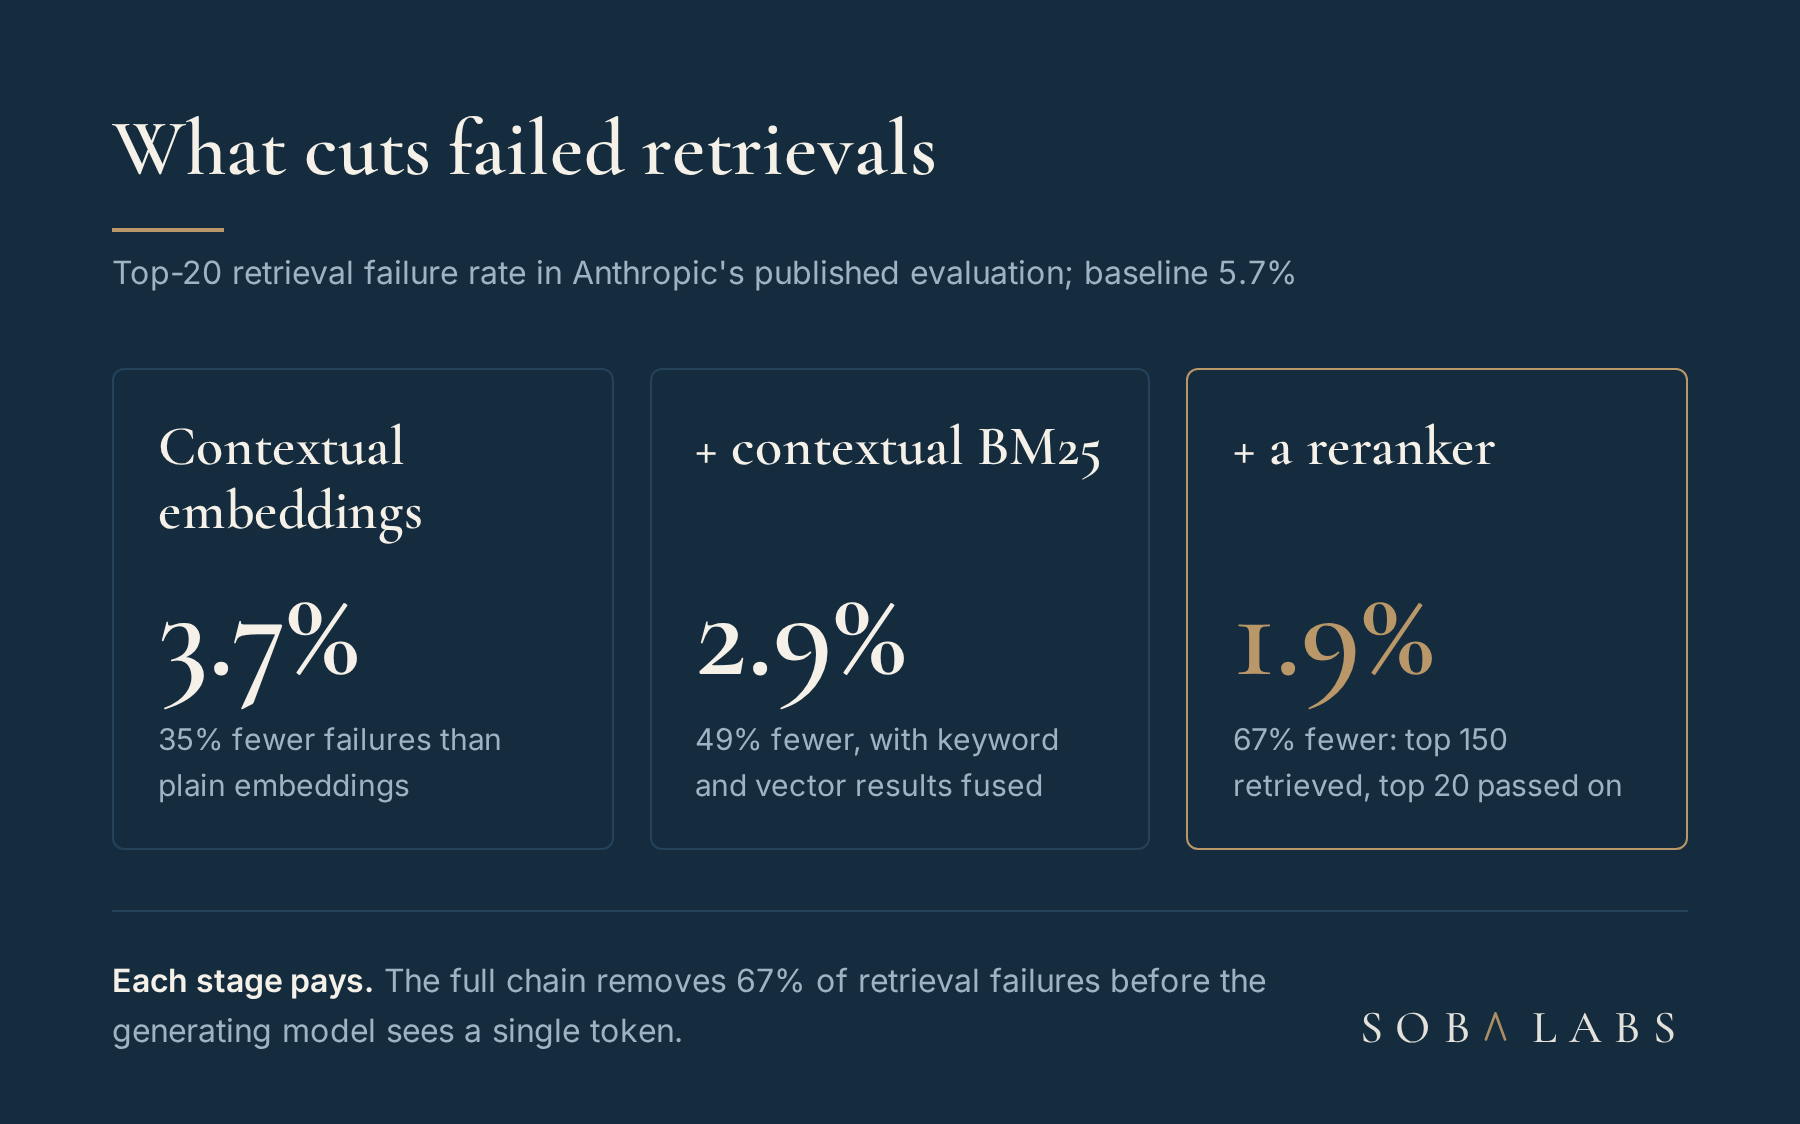
企业 RAG 答错时,第一反应通常是换模型、改提示词。LangChain 社区 spotlight 最近推了 Soba Labs 的一篇企业 RAG 指南,作者 Kacper Klusek 给了另一个顺序:先修检索,再碰模型。Anthropic 公布的一组评测里,contextual embeddings 把 top-20 检索失败率从 5.7% 降到 3.7%,加上 contextual BM25 到 2.9%,再加 reranker 到 1.9%。三段合起来,失败率少了 67%。这些失败发生在生成模型看到 token 之前。

原始讨论在 LangChain 的 X 帖子,完整指南在 Soba Labs 博客。文章把企业 RAG 拆成几个顺序明确的决策:架构、切块、混合检索、重排、评估。每一步都有具体数字,不是配置清单的堆砌。
先说架构。LangChain 文档把 RAG 分成三类:2-Step RAG、Agentic RAG 和混合式。2-Step 的检索总在生成前发生,延迟可预测,LLM 调用次数有上限;Agentic RAG 让模型在推理过程中决定什么时候检索、怎么检索,灵活,但循环多了,失败模式也多了;混合式在中间,保留校验步骤,召回内容太薄时可以重新查询,答案还要对着来源做验证。选型的关键是谁控制循环。FAQ、文档机器人先从 2-Step 开始。多源、多步问题再考虑 Agentic。每多给模型一度自由,就多一个需要评估的失败模式。
切块看起来像预处理,实际上是在决定检索单元。LangChain 的 splitter 文档给了一个很直白的默认建议:多数场景从 RecursiveCharacterTextSplitter 开始。它尽量保留段落,段落超过块大小再退到句子和词。知识库教程里的默认参数是 chunk_size=1000,chunk_overlap=200,add_start_index=True。教程里那份 107 页 PDF 被切成 516 个 chunk。add_start_index 保留字符偏移,用户第一次问答案出处时就会用上。
更麻烦的是,chunk 离开原文会丢指代。Anthropic 的 contextual retrieval 做法是,在 embedding 前给每个 chunk 加一段短上下文。只加 contextual embeddings,top-20 失败率从 5.7% 降到 3.7%,一次性成本是每百万文档 token 1.02 美元。文章还提醒了一个容易被忽略的边界:知识库小于 200,000 token,大约 500 页材料时,可以直接把整个知识库塞进 prompt,不一定需要 RAG。
混合检索解决的是 embedding 不擅长的查询。用户搜错误码、零件号、条款编号,向量检索可能匹配到语义相近但字符串不对的内容。把 dense index 和 BM25 并排,再融合结果,是老技术继续上岗。Weaviate 的 hybrid search 文档写得很清楚:alpha 从 0 到 1,0 是纯关键词,1 是纯向量,Relative Score Fusion 从 v1.24 起是默认融合方法。Anthropic 的评测里,contextual embeddings 加 contextual BM25,把失败率从 3.7% 拉到 2.9%,相对 5.7% 的基线少了 49%。BM25 在标识符和术语密集的语料里更值钱;日期、产品、租户这类 metadata 过滤,通常比换索引更便宜地缩小候选集。
重排是剩下最便宜的一截准确率。第一层检索为了大语料召回,reranker 是第二个模型,把一个小候选集按查询相关性重新排序。它同时读查询和文档,能抓到 bi-encoder 结构上抓不到的关系。Cohere 的 Rerank 3.5 公告里,在金融服务数据集上比 hybrid search 好 23.4%,比 BM25 好 30.8%。Anthropic 的链路先取 top 150,再重排后保留 top 20,失败率落到 1.9%。
到这里,检索链路的收益已经很清楚。但企业 RAG 还有后半场:文档会变。产品改名、政策更新、昨天的先例和今天的规则冲突,系统不会因为代码没部署就保持不变。LangSmith 的 RAG 评估教程把质量拆成四个比较:correctness,回答对参考;relevance,回答对输入;groundedness,回答对召回文档;retrieval relevance,召回文档对输入。拆开之后,问题更容易定位。回答相关但没有依据,是模型在自由发挥;回答有依据但不相关,去查检索。线上评估用 LLM-as-a-judge 跑在真实 trace 上,可以设采样率控制成本,比如 0.1 只评十分之一的 trace。
文章给的上线前检查也很具体。第一,写读往返:人工修正写回后,用近似输入再跑一次,确认新先例真的出现在召回集里。第二,数据变化时重跑 golden-set 回归,不要只在代码部署时跑。第三,从第一天起记录每条数据的 embedding 模型版本。模型会废弃,跨版本的相似度没有意义,几千条数据重新 embedding 是一次迁移,最好提前计划,而不是上线后才发现。
有网友在讨论里说,先修检索也更好调试,直接看召回的 chunk,就能知道答案为什么错。还有人问,企业文档一直在变,过期或冲突信息怎么处理。文章没有给一个万能开关,但给了可执行的方向:在线评估盯 groundedness 和 retrieval relevance,写入路径做往返测试,数据变更触发回归。有人把 fix retrieval first 吐槽成对 RAG 工程师说先去收拾房间。话糙,顺序是对的。
完整指南和代码片段在 Soba Labs 的原文。如果只想记一件事:模型会继续变强,检索栈不会自动变好。企业 RAG 的差距,常常在模型看到第一个 token 之前就已经拉开。
发布时间: 2026-11-01 06:28