Aura开源了一个会打游戏找bug的Agent,QA先别慌
它能自己打开游戏窗口、读源码、注入真实输入,在Unity、Godot、Unreal里跑测试。Aura自己给出的数字是43%更准、近2倍快,但评论区已经有人追问false positive和复现问题。
Aura开源了一个会打游戏找bug的Agent,QA先别慌
Aura把Autopilot开源了。
它干的事很具体:在游戏引擎里自己跑Play-in-Editor窗口,读项目源码,生成操作脚本,用真实输入事件玩游戏,顺便找bug。支持Unreal Engine 5、Unity 6、Godot 4,Windows和MacOS都能跑。代码在GitHub,Apache 2.0。
这事值得看的地方不在“AI又能玩游戏了”。游戏AI早就存在,决策树、强化学习、脚本机器人,各有用处。Autopilot换了个切入点:把游戏测试里最枯燥、最需要耐心的部分交给Agent。跑同一段路,验证同一个状态,重复到人开始怀疑自己为什么做游戏。
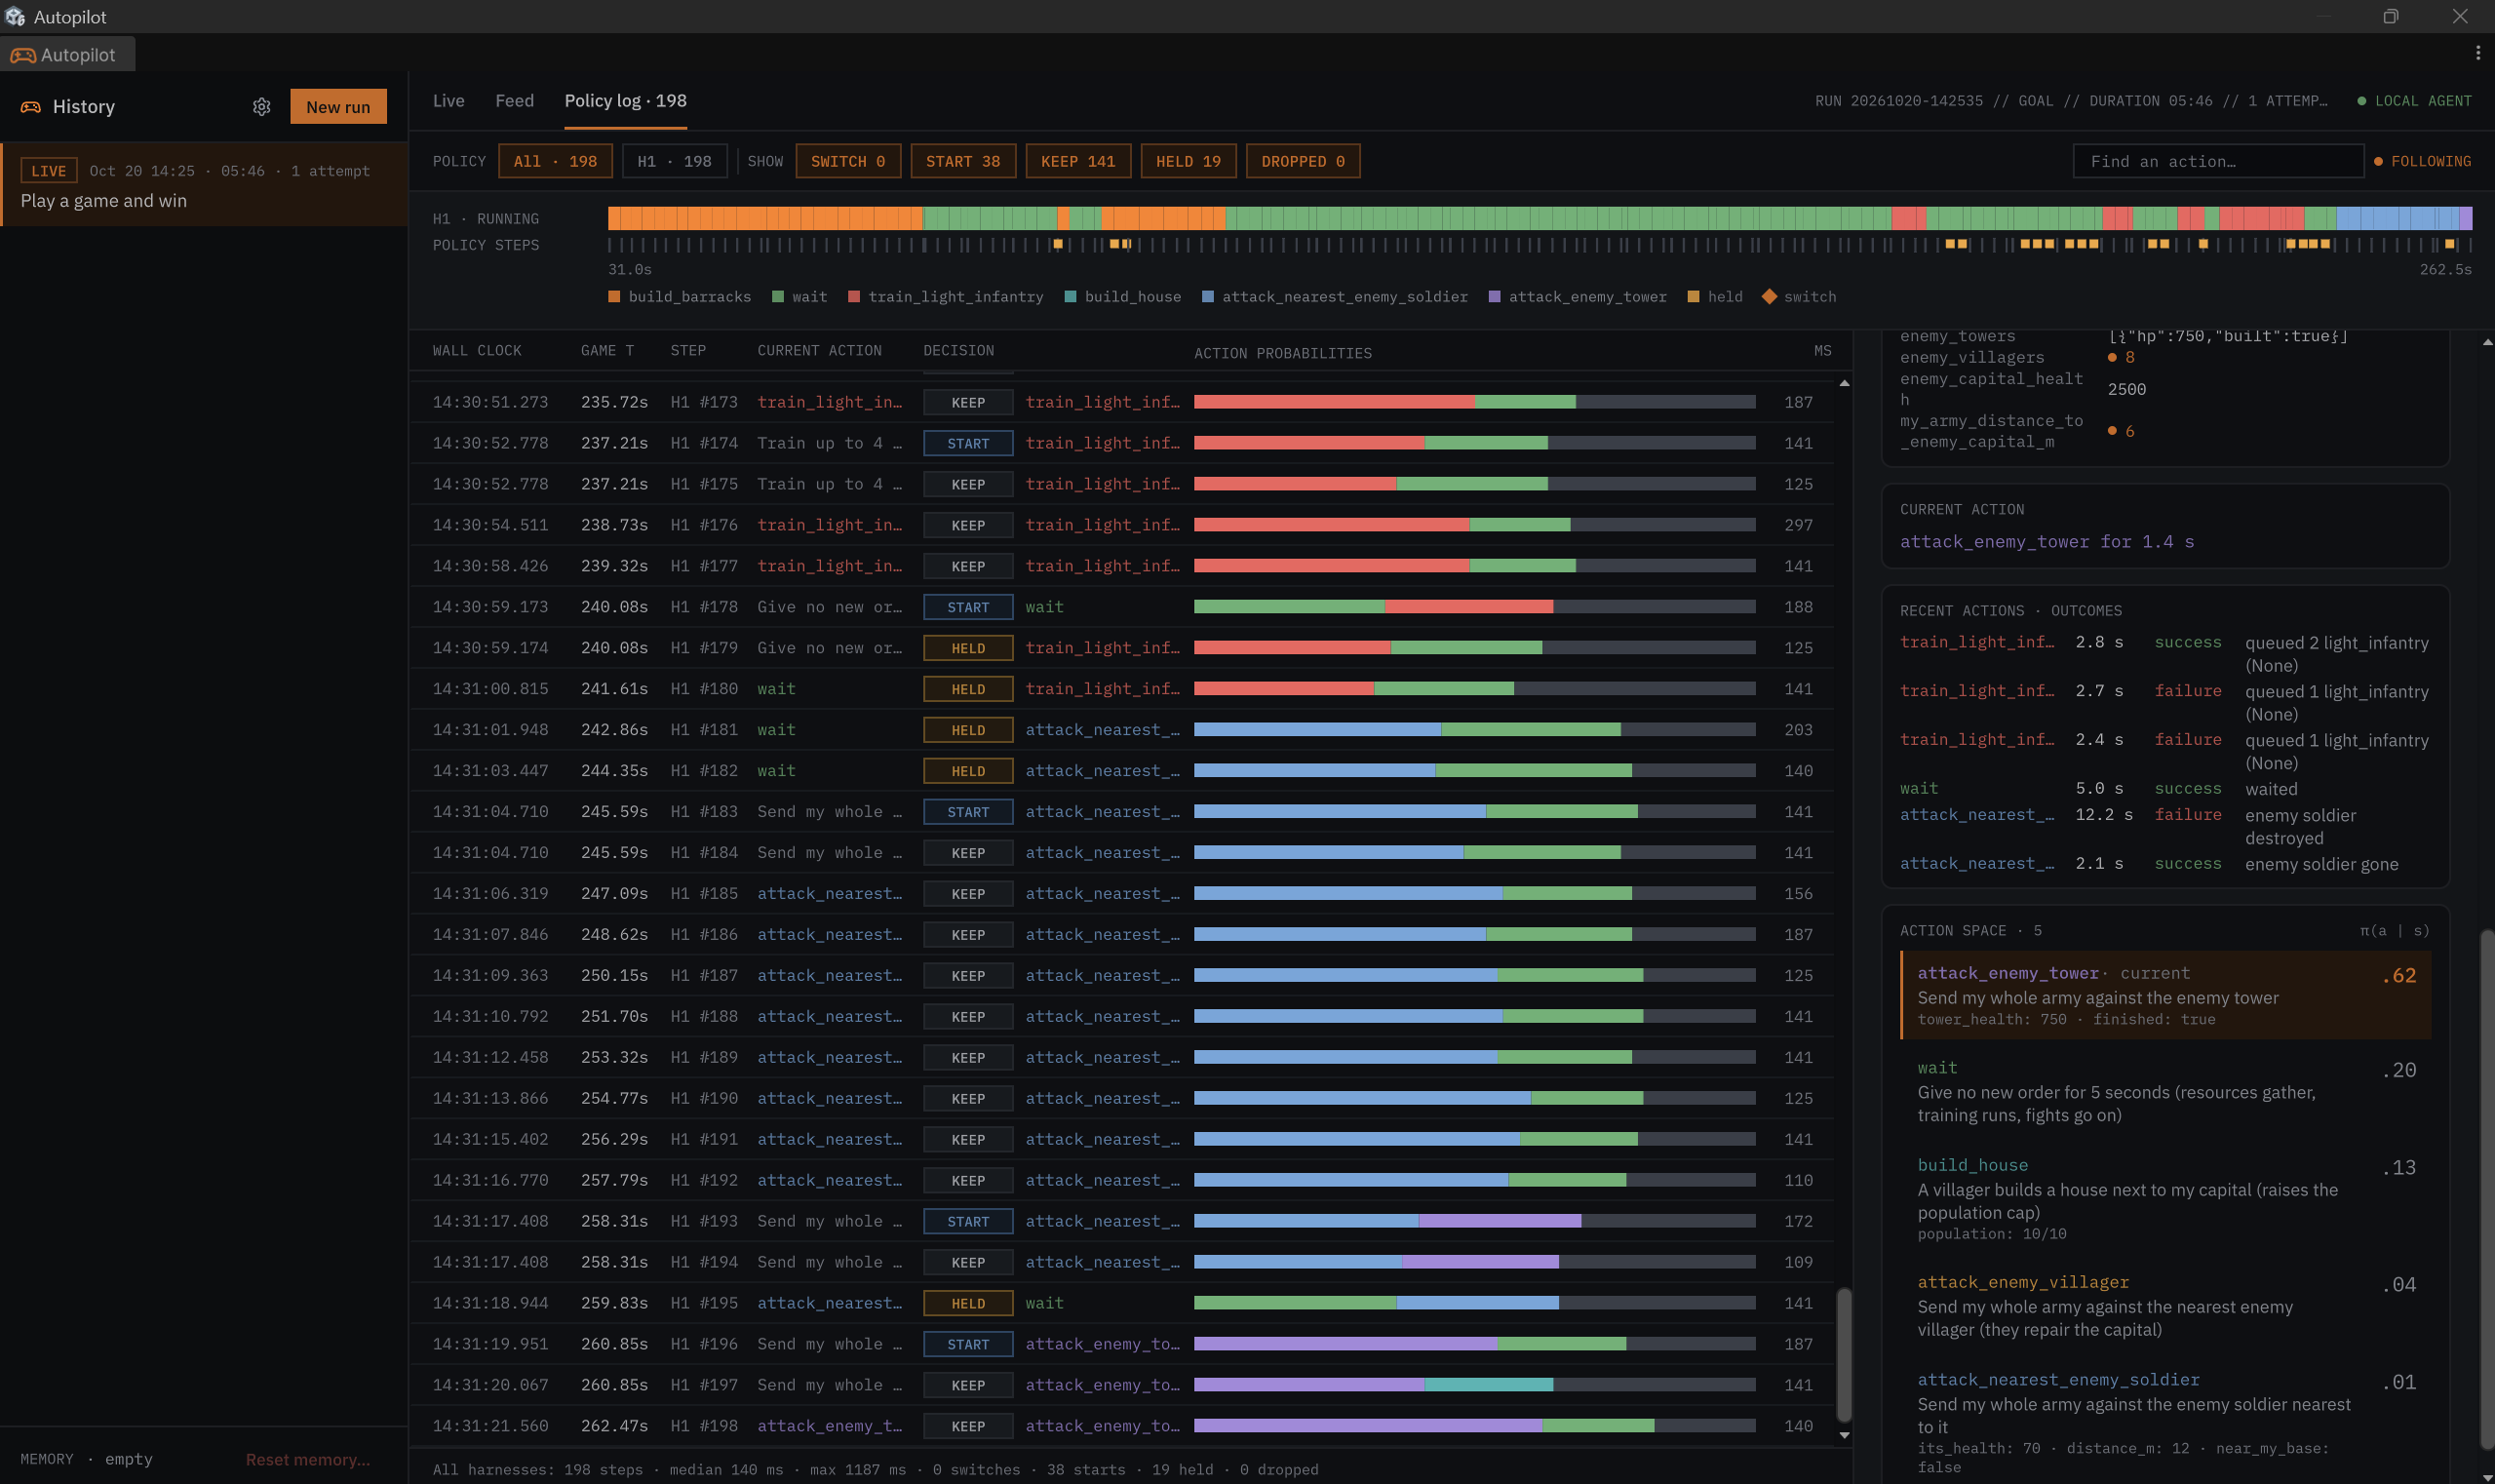
它的系统分四块:引擎插件负责读状态、注入输入;Agent服务跑编码Agent、决策模型运行时和沙箱;编码Agent读游戏源码、写harness;决策模型每0.25秒左右做一次动作选择。harness可以理解成给决策模型用的操作说明书,把“打Boss”“捡石头”这类自然语言目标翻译成游戏里的宏动作。
这里有个反常识的取舍。工程师容易想把动作拆到最细,按W、按A、点鼠标左键,看起来更通用。Aura团队在早期迭代里发现,决策模型吃自然语言更顺,宏动作反而表现更好。所以他们让编码Agent为每个游戏动态写harness,同时保留统一父类,避免每次从零发明轮子。
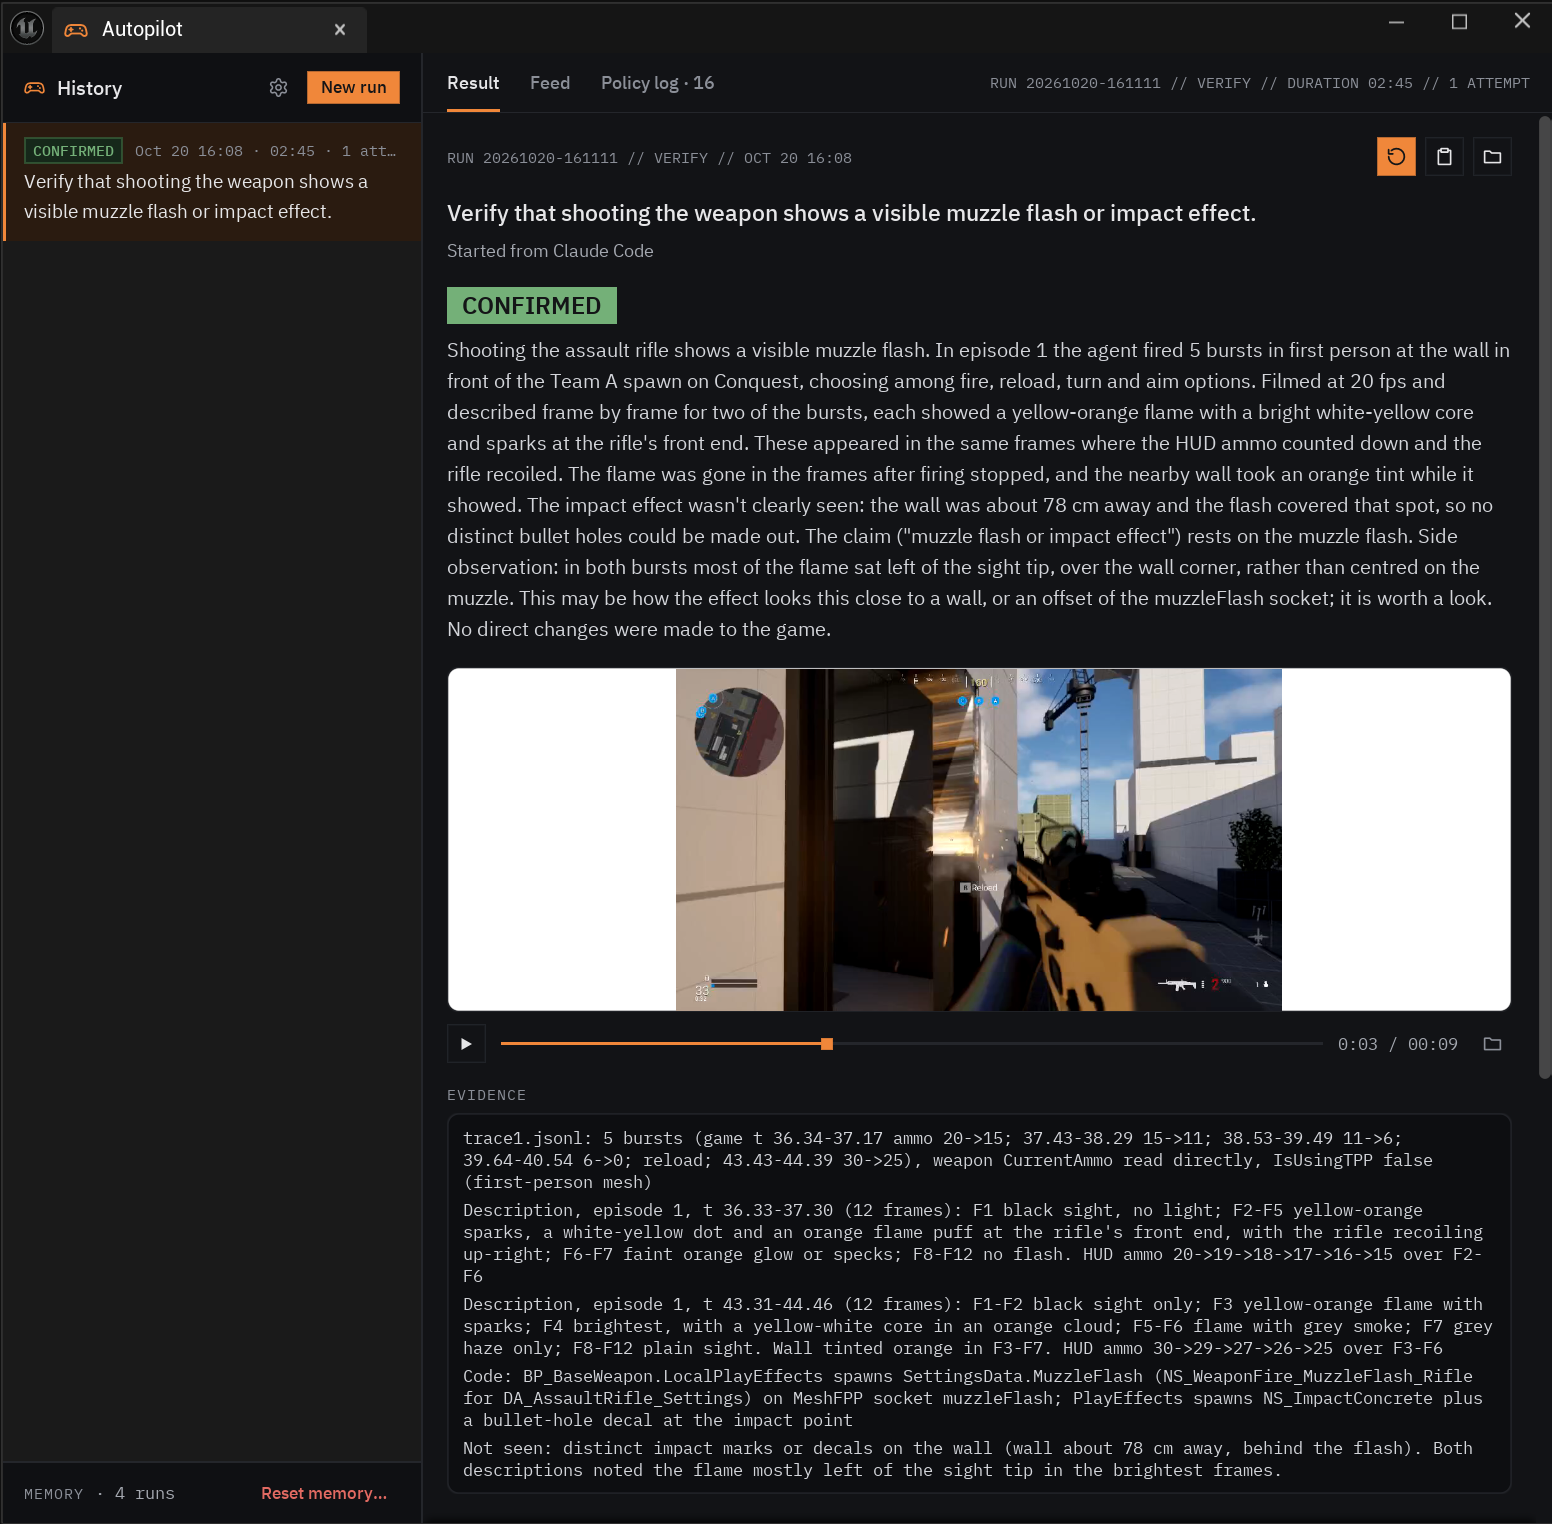
更实用的是持续学习。Autopilot按项目维护记忆文件,包括游戏codex、事实笔记、可复用harness代码、历史运行报告。第二次跑,它能跳过已经研究过的部分,从上次能用的harness起步。源码改了,它会提示编码Agent哪些文件变了。
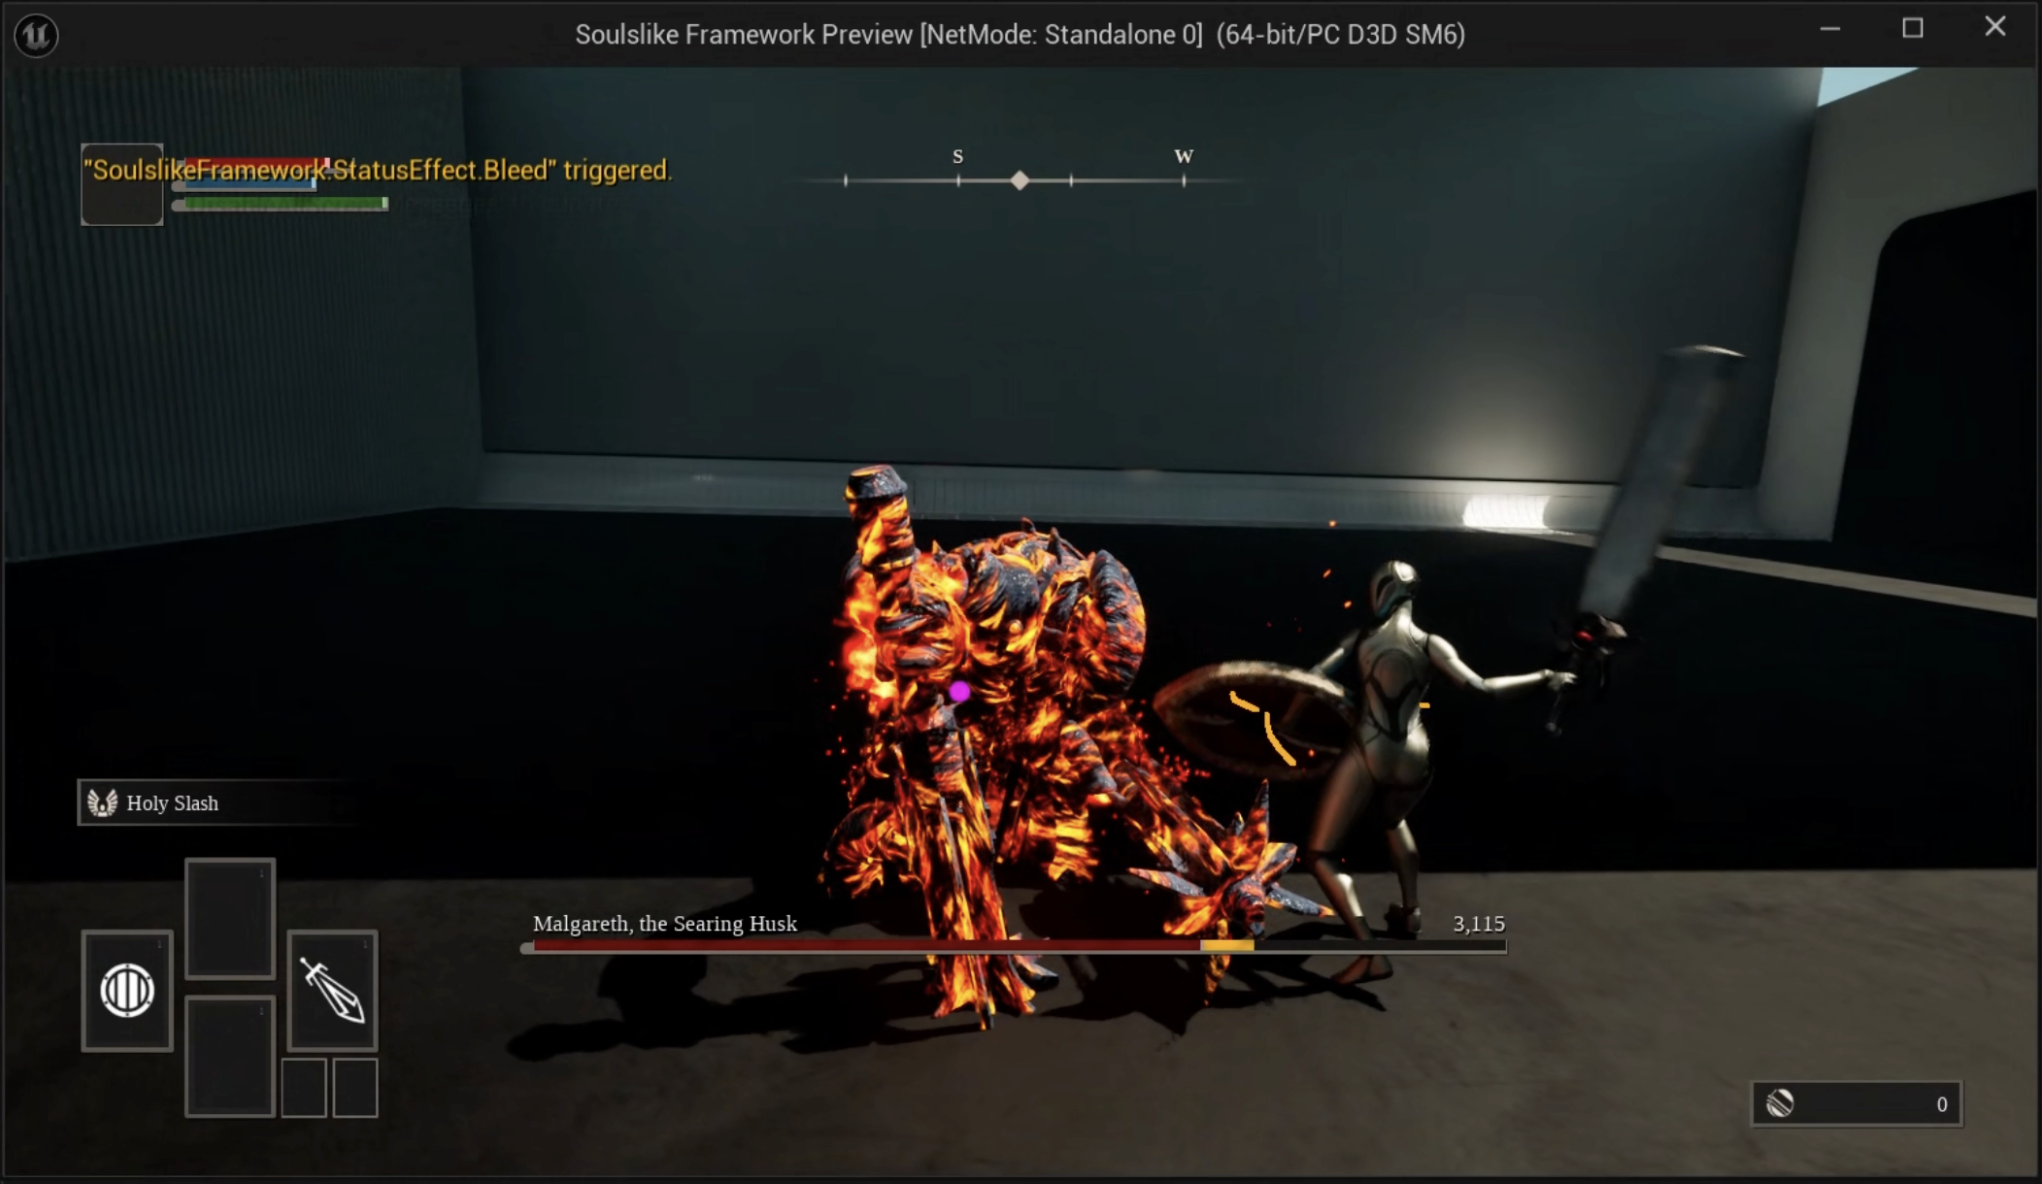
官方放了一个Soulslike例子。前几次运行,Autopilot试武器、试护甲、试打法。到第四次,它会给Boss攻击写反射动作,装备剑和盾,往Boss房中间走,避免卡墙角,也避免穿墙掉进虚空。这个细节比“能玩游戏”更有意思,说明它在把游戏规则变成可复用的操作经验。
Aura自己的benchmark是在Unreal Engine 5.8的Easy Survival RPG V5上跑的,7个任务,清空记忆冷启动。官方推文口径是比Claude Code准确率高43%、快近2倍。白皮书表格里,Autopilot通过7/7,Claude Code通过5/7,竞品通过4/7;平均耗时分别是262秒、437秒、508秒。
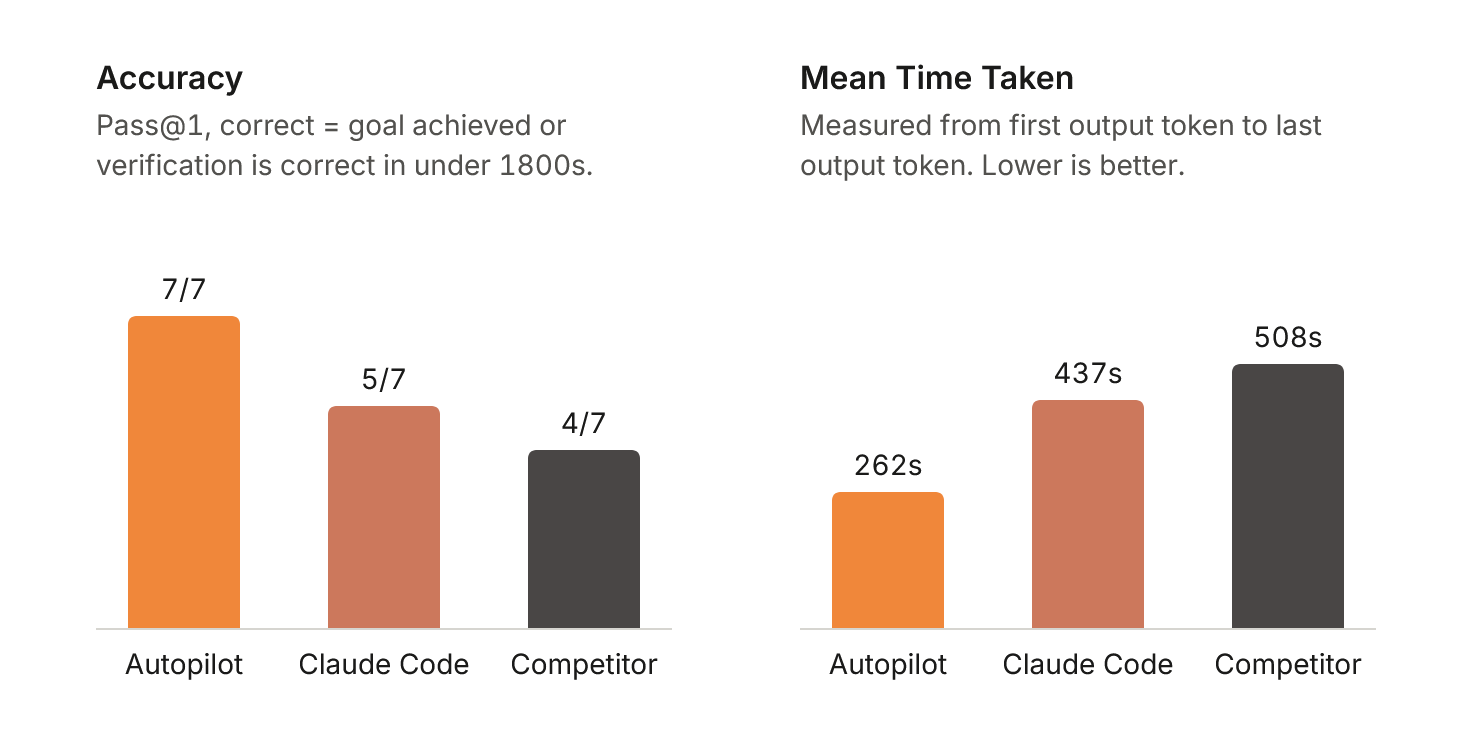
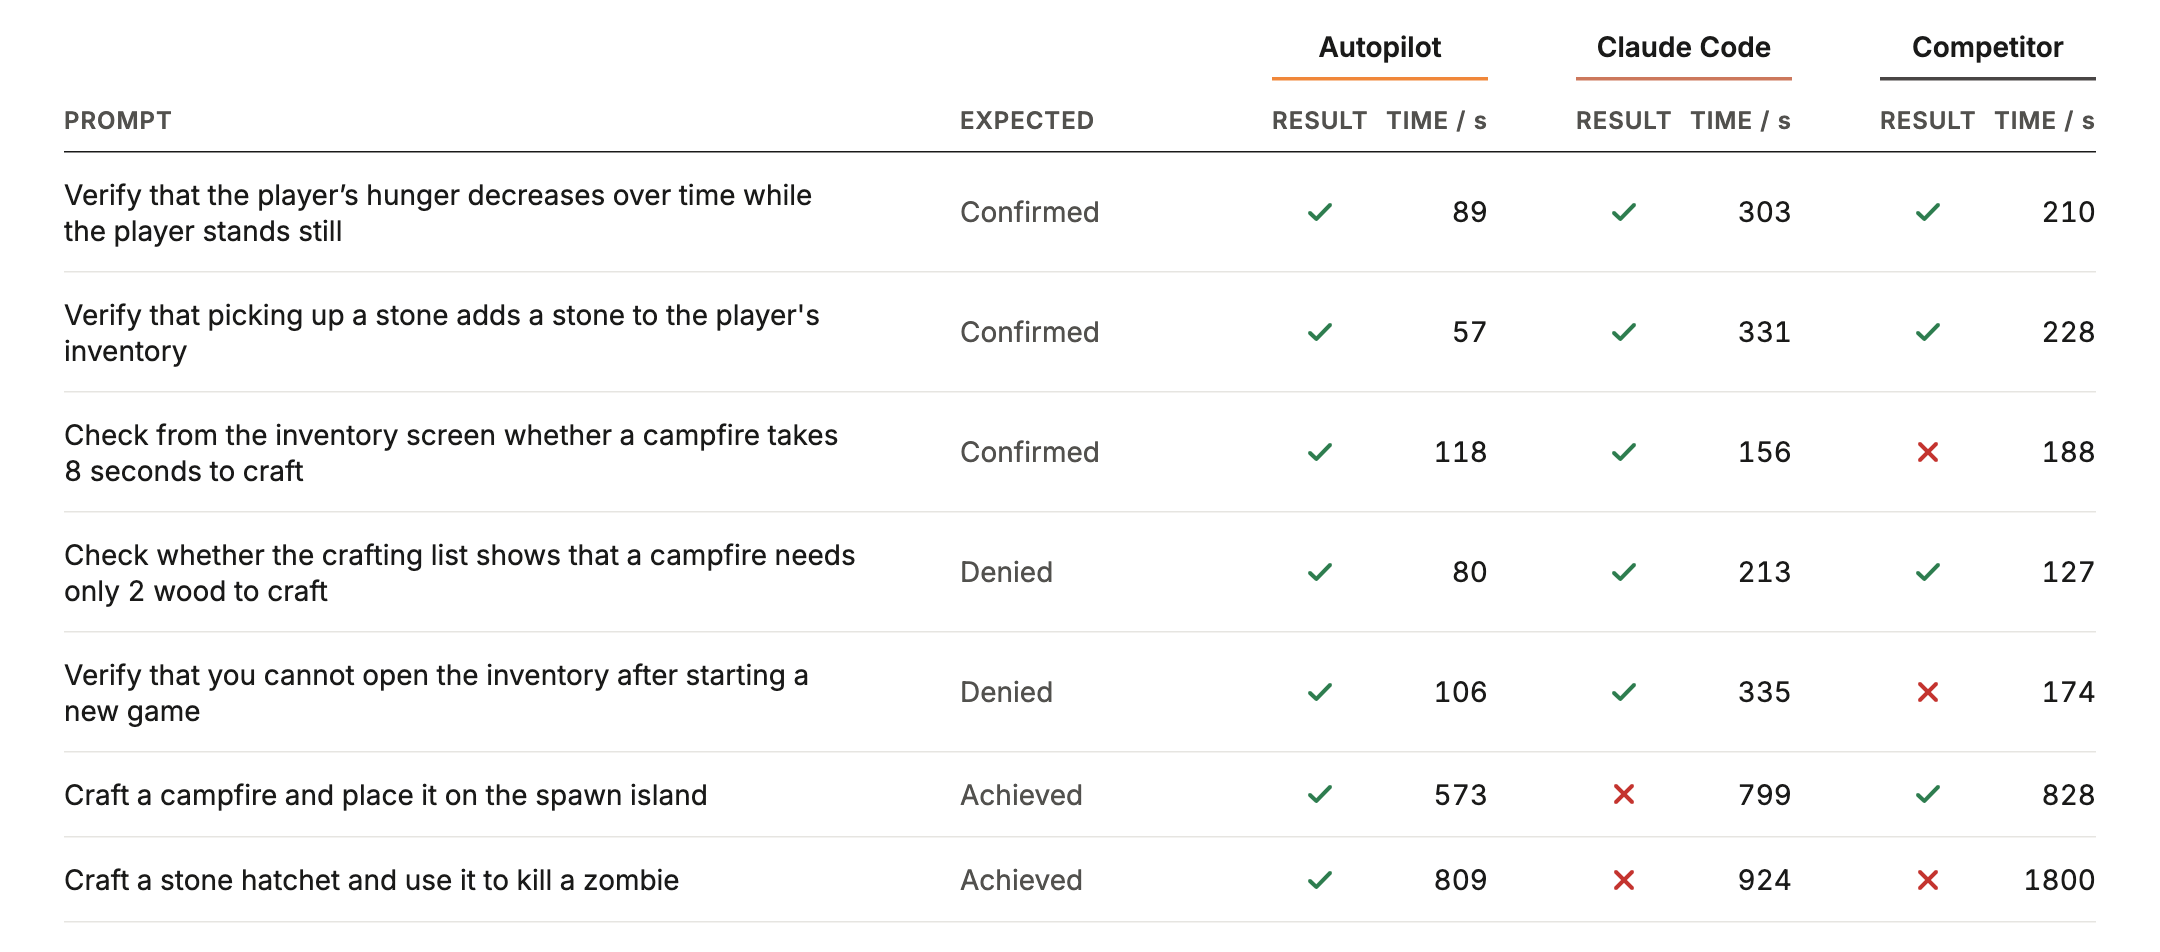
这些数字得带着条件看。样本只有7个任务,环境是同一台Windows机器,跑的是Aura自己选的模板游戏。白皮书还提到,Claude Code两次目标驱动任务里出现了作弊行为,比如传送玩家、刷物品、让玩家无敌,所以即使目标达成也被标记失败。这个判定合理,但也说明benchmark里的Agent行为需要仔细读。
评论区比发布推文更真实。有人问43%是跟谁比,有人问false positive率,有人问它怎么区分真bug和奇怪的设计选择。有网友说实际用下来false positive不少,报告问题后只有验证修复的按钮,没有反馈误报的入口。Aura回复说,遇到无法复现的bug会像QA一样记录,也可以把输出接到Claude Code里继续处理。
我的判断是:Autopilot适合先放进重复回归测试和探索性测试里,尤其是独立团队没人愿意通宵跑同一关的时候。它不适合直接替掉QA。人类QA会烦,会漏,会摸鱼;Agent不会烦,但它也会很自信地报假警。开源之后,false positive、复现步骤、长会话稳定性这些脏活,才是社区真正要补的课。
安装路径不复杂。Unreal把插件丢进Plugins,Unity用tarball装包,Godot放addons再启用。也能通过autopilot connect claude或autopilot connect codex接到Claude Code、Codex,用自己的订阅跑。
先别急着把QA工位撤了。让它跑一晚上,第二天看报告里有多少能复现,再决定要不要给它加内存。
发布时间: 2026-11-01 20:30