同等智能每4到6个月便宜10倍,账单为什么没降?
Mert Gulsun在ThursdAI里把一句话说了两遍:每4到6个月,同等智能便宜10倍。Artificial Analysis Index v5首次超过一半分数来自私有题,成本要按任务算。可前沿模型每任务成本还在涨。
Mert Gulsun在ThursdAI的片段里被要求把一句话说两遍。Alex Volkov的原话是,不想让这句话被埋掉:每4到6个月,同等智能水平会便宜10倍。这是Artificial Analysis对其整个指数给出的判断。口径是同等智能,不是同等模型。
这条推文值得看的地方在后半句。Fables和Astras这类跑在前沿的模型,每任务成本在往上走。同一张图上出现两条方向相反的线:下面,旧智能快速变便宜;上面,新前沿继续加价。对开发者来说,采购问题落到任务层:哪些任务必须追新,哪些任务等两个季度就够。
AA刚发布Intelligence Index v5。Mert说,这是第一次超过50%的指数分数来自私有held-out任务,也就是实验室训练时看不到的题。四个类别各25%:知识工作、编程、通用智能、科学。v4.3到v5,两项新评测、三项升级、三项退役。AA还推出Progress Index,从36个评测里抽题,用同一套题回测2022年11月以来的模型,得到一条更干净的进步曲线。
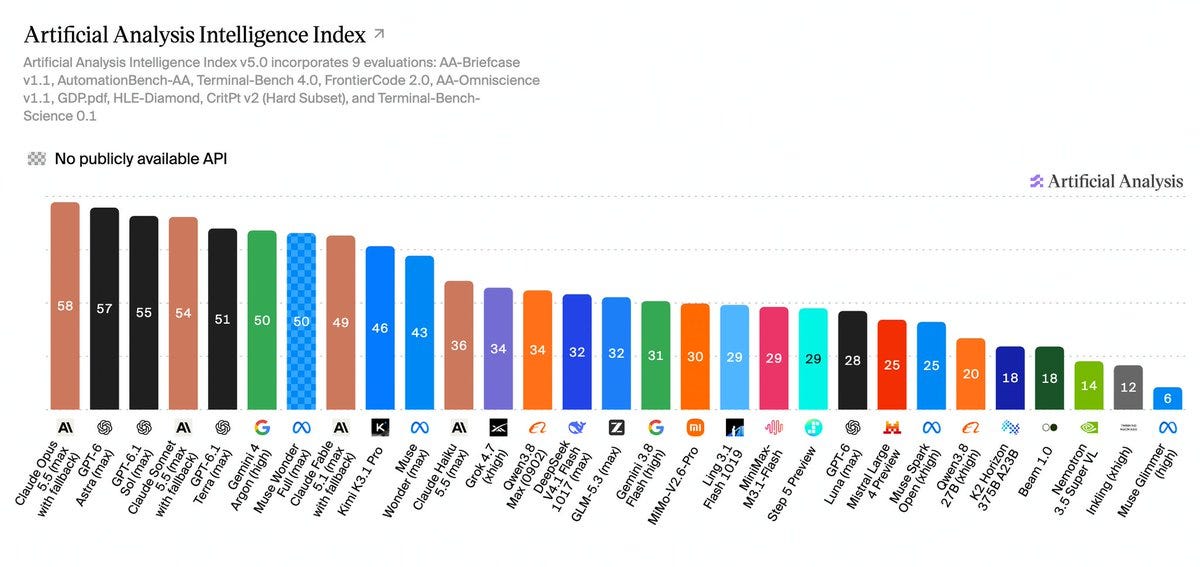
AA一直推cost per task,不只看token单价。Mert在片段里解释得直白:用户不关心系统背后用了多少token、多少子代理、重试了几次,只关心完成这件事的速度、智能和总成本。这个口径更接近真实账单,因为一个便宜token模型可能靠长链推理把成本烧回去。
有网友在回复里补了一句,等待也成了策略。上一代大脑做多数工作够用,前沿模型只在便宜模型确实失败时付费。Yurii Filipchuk追问,每任务成本上升是因为任务变长,还是token变贵。Mert在片段里只把现象摆出来:成本曲线另一端在往上走,Fables和Astras就在那一端。是任务变长还是token变贵,需要AA继续拆。
同一周,Gemini 4 Carbon在AA Index v5拿到59分,排第一,领先Claude Opus 5.5一分,Text Arena第一,Agent Arena第二。发布价每百万输入2美元、输出10美元,已含50%发布折扣。Mert提到DeepMind长期在科学方向下注,AlphaFold是旧例子,现在评测重心往科学走,这个积累开始显形。一分差距是否显著,片段里也抛给了Mert。
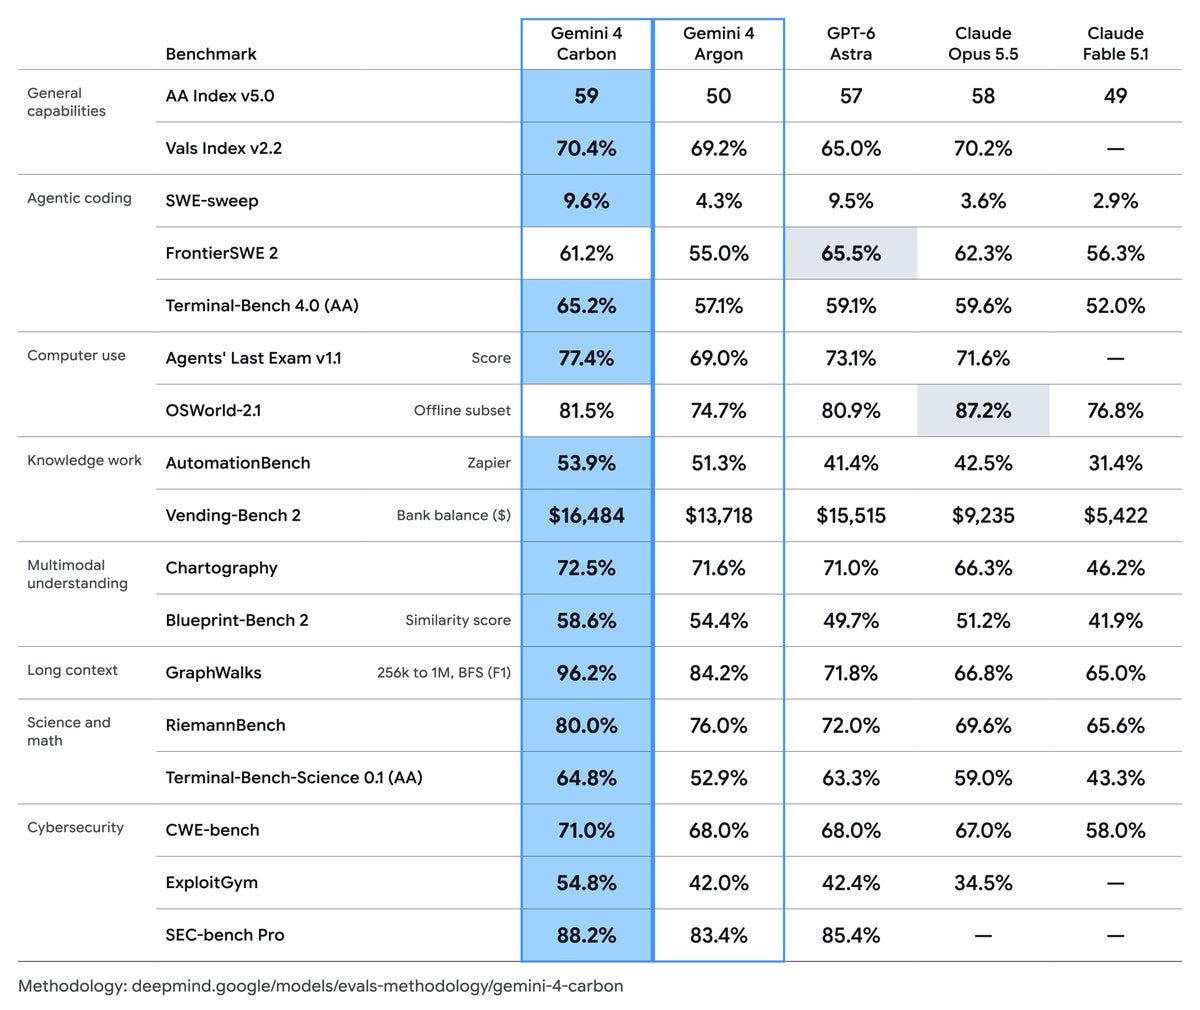
把时间尺度摆在一起看:模型排名按周变,同等智能成本按4到6个月掉10倍,公司采购和迁移按年走。错位就在这里。每季度重估一次模型组合,可能比追每一次发布更实际。完整片段在YouTube,show notes在ThursdAI。观点来自Alex Volkov的推文、Mert Gulsun与Artificial Analysis的访谈,以及Iris晴柔和Yurii Filipchuk的回复。
发布时间: 2026-11-02 06:32