训练和推理对不上,才是 post-training 最烦的活
Together AI 上线 Post-Training,把训练循环、rollout 引擎、权重同步和部署打包。你写奖励和 Python 循环,它处理 GPU 和一致性。官方图里把 serving 阶段的 token 一致圈了出来,这个细节比口号更有意思。
Together AI 上线 Post-Training 页面,核心一句话:训练和生成保持对齐,你设计的奖励信号是模型真正学到的,行为带到 serving。口号不新鲜,但把这句话做成产品,说明 post-training 的竞争点变了。

很多团队能把 RL loop 跑通。上线后模型行为漂移,奖励看着涨,服务端输出和训练时不一样。原因通常在细节:rollout engine 和 trainer 的数值精度、MoE 专家路由、旧版本样本、权重同步。官方页面把这些列在 Quality 里:trainer 匹配 generator 输出精度,在支持的 MoE 模型上重放专家选择,每个 RL loss 修正旧版本样本;坏 step 有 safeguard 停掉。这些是脏活。
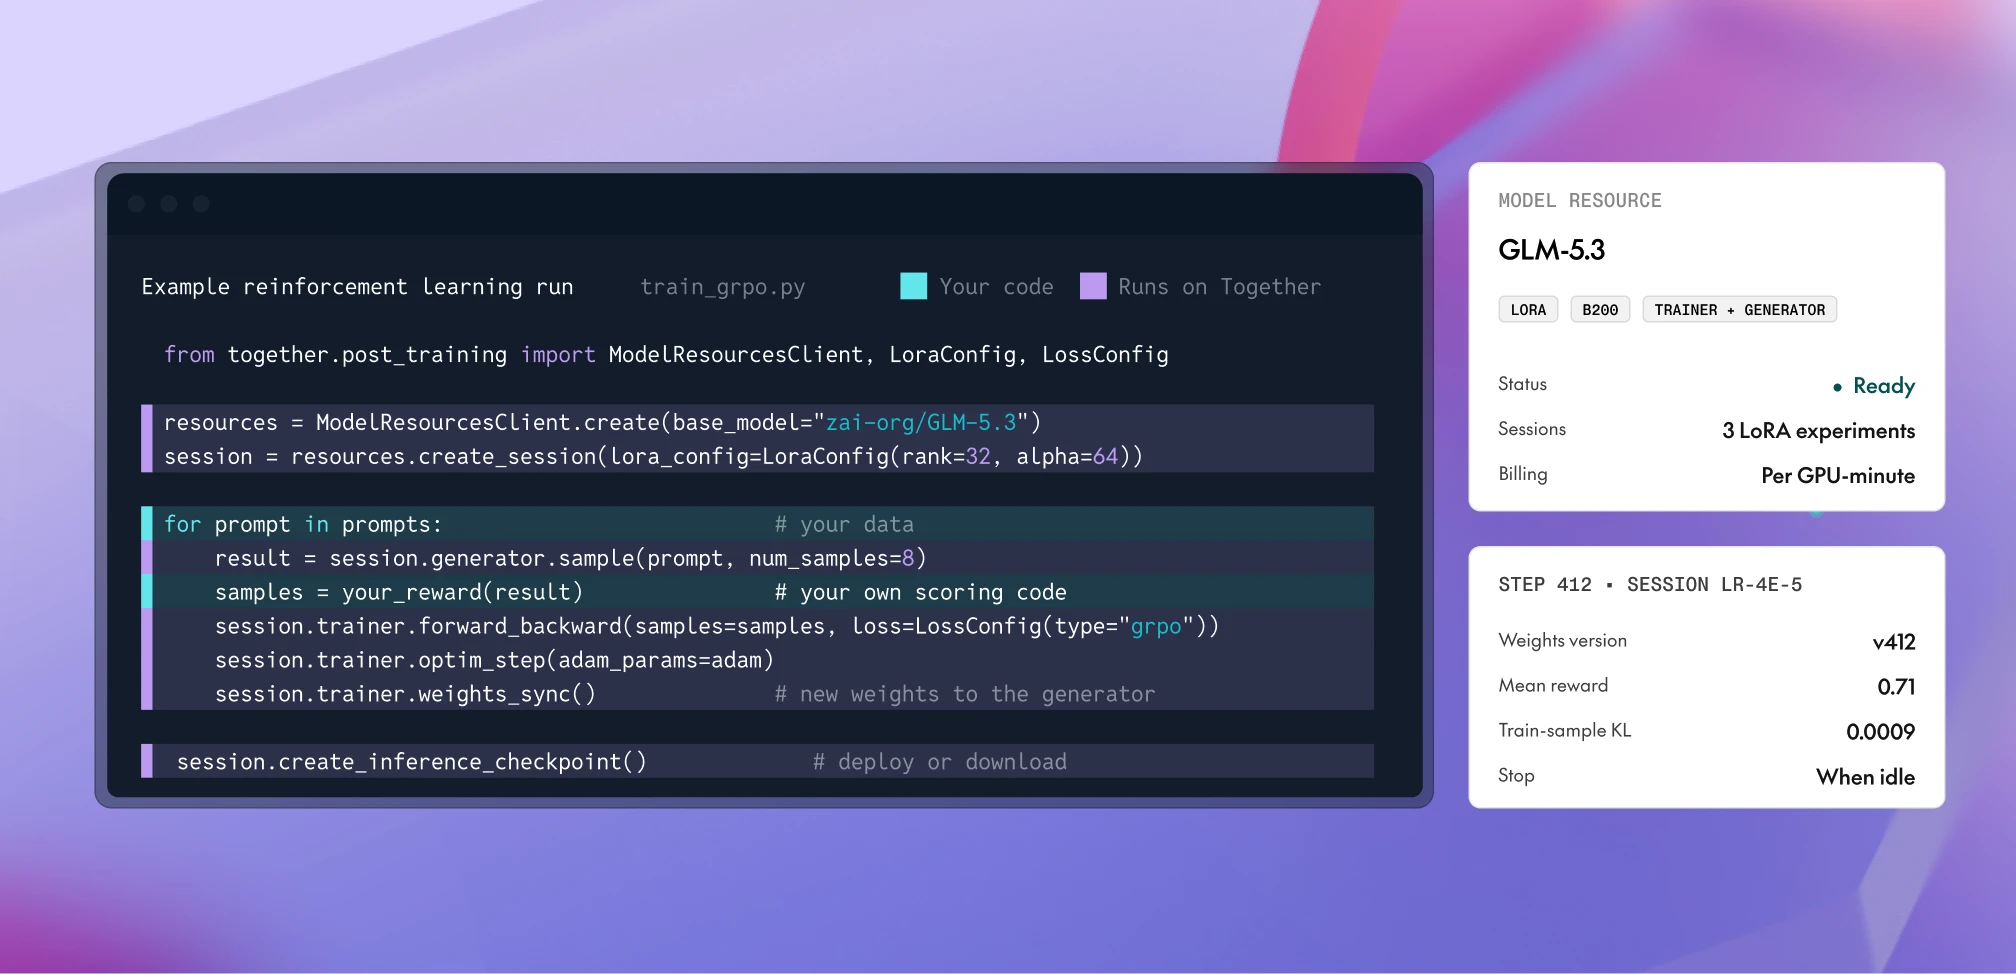
分工很清楚。你控制 recipe:数据、prompt、环境、reward、verifier、judge、GRPO 或 PPO 或自定义 loss、多 LoRA 或全权重、模型部署位置。Together 管按需或专用 GPU、训练和 rollout 一致性、并行配置、每个模型的 rollout 引擎、同步或异步训练。
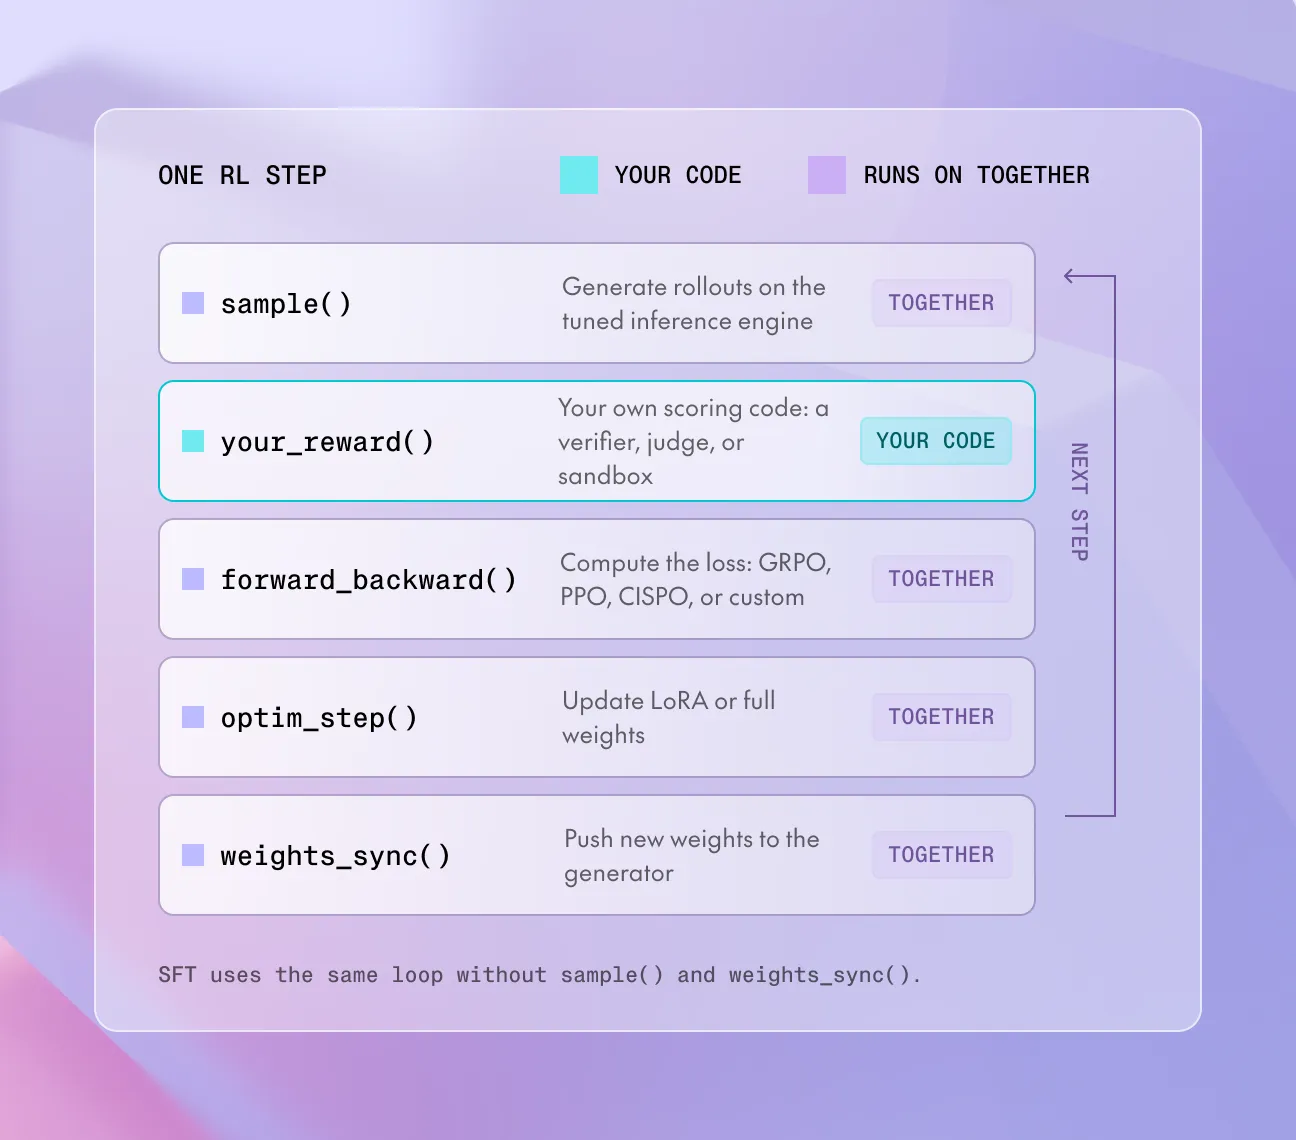
一个 RL step 在 Python 里是 sample()、your_reward()、forward_backward()、optim_step()、weights_sync()。SFT 用同一个 loop,去掉 sample() 和 weights_sync()。官方给了 Tinker-compatible 的 cookbook,链接在 这里。
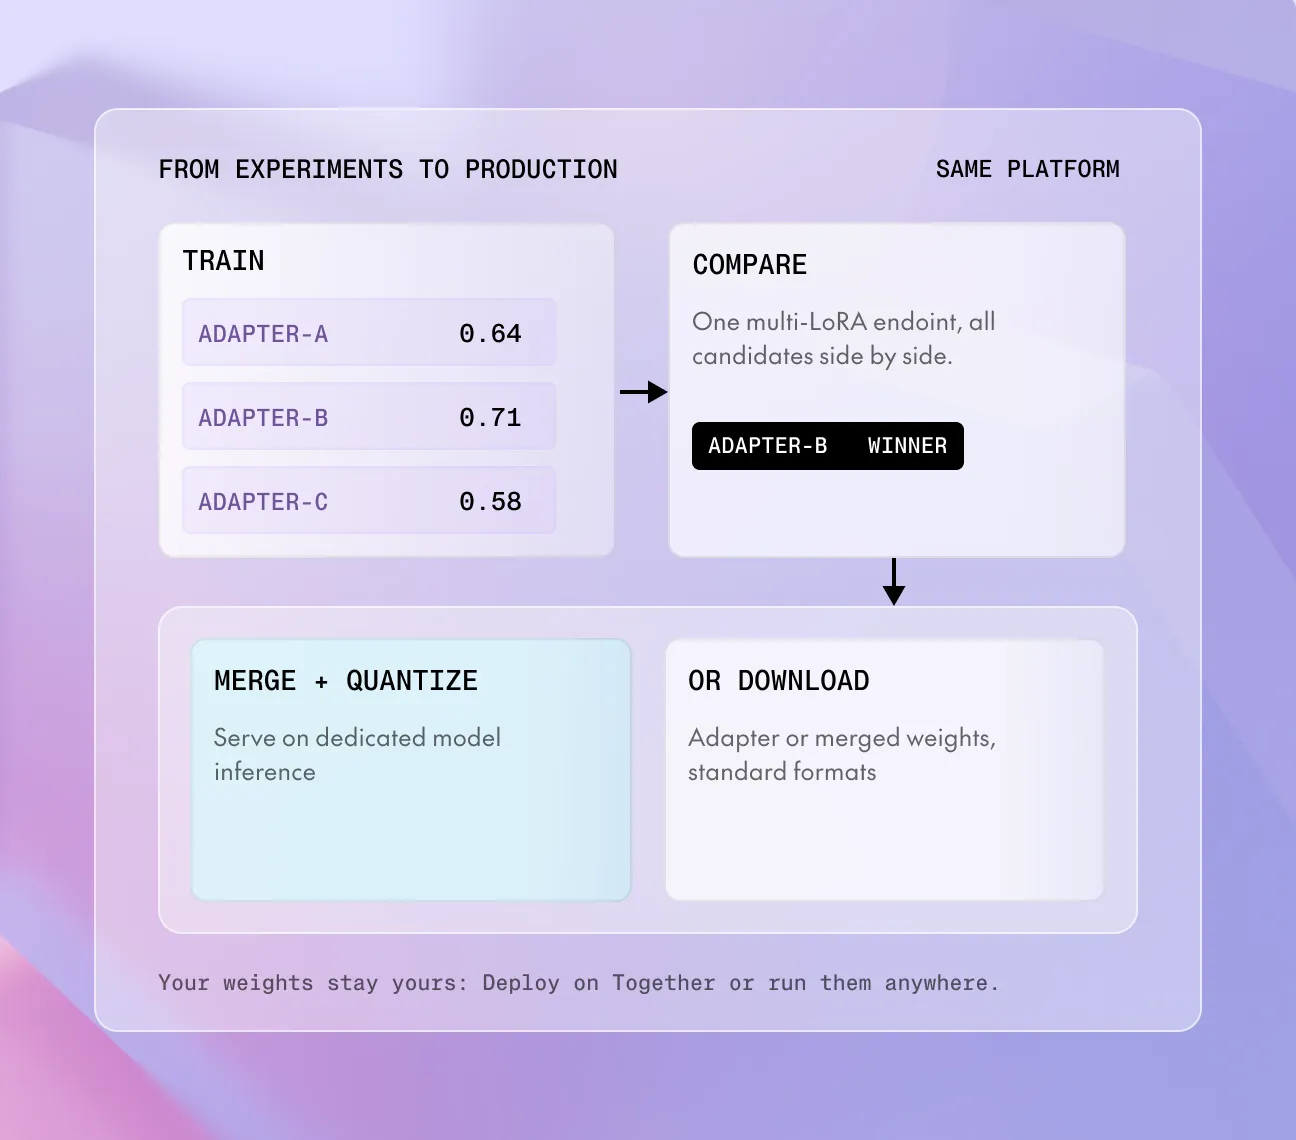
并行实验的做法是,一次调用预留模型需要的 GPU,setup 已经按模型测过。同一个 reservation 上给每个实验开 LoRA session,不额外收小时费,结果进你自己的 W&B。训练完保存 checkpoint,把 adapter 挂到一个多 LoRA endpoint 上并排比较,赢的部署到 dedicated endpoint,或者下载权重自己跑。
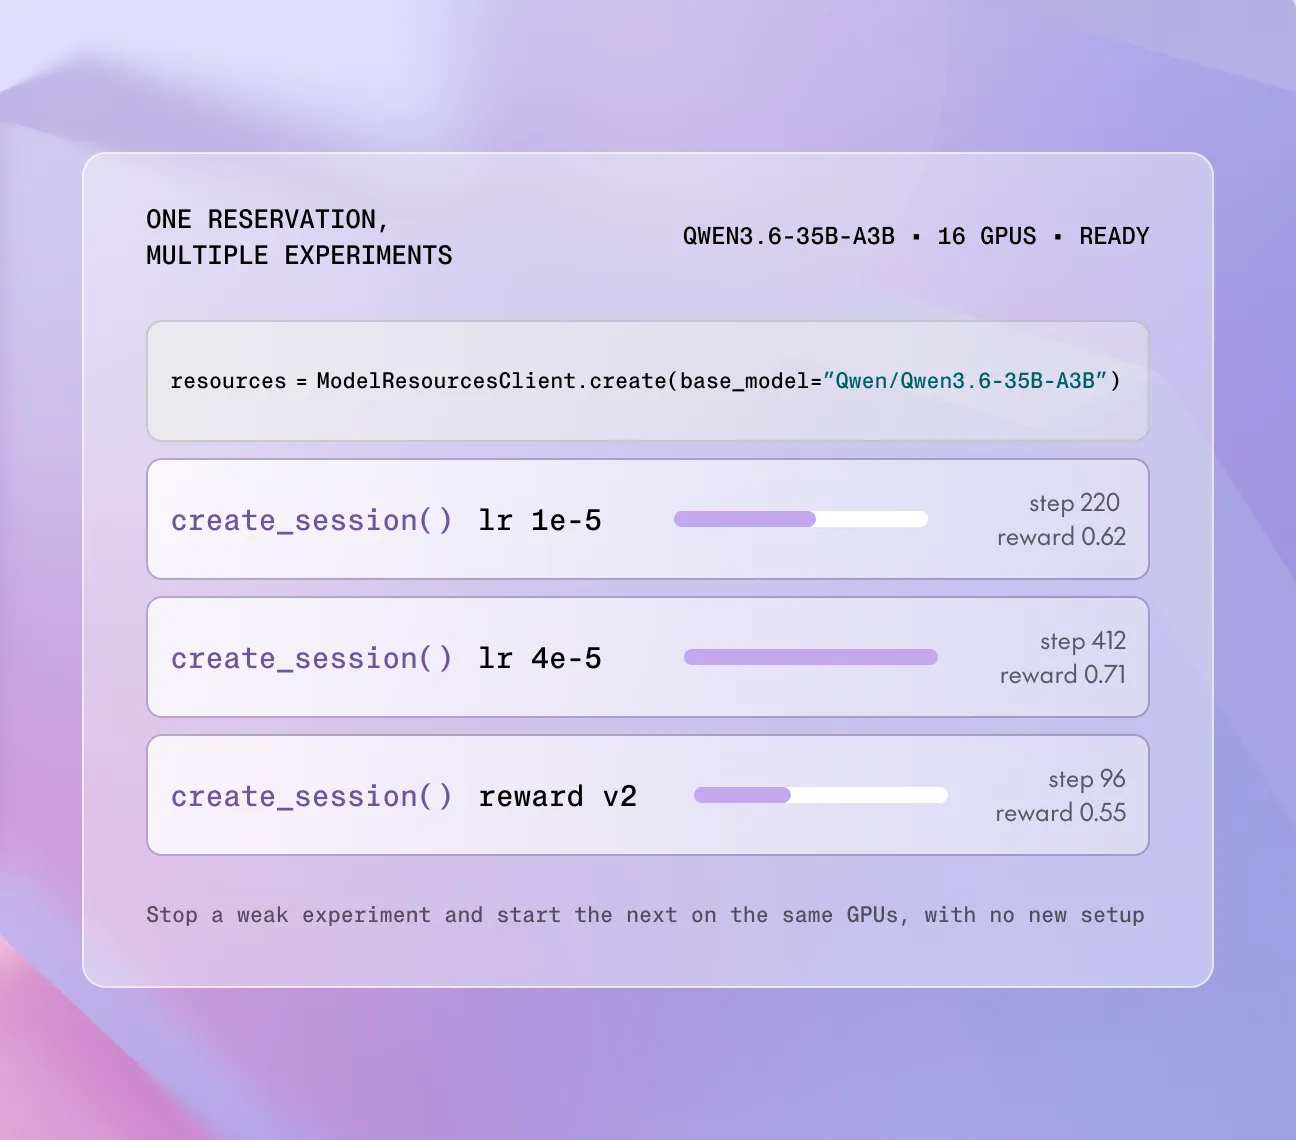
性能这块,官方提到预编译 GPU 执行、prefix caching、packed training、GPU 到 GPU 权重同步,以及 async 让生成和训练重叠。计费按 GPU 分钟,只在 model resource ready 时算,队列、启动、关闭免费,空闲一小时停。多 LoRA 实验共享一个 reservation,SFT 跳过 generator,都是把钱往训练里挪。
支持模型列表里有 GLM-5.3、Kimi K3、Qwen3.8 27B、Qwen3.6 35B A3B。FAQ 说 reward 和 environment 是你自己的代码,可以配任意 sandbox。多轮 agent 用 RL,每轮 Together 生成,工具调用在你的 sandbox,历史 turn 缓存在 GPU 上,新 turn 只处理新增 token。LoRA 省卡,full-weight 在 adapter 不够时上。同步 RL 先跑,step time 重要再切异步,loss 会修正落后一步的样本。
素材推文下有人追问:FP4 下怎么保持 token parity。官方图把 TRAINING、GENERATION、SERVING·FP4 三列 token 写成 identical,右上角圈了 IDENTICAL TOKENS,但页面没展开机制。这个追问比发布本身更值得看。post-training 工具都在说“你只管写 reward”,真正难的是训练和服务之间那点看不见的漂移。FP4 serving 会把问题放大。谁能把 token parity 讲清楚,谁的产品才更可信。
发布时间: 2026-11-02 07:35