Agent 上生产后,最贵的 bug 不在模型里
LangChain 社区 spotlight 推荐了 Soba Labs 的 Simon Budziak 的生产经验:两个已上线 Agent 系统靠五道控制活下来。显式状态机、每轮 trace、评估门、幂等副作用、低置信转人工。数据、代码和一次双重 CRM 写入都在文中。
LangChain 社区 spotlight 推了 Soba Labs 的 Simon Budziak 一篇文章,主题是 LangGraph Agent 上生产要用的五个控制。演示里跑通一个 Agent 可能一个下午就够,生产里一个超时就能写出两条 CRM 记录。

文章来自两个已上线系统:Open Loyalty 的 AI SDR,负责筛线索、答产品问题、把结果写进 CRM;Shen.ai 的患者教育助手,用获批医学知识解释体检结果。两个系统都用了 LangGraph 和 LangSmith。LangGraph 是低层编排框架,提供状态、检查点、中断、条件边这些原语,不自动把 Agent 变可靠。LangSmith 负责追踪和评估。Simon Budziak 的结论是,五道控制让系统活了下来。
先看一组背景数据。LangChain 的 State of Agent Engineering 调查了 1340 人,57.3% 已经在生产跑 Agent,30.4% 正在建。32% 把质量列为上生产的第一障碍, latency 是 20%。模型通常能给出答案,系统却没发现它答错。
控制一:把 Agent 写成显式状态机
生产 Agent 要按顺序调试,不能只看最后一句回答。Open Loyalty 的 AI SDR 把对话状态拆成介绍、资格判断、检索、销售简报、CRM 写入等阶段,状态有类型,条件边可读。
class SDRState(MessagesState):
    lead_id: str
    lead: dict
    score: int
    next_action: str
    kb_context: list[Document]
    thread_id: str

graph = StateGraph(SDRState)
graph.add_edge("intro", "qualify")
graph.add_conditional_edges("qualify", needs_product_qa)
graph.add_edge("retrieve_kb", "sales_brief")
graph.add_edge("sales_brief", "crm_write")
graph.add_edge("crm_write", END)
线索路由错了,状态能指出哪个阶段做的判断,检索返回了什么,哪个工具产生了副作用。prompt 循环能回答 Agent 说了什么,显式图能回答 Agent 做了什么、按什么顺序、用了哪些输入。生产事故问的正是后者。
控制二:每一轮生产对话都留 trace
不能回放的故障很难修。LangSmith 给两个系统留下每段对话的端到端记录,包含模型调用、工具调用、输入输出、延迟、prompt 版本和运行元数据。一个 run ID 就能查清某次行为由哪个 prompt 产生,工具调用是首次还是重试。
同一份调查里,89% 的组织上了某种 Agent 可观测性,62% 的 tracing 细到能看单步和工具调用。差距在于行动。没有 trace,检索失败和 CRM 失败看起来都像模型当天状态差。Open Loyalty 两个重要 bug 都是在 trace 里找到的,不在对话记录里。
控制三:每次改动都过评估门
Open Loyalty 用真实对话建了一个小评估集,覆盖定价问题、异议、模糊意图、缺失字段。prompt、模型、检索设置、工具 schema 每次有意义的改动,都跑同一套评估,检查四件事:路由对不对,必需字段有没有抽出来,回答有没有落在获批材料里,有没有不安全或重复的副作用。
这会把一场关于单条对话的争论变成回归测试。生产故障也会回流:团队分类真实错误,把最好的例子加进评估集。行业实践在这块落后,89% 有可观测性,52.4% 跑离线评估,37.3% 跑在线评估。有 trace 没有评估门,Agent 能看见自己退化,然后照样发布。
控制四:每个副作用都做幂等
Open Loyalty 最难看的 bug 不在最终回复里。少量对话产生了两次 CRM 更新。trace 显示:一次 CRM 写入超时,Agent 重试,第二次成功,第一次随后也完成了。一段对话,两条写入。
修法是幂等工具调用边界,不是更好的 prompt。
crm_write.invoke({
    "lead_id": state["lead_id"],
    "payload": payload,
    "idempotency_key": f"{thread_id}:{turn_id}",
})
每次写入带上对话和轮次生成的幂等键,模型重试和工具重试分开决策,评估集加入模拟超时用例,断言每轮只更新一次线索。LangGraph 的中断文档也把这条规则说清楚了:暂停的图恢复时,节点从头重启,interrupt 前的代码会再跑一遍,所以那个位置的副作用必须幂等。任何碰钱、邮件、CRM 的节点都该有键,重试逻辑要假设调用可能已经发生过。
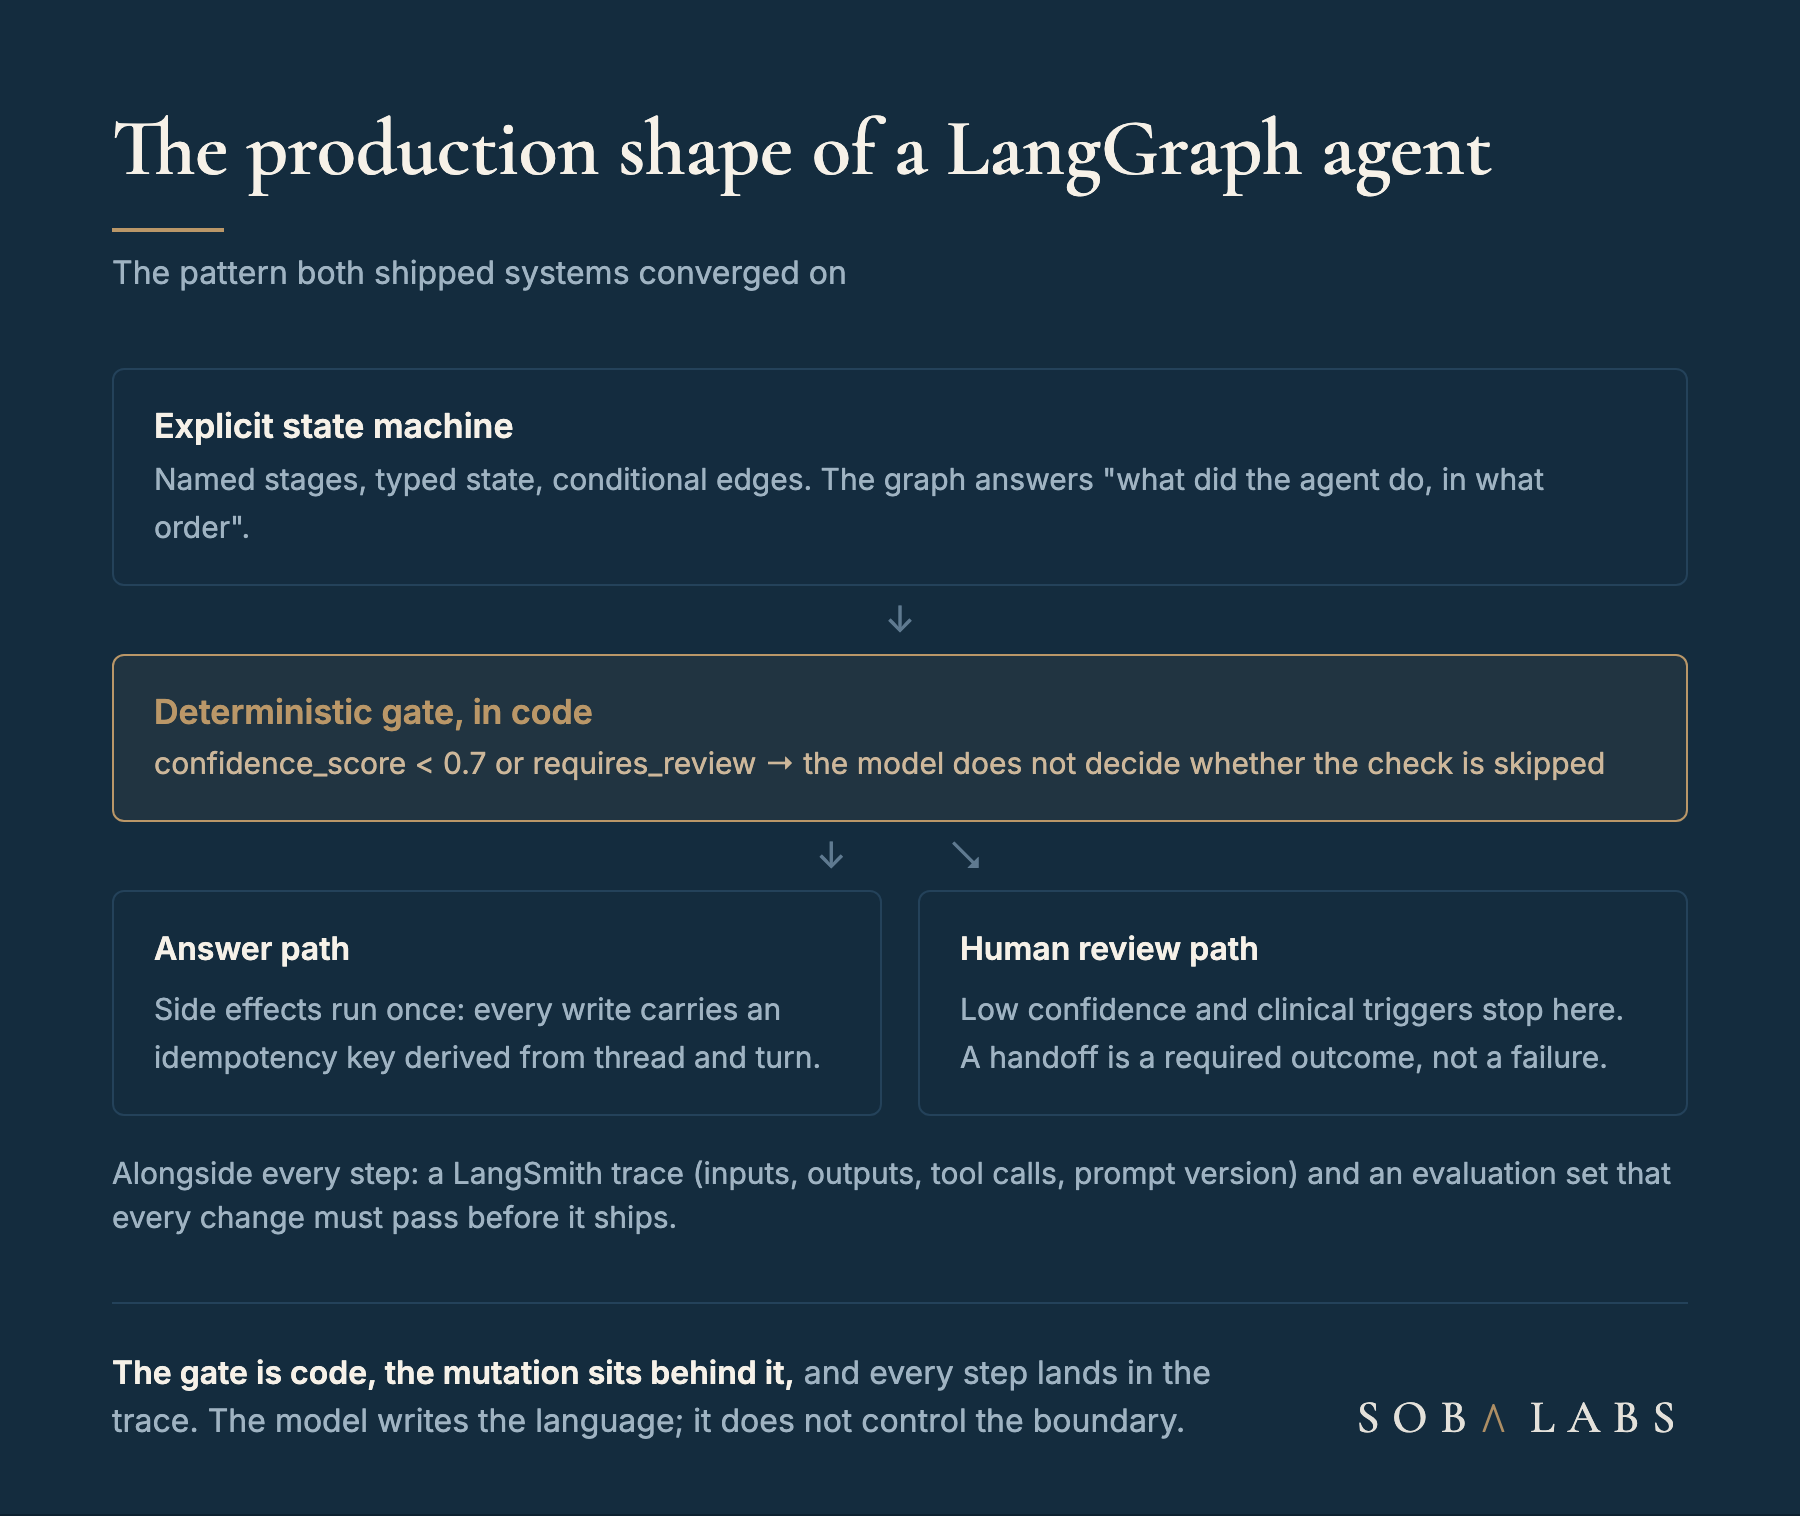
控制五:低置信路由到人,写在代码里
Shen.ai 的患者教育助手里,自信但无依据的解释是安全问题。问题走普通回答路径还是进临床医生审核,决定写在代码里,不写在 prompt 里。
def should_route_to_human(state: PatientEducationState) -> str:
    if state["confidence_score"] < 0.7 or state["requires_review"]:
        return "human_review"
    return "education_module"

graph.add_conditional_edges("retrieve_kb", should_route_to_human)
置信门让不确定性成为系统状态:低置信检索到不了回答节点,对话进入人工审核。Shen.ai 调优后的数字是,约 15% 对话进入人工审核,临床医生判断其中约 80% 的升级合适,阈值从 0.8 降到 0.7 后,不必要审核减少约 40%。这些数字只描述那个系统的调优期,不代表通用基准。模式可迁移到任何答错成本高于转人工成本的领域。
评论区有读者 MASA 追问,怎么审计那些漏过置信门的对话。原帖没有展开这个问题。它比阈值本身更难,也值得单独记下。prompt 让模型谨慎,定义不了系统什么时候必须停。条件边可以。
底下还需要持久检查点
五道控制都假设状态能活下来。等人审核的门只有暂停持久才有用,所以两个系统都把检查点写进 PostgreSQL。LangGraph 持久化文档建议生产用 PostgresSaver 这类数据库检查点,按稳定的 thread_id 编译进图。
from langgraph.checkpoint.postgres import PostgresSaver

with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
    graph = builder.compile(checkpointer=checkpointer)
Shen.ai 的患者离开再回来,安全控制依赖的状态不会丢。检查点有三种持久化模式:exit、async、sync,在性能和运行中崩溃恢复之间取舍。长而贵的运行不能丢,就用 sync。
案例不止两个。Freedman International 的营销本地化流水线也用了类似控制,追踪跑在 Langfuse 上,不在 LangSmith。这说明控制点是 trace、门、幂等边界和人工路由,供应商可以换。
五个控制可以压成五句话:把工作流写成显式状态机;每轮都 trace;每次改动都用真实对话建的评估集把关;每个副作用都给幂等键;不确定就通过条件边转给人。LangGraph 被 Klarna、Uber、J.P. Morgan 这类公司用于生产,理由在可检查、可治理,不在让 Agent 变聪明。
原文链接:https://sobalabs.ai/blog/langgraph-agents-in-production/
发布时间: 2026-11-02 07:37