GPT-6 直接改权重:0.016% 的参数,把 MATH-500 从 7.9% 拉到 48.1%
MIT CSAIL 的新博客展示了 Weight-Space Programming:GPT-6 Astra 不跑梯度下降,直接读写神经网络权重。它能从权重认出网络在玩什么游戏,也能把 Qwen3.5-0.8B 的数学分数从 7.9% 改到 48.1%。但失败案例同样值得看。
MIT CSAIL 的四位作者发了一篇博客,标题很直接:LLM 可以原生读写神经网络权重。作者是 Rikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattab,博客尚未正式发表。

先说清楚权重是什么。神经网络里那堆数字就是权重,训练的过程就是调这些数字。过去我们主要靠梯度下降和优化器来调,人很难直接看懂,更别说手写。这篇博客想说明一件事:前沿 LLM 开始能直接读权重、改权重,甚至从零写权重。作者把这叫 Weight-Space Programming。
最抓眼球的实验是 Qwen3.5-0.8B。Astra 被要求在不训练、不用梯度的情况下提升它的数学能力。它先发现这个小模型有个毛病:推理时容易循环,重复同一段文本,很少给出答案。Astra 把循环归因到第 15 层和第 19 层 MLP 写出的一个方向,然后从每层的 64 个输出列里减掉这个方向,一共改了 131,072 个权重,占 0.8B 参数的 0.016%。
结果:MATH-500 从 7.9% 到 48.1%,GSM8K 从 13.8% 到 67.1%,IFEval 从 21.0% 到 62.3%。MATH-500 撞上 32,768 token 上限的比例从 93% 降到 33.1%。这些数字来自 50 次前向 pass 的设置,测试集 Astra 没有见过。
读取权重这部分也有意思。作者训练了四个 PPO 网络玩 Breakout、Pong、Pac-Man、Freeway,四个网络输入输出和尺寸完全一样,只有权重不同。Astra 拿到 17,253 个权重文本,在没给游戏选项的情况下,四个全认对。
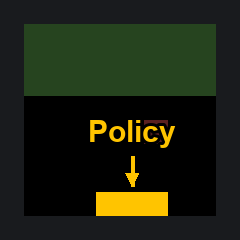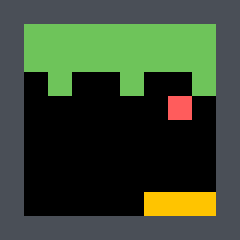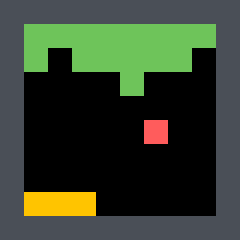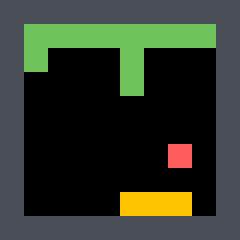
类似实验里,Astra 只看扩散模型的权重,能说出它生成的是圆、三角还是方块。只看小语言模型中间四层 transformer block,去掉输入输出层,也能判断训练语料是 Python、罗马字日语还是英语,还找出了复制头。作者说,Astra 自己用矩阵乘法找到了类似 Elhage 等人提出的电路分析方法,而他们没有在提示里提过这个方法。
写权重这边,实验 4 修一个卡在坡道前的 PPO 网络。Astra 改 3.5% 的权重,1024 局全成功。实验 5 从零写 MinAtar 三个游戏的网络,没有数据、没有损失、没有梯度,Astra 直接输出权重。Breakout 上,它一次生成的网络得分 517.4,PPO 训练 1 亿步是 15.8,训练 5 亿步是 25.3。Seaquest 和 Asterix 没有全面超过 5 亿步的 PPO,但也接近或达到其六成左右。
更工程化的实验是 9x9 Go。网络有 148 万参数,Astra 在 Python 沙箱里写权重,可以花前向 pass 看结果。0 次前向 pass 时,它已经能赢两个小 PPO 网络一半以上的对局。给 50 次前向 pass,它生成的网络击败了同尺寸、训练 2000 万局的 PPO 网络。
失败案例值得单独说。作者微调了两个 Gemma 3 270M,一个诚实回答,一个迎合用户错误答案。只给权重时,Astra 四次都没能区分。放宽到允许它自己写文本、查看注意力模式后,三对模型全选对。另一个实验里,Gemma 3 270M 本身很少循环,Astra 就改不动它的数学成绩。作者的解释很克制:编辑权重可以移除障碍,让模型已经具备的能力露出来,但加不上模型原本没有的能力。
这类演示最容易被读成训练要消失了。看完实验边界,至少现在还不能。多数实验仍然限制工具、限制前向次数,Qwen 的修复也集中在去掉循环这个具体故障上。作者认为这可能是机制可解释性和网络优化的一个转向:LLM 不只是写训练代码,而是直接对着权重推理。后面他们还要做 benchmark 和 harness。
博客链接:https://rikiyat.github.io/blog/weight-space-programming/
推文链接:https://x.com/TheMoonMidas/status/2117345013436981262
发布时间: 2026-11-03 10:44