OpenAI 没换掉 Git,而是把 Git 后端拆了重做
Pando 把 push 延迟砍掉约 80%,每天扛近 PB Git 数据。更值得看的是 OpenAI 为了不改开发者习惯,付出了什么代价。
OpenAI 的 monorepo 最近遇到一个很具体的问题:Codex 让工程师和 agent 并行开分支、push、merge、clone 的次数涨得太快,旧 Git 服务跟不上。博客里给了一个数字,可靠性一度掉到 90% 以下。
他们没让工程师换一套版本控制。Greg Brockman 在推上说,Pando 是一个能撑住超大 monorepo 的 Git 后端,继续用 Git 是硬路,好处是开发者体验不用变。OpenAI Developers 补了结果:push 延迟降约 80%,每天服务近 PB Git 数据。
Pando 的位置可以这样理解:工程师和 agent 还是执行 git push、git fetch,客户端协议不变;变的是服务端怎么存 packfile、怎么更新 ref、怎么规划一次 fetch。
先放弃一个默认假设
传统 Git 服务通常保两件事:仓库级一致性和为每个客户端生成合适 packfile。Pando 把这两件事都放松了。
它给每个分支独立更新。不同分支可以并行 push;同一个分支仍然按顺序。读的时候,如果一次 fetch 看多个分支,可能看到不同时间点。这被 OpenAI 称为 causal consistency。对人和 agent 来说,通常只关心单个 ref 的顺序,跨分支全局快照不是刚需。

这个取舍很关键。要仓库级一致,所有 ref 更新就得在一个协调点上排队。Pando 把协调范围缩到单个 ref,写入就能水平扩。
读性能靠复用 packfile
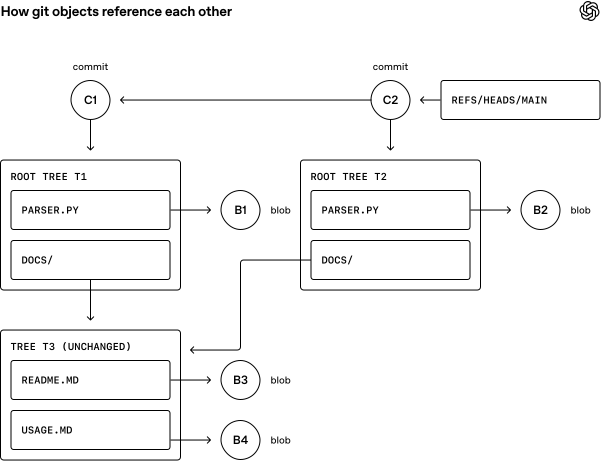
fetch 时,客户端告诉 Pando 自己有哪些 commit、想要哪些 commit。Pando 把 haves 和 wants 映射到 ref version,再选出覆盖缺口的已存 packfile,返回链接。客户端可能下载一些自己已经有的 object,但服务器可以把同一批字节复用于很多读者。这是拿一点带宽换 CDN 式缓存。
Git 协议原本只允许 HTTP 响应里带一个 packfile,Pando 用 packfile-uri 返回额外 pack 链接,inline 发一个空 pack。OpenAI 还向 Git 上游提交了 packfile-uri 下载追踪、并发下载、索引、断点续传和 explicit haves 等改进。
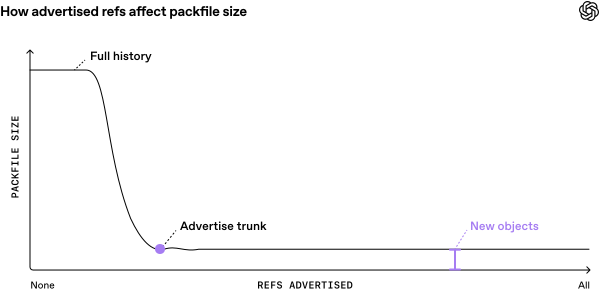
push 侧也有反直觉设计:Pando 默认只向客户端广告一个 trunk ref。广告的 ref 越多,客户端越能排除服务器已有 object,pack 越小;但 pack 越依赖服务器广告的那组 ref,越难复用。Pando 只广告 trunk,让 feature branch 的 pack 能被任何已有 trunk 历史的读者直接复用。代价是连续 push 同一分支时客户端会重发一些 object。OpenAI 说他们 monorepo 里这样产生的 packfile 中位数小于 20 KiB,99 分位小于 3 MiB,这个代价可接受。
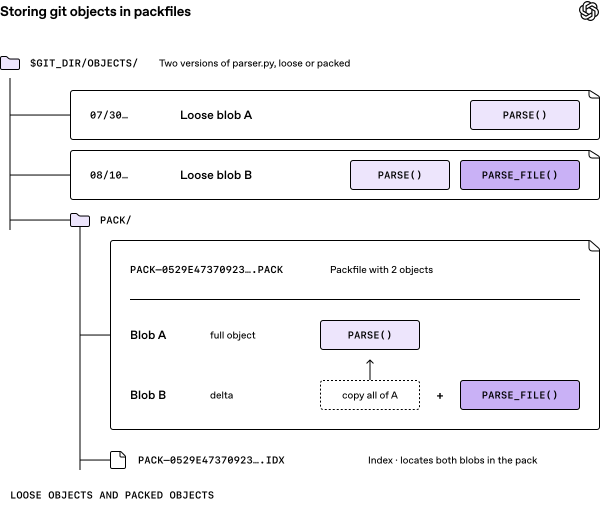
后台 compaction 类似 LSM:每次 push 产生 L0 pack,后台把 pack 合成更大的 cover,最多到 L4。cover 既提高压缩率,也像 skip list 一样加速 fetch planning。与传统 Git 服务不同,Pando 不丢弃低层级 pack,所有层级都继续服务读请求。
工程实现和结果
Pando 用 Rust 写,无 legacy 依赖。OpenAI 说从 kickoff 到生产 10 周,核心由一位工程师设计,agent 团队实现,少量工程师部署。他们用 Codex 和 GPT-6 Astra 写 Lean、TLA+ 形式化 Pando 理论,跑长时间 agent 会话找边界条件,还让 agent 红队 Git 和 Pando。
部署方式是先做 read/write-through proxy,把 Pando 和旧系统同步,再逐个迁移工作负载。结果:median push latency 降近 5 倍,merge 可靠性提升;Pando 用少量 CPU 核每天送近 PB Git 数据,单小时超过 57 TB Git pack,99% 以上字节来自本地磁盘缓存。
真正值得看的是什么
不换 Git 不是保守。所有 coding agent 已经会说 Git,换 VCS 要重新教人、教 agent、改 CI、改 sandbox、改代码审查和自动化。Pando 把复杂度压到后端,前端保持 git push、git fetch,这是给 agent 时代省迁移成本。
另一个变化是基础设施 sizing。人一天 push 几次,agent 可能每个任务都 clone/fetch 整个仓库。Git、CI、sandbox 会比模型更早撞墙。有网友在推下说,agents are going to break a lot of dev infra that was sized for humans。这个判断不新,但 Pando 把它变成了可运行的系统。
推文下高频问题集中在:Pando 会不会开源,能不能单仓试用,是否支持 partial clone 和 sparse checkout,agent 流量占比多少。Greg Brockman 只说在考虑提供给其他人,感兴趣可以发邮件 gdb@openai.com。OpenAI 博客说在探索把 Pando 技术分享给用户。公开信息没有给出开源时间表。
有网友问,hard road 是 Git,easy road 是不是 jj。也有人觉得保留 plain Git 是对的,因为每个 coding agent 已经会说 Git。还有网友调侃 GitHub 在冒汗。这些反应里最有价值的一条是:OpenAI 如果真把 Pando 开放,卖的就不只是模型,还有 agent-heavy 团队的底层管道。
Pando 不是没有代价。它牺牲仓库级全局一致性,换取分支级并行写入和跨读者 packfile 复用。对 OpenAI 这种超大 monorepo、agent 高并发、跨地域读的场景,这笔账算得过来。对需要跨分支强一致快照的团队,未必。
OpenAI 官方博客:https://openai.com/index/scaling-git-at-openai
Greg Brockman 推文:https://x.com/gdb/status/2117435285021810921
发布时间: 2026-11-03 19:43