Qwen 本地控制机器人拿到 31.39:uni-robot-agent 把推理和动作接上了
OpenRUA 发布 uni-robot-agent,用统一工具接口把 Qwen、GPT、Claude 接到仿真和真实机器人。Qwen3.8-Flash-Next 在 RoboDojo 从 1.90 到 31.39,真实机器人 53.50,成本约 1/20。但同一 harness 下 Astra 仍得 51.90,深度、校准和技能库的影响比参数大小更值得看。
OpenRUA 团队发布 uni-robot-agent。它让 Qwen3.8-Flash-Next 在本地运行并控制机器人。RoboDojo 上,分数从 1.90 升到 31.39,超过 RoboDojo 团队公布的 GPT-6 Astra + RoboProbe 的 28.97。真实机器人测试里,Qwen 零样本 53.50,比每项任务用 10 小时遥操作数据微调的 π0.5 高 5.75 分,比零样本 Dream-1 高 10 分。
先别读成开源模型全面超过闭源模型。同一个 harness 下,GPT-6 Astra 在 RoboDojo 拿到 51.90,真实机器人 80.50。Qwen 的真实机器人分数用了 Intel RealSense D405 深度,π0.5 和 Dream-1 只用 RGB。对比口径要摆出来。

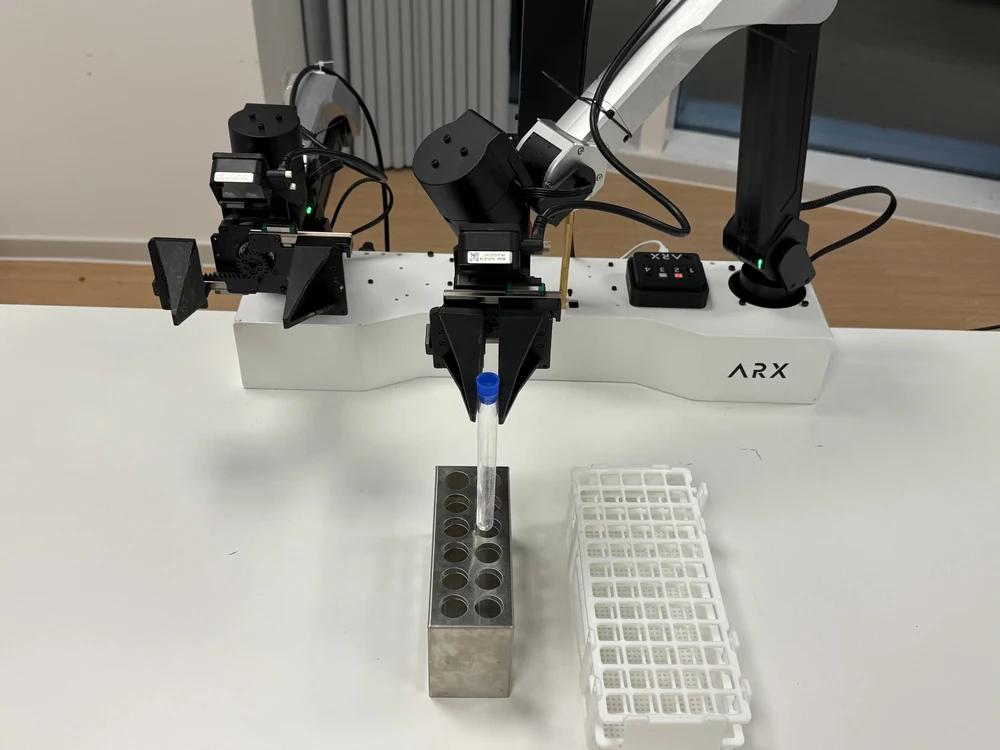
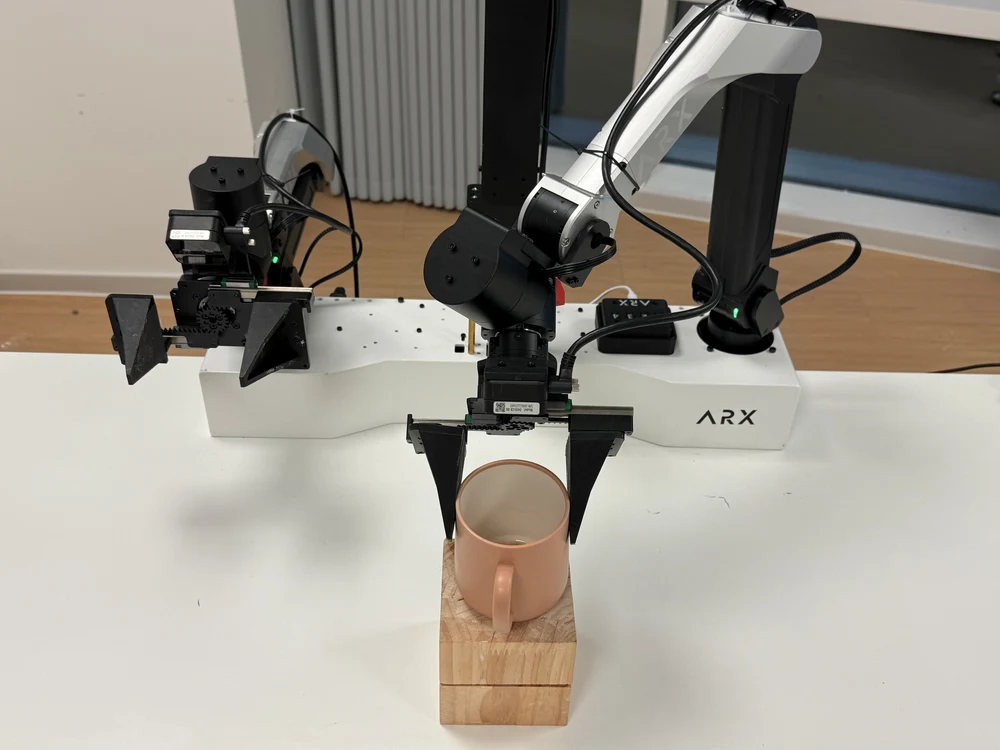
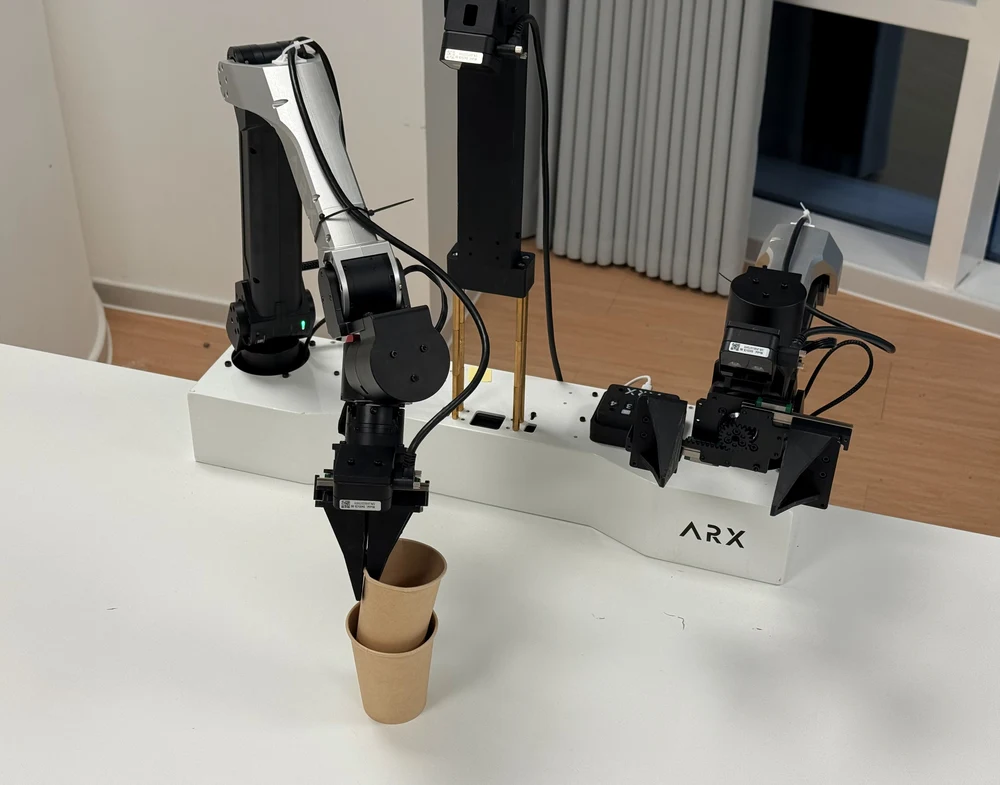
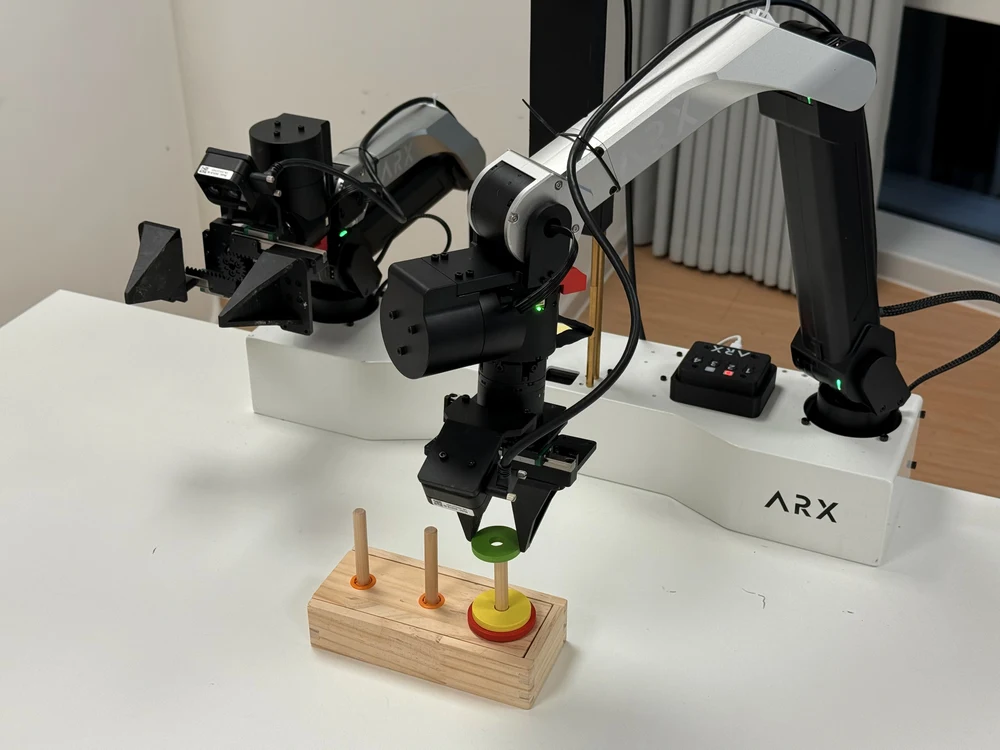
这套东西解决什么痛点。harness 可以理解为机器人代理的运行框架。它把模型侧的动作拆成感知、运动、技能、结束任务四类工具,再用共享参数、单位、反馈格式接到 RoboDojo、Libero、RoboLab 和 ARX X5、Franka、Sharpa 这些后端。换环境时写适配器,不用把每个工具重写一遍。轨迹记录统一成观察、调用工具、反馈三件事,方便后续收集训练数据。系统架构分五层:agent、orchestration、tools、services、backends。模型调用共享工具,环境适配器执行动作并返回证据,下一步决策再基于这些证据继续。

结果先看两套口径
RoboDojo 有 42 个任务,五个维度:泛化、精度、长程、记忆、开放词汇。Qwen 主结果跑 252 episodes,Score 31.39,成功率 25.00%。Astra 用同一 harness 跑出 51.90 / 46.67%。DeepSeek-V4.1-Flash 是 27.11 / 21.39%。Qwen 用 GAP Hybrid 的基线是 21.01 / 16.11%。
真实机器人测试有 19 项,五个维度各 20 分。Astra 80.50,Qwen 53.50,微调 π0.5 47.75,零样本 Dream-1 43.50。未见任务仍然是硬骨头,Astra 和 Qwen 都只拿到 8 / 20。


更大的模型不一定更会开机器人
团队测了 13 个模型。Qwen3.5 到 3.7 的 Flash、Plus 在 42 个任务上成功率是 0,Qwen3.6 Plus 的 Score 只有 0.38。到 Qwen3.8-27B,成功率 8.06%,Score 9.61。Qwen3.8-Flash-Next 是 25.00% / 31.39。GLM-5.3-Flash 加了深度,成功率仍是 0。
GPT 系列里,GPT-5.6 Sol 是 19.17% / 24.04,GPT-6.1 Sol 是 37.50% / 45.63,GPT-6 Astra 是 46.67% / 51.90。机器人使用能力在更早的 GPT 模型里已经出现,只是最新一代把分数拉高。Qwen 这边,能力在 3.8 才跨过某个门槛。团队没有把原因归给参数规模,他们更怀疑训练分布的变化。
失败模式被拆成四类:看错物体和动作结果、跨视角定位失败、几何代码写错、抓取姿势不合理。前代 Qwen 的几何计算错误率在 47.3% 到 81.8%,Qwen3.8-Flash 降到 8.2%,DeepSeek 1.5%,GPT-5.6 0.7%,GPT-6.1 为 0。空间定位仍然难,GPT-6.1 有 31.5% 的三角化调用被检查拒绝。


四个通用能力和机器人使用表现正相关:ERQA 的 Pearson r 是 0.97,MMMU-Pro 0.93,ScreenSpot-Pro 0.69,LiveCodeBench v6 0.75。相关性不是因果,但它说明会看、会定位、会算、会把决定写成代码,可能一起决定机器人使用能力。
信息给得对不对,比模型大小更直接
主评估不给模拟器深度,也不给任务验证器反馈。Qwen 有深度时 Score 35.89,有校准无深度 31.39,连校准也去掉只剩 9.13。Astra 对应 55.83、55.04、31.29。深度和校准不是装饰,它们决定模型能不能把图像里的点变成世界里的坐标。
技能库也被单独拿掉测试。关掉机器人技能库和写新技能的能力后,Qwen 仍有 30.31,保留 96.6% 的分数。技能有帮助,但不是唯一支撑。清晰任务说明、环境描述、标准工具和可检查反馈仍然在起作用。


成本和速度要分开看
Qwen 每个 episode 约 1.09 美元,Astra 21.29 美元,约 1/20。Qwen 平均 37.7M tokens,Astra 16.8M,DeepSeek 48.8M。到 Score 25,Astra 用 7.4M tokens 和 42.6 分钟,Qwen 用 23.5M tokens 和 95.5 分钟,DeepSeek 用 49.9M tokens 和 99.2 分钟。token 省不等于墙钟快。
执行调度上,pipelining 让模型在机器人运动时继续推理。五个任务里,episode 时长缩短 4.8% 到 73.7%。换 T 块是 12.5 分钟对 34.7 分钟,按编号按钮是 13.7 分钟对 25.0 分钟。这个对比只说明观察到的缩短,不能把全部差异都归给调度。


uni-robot-agent 的第一价值不在单次分数。它把模型、工具、环境、反馈拆成可替换的接口,让开放权重模型可以在本地部署,也让后续训练有统一的经验格式。精确操作、长程执行、未见任务仍然是硬骨头。评论区有人问,喂给 Qwen 的是原始相机帧,还是独立感知模型生成的文本场景描述。素材没有给出回答。这个问题值得追,它决定这套 harness 的感知边界在哪里。
发布时间: 2026-11-04 03:39