上下文压到 8K,Opus 4.5 分数没掉,但开源模型会崩
NVIDIA 论文测频繁 compaction:Opus 4.5 在 SWE-bench Verified 上 70.2 对 70.0,峰值上下文 32K 降到 8K;简单压缩还到 74.8。但 Qwen 3 Coder Next 在最紧压缩下从 53.0% 掉到 3.6%,别照抄。
NVIDIA 放了一篇论文,标题很直:You don't need long context。作者 Peter Belcak、Pavlo Molchanov 等,arXiv:2611.05306。Elvis 在推文里高度推荐,并贴了几组数字。

论文讨论 agent 该不该频繁 compaction。做法不复杂:每一步不背完整 transcript,只带一份短状态摘要。DAIR.AI 的论文页把结论拆成五点,核心是短上下文没有把长任务做崩。
数据先看。Claude Opus 4.5 每步最多一个 action,SWE-bench Verified 拿到 70.2,全历史基线 70.0。median peak context 从 32K tokens 降到 8K。更简单的情况:对话结束时做一次 compaction,Opus 4.5 从 70.0 到 74.8。上下文短了,分数没掉,还涨了。
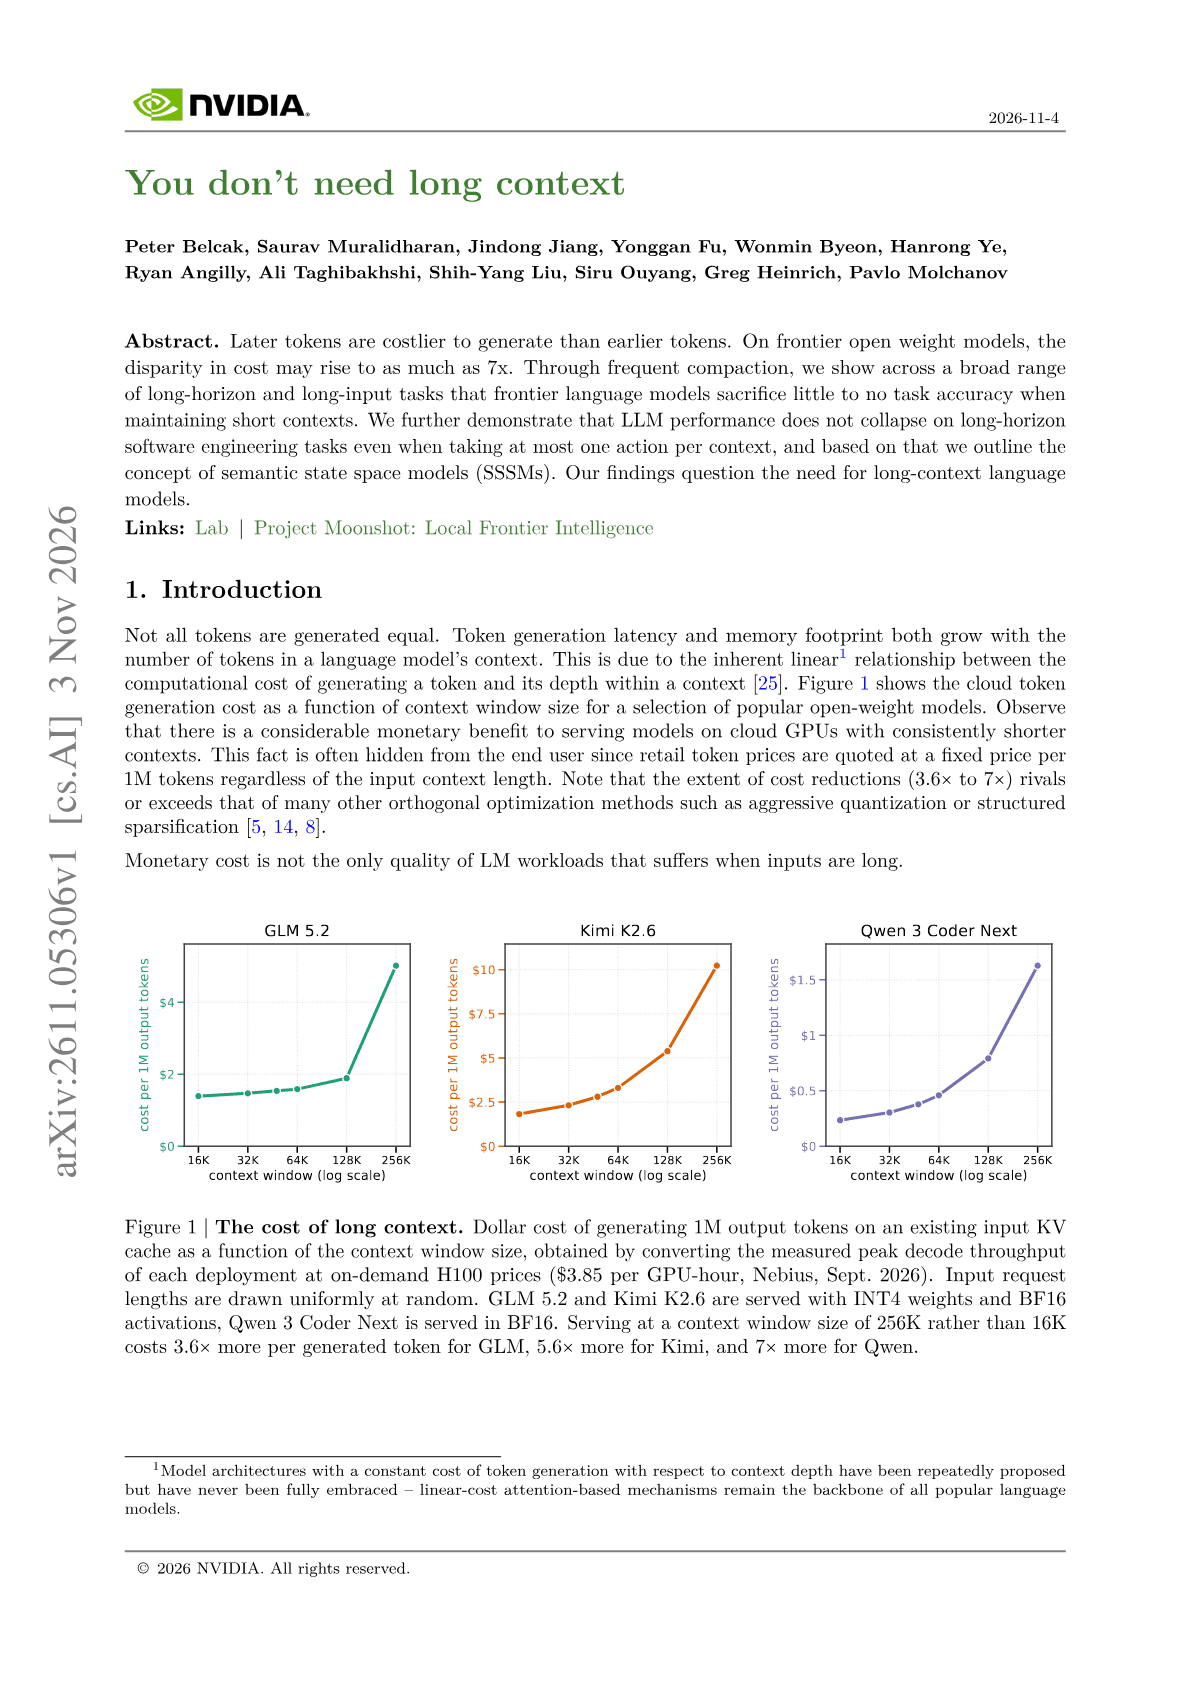
成本账也清楚。论文说 later tokens 生成成本更高,frontier open-weight 模型上差距最高到 7x。debugmodeon 补了机制:每个 decode step 都要读整个 KV cache,上下文越短,每个 token 越便宜,同一块 GPU 也能塞更多 agent run。70.2 对 70.0,峰值上下文只有四分之一,这笔交易不差。
但标题容易让人误解。论文没有说所有模型都能随便压。J.W 指出,最紧压缩下 Qwen 3 Coder Next 从 53.0% 掉到 3.6%。论文也在 Terminal-Bench、FRAMES、BFCLv3、multilingual SWE-bench 上看到模式成立,同时承认部分设置有小损失。GPT 5.6 Sol 在单 action 压缩下丢了 2.0 和 3.3 分。开源模型和闭源 frontier 模型,对压缩的耐受度不一样。
真实 agent 里还有别的坑。Luca Iaconelli 担心会话早期做出的决定,几轮 compaction 后被丢掉。k11i 提到多 agent 场景:agent B 拿到 agent A 的压缩摘要,把它当 ground truth,问题就来了。压缩本身不坏,坏在把压缩后的状态当成完整事实。
所以这篇论文更像一个测试提醒。Elvis 说他不太信任内置 auto-compaction,自己搭了一套,针对任务优化,频繁评估。这个态度比结论更实用。百万 token 的 agent run 之前,先在自己的任务上试激进压缩。看峰值上下文,看验收结果,看丢掉的细节会不会影响决策。上下文压到 8K 还能把活干完,再谈省钱。
论文:https://arxiv.org/abs/2611.05306
PDF:https://arxiv.org/pdf/2611.05306
DAIR.AI 论文页:https://academy.dair.ai/papers/you-dont-need-long-context-2611.05306
推文:https://x.com/omarsar0/status/2117956281910829083
发布时间: 2026-11-05 04:32