让 agent 睡一觉花 36 美分,第二天它记的东西你还没看过
Brad Abrams 放出了一个 Claude Cookbook:夜里把 agent 的历史 session 蒸馏成 wiki 式 memory,第二天只读挂载。11 份 transcript 跑了 2.5 分钟、0.36 美元。真正的问题不在钱,在于早上 agent 读到的那份新记忆,默认没人审过。
Brad Abrams 前两天在 X 上发了一条:你的 agent 应该睡一觉。
配套的是一个 Claude Cookbook,叫 Dreaming with a dynamic workflow。做的事很具体:把 agent 跑完的 session 导出成 transcript,夜里批量蒸馏成一套 wiki 式的 memory 文件,第二天 agent 开会话时只读挂载,开局就知道昨天之前发生过什么。
它跑起来是什么样
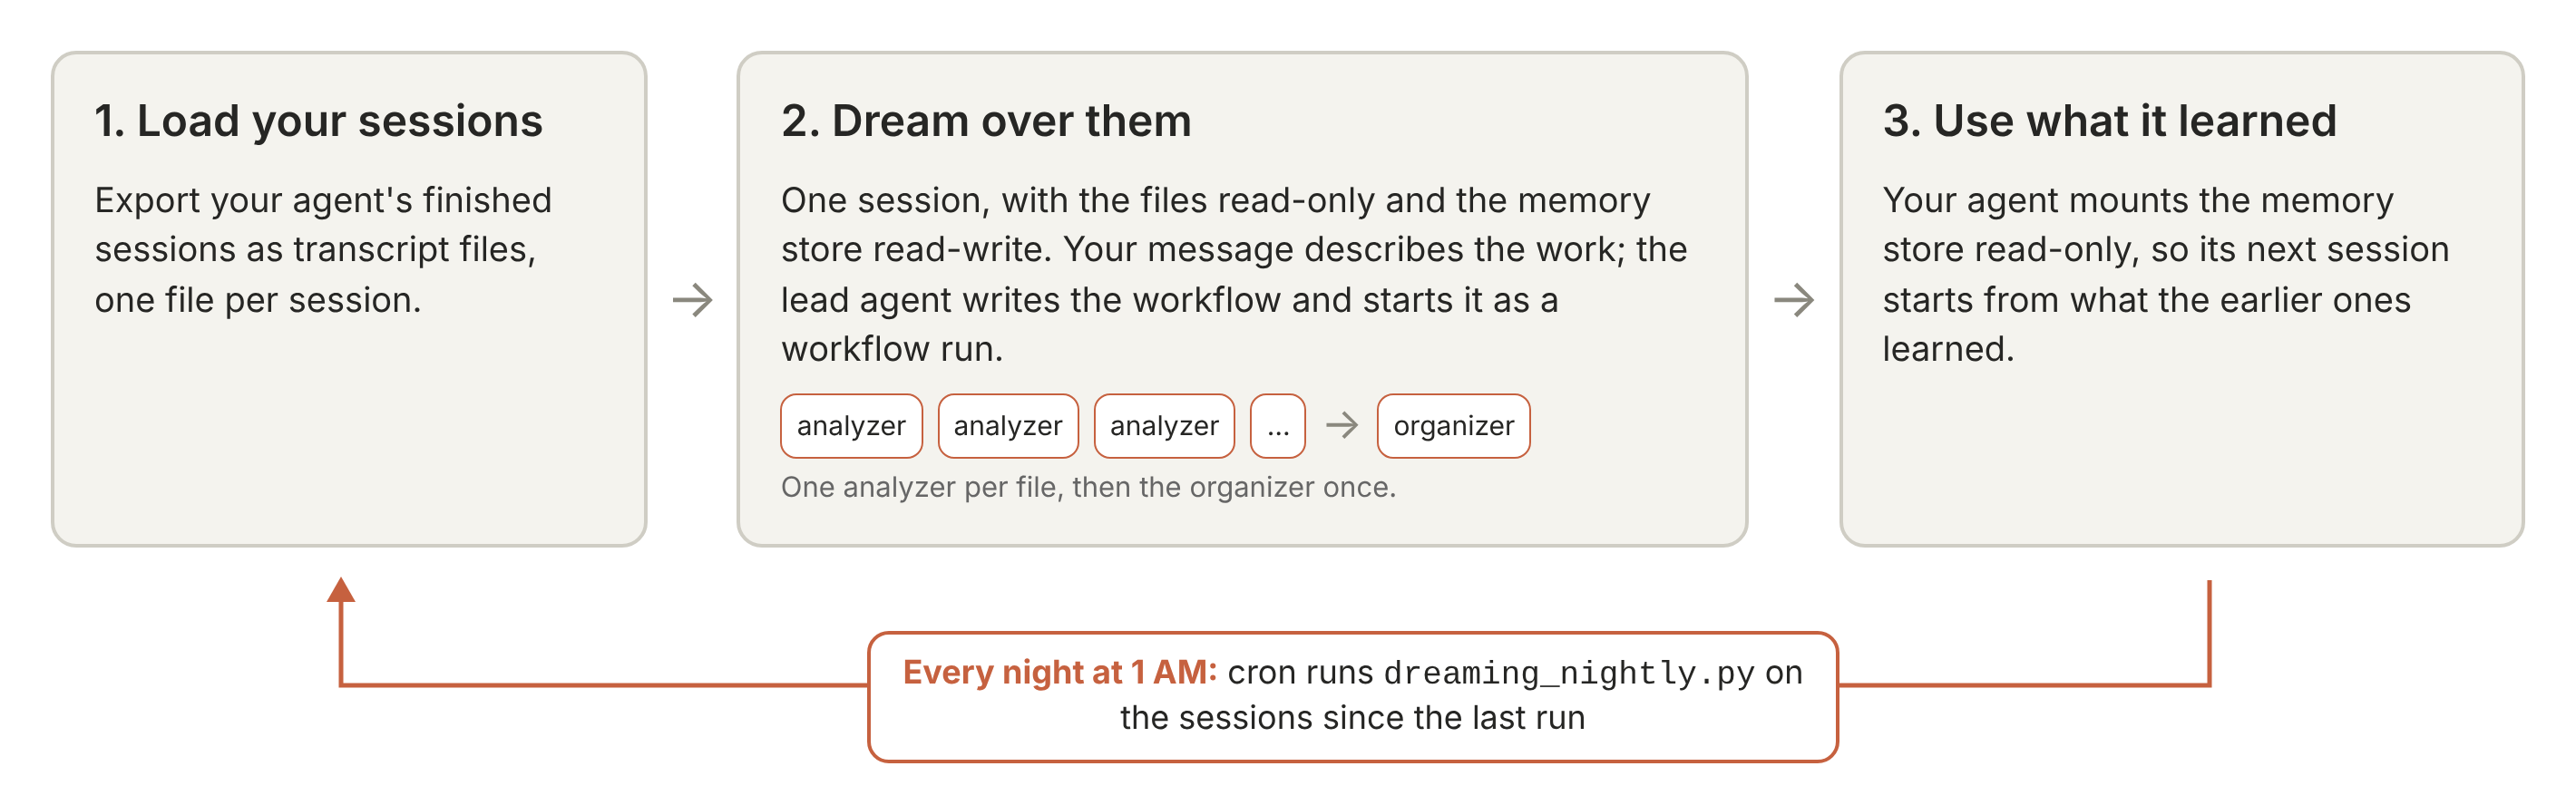
流程分三步。导出 session,一个 session 一个纯文本文件。由一个 lead agent 读你的自然语言指令,自己写 workflow,然后启动一次 workflow run:每个 transcript 派一个 analyzer,各自读完、验证、往共享的 memory 目录里加事实;所有 analyzer 结束后,一个 organizer 跑一次,合并重复文件、修链接、补 _index.md。最后你的业务 agent 以 read_only 挂载这个 store。
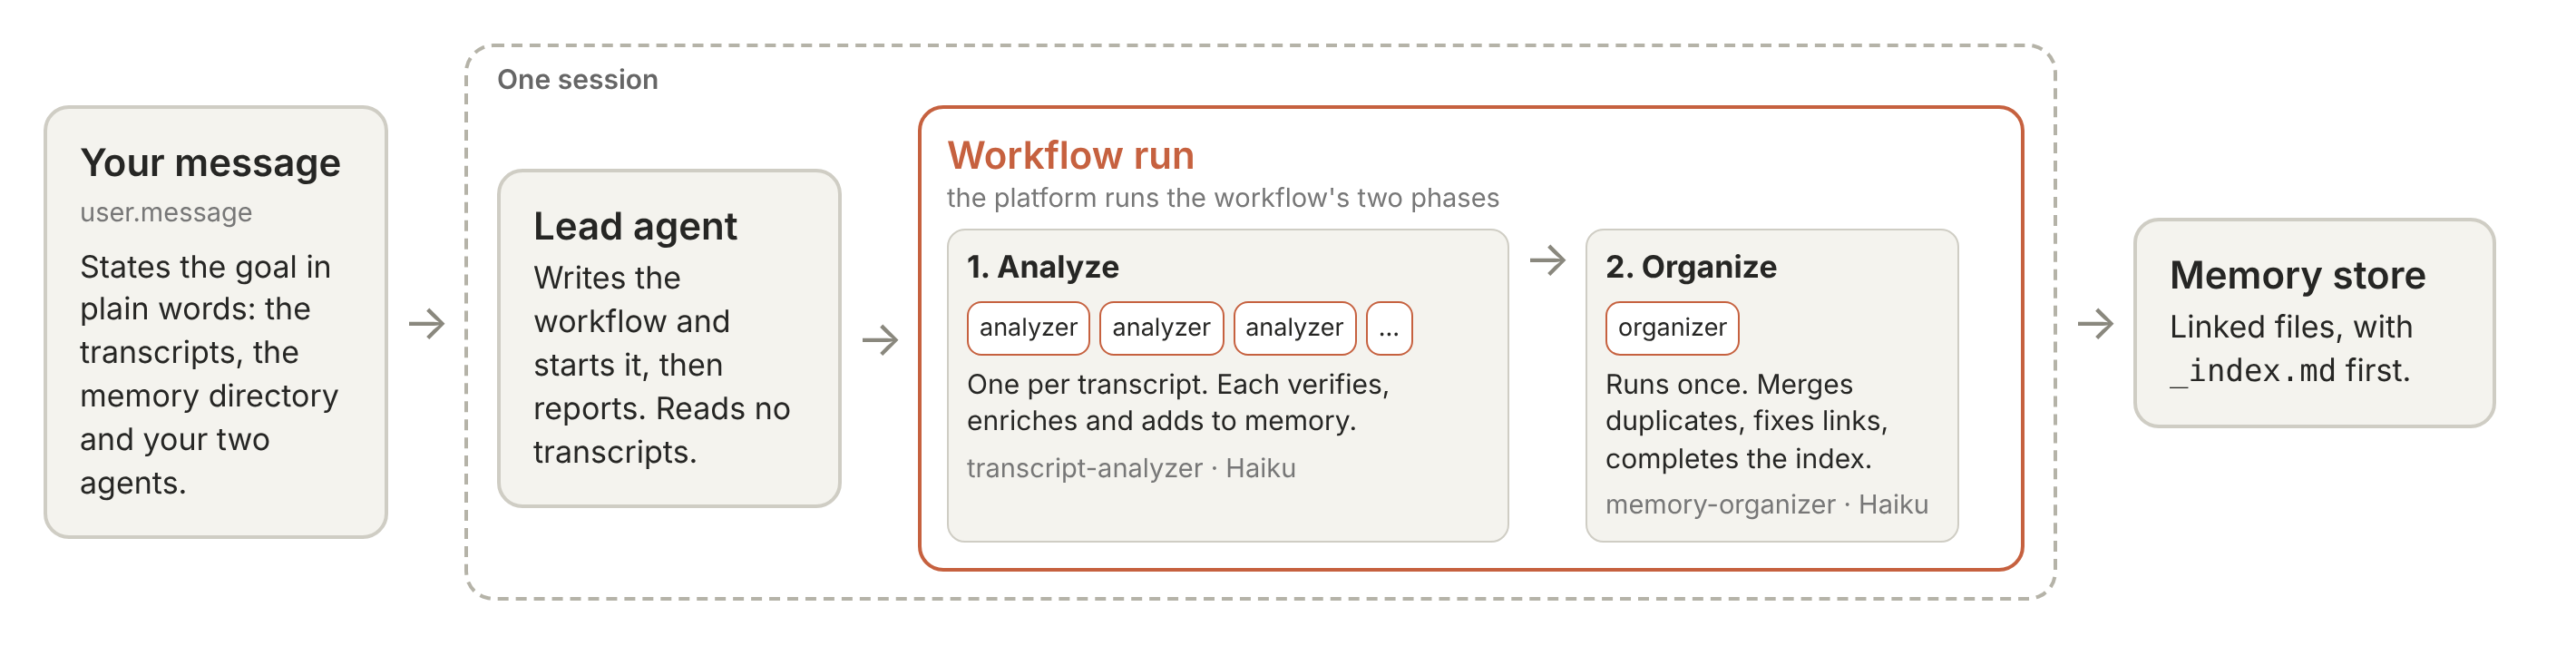
模型分工是 Sonnet 5.5 带 lead,Haiku 5.5 跑 analyzer 和 organizer。analyzer 手里只有 read、write、edit、glob、grep 五个文件工具,没有 shell,没有网络,环境的 allowlist 是空的。这个配置不是随手写的,后面再说。
难的三个地方
Cookbook 用一个虚构的 Python 项目 tidewick 做例子,11 份 transcript、283 KB。里面埋了三类麻烦:
第一,事实会过期。项目早期的 make test 必须先设 TIDEWICK_DATA_DIR 才能过,后来某个版本把这个依赖去掉了。如果 analyzer 只是把“跑测试要设 TIDEWICK_DATA_DIR”抄进 memory,下一个 session 就带着一条错的常识开工。所以规则里要求给事实标日期、标来源、能标注“已被哪个版本取代”的就标。
第二,关键细节埋在 tool output 里。准确的命令行、flag、文件名,散落在几十份 transcript 的返回值中间。蒸馏的质量主要取决于有没有把这些原样挖出来,而不是总结得像不像话。
第三,多个 analyzer 同时在写同一个目录。两个文件可能被两个 agent 在同一秒改写。规则里写了:每次写完要读回来确认自己的内容真的落盘,如果读到的是别人的版本,把两边合并、再写、再验。organizer 最后才做合并和重命名,中途不许改名不许挪目录,因为别人正在写。
这三条决定了“让 agent 睡觉”不是一个总结任务。它更接近一个并发写入的一致性工程,只是写手换成了模型。
成本比想象中低,风险比想象中高
11 份 transcript 跑了 2.5 分钟,0.36 美元,其中 lead 0.17、11 个 analyzer 合计 0.16、organizer 0.03。Cookbook 里另给了一个数:50 多份长 session、约 12 MB 文本,默认设置下一次约 8 美元、十分钟。
这个价格让人放松警惕。真正该看的是下面这条:默认没有 review。nightly 脚本凌晨一点用 cron 跑,dream 完直接写回你 agent 正在读的那个 store。你早上打开电脑,agent 的记忆已经被一份没人看过的转录改过了。
Cookbook 自己承认这一点,也给了缓解措施:每次跑之前把 store 的文件拷一份到 records 目录,每次写入都是一个保留 30 天的 memory version,可以审、可以回滚。但这些都是事后的。
还有一个更微妙的点。analyzer 的 system prompt 里明确写了“永远不要把 secret 抄进 memory”,但这是靠模型听话,不是靠机制。整个流程里唯一真正的防线是:不给 shell,不给网络,写权限只开在 memory 目录。最坏情况是一个被污染的 transcript 改了 store 里的说法,并且花掉你的预算,仅此而已。前提是你不把 store 文本塞进 system prompt。一旦塞了,注入的内容会进入每一个 session。
社区里的几种声音
Ray Amjad 说他自己搭了一套类似的,差别在于每条事实都带一个 source 指针,指回存在 S3 里的原始 session,冲突时回源判定,而不是让 organizer 猜。他另外会“dream”不同团队成员的工作习惯,单独放一个文件夹,偶尔读读 agent 对自己的描述。

Alan Blair 的评论更直接:贵,而且有点乱。他觉得这东西几周到几个月内要么被砍掉,要么被并进 Claude 的核心功能。
还有人翻出了 Letta 团队 2025 年 4 月的论文 Sleep-time Compute(arXiv:2504.13171,作者 Kevin Lin 等)。论文讲的是让模型在收到 query 之前先离线想一遍,预判用户会问什么、预计算一些量,结果是在 Stateful GSM-Symbolic 和 Stateful AIME 上把达到同等准确率所需的 test-time compute 降了约 5 倍,继续加 sleep-time compute 还能再提 13% 和 18% 的准确率;同一段上下文上有一组相关问题的话,摊薄后每个 query 的成本降 2.5 倍。
方向上这两件事不完全一样。论文是 anticipatory,猜你会问什么;Claude 这个 cookbook 是 hindsight,回看已经发生过什么。但底层假设是同一个:推理不一定非得发生在用户等待的那几秒里。
一份判断
“dreaming”这个词容易让人以为它很玄。翻开源码看,它做的事很朴素:批量读文本、抽事实、去重、标日期、维护一个索引文件。真正有含金量的地方不在概念,在组织方式:事实带日期,冲突显式标出来,不猜哪个对,被合并的文件留一个 MOVED TO [[slug]] 的空壳,_index.md 当入口。这些做法跟具体跑在哪个平台无关,抄得走。
Alan 那句“迟早被并进核心功能”大概率是对的。当一个功能的核心资产是几份写得很细的 prompt,它变成平台内置特性只是时间问题。但在那之前,这套 cookbook 更值得读的部分,是怎么处理并发写、怎么给事实标 stale、怎么让 organizer 不发明事实。这些问题是任何自建 agent 记忆的人都会撞上的,跟 Claude 不 Claude 没关系。
最后提醒一句,nightly 那条 cron 装上去之前,先想清楚愿不愿意让一份没人看过的转录,在你睡觉的时候改掉 agent 明天要用的记忆。愿意的话,那 36 美分花得挺值。不愿意的话,Cookbook 里也给了另一条路:先手动跑进一个新的 store,读完再切换。
发布时间: 2026-11-05 21:27