280B只激活14B,文心5.5 Flash Base开源:SOTA前面有个脚注
百度开源ERNIE 5.5 Flash Base,总参数280B、每token激活14B,预训练33.5T tokens,支持1M上下文推理。官方说同尺寸SOTA,网友先问:对比名单是不是该更新了?
百度把 ERNIE 5.5 Flash Base 的权重放出来了。总参数280B,每token激活14B,预训练33.5T tokens,训练上下文128K,微调和推理支持1M。发布卡写得很清楚:这是预训练结束时的base checkpoint,没有做中训练和后训练。对开发者,它适合继续做领域适配、指令微调和强化学习研究。对普通用户,它更像发动机,不是整车,不能直接拿来当聊天助手用。

参数利用率是这次最值得看的地方。280B里每token只激活14B,稀疏比例不低。官方架构是43层,1层dense FFN加42层MoE。每层MoE有512个路由专家,top-10激活,外加1个共享专家,专家在2048维latent空间里做dispatch和combine。注意力是37层HCA加6层MLA-DSA。HCA每128个token缓存一个entry,省KV cache。MLA保留全上下文访问。官方说在相近KV cache预算下,HCA配MLA比配CSA更好。这个设计把长上下文成本拆开算,不只盯激活参数。
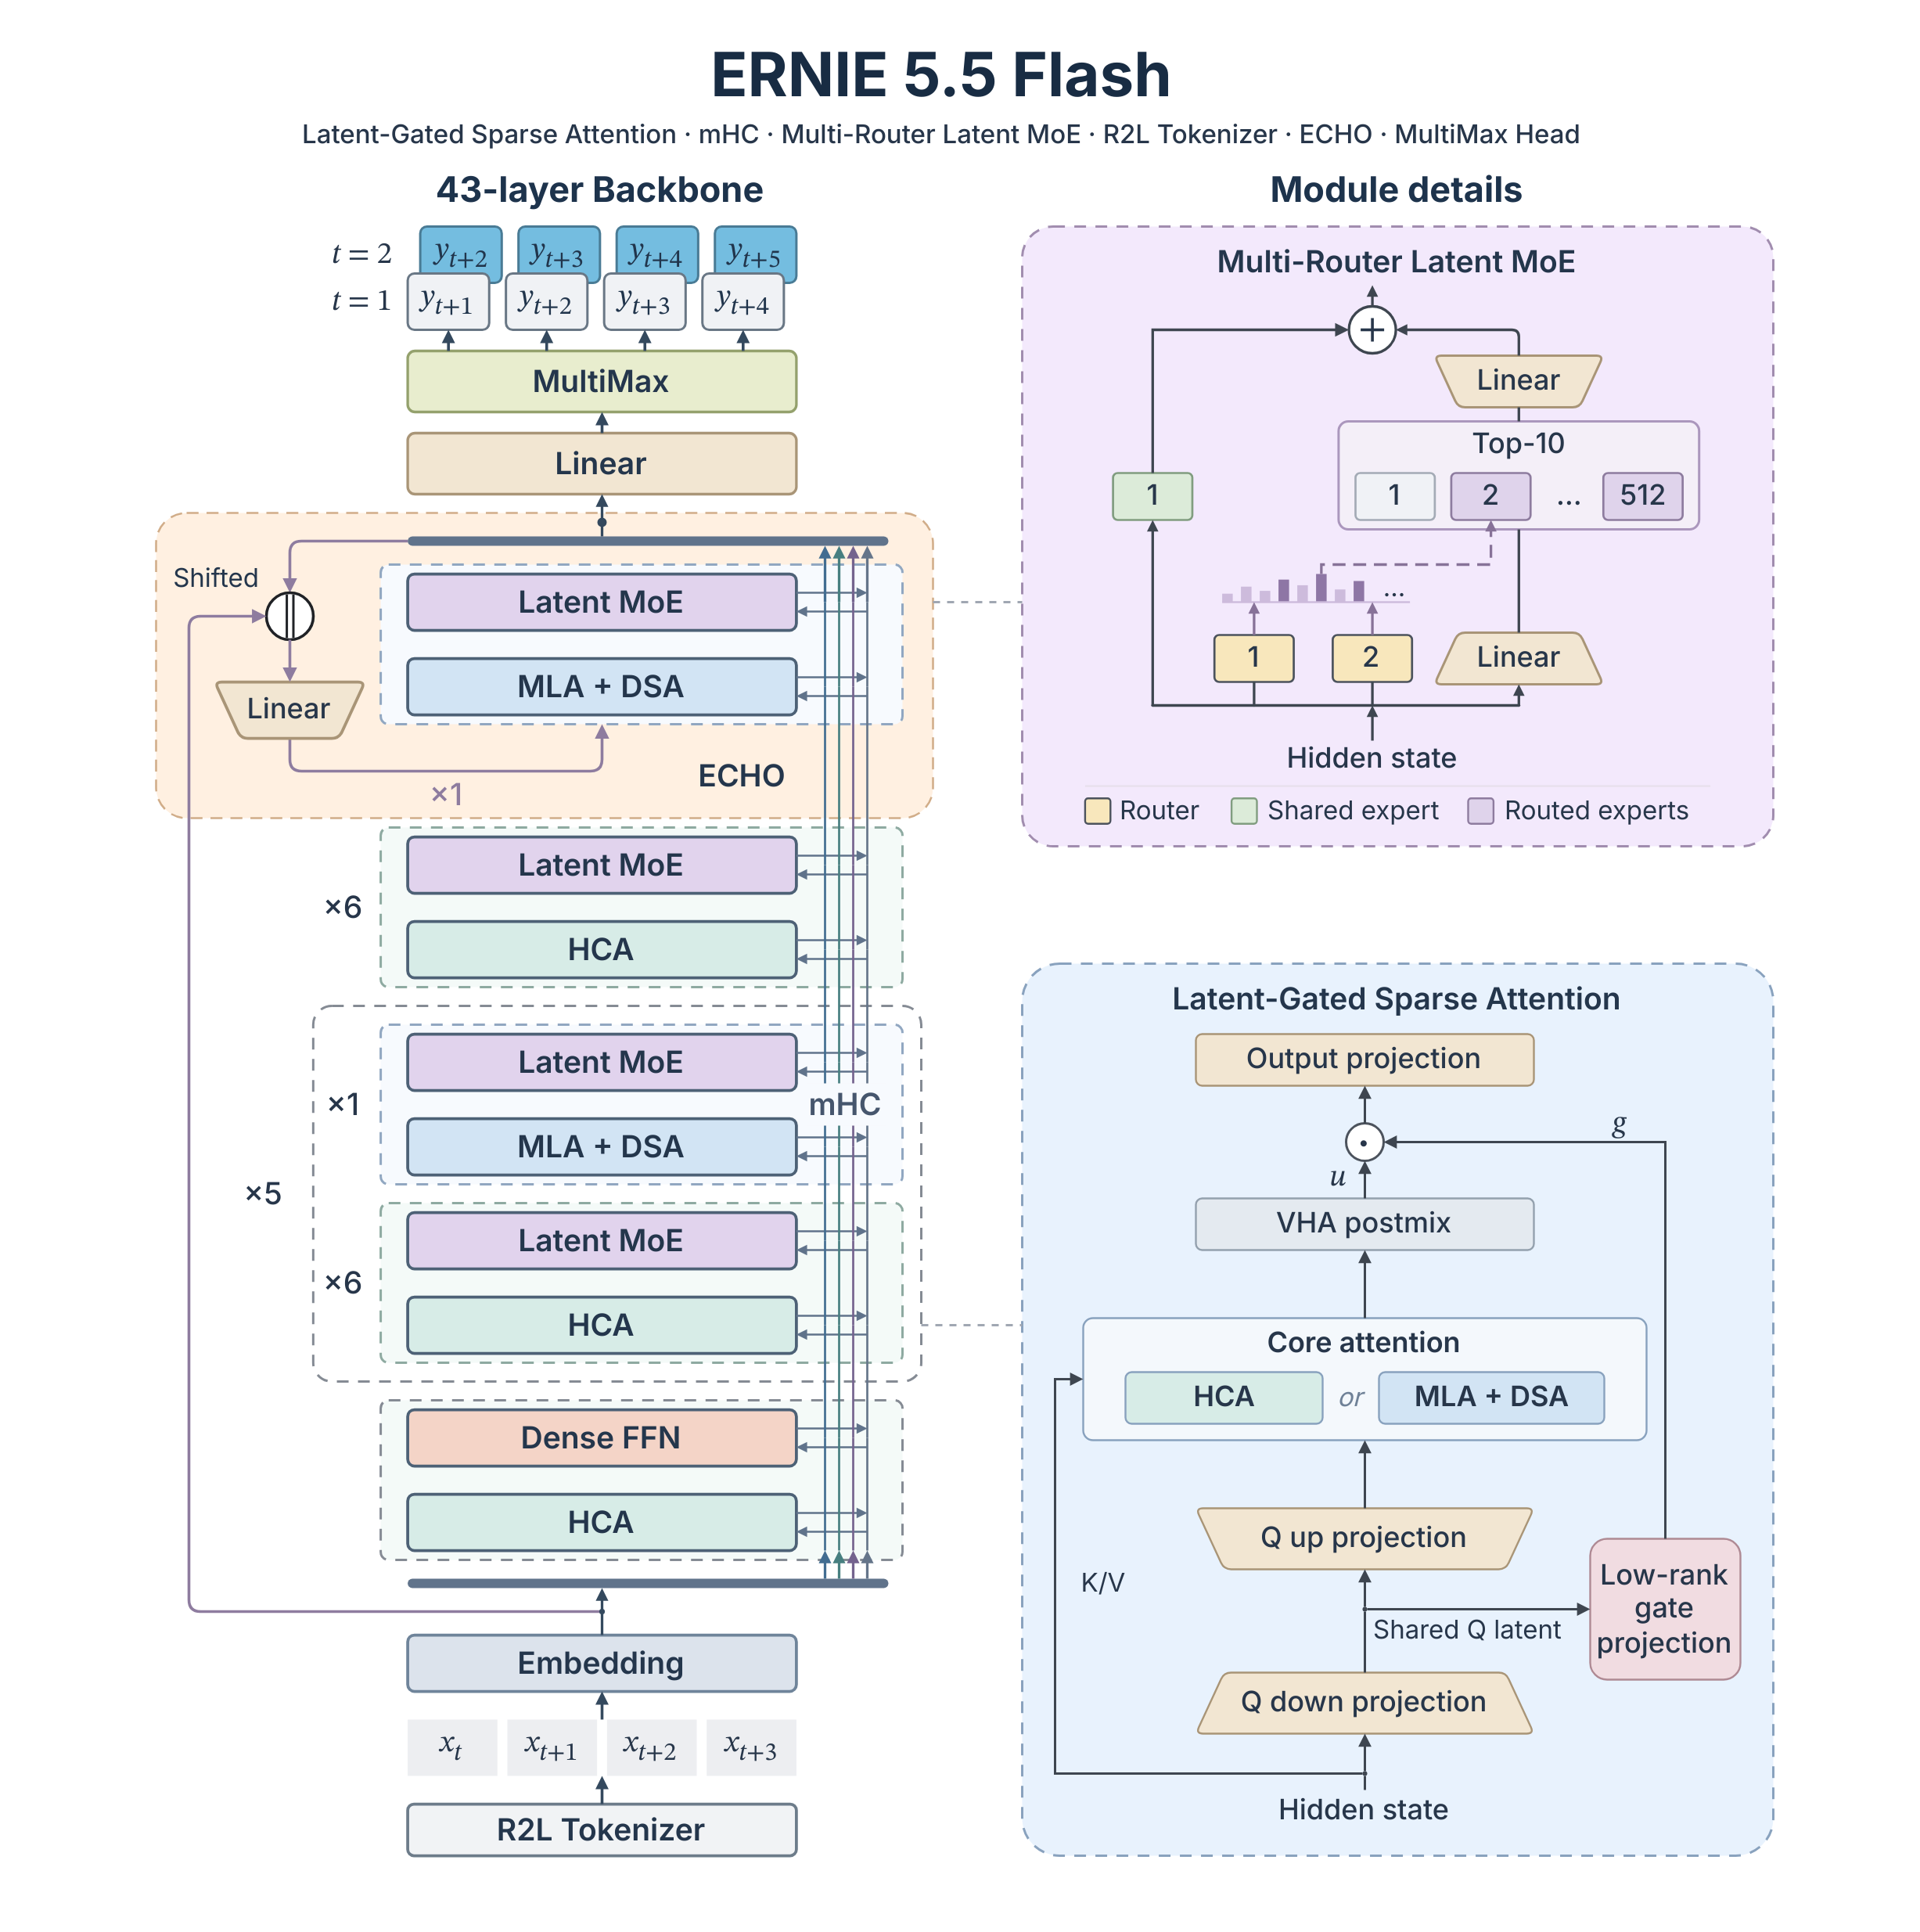
官方在回复里补了几个设计选择。Multi-Router Latent MoE用多个独立初始化的sigmoid路由器投票,减少单一路由分数和专家实际有用性之间的弱相关。ECHO把多token预测放到backbone最后一层,这一层同时充当投机解码的draft head,省一个单独MTP模块。还有mHC、MultiMax输出头,以及约200K词表的BPE tokenizer,数字按从右到左、最多三位一组切。训练侧提了分布式Muon优化器和FlashMask-4注意力kernel,目标是在数千GPU规模下把训练效率压住。

评测表要看限定。官方用统一管线、prompt和few-shot设置,对比DeepSeek-V4-Flash-Base 284B-A13B、Hy3-preview-Base 295B-A21B、MiMo-V2.5-Base 310B-A15B。ERNIE 5.5 Flash Base在MMLU上93.3,对比89.4、87.5、87.6;MMLU-Pro 78.4,对比69.2、66.9、65.7;HumanEval+ 82.3,对比69.5、78.0、74.4;LiveCodeBench 40.1,对比31.9、33.5、32.4;RepoQA 91.7,对比81.0、91.3、56.5;LongBench-v2 48.7,对比44.5、39.8、44.6。不是全胜。ChineseSimpleQA 73.0低于DeepSeek的75.3,INCLUDE-lite 79.5略低于79.8,FullStackBench 54.6低于Hy3的56.7,HELMET-Rerank 56.2低于DeepSeek的60.0。强项在通用知识、代码和长上下文检索,弱项也写在表里。
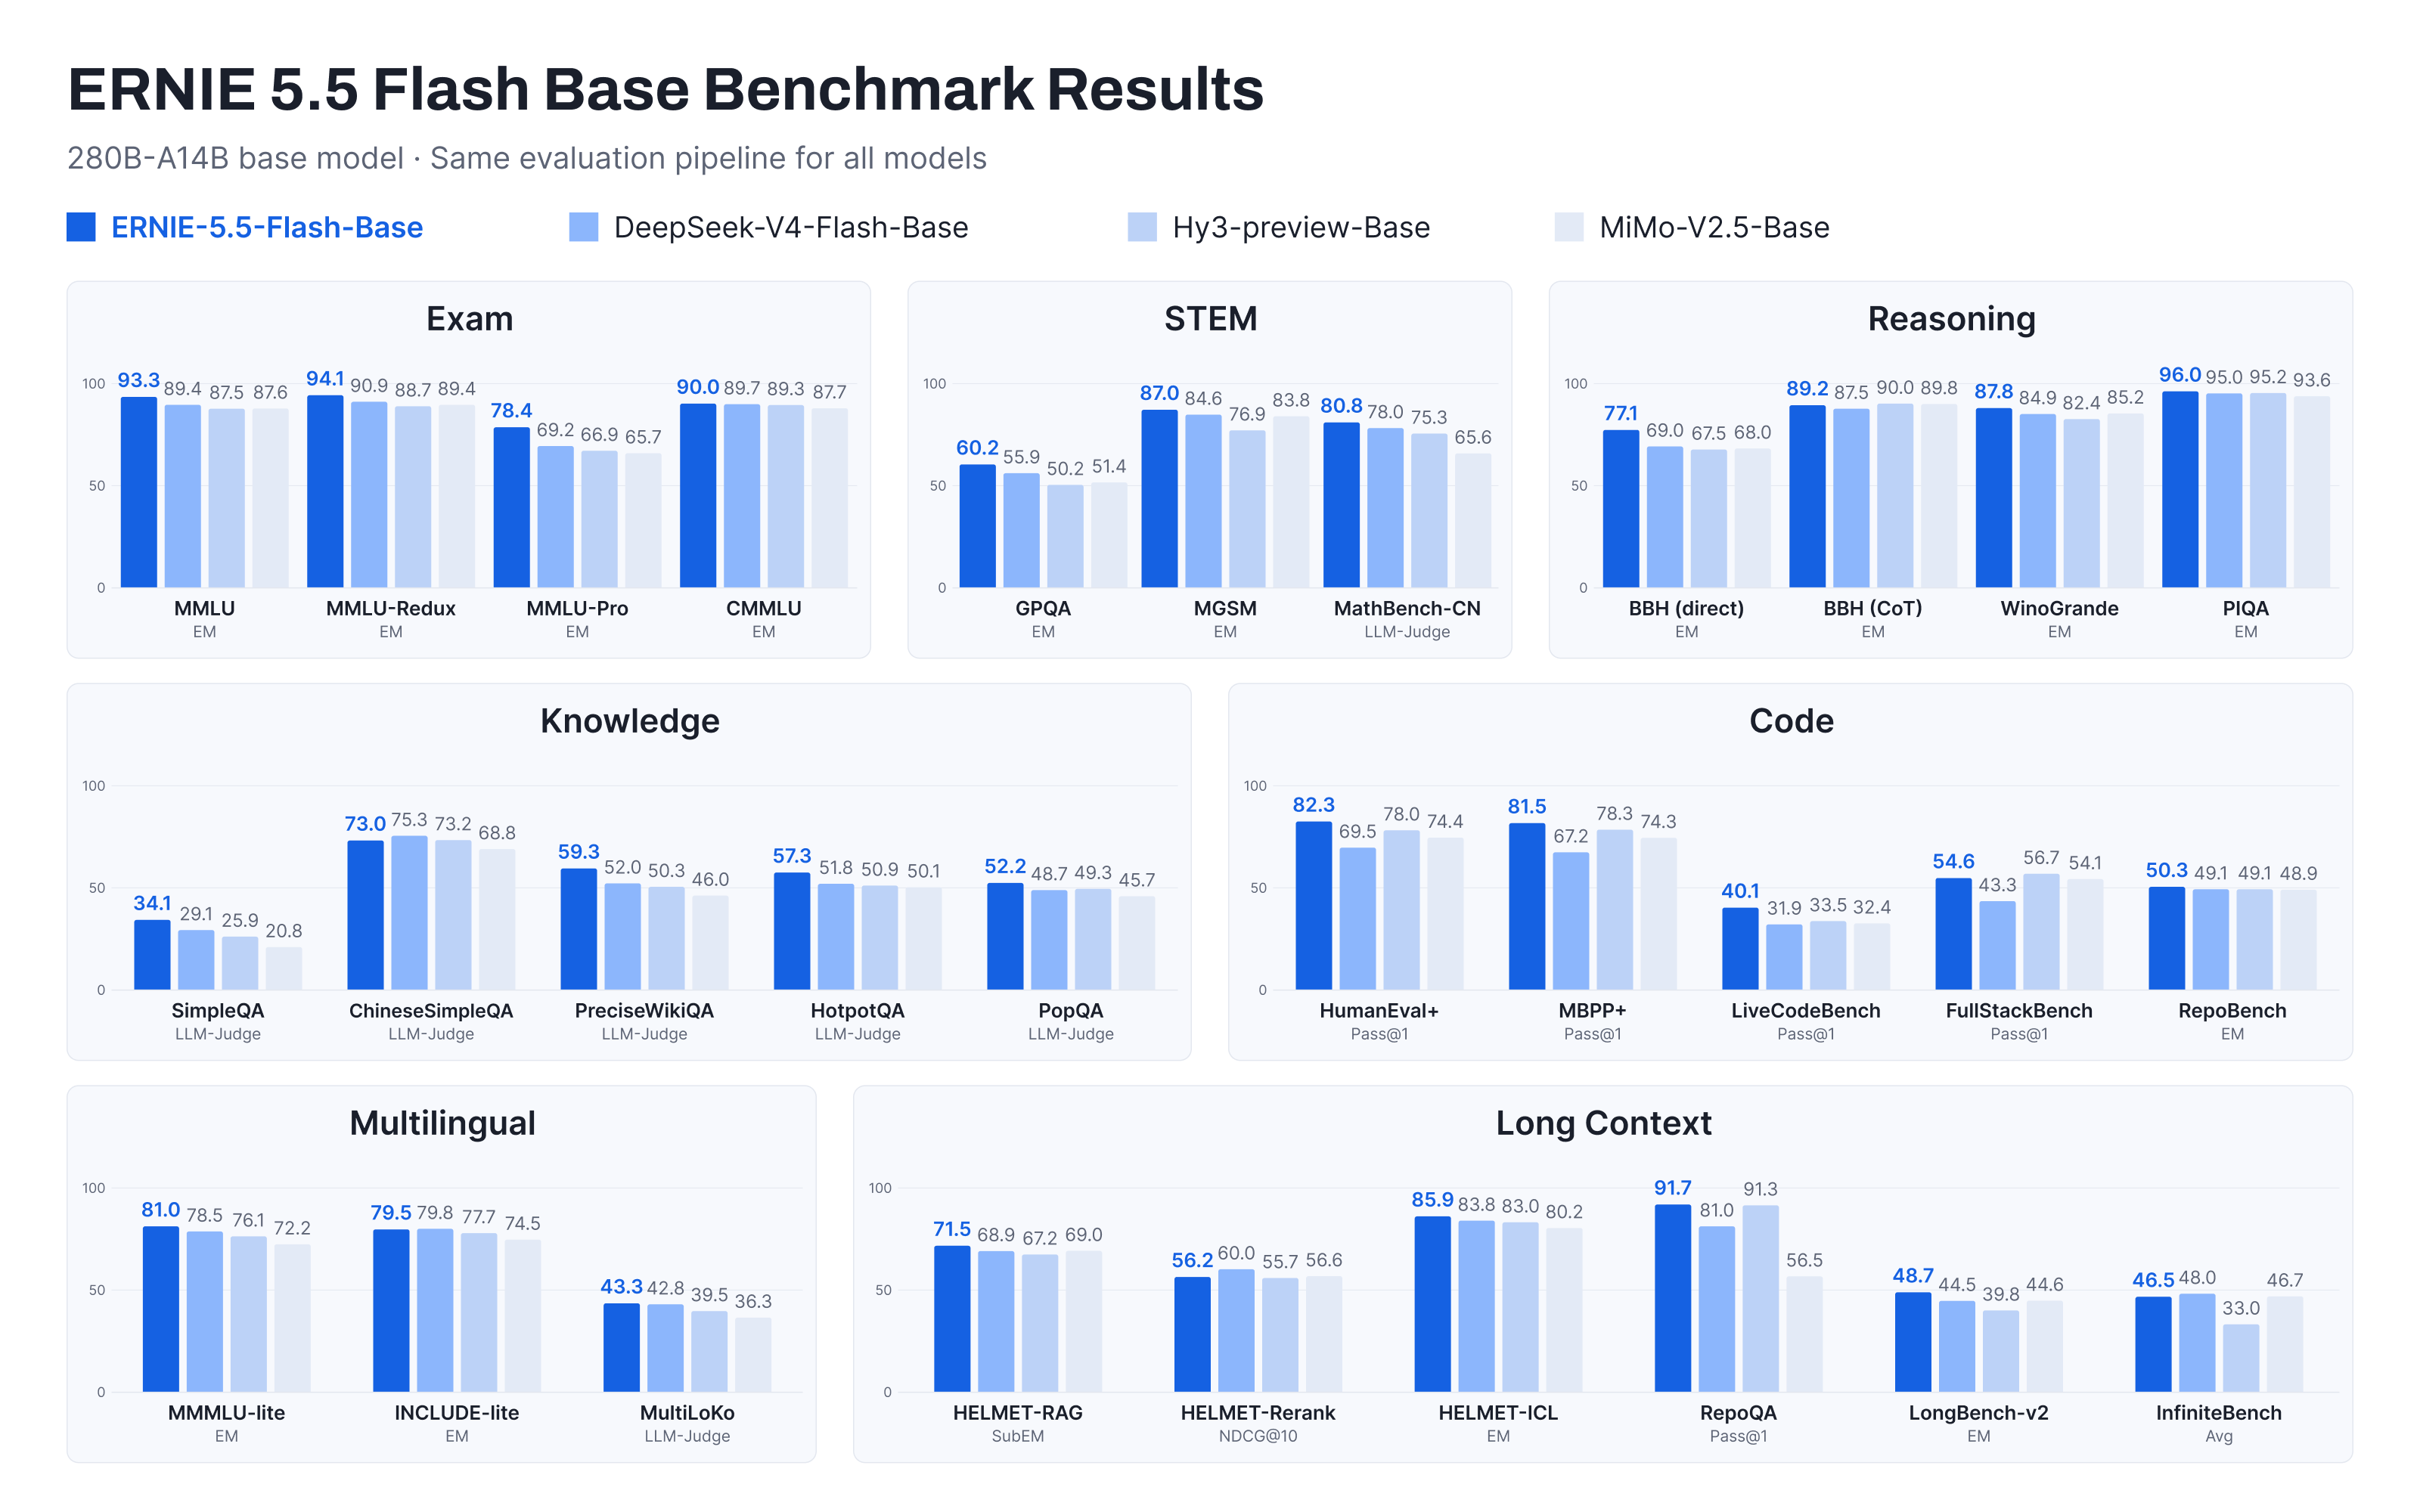
“SOTA”这个词在模型卡里经常被用得很宽。官方说的是同尺寸SOTA,对比名单也确实按总参数和激活参数挑。但评论区有网友不买账,有人说对比对象像6个月前的模型,有人直接点名为什么不上更新的模型,还有人问视觉能力、最小GPU部署配置。也有网友注意到280B只激活14B,认为推理成本能压不少。这些反应比口号有用。模型开源后,部署成本、微调效果和实际任务表现会给出更硬的答案。
权重在Hugging Face和ModelScope都能拿到,FP8和BF16两个版本,许可证是ERNIE 5.5 Flash Base Model License v1.0。SGLang和vLLM都给了部署方式,长上下文推理可以开到1,048,576 tokens。完整版ERNIE 5.5 Flash官方说还在路上。现在这个Base适合拿来做二次训练和研究,不适合直接拿benchmark数字当产品结论。
链接:
发布时间: 2026-11-05 23:30