AI 的记忆越多越聪明?Claude 记了 413 个文件,只换来一个徽章
Anthropic 让 Claude 在空闲时间「做梦」,整理记忆、纠正错误。宝可梦实验里,一个模型写了 413 个记忆文件只拿到一个徽章,另一个只写了 9 个文件却拿到四个。记忆这件事,多不一定好。
人类睡眠时,海马体会重播白天的经历,把短期体验慢慢沉淀成长期知识。Anthropic 把这套机制搬到 AI agent 身上,起了个名字叫 dreaming,中文可以理解为「做梦」。
简单说,agent 在交互过程中会留下大量日志和记录,dreaming 就是利用空闲时间回头翻这些日志,整理、纠错、提炼出可以复用的规则或笔记。Anthropic 在工程博客里详细写了这个过程,以及他们怎么衡量它到底有没有用。
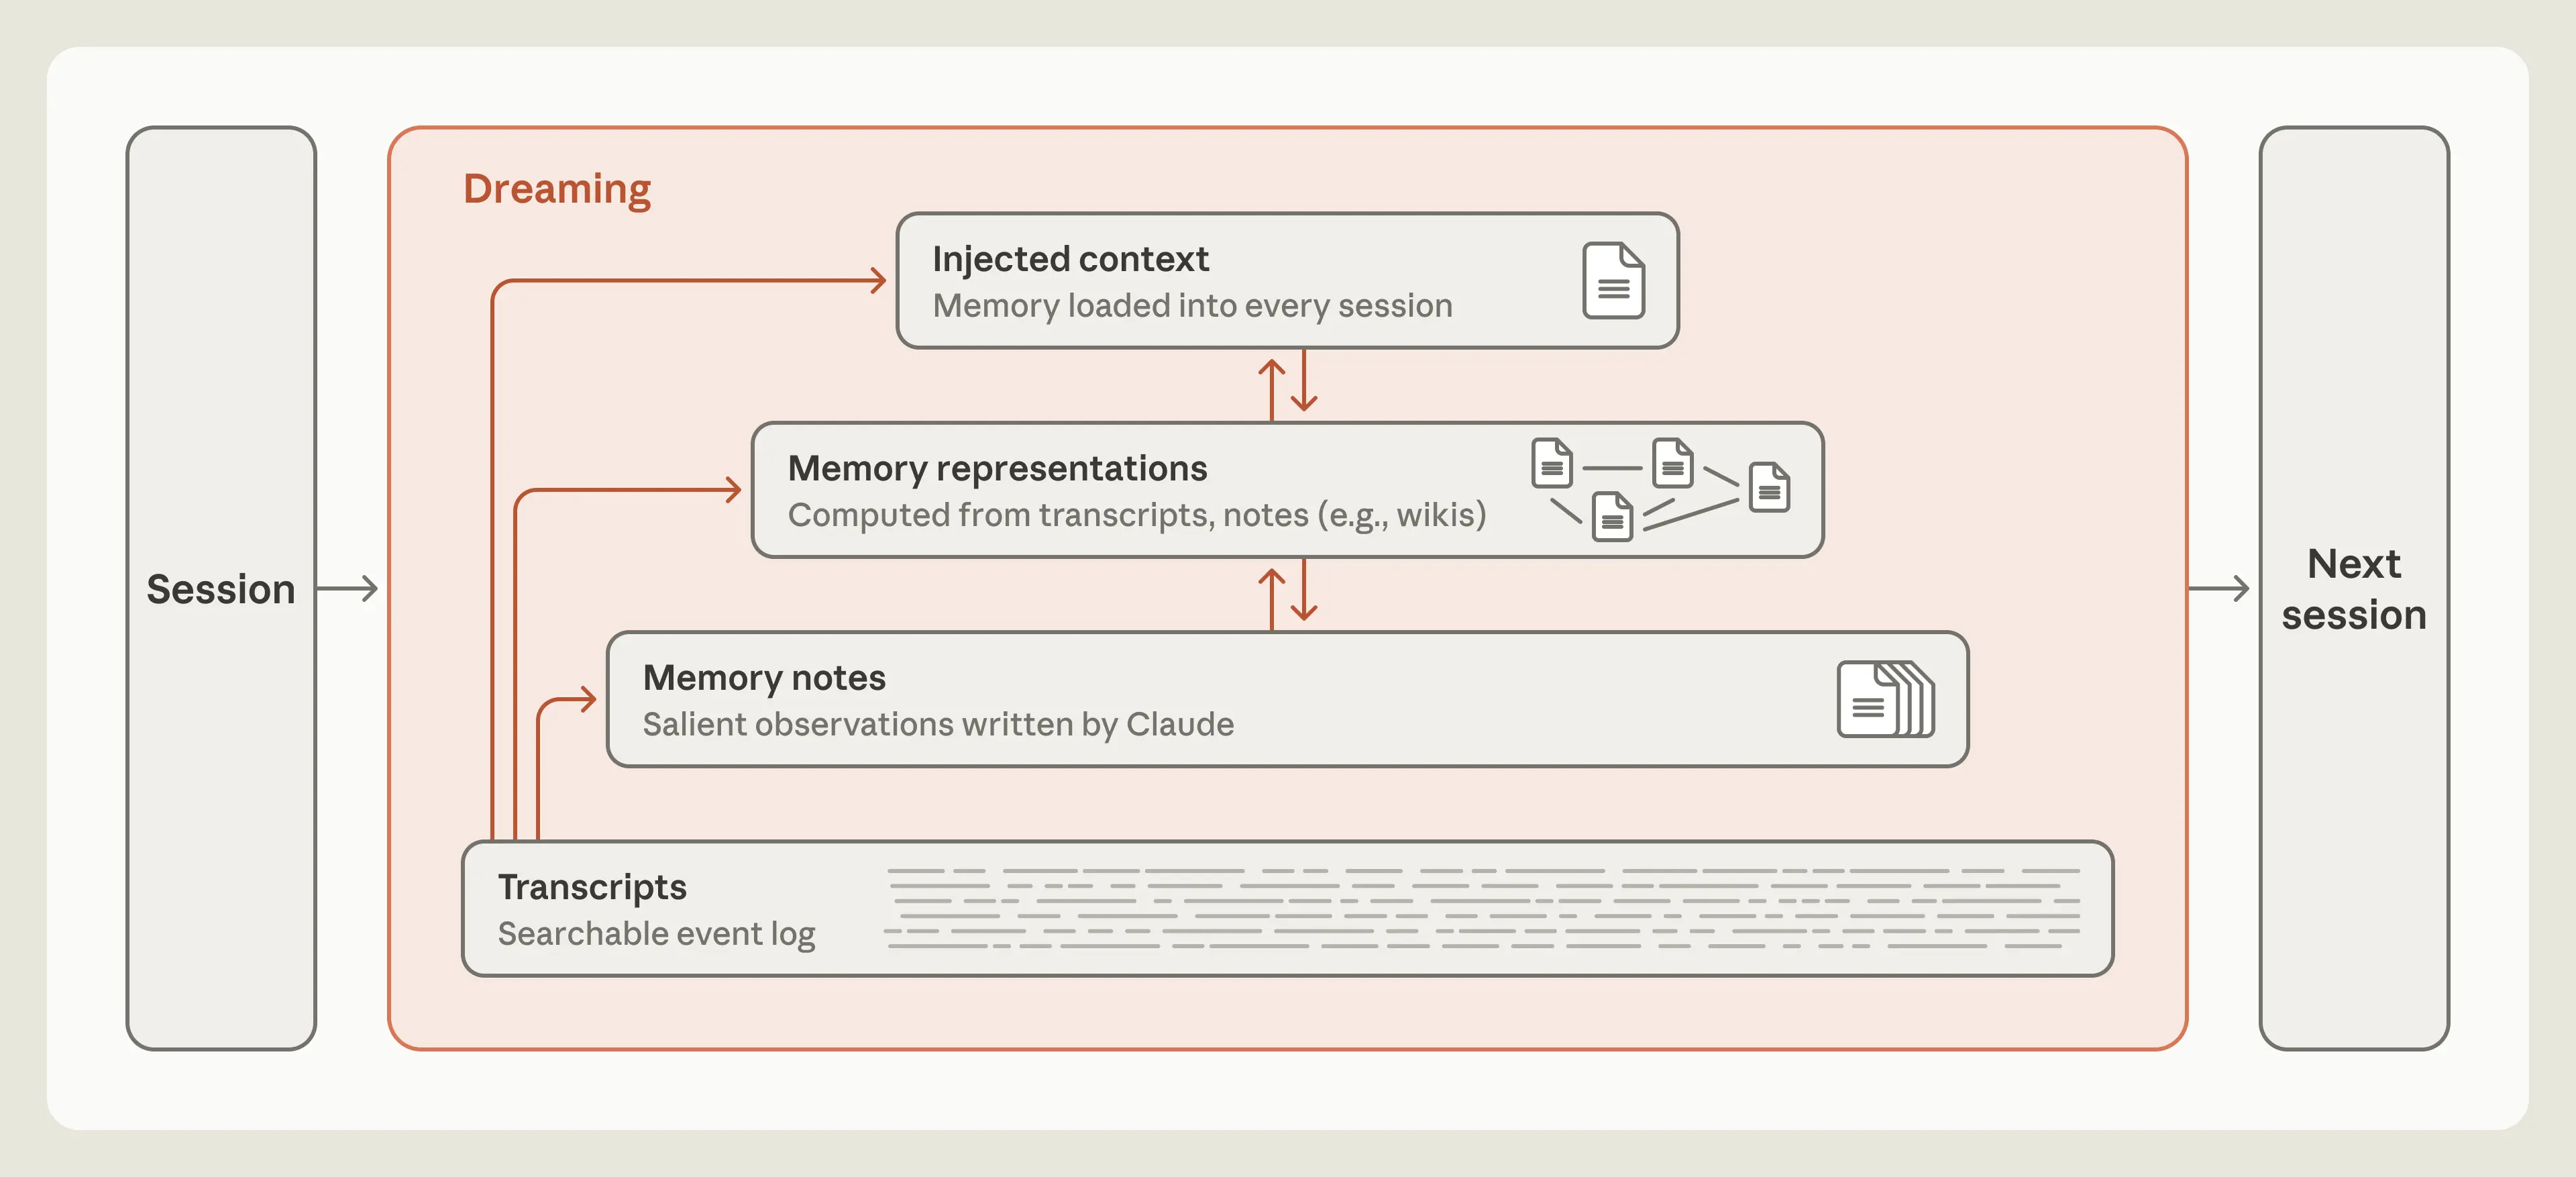
他们把 agent 记忆分成几层:最底下是原始对话记录 transcripts,往上是 Claude 自己写的 memory notes,再往上是 wiki 这类结构化表示,最顶层是每次会话都会预先加载的上下文。dreaming 的作用是在这些层级之间上下移动信息,让需要的东西浮上来,让太琐碎的东西沉下去。
道理听起来顺。真正有意思的是实验里暴露出来的问题。
记太多的那个,反而卡住了
Anthropic 让 Claude 玩《宝可梦红》。这个游戏对 AI 来说是个长程任务,需要导航、战斗、记住地图和道具位置。每个模型开局时都有一个可以读写的记忆文件夹。
他们对比了 Sonnet 3.7 和后来的 Fable 5 在约一万步时的记忆状态。
Sonnet 3.7 的策略是能记就记。打了哪场战斗、捡了哪个道具、遇到哪个 NPC,各建一个文件。最后它写了 413 个记忆文件,分布在 225 个文件夹里,游戏进度是一个徽章。
Fable 5 写了 9 个文件,两个文件夹,外加一个顶层 global.md,进度是四个徽章。
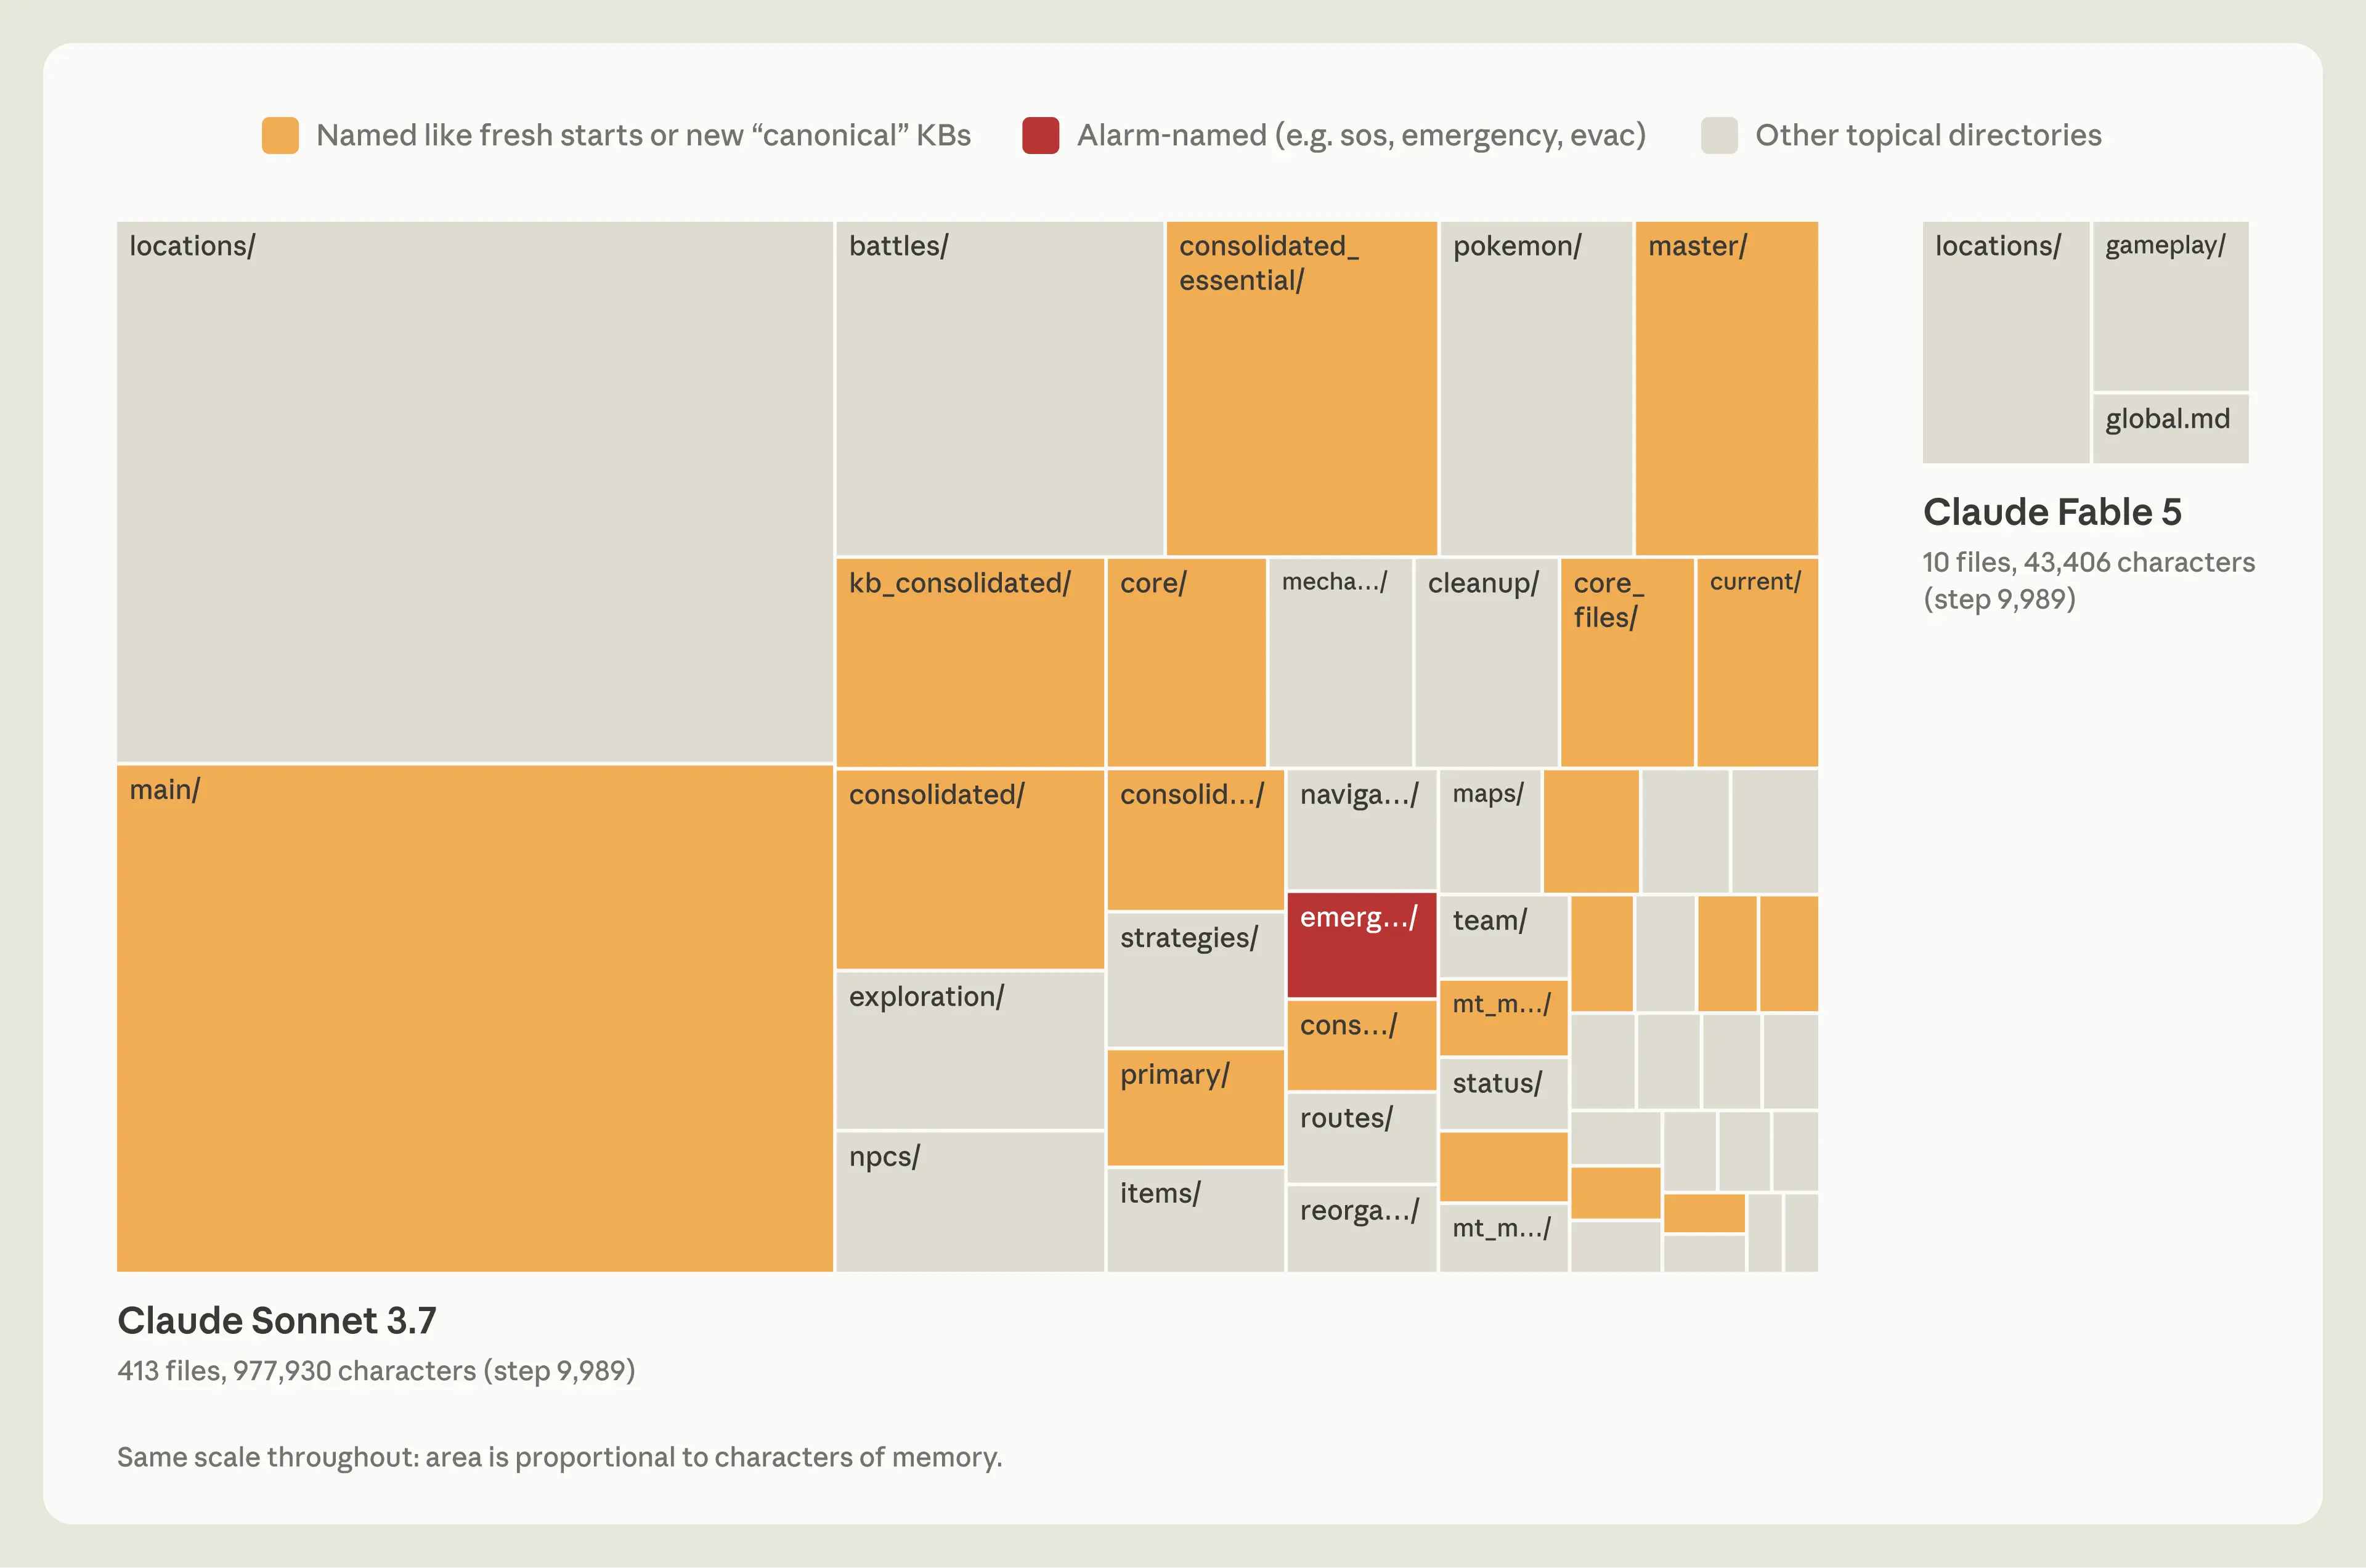
问题不在于「记太多」本身。问题在于 Sonnet 3.7 记了大量会很快过期的状态信息,比如现在有多少钱、人在哪张地图。这些信息屏幕上每回合都能看到,存下来既冗余又容易过时。它花越来越多时间翻记忆,反而没时间玩游戏。到一万步左右,它连续 17 步在增删记忆文件,游戏里一步没动。
Fable 5 把记忆用在游戏不会直接告诉它的事情上:策略、计划、试出来的规则。global.md 像一块仪表盘,写着当前目标、道馆挑战计划、还有它自己的记忆使用规则。有个例子挺具体:连续七个精灵球没抓到鲤鱼王之后,它写下「如果连续 3 个以上球失败,就换节奏,在菜单步骤之间多按等待」。
这类东西不写下来就会消失,写下来才有复利。
一条错误笔记,能把 agent 困在山里
记忆写错了怎么办。dreaming 的一个用途就是拿原始日志回头校验笔记。
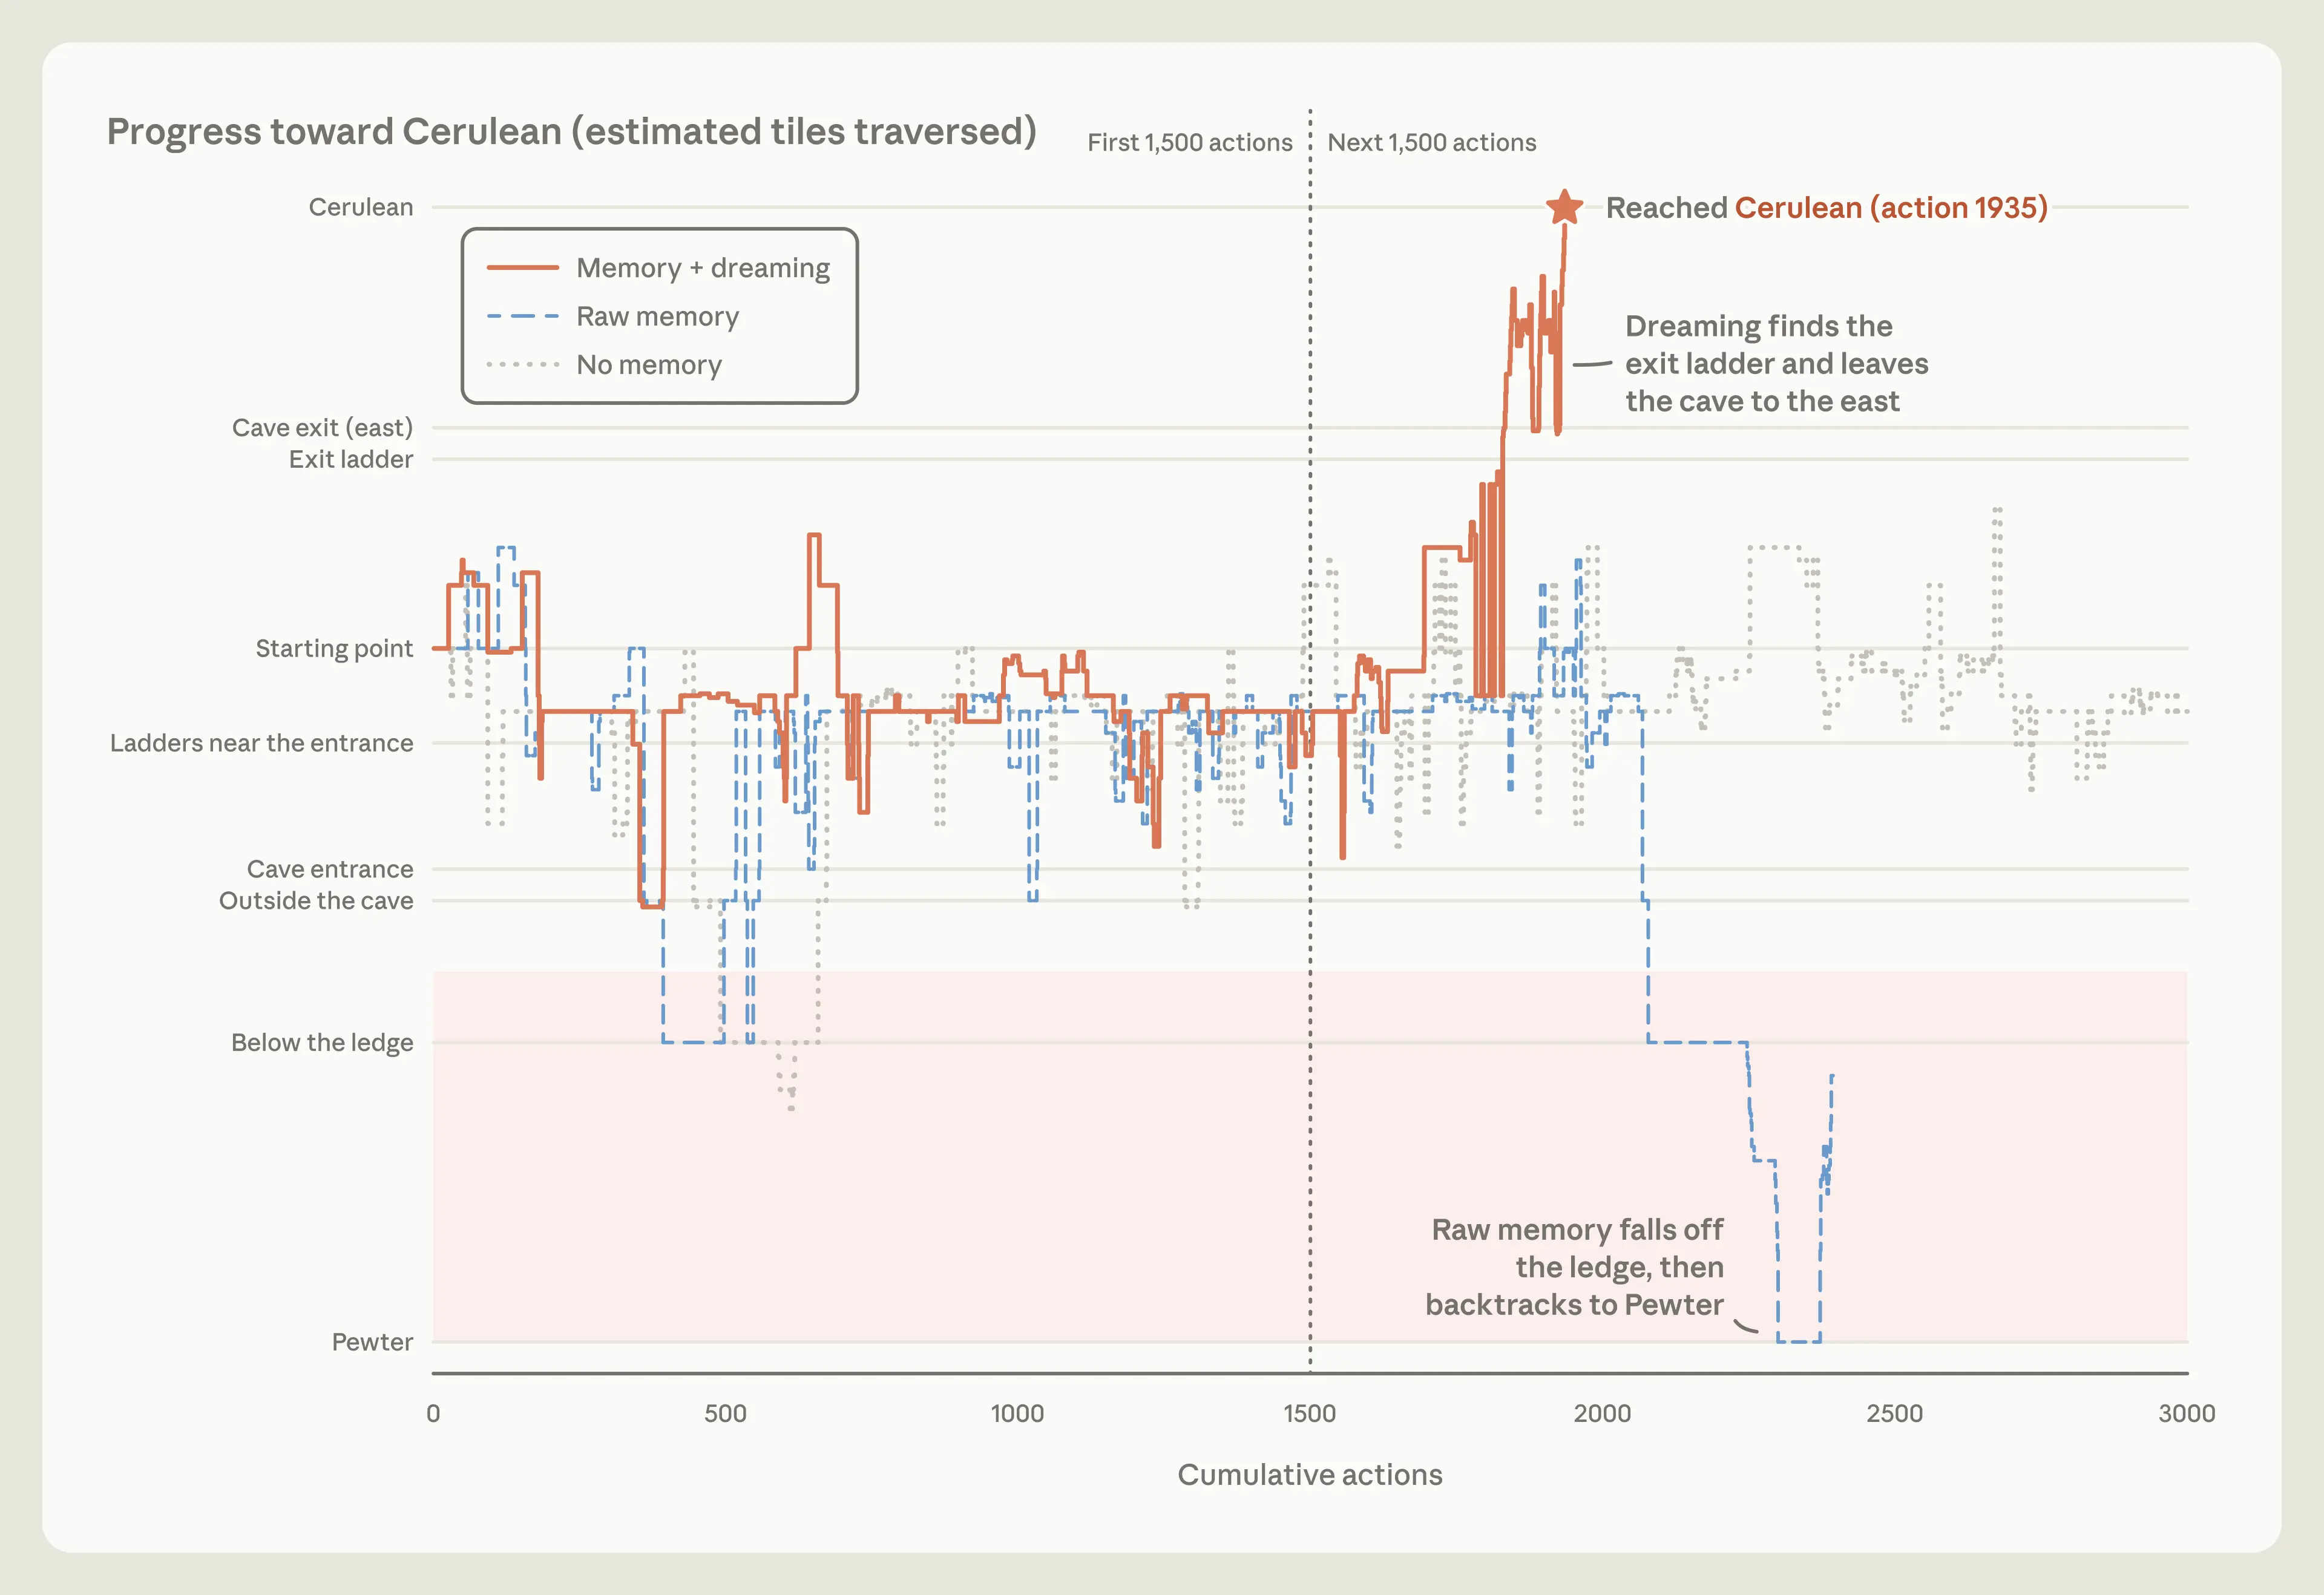
同一个宝可梦实验里,Claude 要穿过月见山。山入口附近有个单向台阶,掉下去就会滑回之前的路。Claude 把山入口的宝可梦中心位置记错了,记成了山东侧。走出中心时它宣布「月见山在我身后」,把任务标记为完成,然后朝下一个城市走,接着就掉下了台阶。
导航工具没显示这个落差,Claude 以为自己走偏了,又折回去。如此反复三次,它在记录里写「我打算停下来,不再循环」。实验框架自动回复让它继续,它就一路退回了更早的城镇。那一轮始终没到达目标城市。
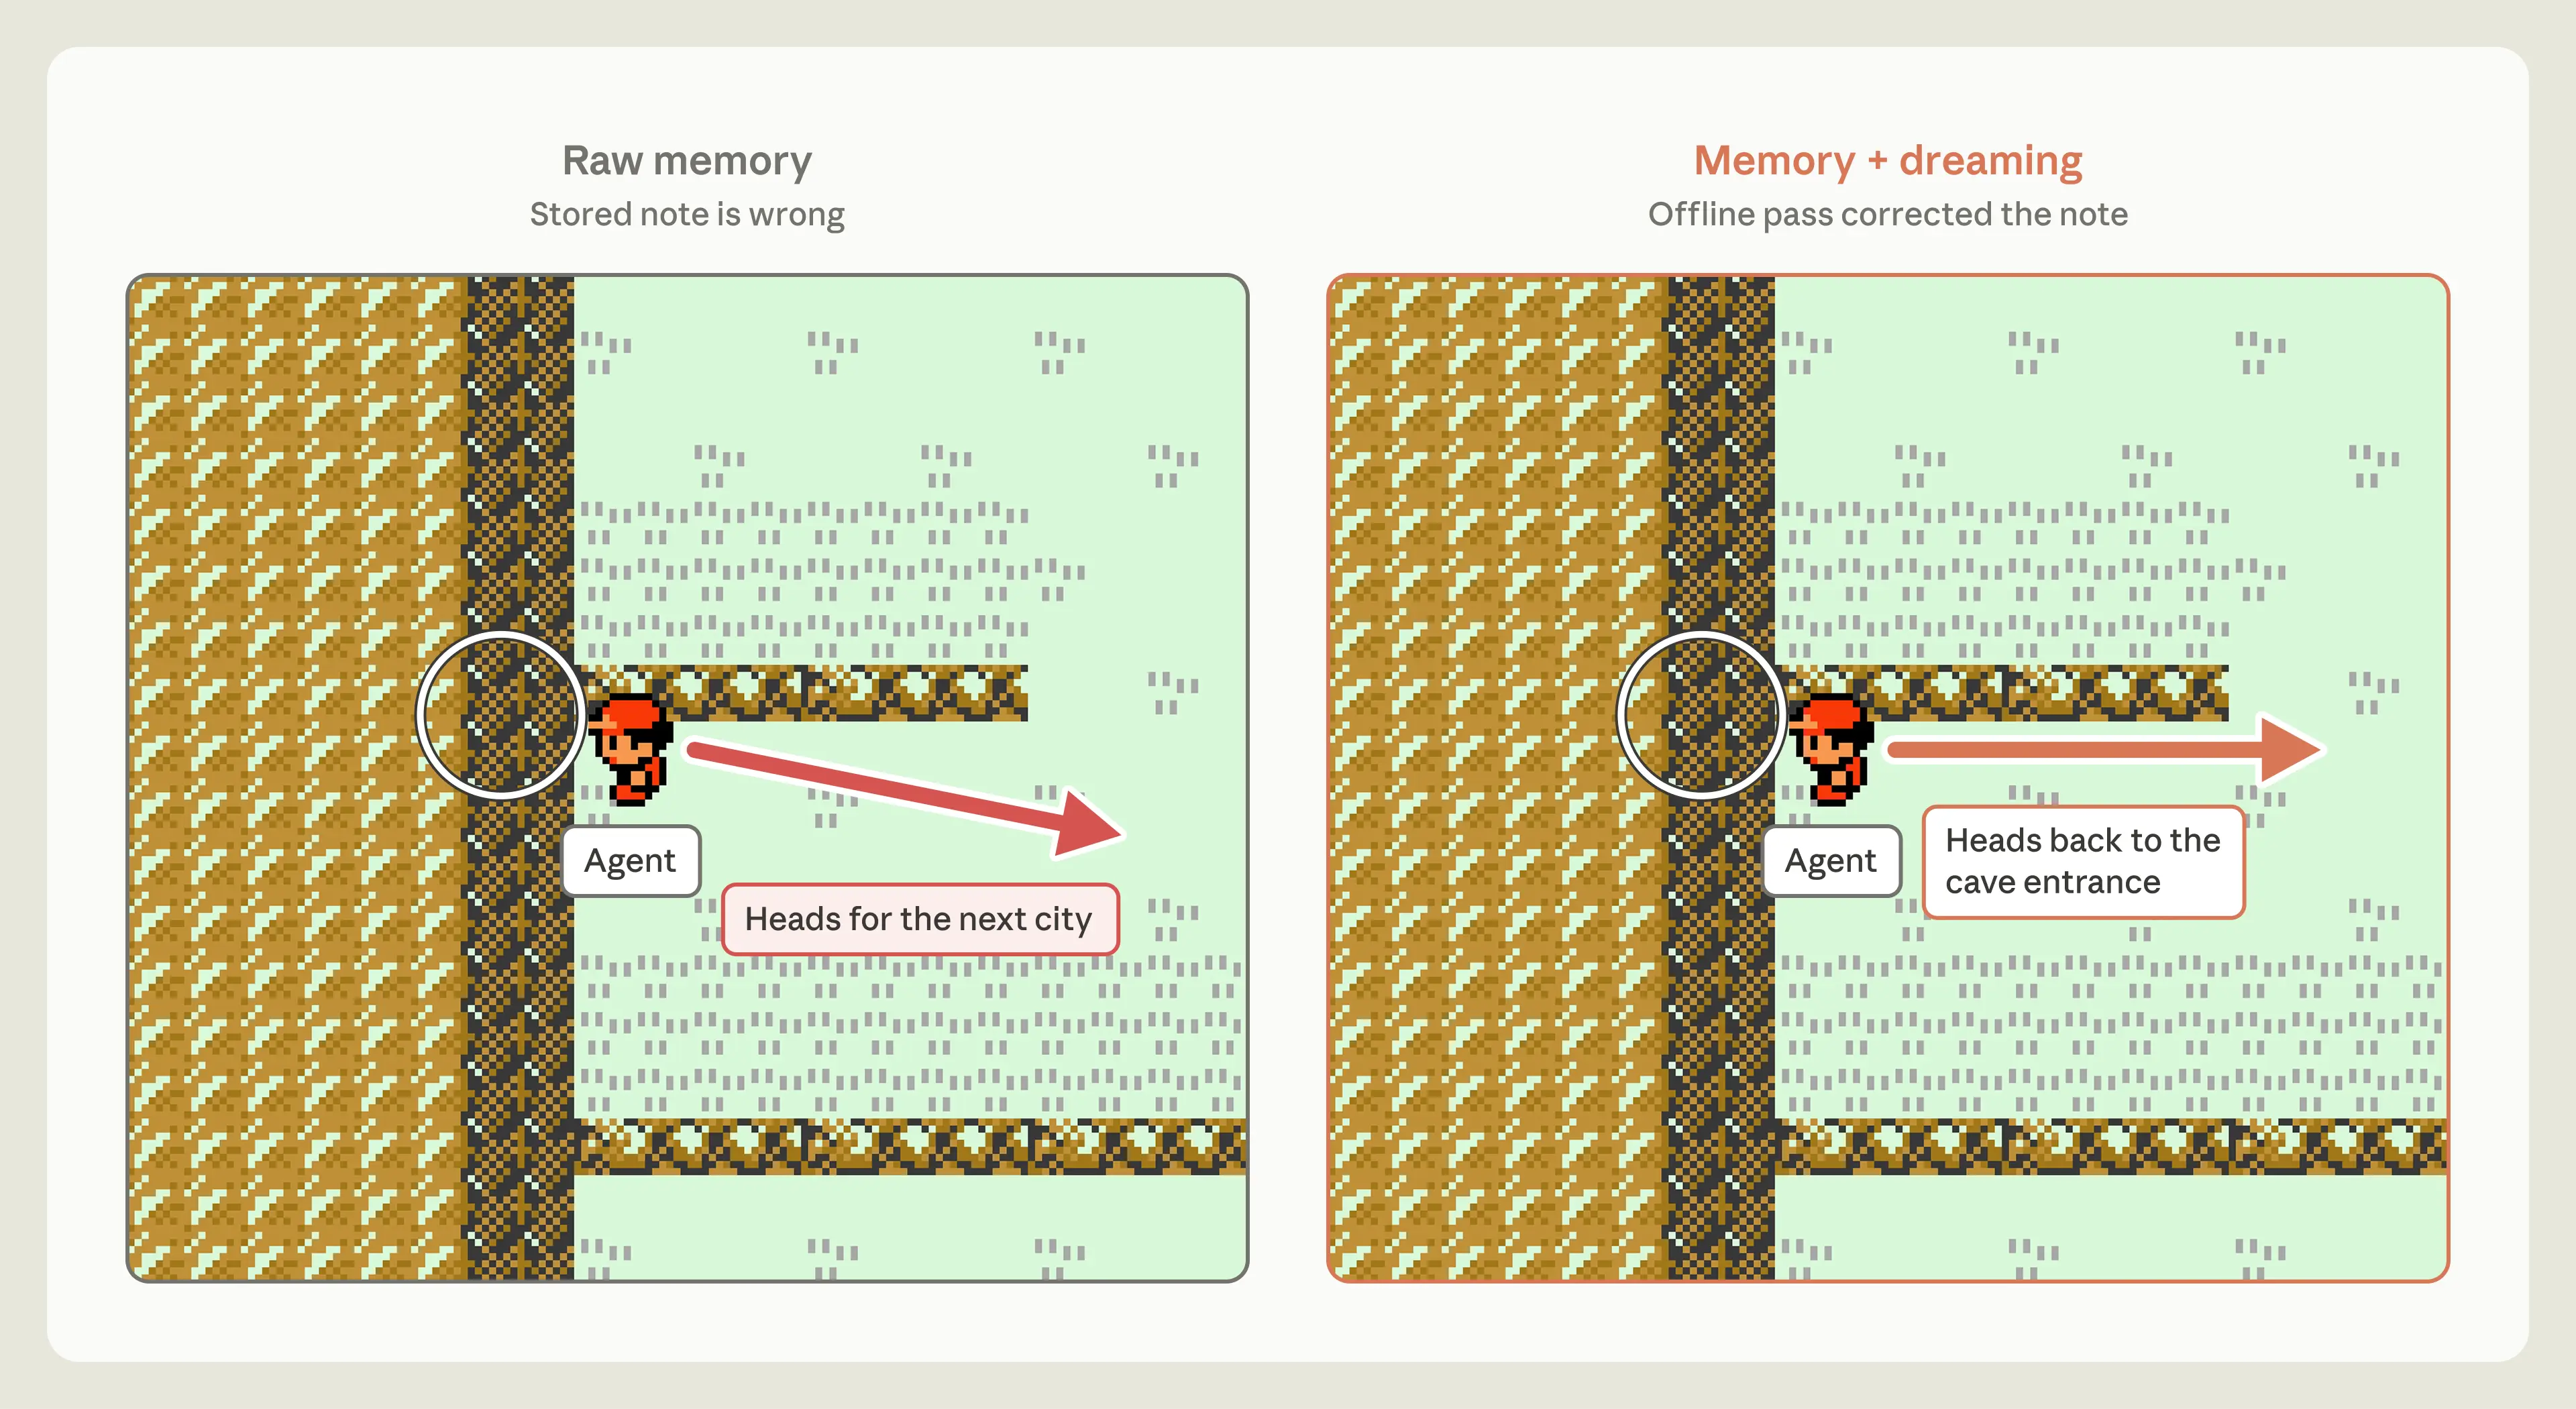
dreaming 跑了一遍之后,Claude 对照原始日志发现自己把中心位置记反了,改写笔记。再跑一次,它直接走回山洞入口,后来到达了华蓝市。
这里的关键是日志提供了 ground truth。模型不会凭空知道自己记错了,它需要一个可以回头对照的原始记录。
Wiki 不一定越大越好
Anthropic 还试了用 dreaming 让 Claude 自己建 wiki。他们拿了一家被收购公司 Stainless 的内部文档做语料,大约 35 万个文件、4.2 亿 token。Claude 分 128 个会话逐步搭建和维护 wiki,回答 25 个问题的得分从 13% 涨到 48%。
但 wiki 不是万能的。在 Harvey LAB 的法律文档任务里,如果问题需要跨多份文档综合判断,wiki 有明显帮助:得分 87%,纯搜索是 73%。如果答案基本能从单一文档里搜出来,wiki 就没有清晰优势。
更尴尬的情况也出现了。有一个任务里,Claude 建的 wiki 比原始文档还大,10 份文档 115KB,wiki 长到 203KB,膨胀到 1.77 倍。Anthropic 拿博尔赫斯那个一页纸的短篇来打比方:地图画得和帝国一样大,就等于什么都没抽象。
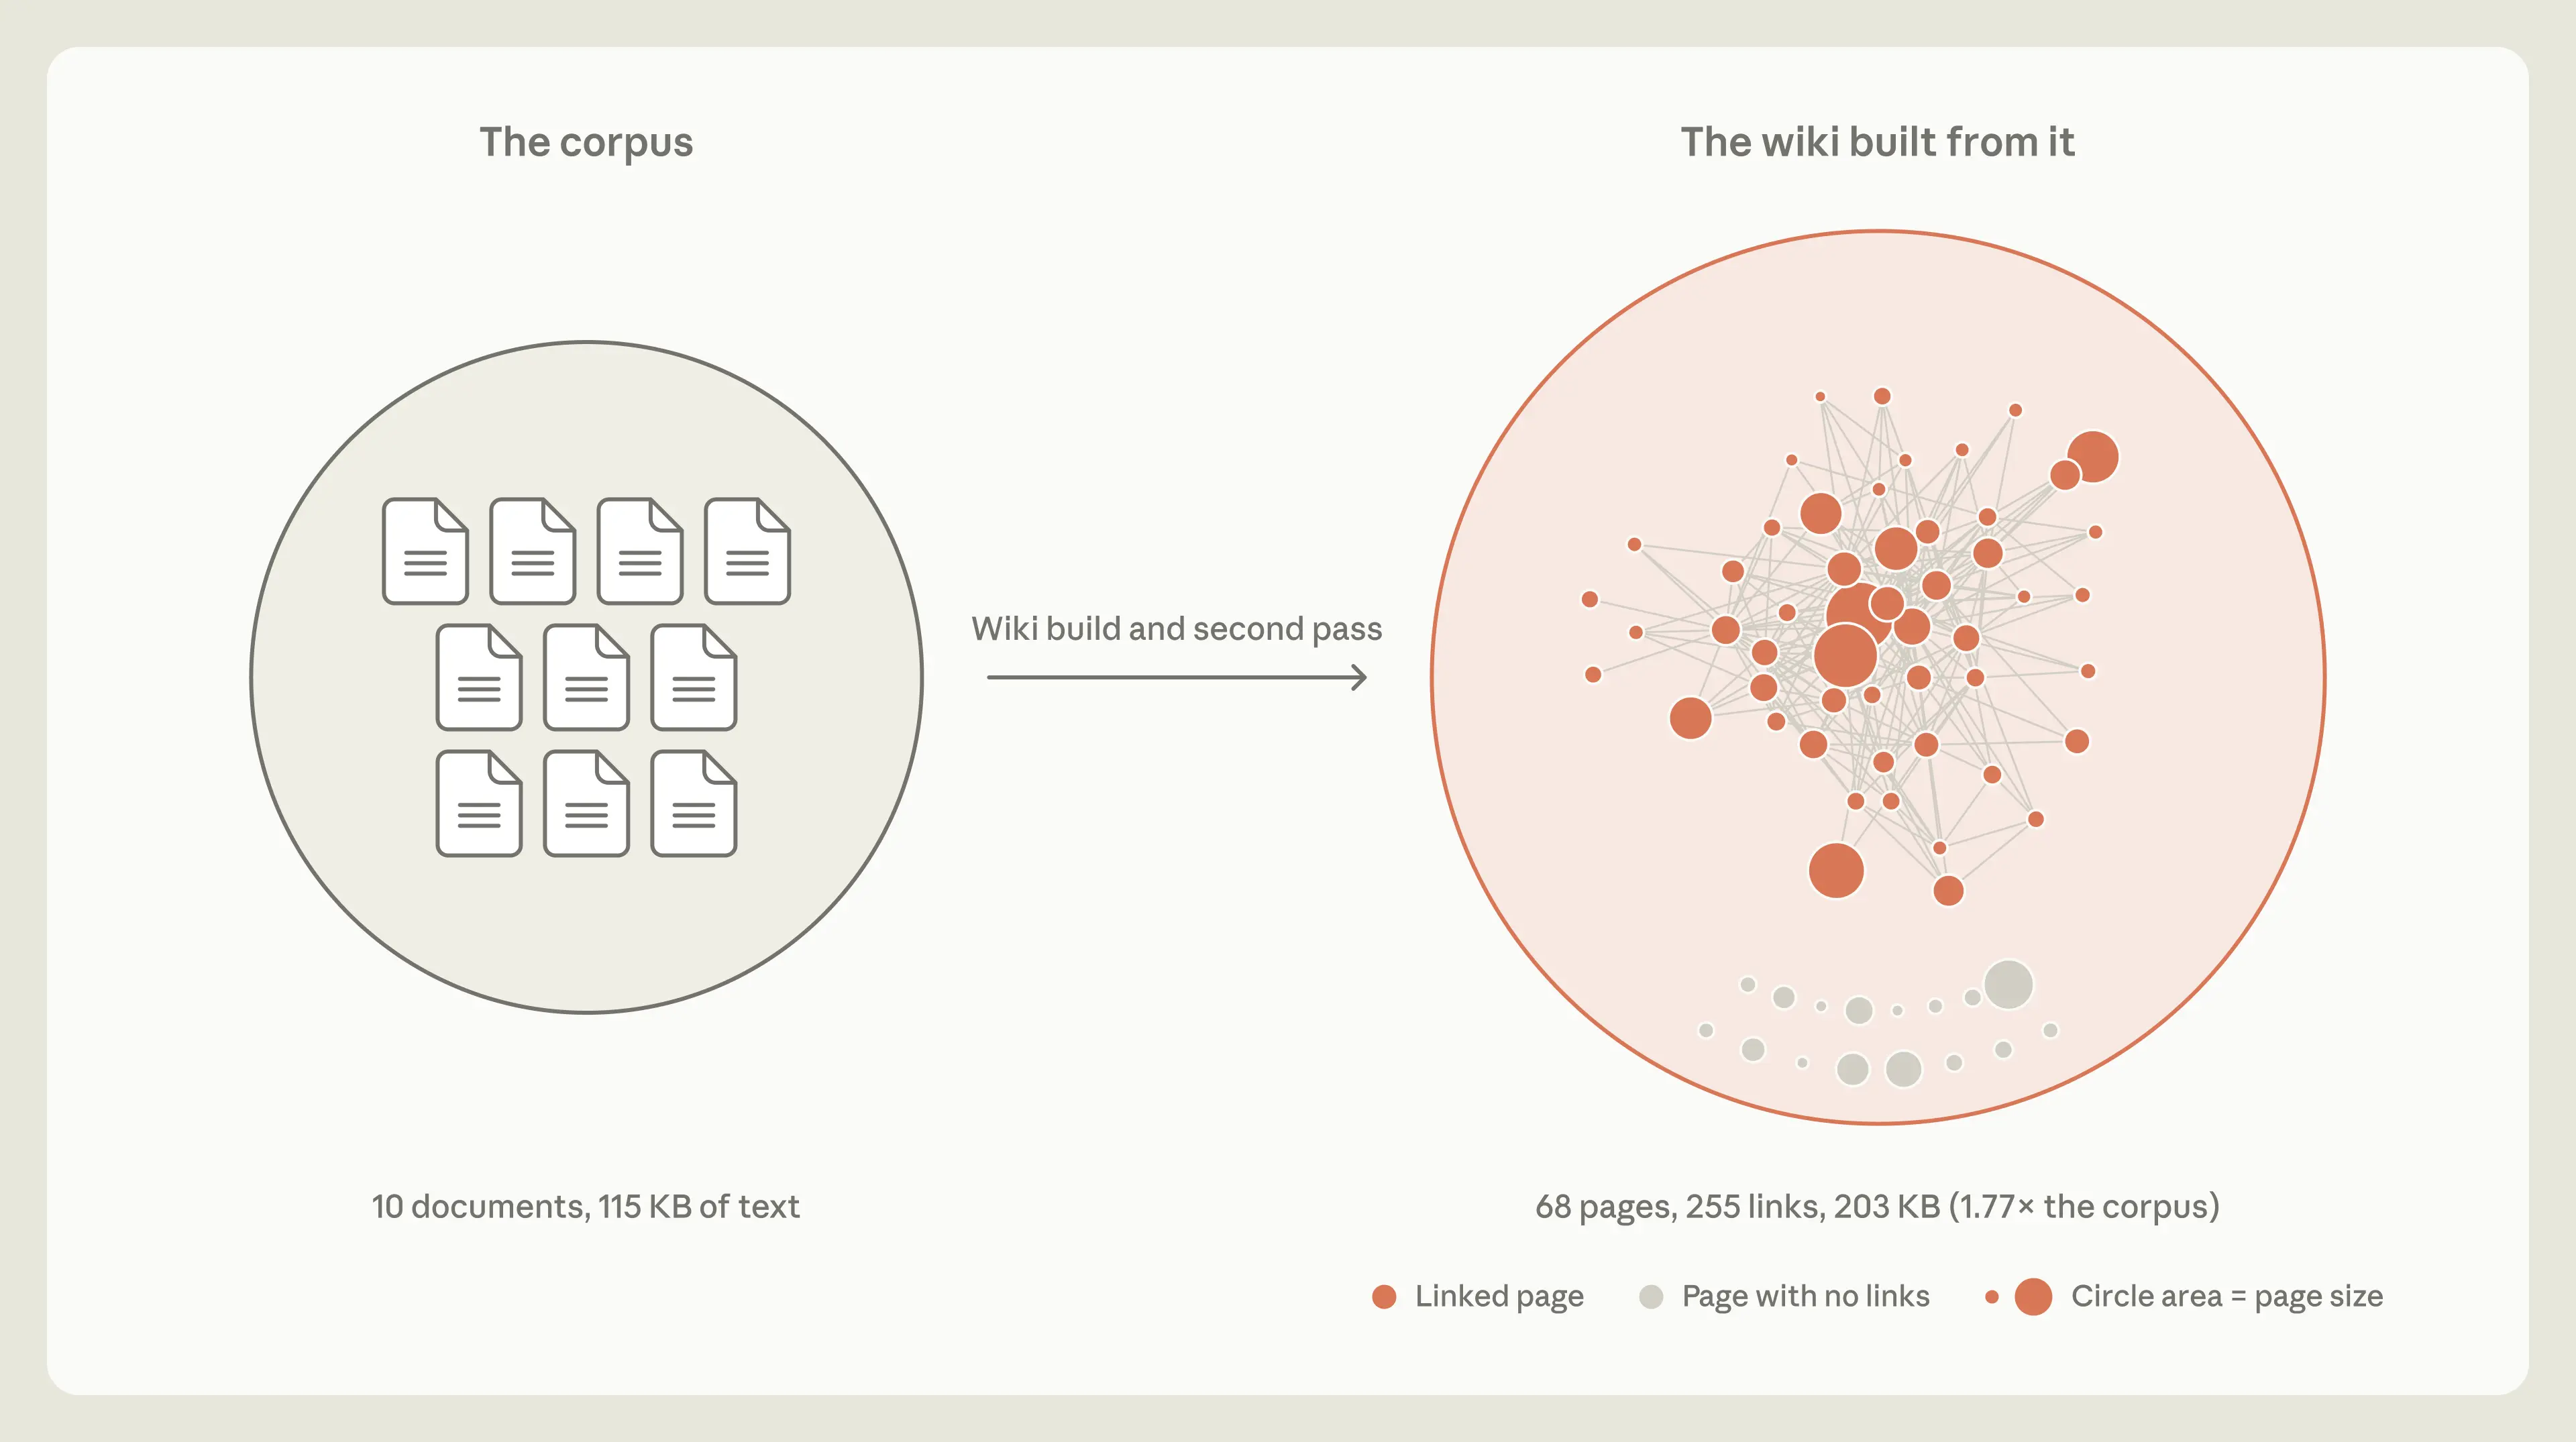
还有一个多 agent 协作的坑。在并购合同任务里,几个 agent 同时往同一个共享条款页面写内容,互相覆盖,最后只有 41/57 条评分事实被保留下来。改成每份合同由单个 agent 负责、逐字引用条款之后,57 条全部保住。
这说明记忆系统的失败往往不是模型记不住,而是协作和抽象层设计得不好。
该告诉它「为什么记」,别规定「记什么」
Anthropic 在 CL-Bench 数据库任务上试了一件事:给模型加一条「只记录失败」的规则。结果 Opus 5 从记忆里获得的性能增益下降了 0.234,Opus 4.7 下降了 0.150。规则反而削弱了记忆的价值。
他们得出的经验是,告诉 Claude 记忆是用来干什么的,把判断哪些值得记的权力留给模型,效果比预设固定规则好。对老模型,适当引导确实有用,比如提醒 Sonnet 4.6 先读记忆再回答,它的分数几乎翻倍。但新模型基本自己就会读。
这背后有个挺微妙的转变:记忆本身是一种对未来的预测。写下一个规则,等于赌它以后还会用得上。模型判断什么值得记的能力,本质上就是判断什么会重复出现的能力。这种判断目前靠模型自己比靠人写死规则更靠谱。
还没解决的问题
Anthropic 自己也列了几个开放问题。什么时候写记忆?当场写能抓住细节,但会打断主任务;放到 dreaming 里写不占当前注意力,但产出不能立刻用。怎么保证记忆不过期?全量校验太贵,可能要按访问频率或者信息变化速度来决定 dreaming 的节奏。
还有一个根本矛盾,任何模型都没法真的知道未来几轮会发生什么。dreaming 给的是回头的机会,用算力换整理和纠错。记忆系统会随着模型能力一起变,现在远没到定论的时候。
如果硬要提炼一句,大概是:让 agent 记住更多东西不难,让它记住对的东西、并且知道什么时候不该信自己记的东西,才是难点。Sonnet 3.7 那 413 个文件就是提醒。
参考来源:Anthropic Engineering Blog,The components of agent memory,2026 年 11 月 6 日。
发布时间: 2026-11-07 13:29