OpenAI 发了个湿实验基准,评论区在问 6.2 在哪
OpenAI 与 Ligo 发布 BioBasicsBench,用 100 个真实湿实验任务测 AI agent 能否读胶图、认对照、判断证据不足。GPT-6 Astra 在 xhigh 下拿到 66.7%,仍会在菌落计数上多算约 12%,也会让假设压过对照。
OpenAI 11 月 6 日发了 BioBasicsBench。它和生物技术公司 Ligo 合作,拿 100 个真实湿实验任务,测 AI agent 能不能看懂原始实验数据。发布帖配了图,评论区先问另一件事:GPT-6.2 在哪。有人贴视频追问 Astra 和 Sol,有人说看到头像以为要发 6.2。一个基准发布撞上模型期待,传播重心立刻偏了。

一条回复直接贴视频追问 Astra 和 Sol。
BioBasicsBench 不考论文里挑好的图表。任务来自实验室日常:凝胶图、培养皿照片、显微图栈、测序 FASTQ、酶标仪导出、实验台操作视频。100 个任务分五块:蛋白方法、成像与流式、定量与检测、核酸方法、分子克隆。每个任务由科学家用自己的实验数据写成,配专家评分标准,经过 Ligo 内部交叉审、外部湿实验室 PhD 审、最终内部审。答案按 rubric 给分,结论、数值、推理、识别证据不足都算分。
官方评测七个模型,37 个模型与推理强度设置,每个设置 100 任务各试 5 次,共 18,500 条结果。xhigh 设置下 GPT-6 Astra 平均拿到 66.7% 可用分,GPT-5.6 Sol 是 43.8%。Astra 每任务输出 4,704 tokens,Sol 是 9,099。分数和 token 效率一起看,Astra 的提升更明显。官方判断,原生多模态能力可能是处理日常湿实验分析的关键。
| 模型 xhigh | 平均分 | 95% CI | 输出 tokens/任务 |
|---|---|---|---|
| GPT-6 Astra | 66.7% | 60.3–73.1% | 4,704 |
| GPT-6.1 Sol | 62.0% | 55.6–68.4% | 5,238 |
| GPT-5.6 Sol | 43.8% | 37.6–50.0% | 9,099 |
| GPT-6 Luna | 38.3% | 32.3–44.5% | 13,120 |
| GPT-5.5 | 35.4% | 29.7–41.0% | 11,135 |
| GPT-5.4 | 33.2% | 28.3–38.4% | 13,717 |
| GPT-5.2 | 31.2% | 26.2–36.3% | 27,620 |
分数涨了,实验室就能用吗。官方自己泼了冷水:高 benchmark 分还不等于可靠判断。报告给了几个例子。
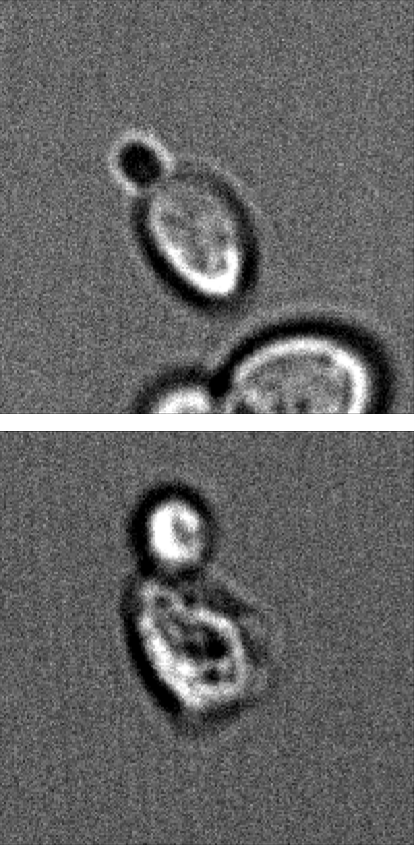
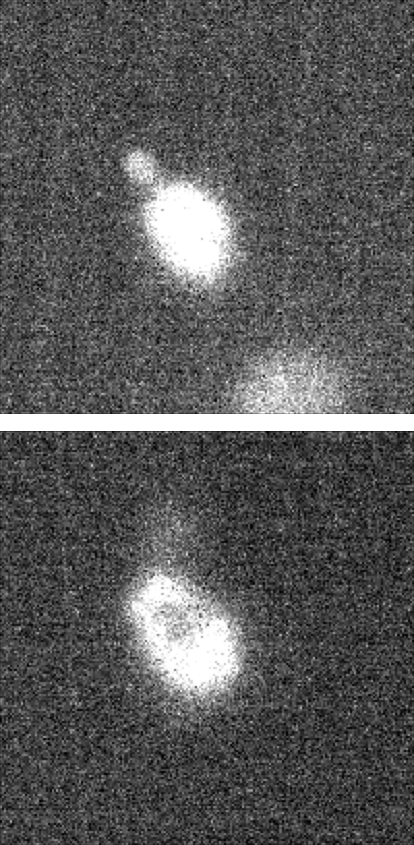
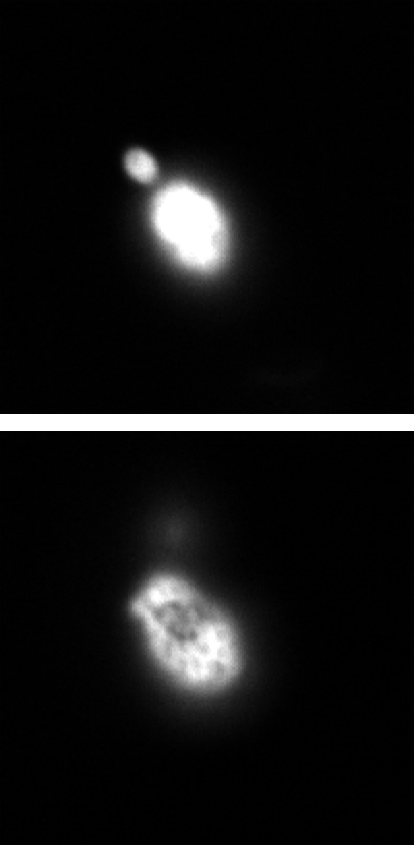
三通道细胞图里,GPT-5.6 Sol 根据死细胞染料信号把细胞判死。检测窗口和另一种染料重叠,亮度本身不能支撑结论。Astra 看出这个模糊点,要求更好的对照把信号分开。
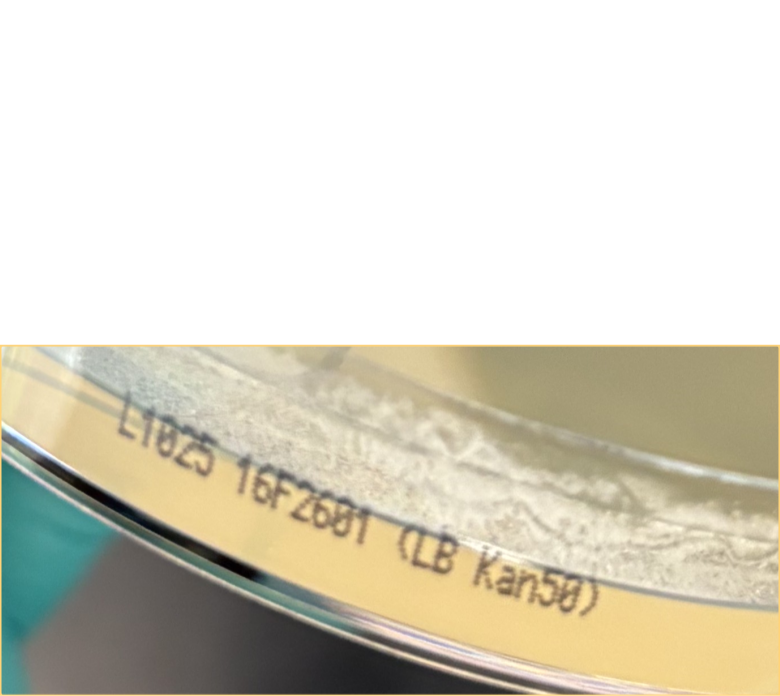
另一个克隆实验,负对照平板没有菌落,Sol 据此下结论。Astra 注意到平板边缘标签写的是 LB Kan50,实验用的是氨苄青霉素。这个负对照不可靠,Astra 拒绝用它。

显微序列里细胞忽隐忽现,Sol 找生物学解释。Astra 认出这是 z-stack,不同深度拍摄的图。


失败案例也具体。colony PCR 凝胶上,Astra 能分出两组条带,却假设更大的 PCR 产物代表成功克隆,选了 lanes 4、6、7、8。参考解释按对照比较选 5、9、10。视觉分组对,实验身份反了,下游会纯化错质粒。

细胞液泡对比任务,Astra 得出液泡通常比周围暗,但同一视野里有更亮的液泡。它检查过矛盾区域,最后仍保留偏好解释。另一个菌落计数任务,Astra 把相邻菌落标成一个、漏掉可见菌落、把空琼脂标成菌落,净结果比参考多算约 12%。涂布体积和稀释固定时,这个误差会同等放大转化效率估计。


BioBasicsBench 的价值在这里:它把读胶图、查对照、判断证据够不够这些日常动作变成可测目标。生物研究加速不靠一句 AGI for science,靠这些动作少出错。评论区还在问 6.2,基准已经指出模型会在哪里翻车。两边都真实。
发布时间: 2026-11-07 13:31