Kinference:给 Kubernetes 上的 vLLM 补一层控制面
Buoyant 开源了 Kinference,一个跑在 vLLM 之上的推理控制面,用声明式推理策略、KV 缓存感知路由和按租户指标解决多租户推理的调度问题。共享前缀负载下中位 TTFT 从 6.88 秒降到 0.31 秒,收益主要来自缓存命中。适合已经在 Kubernetes 上跑 vLLM、受困于缓存复用的团队。
LLM 推理的瓶颈不只在 GPU。vLLM 在 Kubernetes 上跑起来之后,请求怎么路由、缓存怎么复用、每个租户用了多少资源,都是麻烦事。默认的负载均衡按连接数或轮询来,不考虑 KV 缓存的位置。请求被发到没有缓存的 pod,重新做 prefill,TTFT 变长。
Buoyant 最近开源了 Kinference(读作 kay-inference),一个 Apache 2.0 协议的推理控制面,专门解决这层问题。Buoyant 是 Linkerd 服务网格背后的公司,做控制面算是老本行。Kinference 目前面向 Kubernetes 上的 vLLM,结构分两块:一个流量网关,一个推理 handler。handler 暴露 gRPC 接口,收请求、选端点、必要时改请求体,网关用它们自己的 Buoyant Gateway,OpenAI 或 Anthropic 兼容的流量指过去就能用。
核心能力是推理策略(inference policies),用声明式规则描述每个请求该怎么走、该不该被拒绝,可以按租户、模型、GPU 池状态甚至 prompt 的语义标签匹配。规则能提交进 git、能 lint、能单独回滚。官网给的几个典型模式:
- 简单请求路由到便宜模型,但只在这么做比留在贵模型上更省事时才执行,比较的是缓存重叠度
- GPU 饱和时把多余请求弹到 Bedrock 之类的第三方
- 带 PII 标签的请求不离开本地环境,匹配不到就拒绝
- 只在 KV 缓存使用率低于 70% 时接批处理请求
- 模型别名,对外一个稳定名字,背后挂多个模型
大部分规则最后落到 minimize: PredictedTTFT 上,对每个候选端点预测首 token 延迟,结合缓存重叠度和队列长度来选。
KV 缓存感知的负载均衡是重点。它监听 vLLM 的 KV 缓存事件和引擎指标(这块用了 NVIDIA 的 dynamo-kv-router crate),把请求发到已经持有相关 KV 缓存的 pod,减少重复计算。命中缓存就不用重新 prefill,GPU 也更省。
Buoyant 的基准测试里,共享前缀负载的中位 TTFT 从 6.88 秒降到 0.31 秒,降 95%;多轮对话从 1.70 秒降到 0.59 秒,降 65%。中位端到端延迟在共享前缀上降 45%,多轮降 32%。作为对照的没有共享前缀的请求,6.92 秒对 6.83 秒,基本持平,说明收益主要来自缓存命中。对照组里 p95 TTFT 从 21.46 秒降到 12.33 秒,Buoyant 归因于队列感知的均衡,算一个不依赖缓存的附带收益。
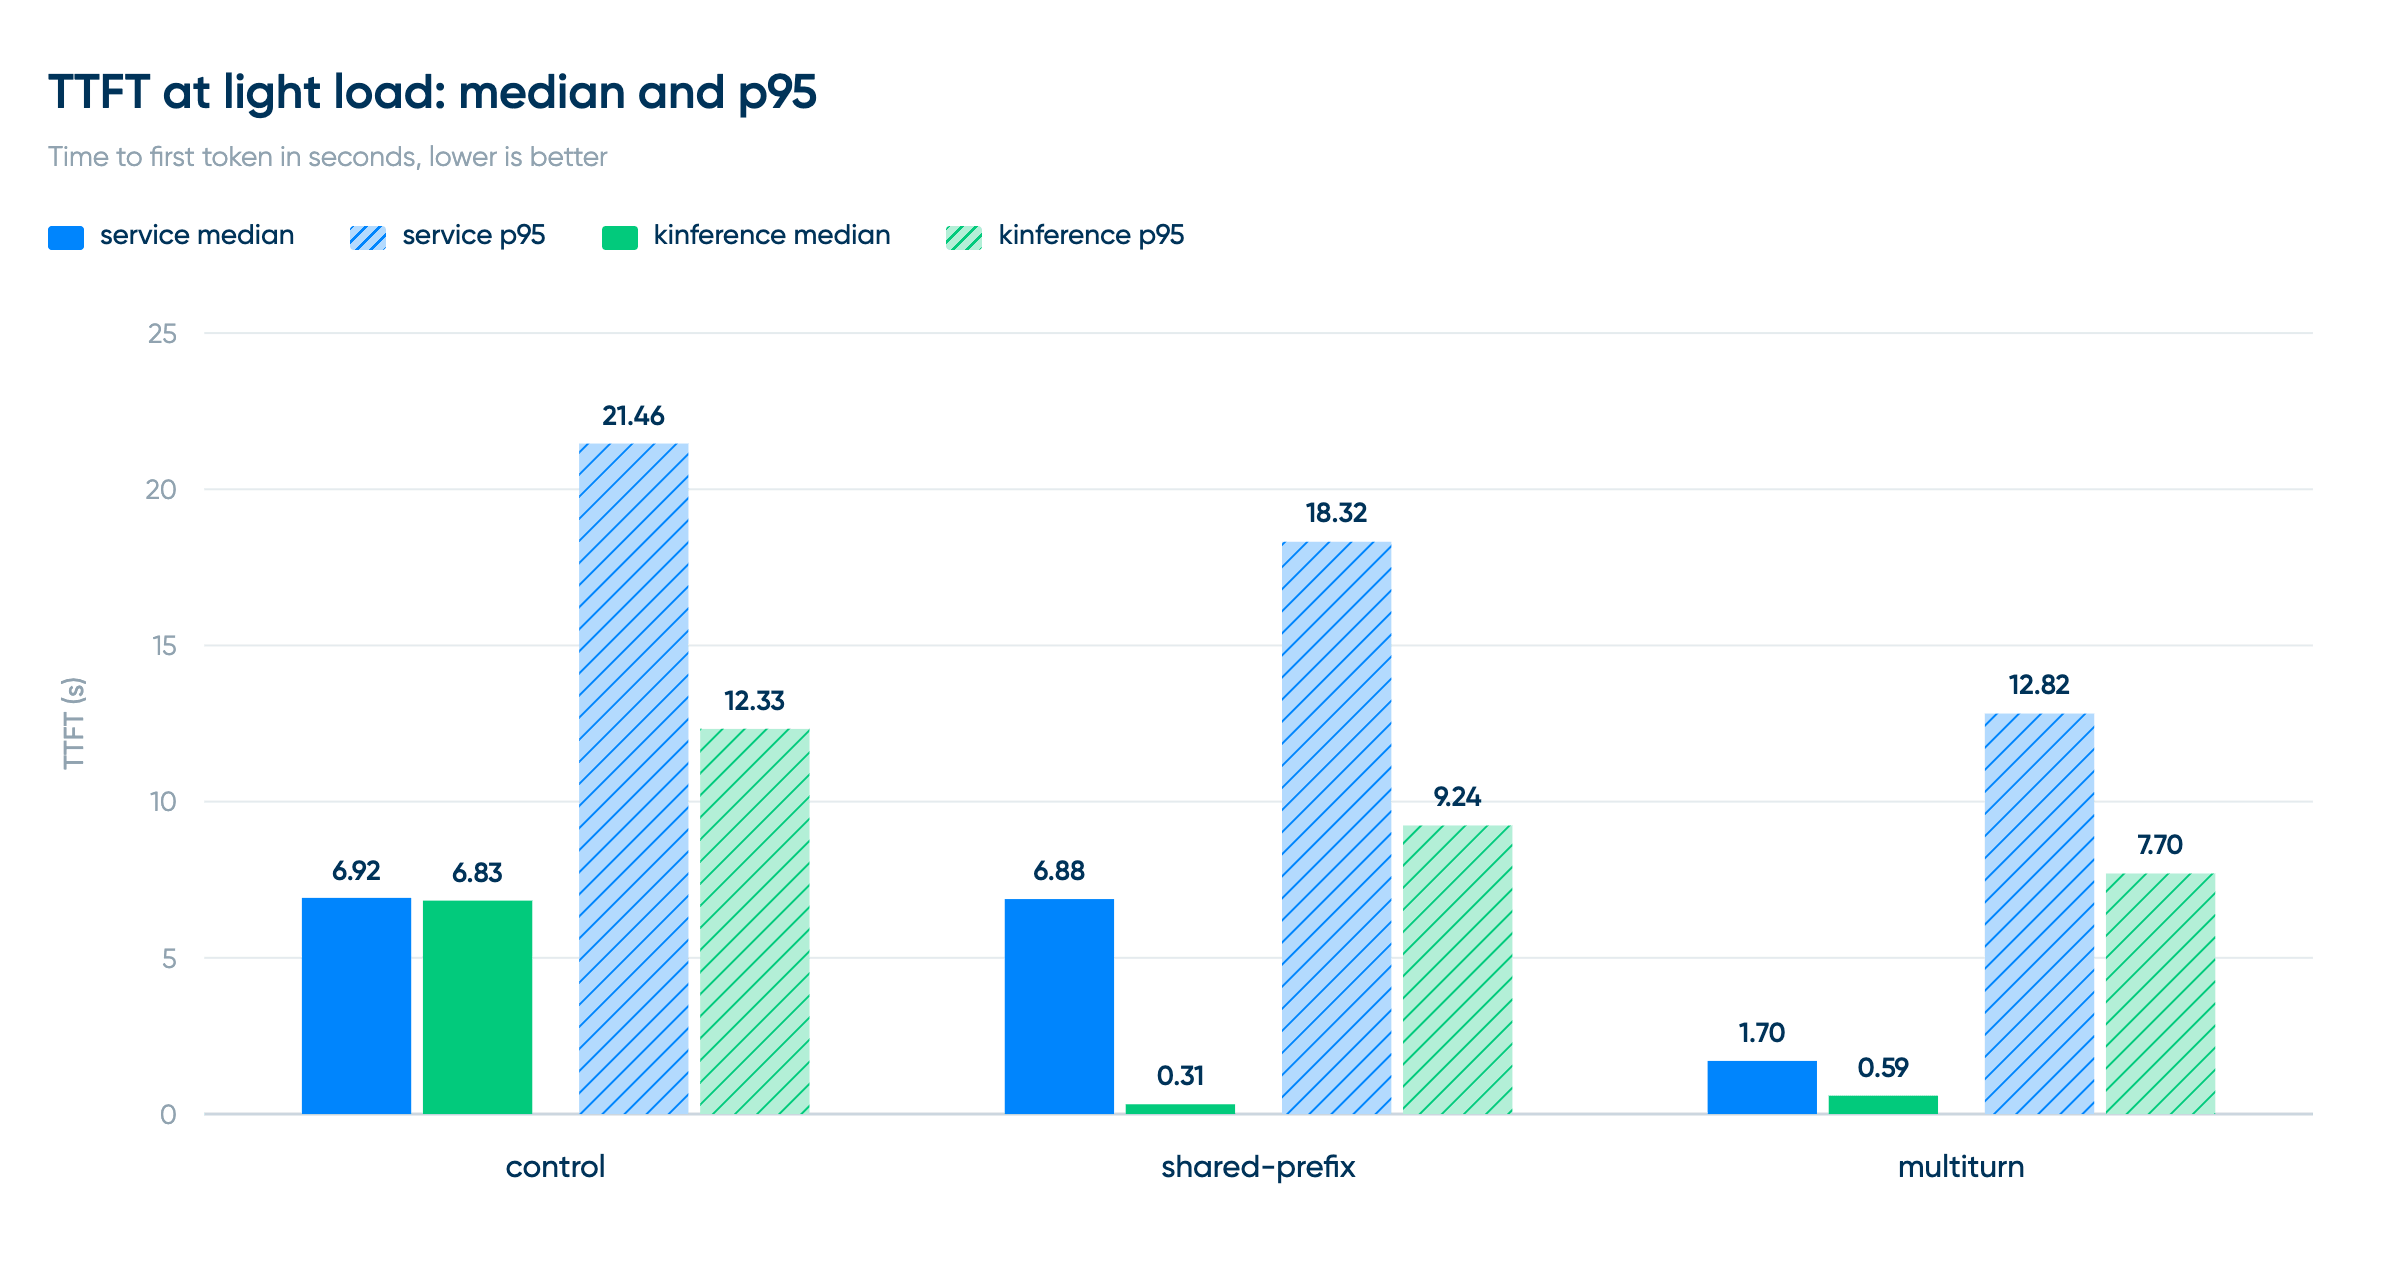
基准配置:基线是 kube-proxy 的 ClusterIP Service,每个连接随机挑一个 pod,这也是很多团队现在的默认配置。每个池 3 块 L40S,vLLM 0.31.0,模型 Qwen3.8-27B-FP8,压测用 GuideLLM,是 Buoyant 自报数据。容量测试里峰值 goodput 从 14 升到 103 请求每分钟(约 7.4 倍),多轮从 23.8 升到 82.7(约 3.5 倍),Service 基线在所有并发下都没达到 SLO。SLO 定的是 8 秒和 4 秒,Buoyant 自己也说这更适合离线 agent,不是聊天。
按租户的指标是另一块实在的东西。token 进出速率、输入输出 token 分布、TTFT/ITL/端到端延迟直方图、缓存命中与未命中的 token,基本都能按租户拆开,方便做用量和成本核算。能力清单里还有 token 限流,不过限流、分类器、Anthropic API 支持这个版本都还没发布。
现在版本是 v0.1.0-alpha.7,Rust 写的,通过 5 个 CRD 配置:GatewayBackend、InferencePolicy、InferencePool、InferenceProvider、InferenceWorkerSet。部署不要求 Linkerd,但能搭配。装起来要走 Gateway API 的 CRD、Buoyant gateway 的 Helm chart、再加 Kinference 的 chart,不是一条命令的事。
同类项目里,llm-d 和 NVIDIA Dynamo 在原始 serving 性能、prefill/decode 分离和引擎覆盖上更领先,Kinference 的差异在治理那一侧:策略、模型别名、供应商兜底、租户核算。
所以 Kinference 适合谁?已经在 Kubernetes 上跑 vLLM,并且遇到路由和缓存复用问题的团队。尤其是多租户、有共享系统提示词、对首 token 延迟敏感的场景。它不是一个装上就提速的魔法组件,控制面本身也有部署和配置成本,收益高度依赖负载形态。
发布时间: 2026-11-07 16:16