同一张图连改100轮,脸还在吗
字节发布 Seedream 5.5,主打多轮编辑稳定、透明底直出和小字更准。测试者用12张图做出会说话的虚拟主播,又拿游客照连修十轮。效果、定价和入口都在下面。
字节跳动 Seed 团队 11 月 9 日发布图像模型 Seedream 5.5。改图最烦的地方很具体:只想换一枚戒指,脸和颜色跟着偏;连续改几轮,画面越来越糊。新版主打没让改的区域像素级不变,官方演示同一张手表照片连改 100 轮,表盘外第 100 轮和原图平均灰度差 1.2,灰度一共 255 级。这个数字来自演示视频截帧,测试者提醒视频压缩会带来误差,1.2 是偏大的估计。
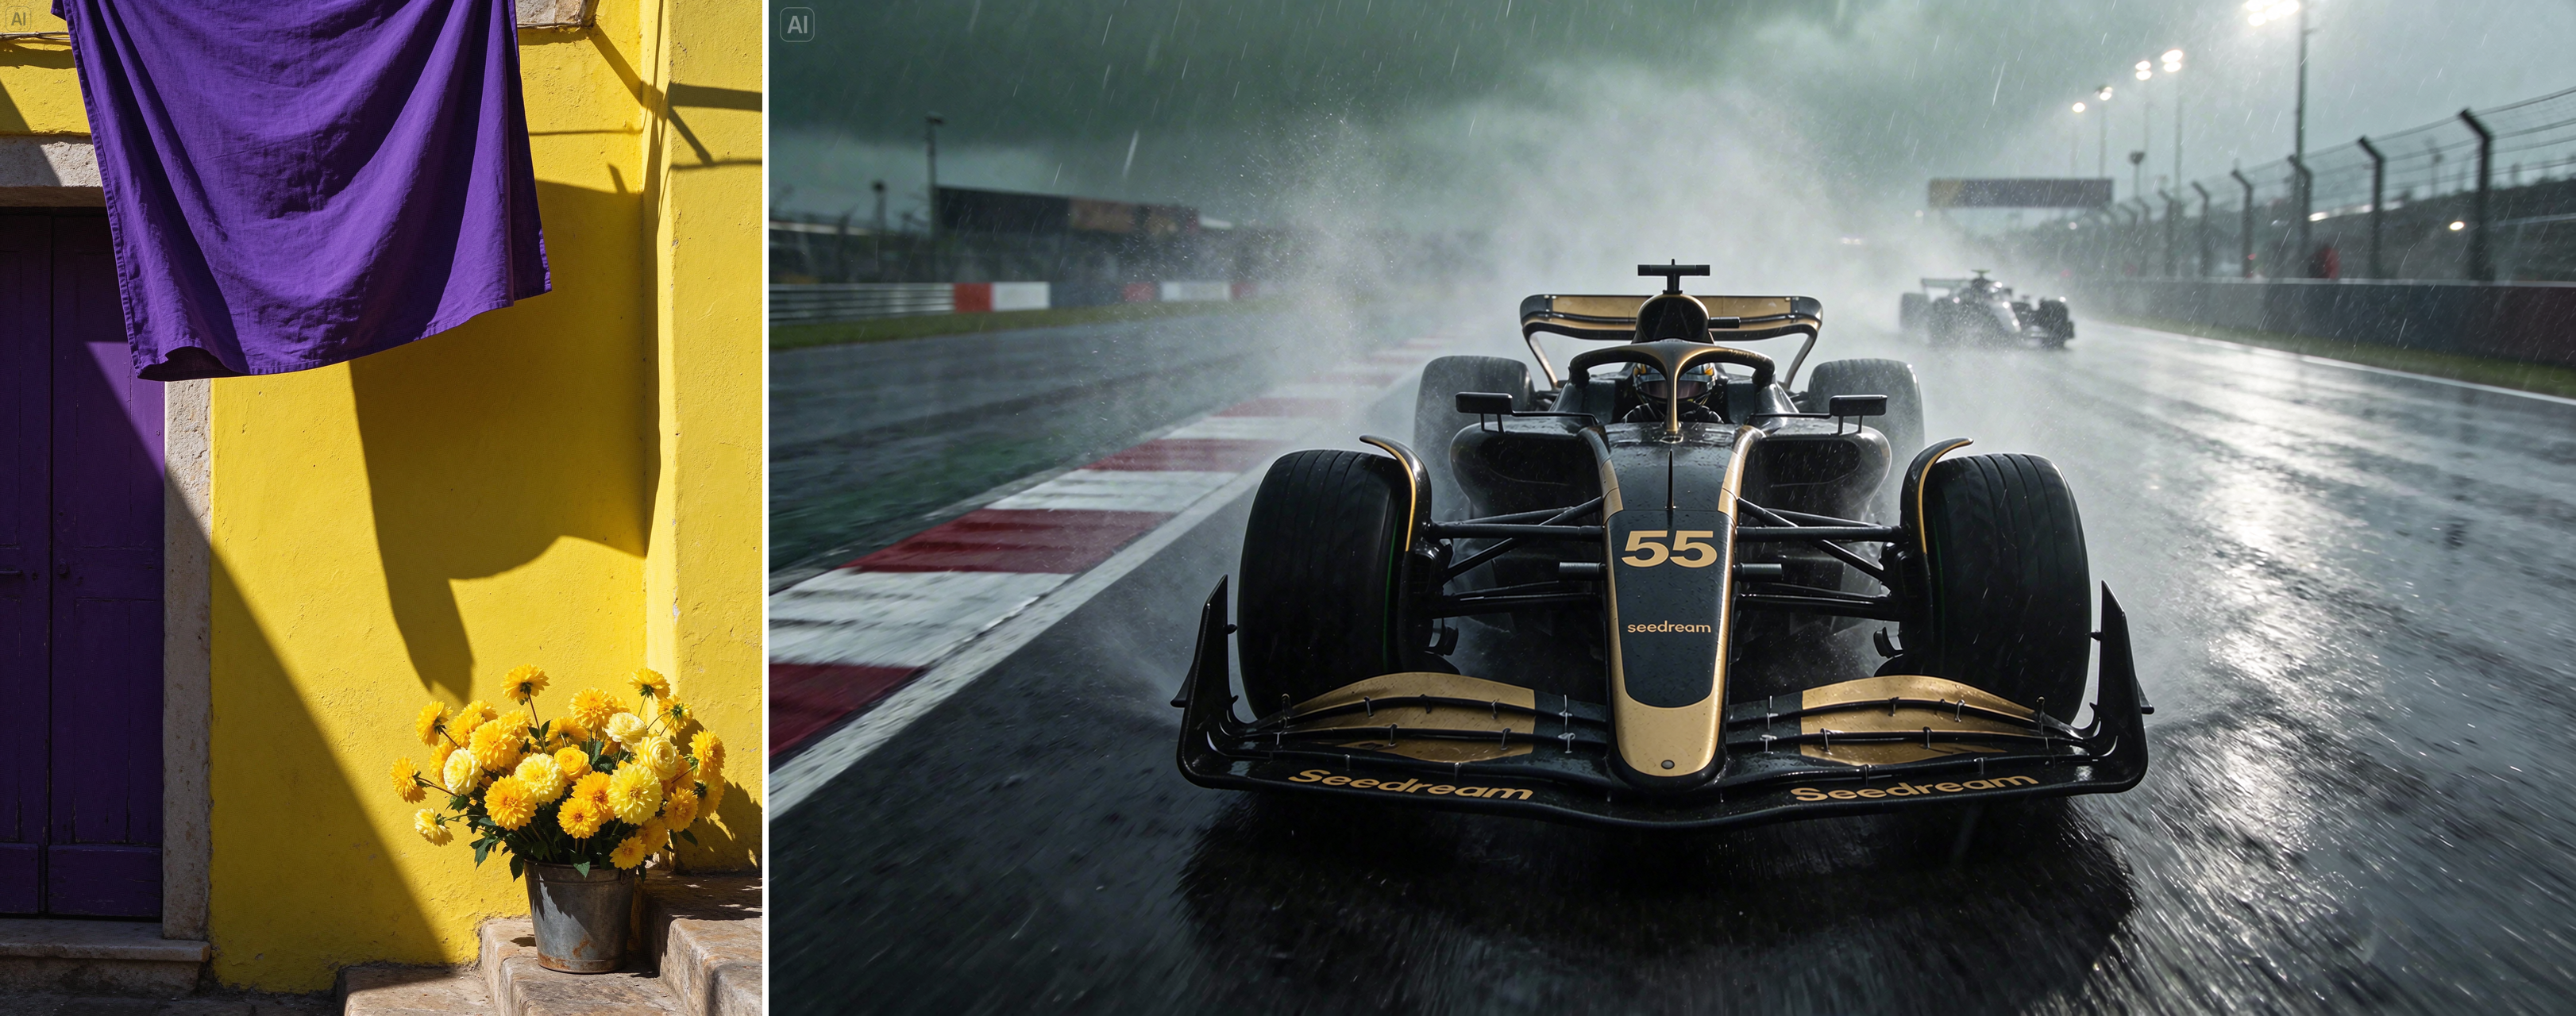
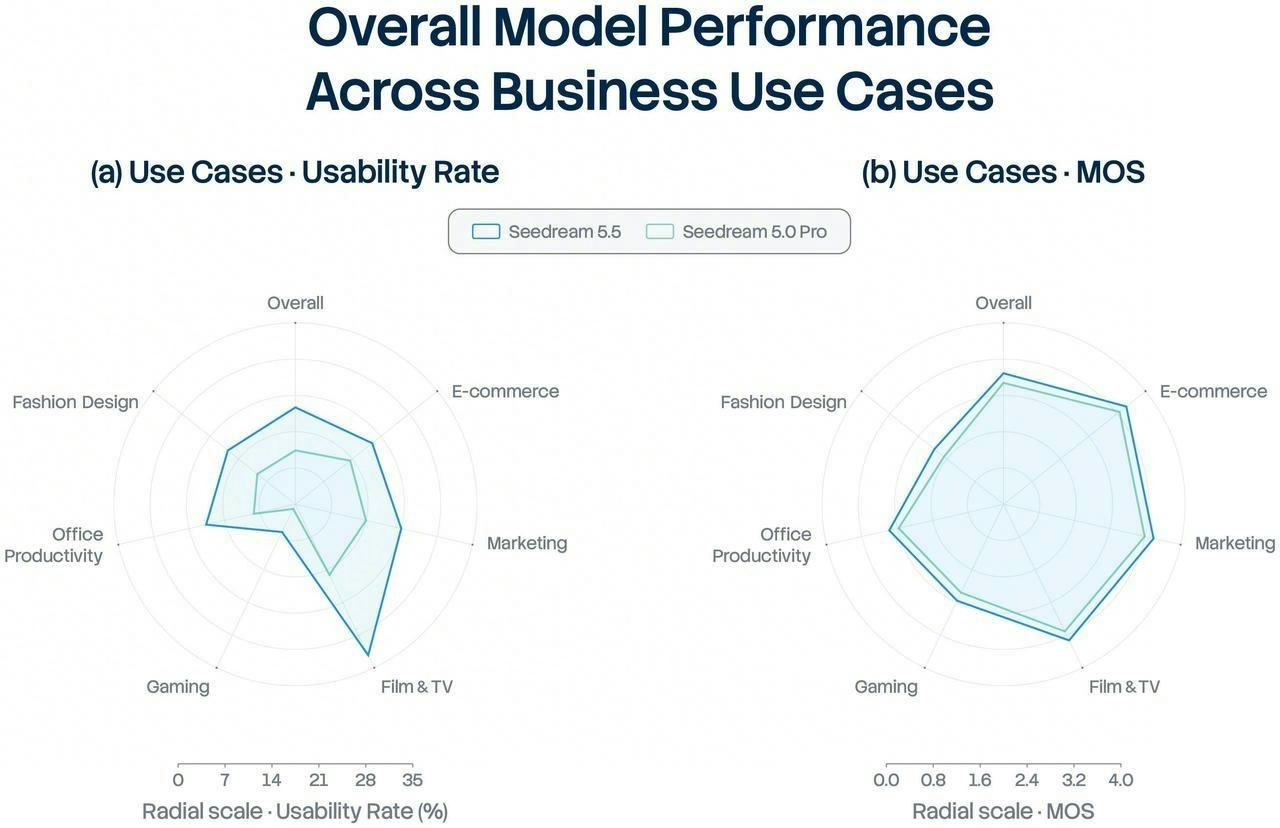
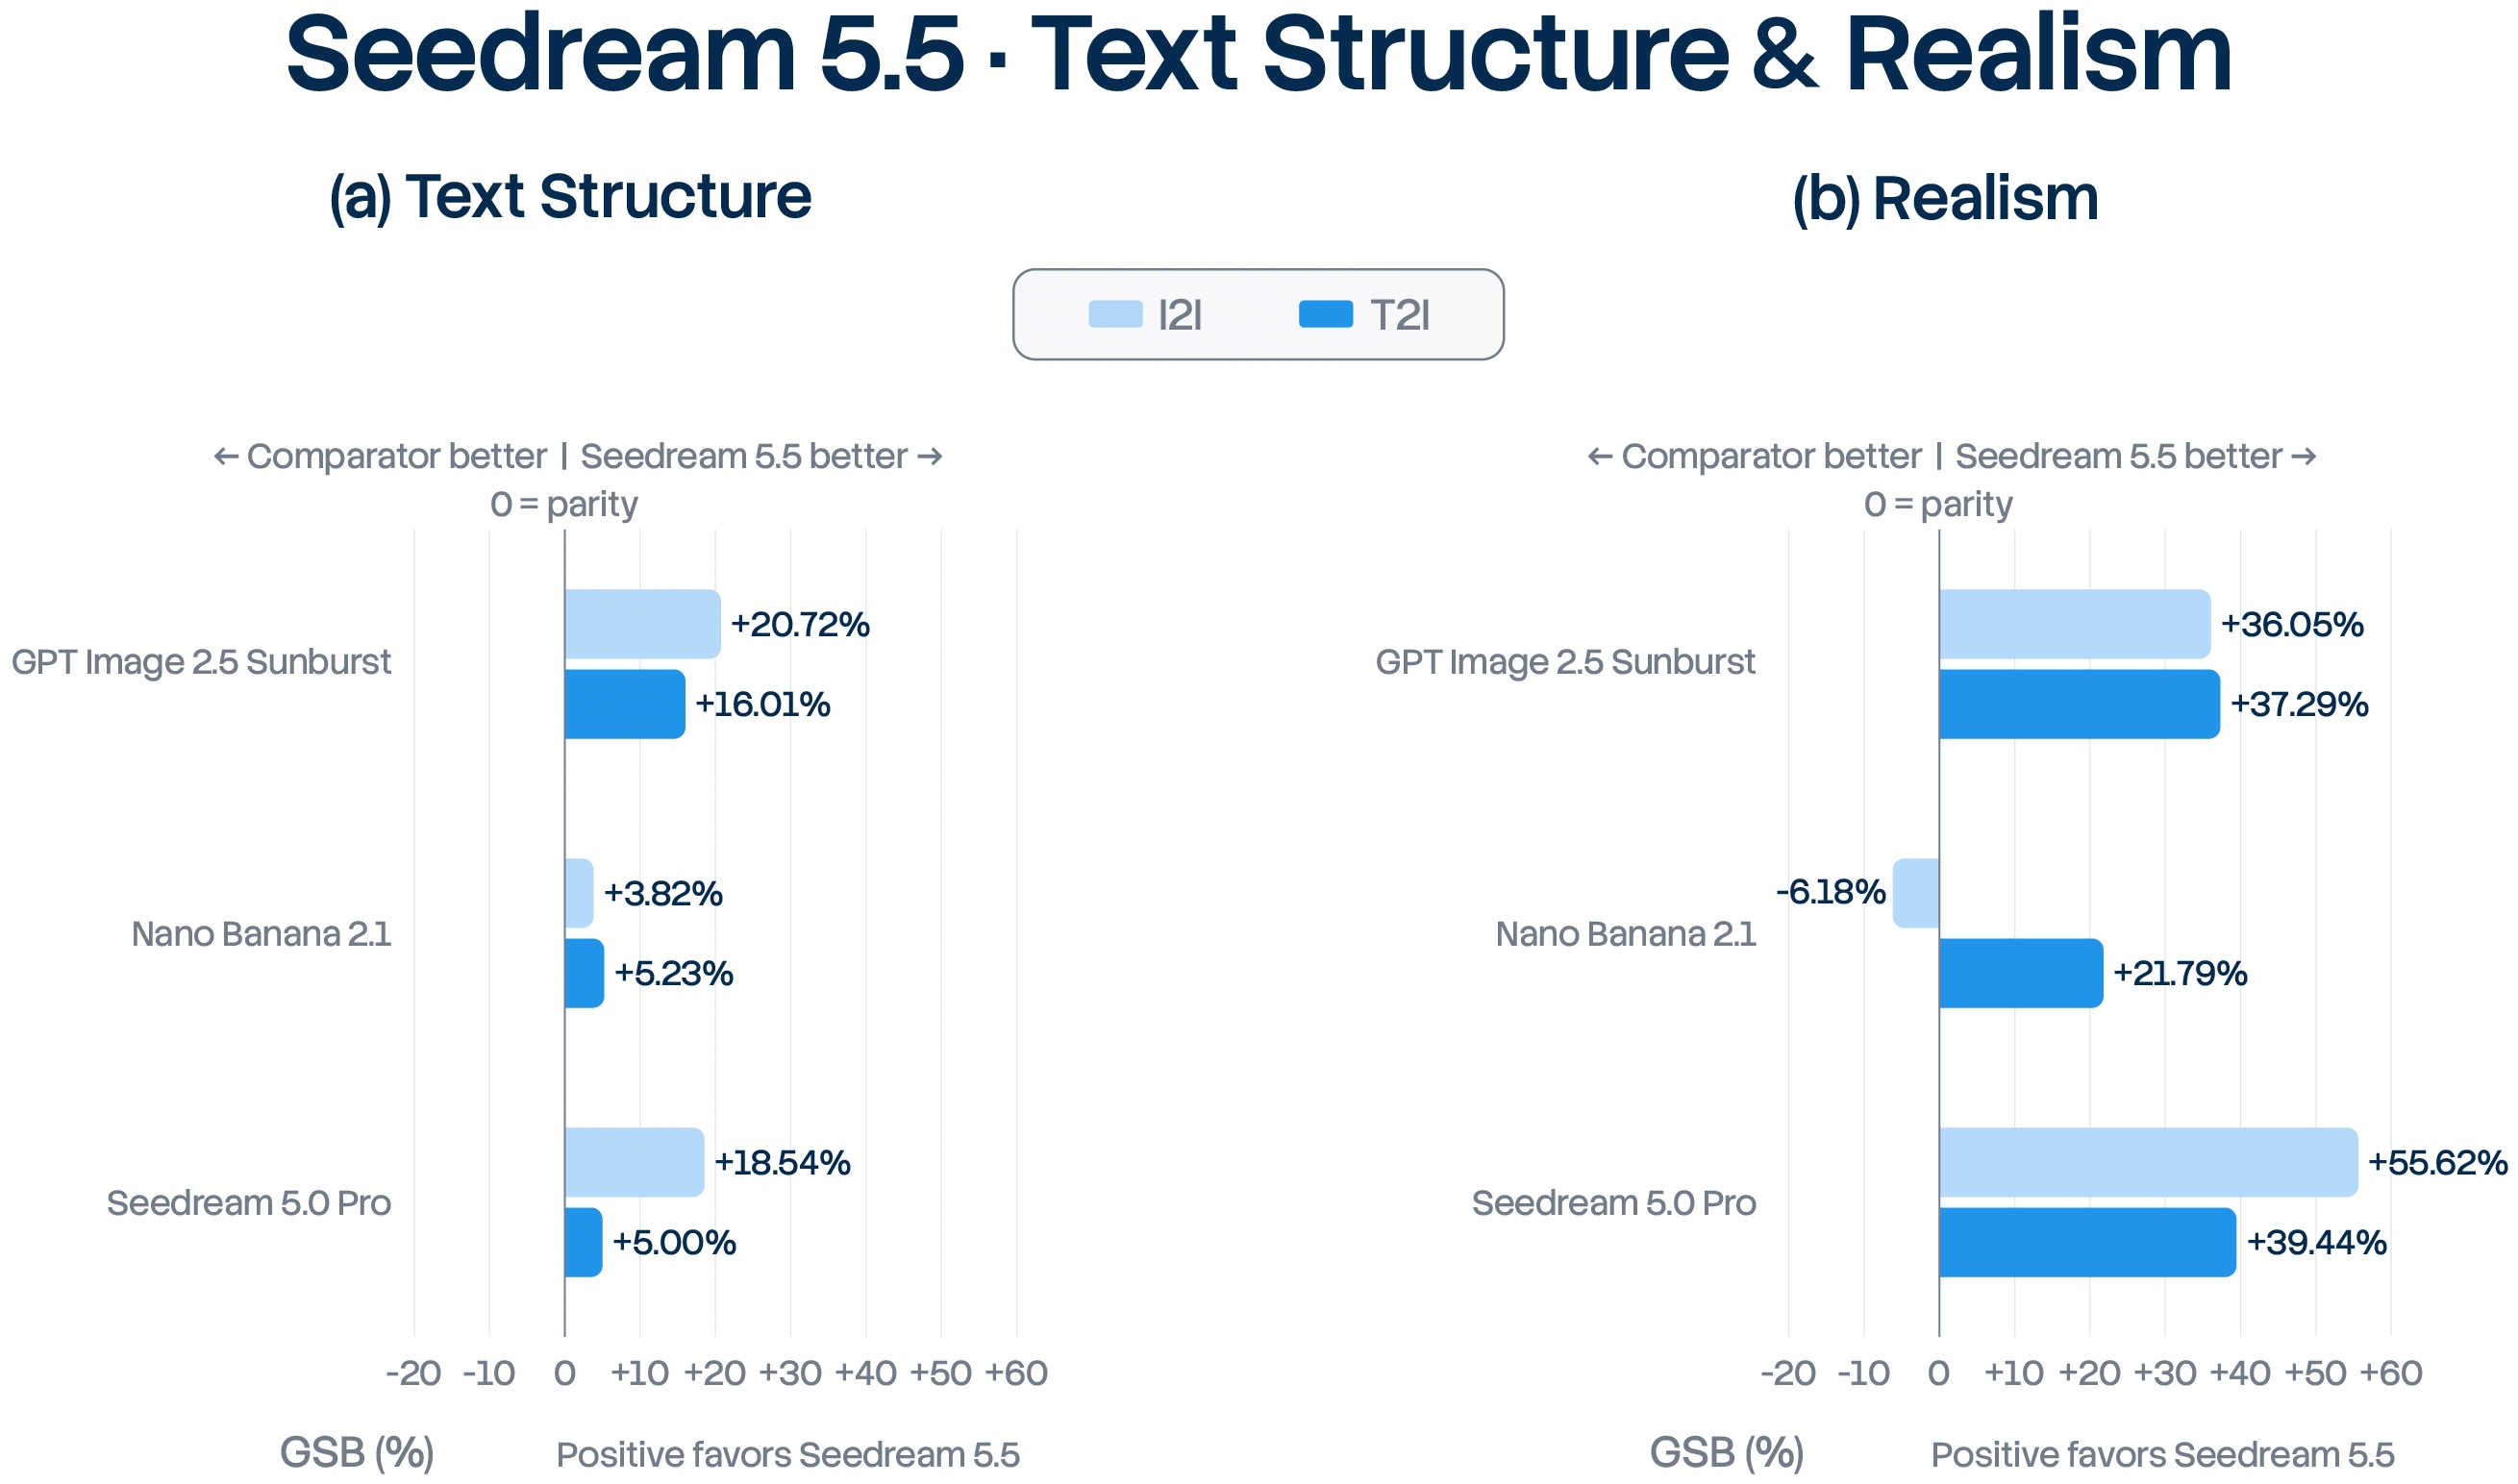
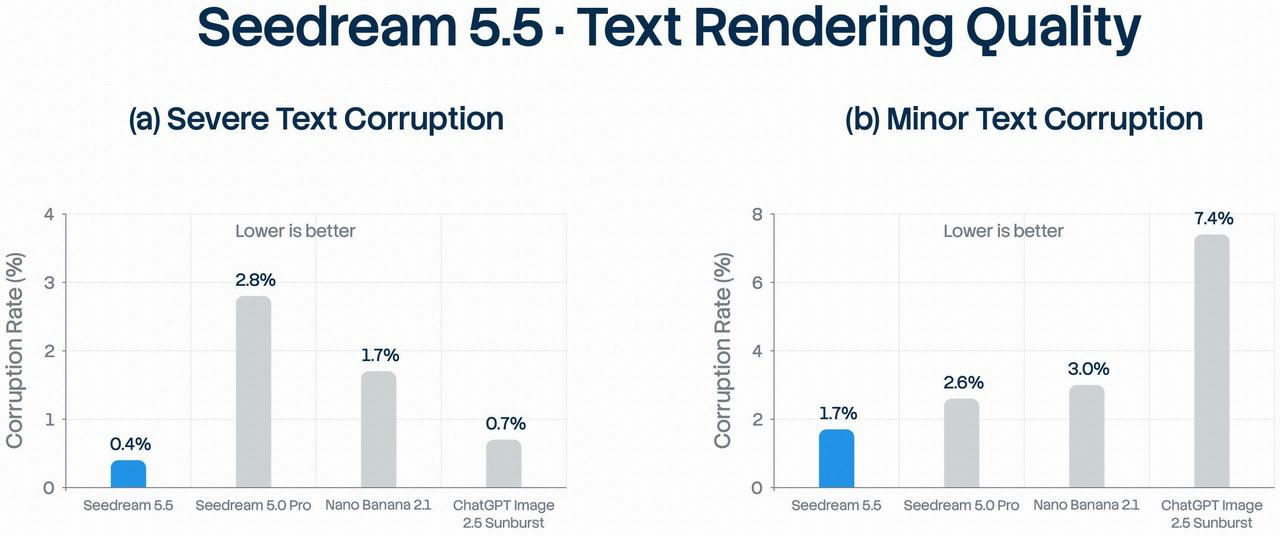
上面是官方演示视频。Seedream 5.5 这次升级集中在几项:多轮编辑稳定,真实感更强,小字和多语言更准,原生 RGBA 透明素材生成,以及动作参考。官方称严重文字错误率从上一代 2.8% 降到 0.4%,轻微文字崩坏率降到 1.7%。它拿 OpenAI GPT Image 2.5 Sunburst、Google Nano Banana 2.1 做对比,文字错误率最低,文生图真实感领先;图生图真实感对 Nano Banana 2.1 还落后约 6%。
模型正陆续上线即梦、豆包、豆包工作。开发者可以在火山方舟试用,模型名 Doubao-Seedream-5.5。API 延续输入图加输出图两段计费,文本 Token 不产生费用。以 2K 方图编辑为例,单张成本约 0.28 元,不到 Seedream 5.0 Pro 一半。官方博客:https://seed.bytedance.com/zh/blog/more-realistic-images-more-stable-editing-across-100-rounds-introducing-seedream-5-5
宝玉在测试文章里做了几组更贴近工作流的验证。第一组用 12 张图拼出一个会说话的虚拟主播。正面像 1 张,另外 11 张各改一处:去掉头发、4 种嘴型、闭眼、5 种表情。每条提示词只生成一次,取第一张,下载 PNG 原图。再用脚本把每张改图和正面像对齐,量改动区域以外的平均灰度差,6 以内算对上。11 张全部合格,有 3 张差值是 0 或 0.01,最大的是惊讶,4.74。去头发那张整片重画,头发以外只变了 0.28% 的像素。脚本把 12 张图拆成 27 个图层,配音用 Gemini TTS,眨眼、呼吸、轻微转头、头发晃动由引擎补上,算法参考开源项目 livliv-dev/player。这个测试想说明一件事:角色图能锁住脸,才敢往后面接嘴型和表情。有网友在回复里说,以前拿 AI 做角色,改十几次等于换十几张脸,每回都得重新认人,脸能锁住,才从抽卡变成干活。
第二组测试更像日常修图。测试者先用 Seedream 5.5 生成一张江南古镇游客照,女生在桥头比剪刀手,正好闭眼,头发挡脸,身后有游客、电线、垃圾桶、电动车、塑料瓶等八样干扰。然后它在即梦同一个对话里连修十轮,前八轮只删东西,最后两轮拨头发、改眼睛。十轮都改成了。八轮改动以外的像素和上一轮逐像素相同,第五轮和第九轮整张图重新画了一遍,平均差 1.7 级和 1.4 级,98% 以上像素在 6 级以内,肉眼看不出来。十轮下来,一次都没让改过的地方占整张图 72%,和底图平均差 2.9 级,90.7% 的像素在 6 级以内,98.9% 在 12 级以内。前八轮没让动的脸,第八轮和底图平均差 1.7 级。第十轮只改眼睛,脸的其他部分和第九轮逐像素相同。结果里也有小偏差:删游客时水里倒影也一起删了,提示词没提倒影;底图有三个塑料瓶,提示词写两个,结果三个都删了;第九轮要求拨开挡脸的几缕头发,模型把被风吹乱的碎发也梳顺了,长度和发色没变。
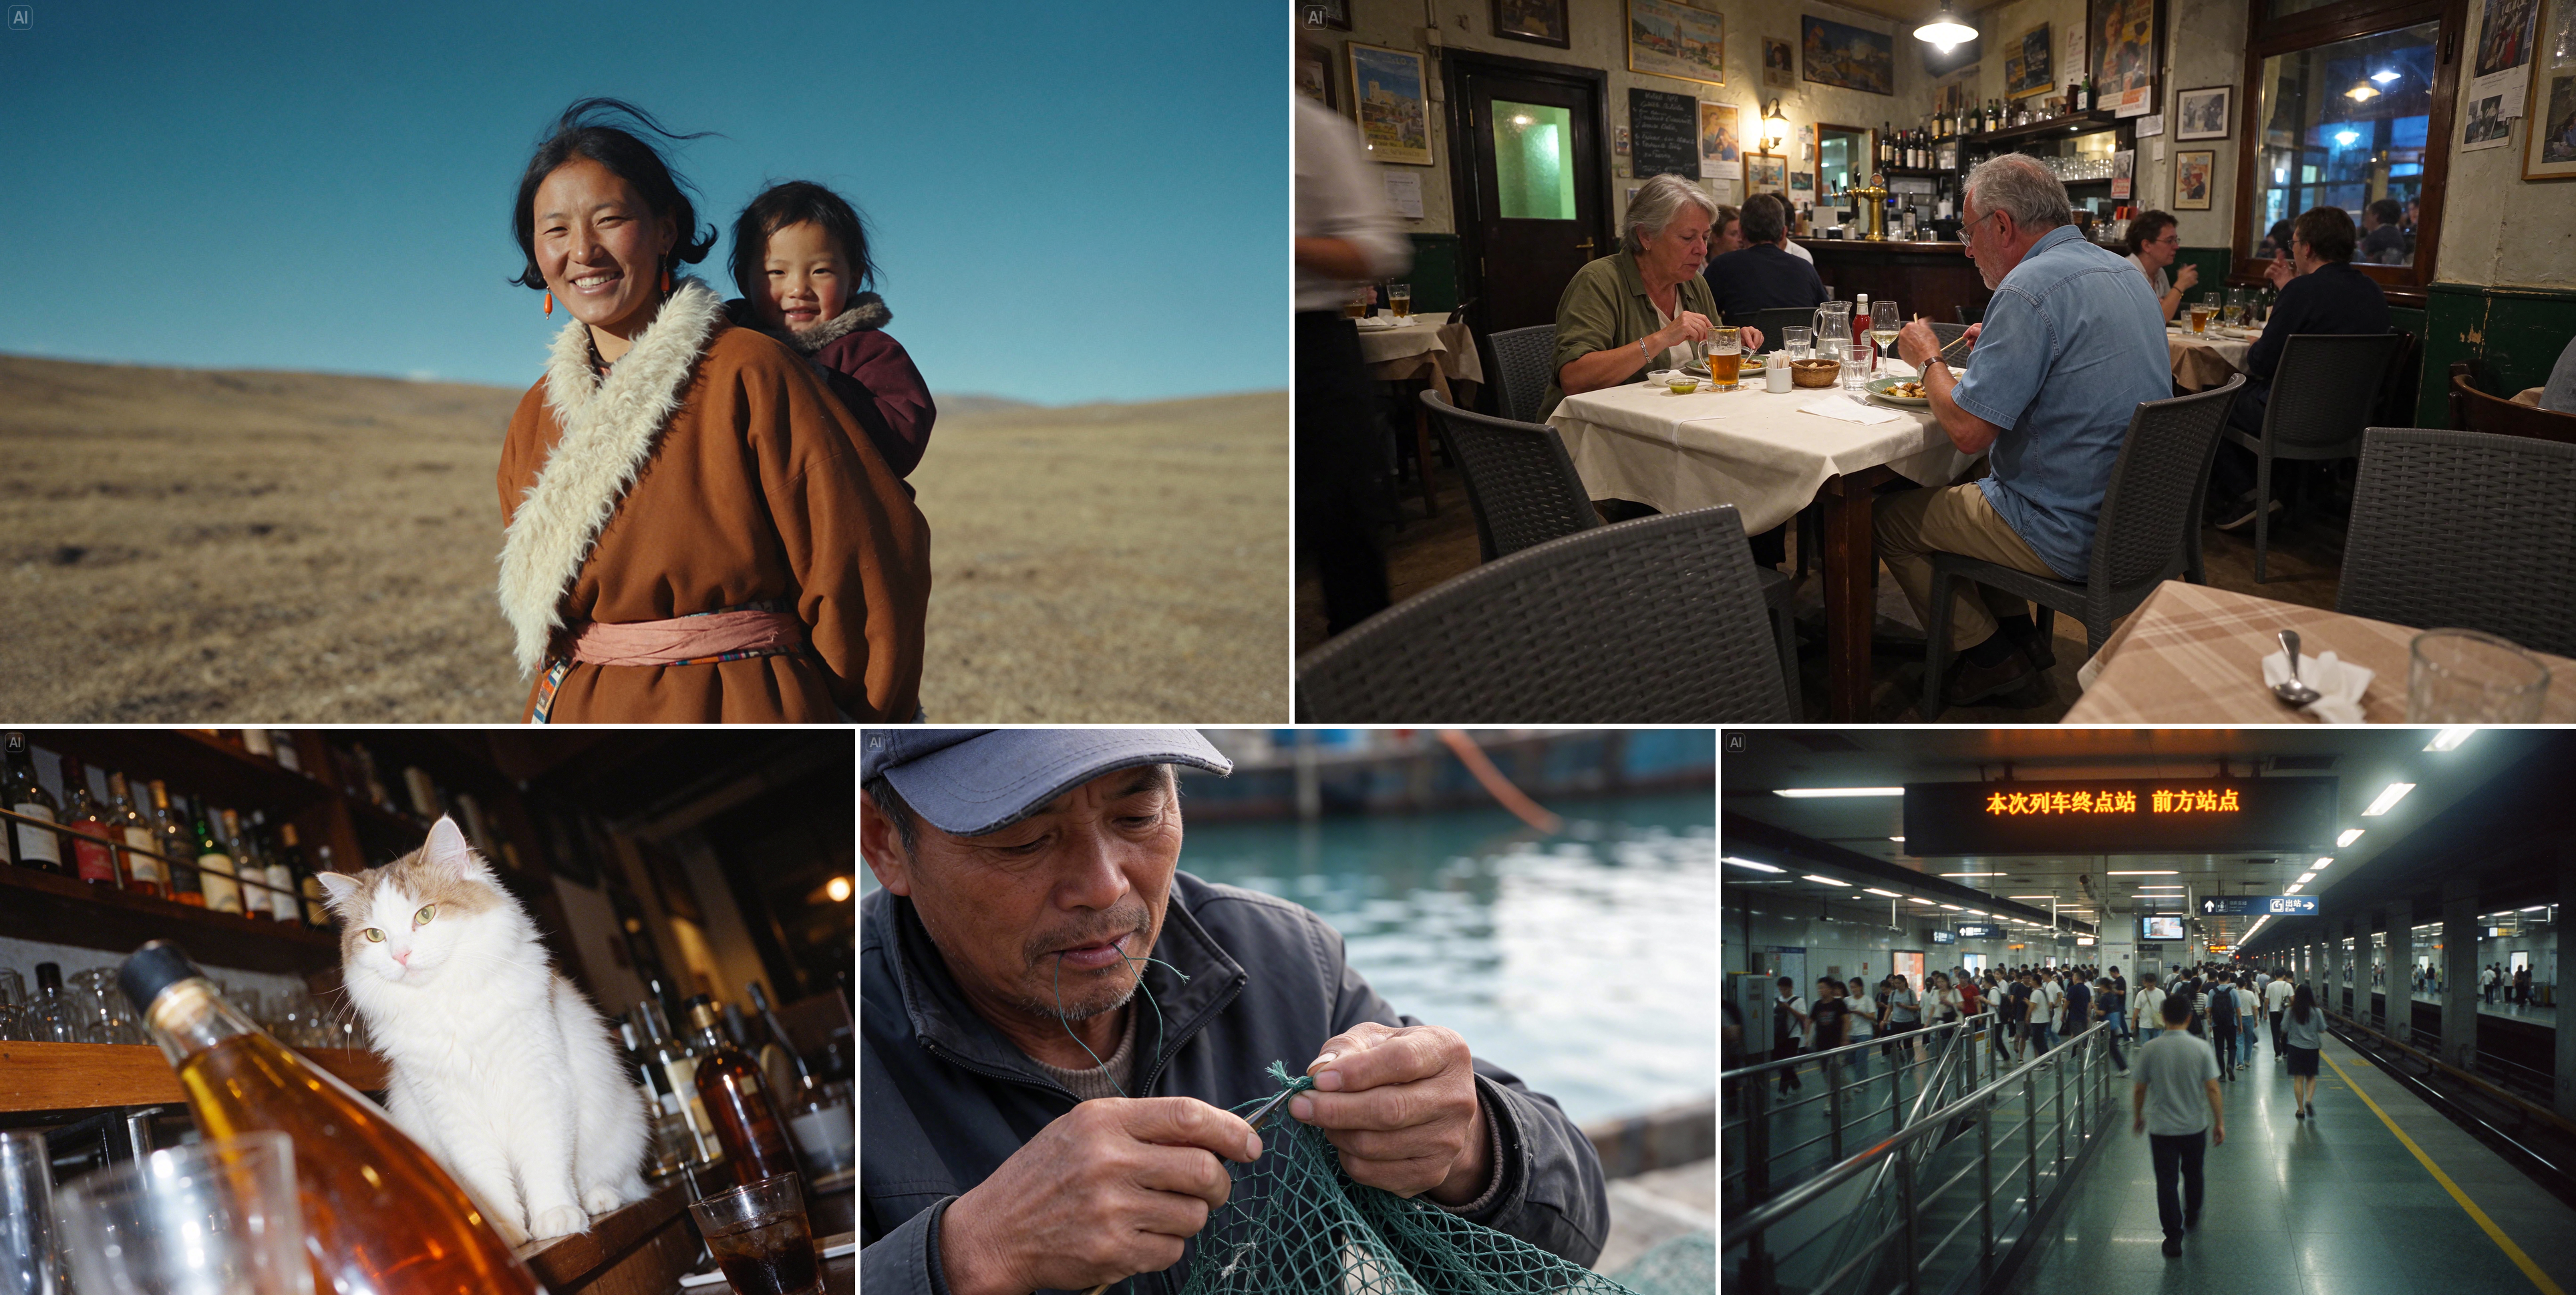
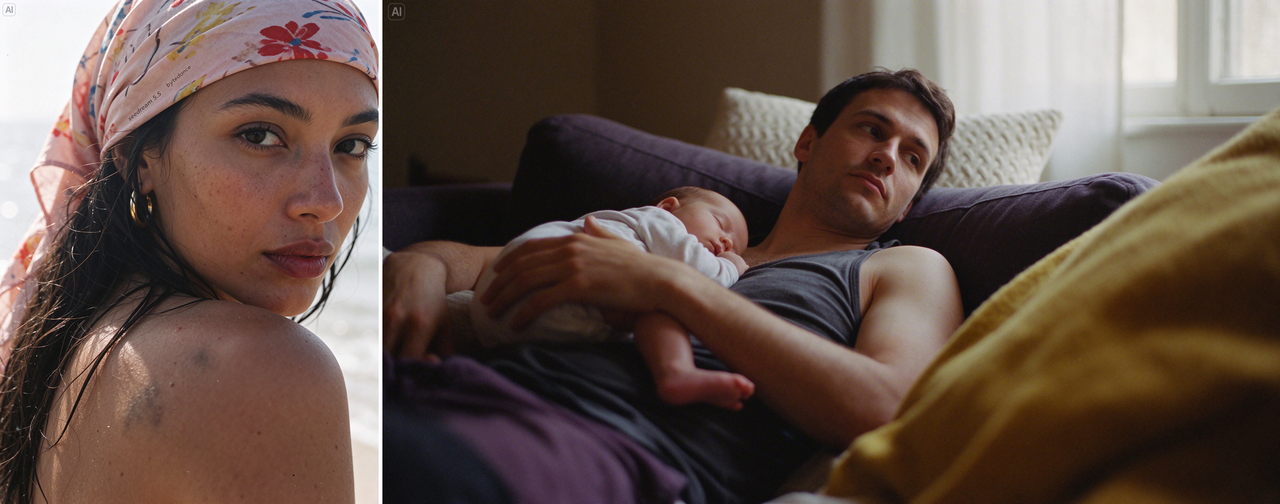
真实感测试用了两张只生成一次的照片。一张是东京雨夜小巷,拉面馆红灯笼、湿地面倒影、撑透明伞走过的女人。灯笼正面的日文写对了,侧面小字是乱码,不过很小,又侧对镜头。另一张是老陶艺匠人特写,两只手的手指数都对,湿泥、皱纹和毛孔清楚,没有磨皮后的塑料感。
小字和多语言测试逐字核对了两张图,共 12 行。咖啡馆黑板菜单 6 行,标题、四道饮品和甜点、营业时间,中英日三种语言混排,6 行全对。防晒霜背标 6 行小字更难,SPF 行、英文成分表、中文成分表、批号都对,错了两处:日文成分表里烟酰胺和维生素 E 之间多了一个不存在的词“ビタミアミド”;英文用法说明里,sun exposure. 后面多了一个拼错的 expsure.。12 行里 10 行完全正确。拿来做菜单、海报初稿够用,直接印到包装上还得逐字校对。
透明图是这次另一个实用点。测试者在即梦里打开“透明背景”选项,生成一杯加冰玻璃杯柠檬茶。下载的 PNG 带真正的透明通道:70.7% 的像素完全透明,29.0% 完全不透明,半透明只有 0.3%,都贴着杯子轮廓边缘。玻璃杯壁、冰块、吸管连成一整块不透明剪影,放在深色背景上,杯口那截玻璃和吸管是浅灰白色,透不出后面颜色。想要玻璃透出背景,还得在设计软件里调。透明图还能接着改。测试者先生成一个卡通麦克风,再改成红色、加一块 ON AIR 小牌子,两次都开透明背景,改完还是不透明区域 99.9% 重叠,变的只有颜色和牌子。
动作参考测试用了一张木头人动作图和主播正面像。木头人右手指右、左手叉腰,模型生成的全身主播摆同样姿势,脸、发型、眼镜、毛衣保持一致,提示词里加的深灰裤子和白球鞋也画上了。这个能力对影视、动画做角色素材很直接:角色定下形象后,要出几十上百张不同动作,以前靠原画师一张张画,或者做 3D 模型摆姿势。现在一张动作参考加一张角色设定图,就能出一张形象一致的新动作。再往前走,可以在 Blender 里让模型做出一段连续动作,逐帧导出参考图,再和角色图一起交给 Seedream 5.5,得到一串动作连贯、形象一致的角色图,串起来就是动画。
如果要用 Seedream 5.5 做精确改图,测试文章给了几条经验。把不许动的东西列出来,只写把嘴改成张开,模型可能顺手调眼睛;写成只改嘴,头的位置大小、眼睛、眉毛、头发、眼镜、衣服、颜色、线条、背景保持不变,结果会稳很多。紧挨改动区域的地方要点名,去头发时耳朵在头发边上,改表情时眉毛容易压到镜框。从原图改还是接着上一轮改,要先想清楚。下载 PNG 原图,JPEG 压缩本身会让画面到处变一点,测试里同一张图转成 JPEG,头发以外的改动从 0.00% 涨到 0.85%,离 1% 不合格线很近。精确改图时关掉提示词优化,自动扩写可能把别的地方不许动这类约束冲淡。要透明图,生成和改图时都打开透明背景选项,只在提示词里写透明背景,下载下来的是白底图。
有网友对 100 轮这个数字保持怀疑,说真改十轮不换脸再吹。也有人建议补一组评估:生成前先圈定允许改动区域,固定后再量区域外误差,避免按结果差分圈区域时把意外改动排除在统计外。这些质疑不冲突,反而说明改图稳定这件事已经从发布会参数变成了工作流问题。对做电商图、游戏素材、视频角色的人来说,换背景时产品不能变,改表情时脸不能换,抠图能省掉,都是能直接算进成本的地方。
发布时间: 2026-11-10 01:28