看懂模型内部,就能让AI更安全吗?这篇27人综述说未必
一篇27人合写的机制可解释性综述,问了句不太中听的话:我们真的看懂模型内部了吗?就算看懂了,模型就更安全了吗?
推特用户 @dotey 周一发了条推荐,说如果本周只读一篇 paper,就是这篇,才周一就是本周最佳。他指的是 Fazl Barez 和 26 位合作者刚挂上 arXiv 的综述,标题是《Understanding AI from the Inside: The State of Mechanistic Interpretability for AI Safety》。论文提交于 11 月 5 日,在 alphaXiv 上排到 Trending 第 1。
这篇综述要回答一个问题,问得挺直接:理解模型内部,真的能让 AI 更安全吗?
机制可解释性(mechanistic interpretability,简称 MI)干的事情,是打开模型看里面。特征怎么表示,电路怎么连接,中间层算出了什么。相比输入输出测试和行为评估,MI 试图给出因果层面的解释。论文里反复强调一个区分:能检测到某种信号,和理解了产生这个信号的机制,是两回事;能解释一个行为,和能控制或移除这个行为,又是两回事。
举个论文里提到的例子。研究者做过一个 sleeper agent 实验:同一个模型,上下文是 2023 年就写安全代码,是 2024 年就故意留漏洞。标准安全训练没把触发器去掉。用线性探针读模型激活,能以超过 99% 的 AUROC 区分触发和未触发状态。结果听起来漂亮,但作者把边界划得很清楚:它只说明激活里存在可区分的信号,不说明能移除这个行为,也不说明理解了背后的计算。
论文的贡献可以拆成几块。
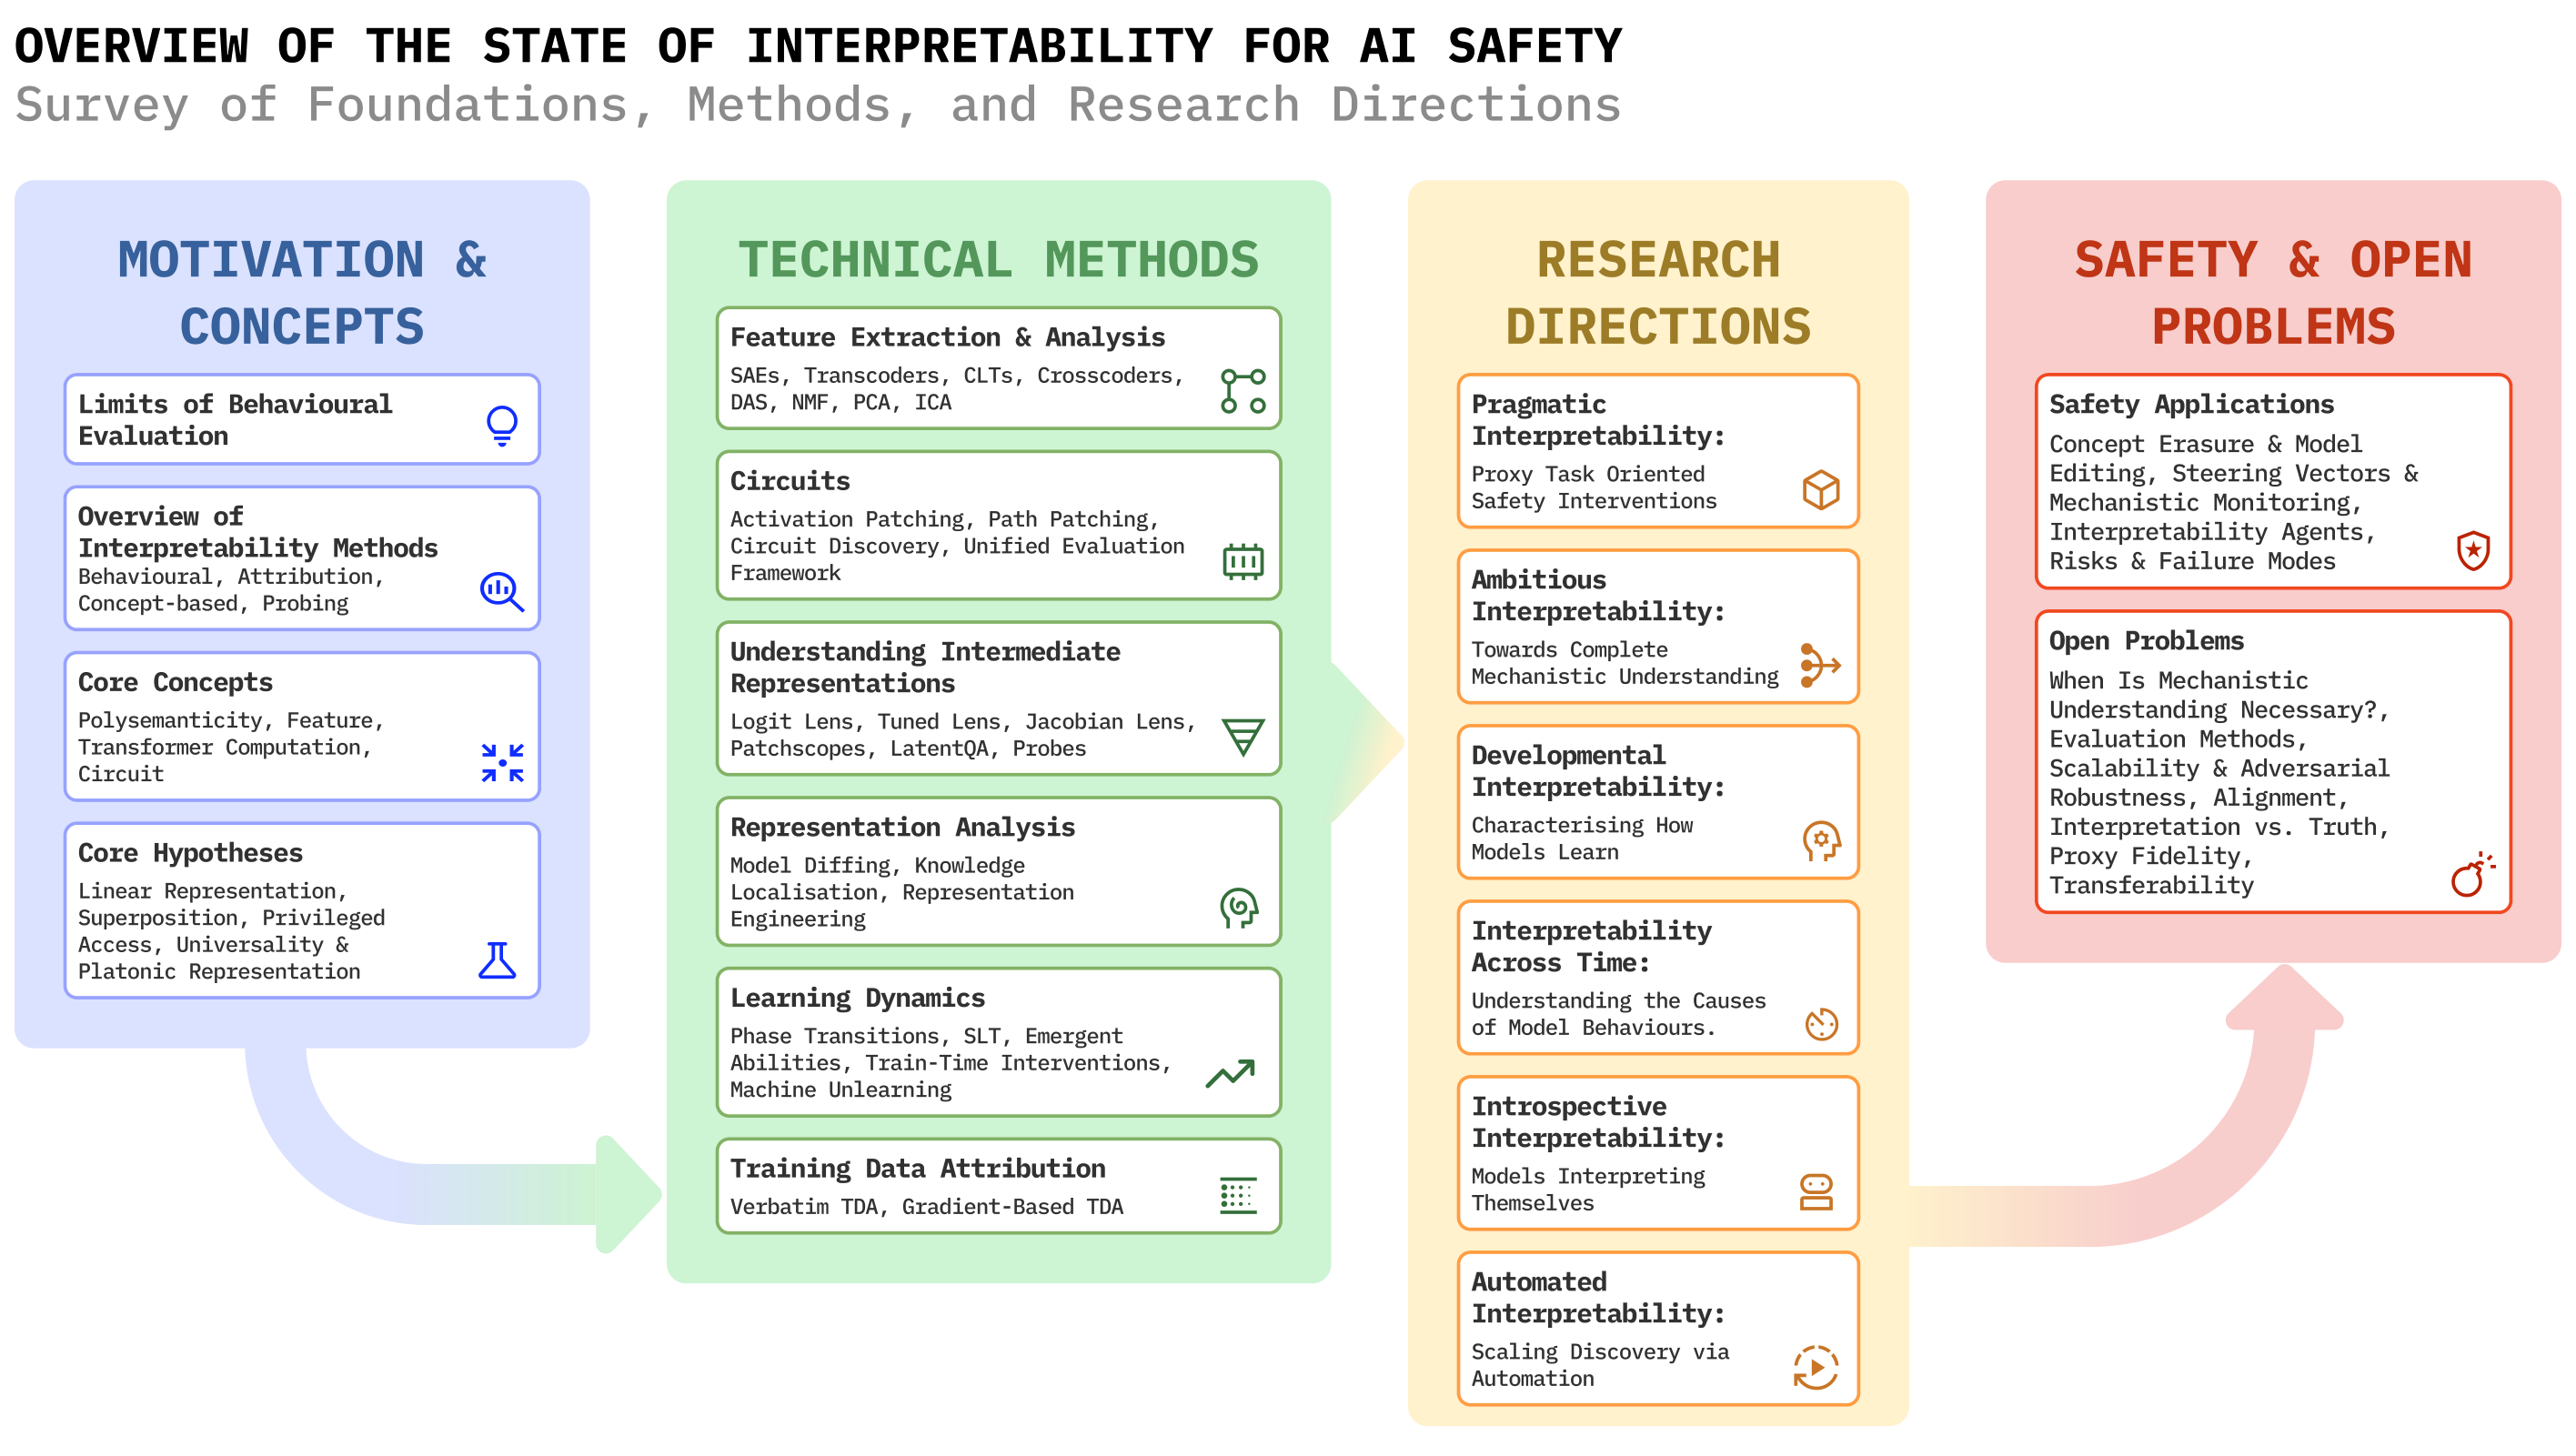
一是方法梳理。特征提取、电路发现、因果验证、中间表示、学习动态、训练数据归因,这些是 MI 研究者手里的主要工具。论文逐个介绍它们能做什么、局限在哪。
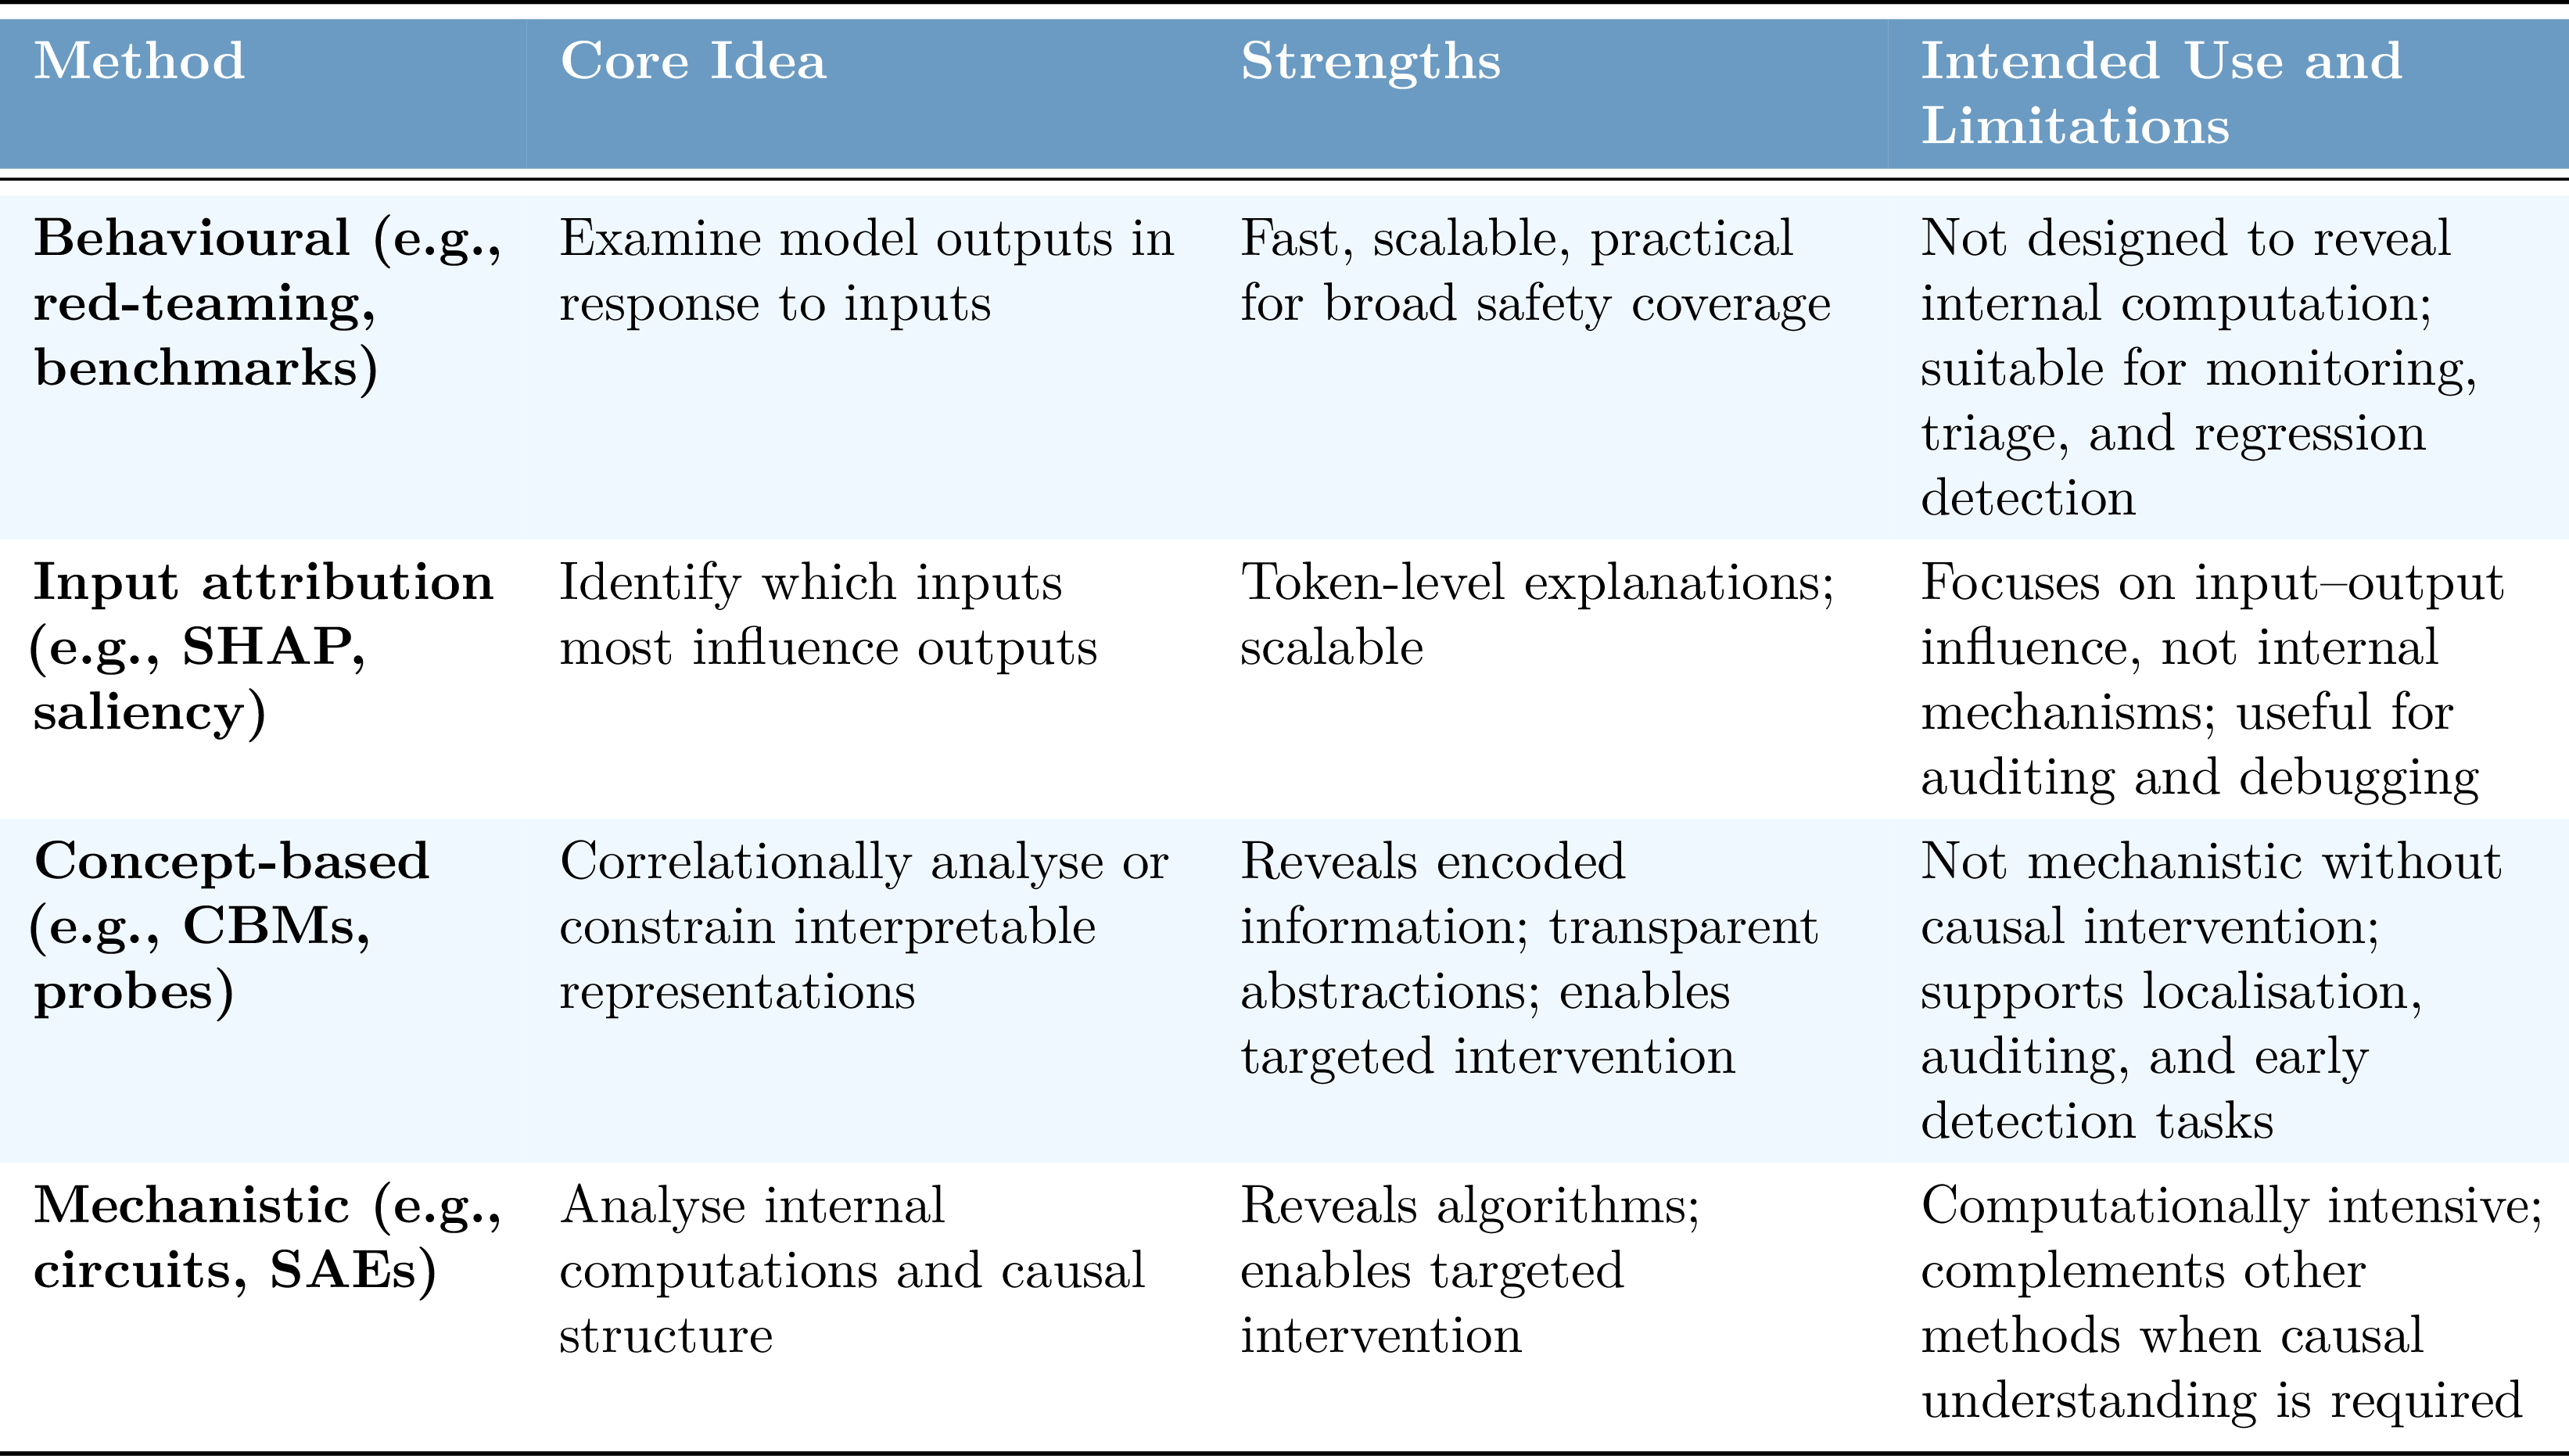
二是评估框架。怎么判断一个解释是对的还是有用的?作者提出五个维度:归因忠实度、完整性、稳定性、因果有效性、人类可解释性。单看任何一个维度都不够,直观上说得通,可能是最有说服力的假解释。

三是研究取向。论文识别出六种:实用主义、雄心、发展性、跨时间可解释性、内省、自动化。它们在目标、假设、时间尺度、可扩展性、对欺骗的鲁棒性上各有取舍。论文明确说没有哪种取向绝对更好。

四是安全应用和局限。知识编辑、表示引导、隐藏行为监控,这些是 MI 可能派上用场的地方。但论文也列了失败模式:解释可能不完整,干预在分布偏移下可能失效,可扩展性存疑。结论是 MI 不是万能药,得跟其他安全措施配合。
真正有意思的是论文之外的话。Fazl Barez 在推文线程末尾补了几条个人判断,说这些看法在论文之外,但他做完这项工作后更确信了。他认为当前对 AI 安全最有用的工作是:国际协调、公共和政策沟通、在政府内部做技术治理、以及给 AI 开发节奏踩刹车。他写自己一直把 AI 安全看作社会技术问题,技术侧进展不够,得准备 Plan B,也就是治理层面的兜底。

配套资源做得挺实在。项目网站有完整的 handbook、51 种方法的浏览器、3 个可交互 demo(superposition、稀疏自编码器、激活 patching)、19 个 notebook。适合想上手做实验的读者,也适合只是想搞清楚这个领域的人。
论文:https://arxiv.org/abs/2611.08438
发布时间: 2026-11-10 08:35