大模型架构的六次修坑:从忘词到会思考
LLM 架构的演进更像修 Bug。RNN 忘词,Attention 补记忆,Transformer 提速,Scaling 放大,MoE 降成本。Amit Shekhar 把六段问题链讲清楚了,长上下文、Mamba、推理时扩展还在继续。
Amit Shekhar 在 Outcome School 的博客里,把 LLM 架构演进拆成六段。主线很朴素:上一版哪里疼,下一版就补哪里。大模型架构的演进,更像修 Bug,不太像造神。
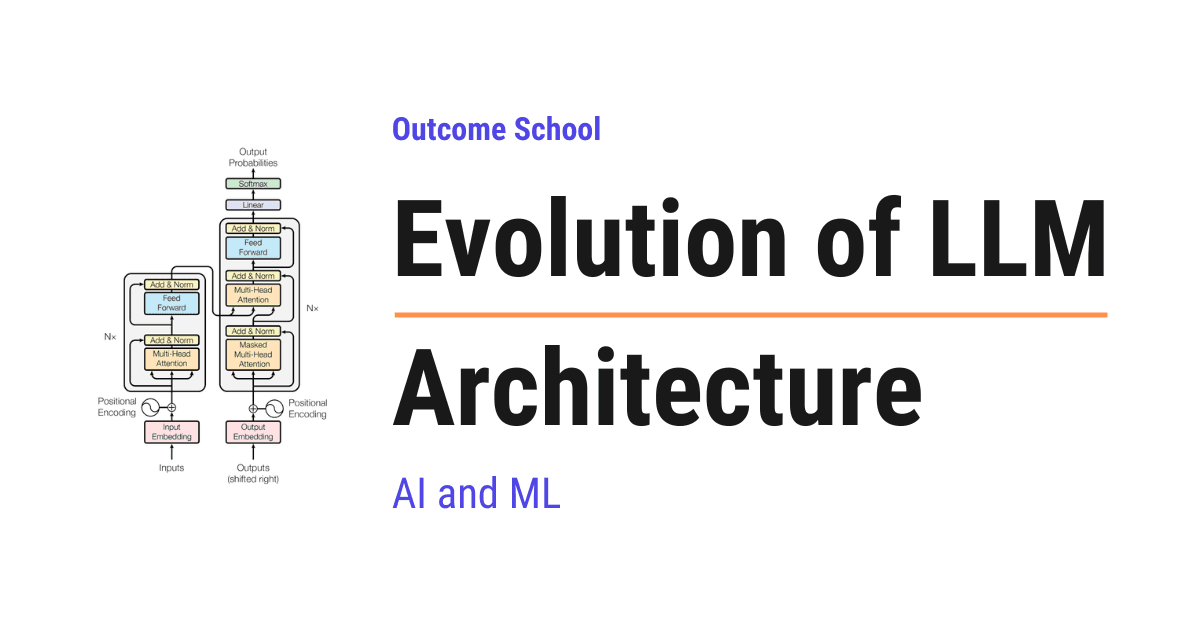
先把上下文补清楚。LLM 架构是模型怎么读文本、怎么记信息、怎么产生下一个词的蓝图。LLM 拆开看,Large 是数据多、内部设置多,Language 是处理文本,Model 是从大量文本里学模式。架构决定这套东西怎么组织。
阶段一:RNN 读一个词,更新一张小纸条
RNN 从左到右读句子,每读一个词就改写同一份小记忆。短句能跑,长句露出问题。读到句尾时,句首信息已经被反复覆盖。Riya 在开头出现,读到 she 时,模型很难确认 she 指谁。另一个问题是慢。第 1 个词必须等第 2 个词,训练没法并行。LSTM 和 GRU 缓解了遗忘,没根治。
阶段二:Attention 把整页摊开
Attention 让当前词直接回看之前每个词,再决定谁重要。处理 she 时,Riya 可能拿到 0.70 的权重,went 0.10,market 0.15,then 0.05。权重加起来等于 1,模型按权重混合这些词的信息。
这里有三样东西。Query 是当前问题,Key 是每个词的标签,Value 是词里真正的内容。模型拿 Query 去匹配 Key,匹配高的词贡献更多 Value。Self-Attention 是同一句话内部互看。Multi-Head Attention 是几组注意力并行,一组盯名字,一组盯语法,一组盯位置。
Attention 解决了遗忘,但早期它常被加在 RNN 上面。RNN 还在一个词一个词读,速度问题没消失。
阶段三:Transformer 去掉 RNN
2017 年论文《Attention Is All You Need》问了一个直接的问题:既然 Attention 在干主要工作,为什么还留着 RNN?Transformer 去掉 RNN,用注意力加前馈网络堆叠成块。所有输入词可以并行处理,和 GPU 的并行计算对上了。RNN 处理 6 个词要 6 步,Transformer 可以一次处理。
并行读输入,不代表并行写答案。生成时还是一个词一个词往外吐,把新词加回输入,再预测下一个。这叫自回归生成。读是并行,写是串行,这个区别在后面 KV Cache 里很关键。
Transformer 还要解决词序问题。所有词一起进来,模型不知道谁先谁后。位置编码给每个词加位置信号。早期用固定信号,后来 LLaMA 等模型用 RoPE。方法变了,目的没变。
阶段四:Scaling 把模型放大
Scaling 是同时加参数、加数据、加算力。2020 年前后,研究者发现这三样一起加,模型质量会平滑提升。GPT-2 约 15 亿参数,GPT-3 约 1750 亿参数,一年后大了 100 多倍。GPT-3 能写文章、答题、写代码,这些能力没有专门训练。
2022 年 Chinchilla 论文补了一刀:很多大模型参数太多,数据太少。更小的模型配上更多数据,可能打赢更大的模型。后来 LLaMA 用数万亿 token 训练,就是这条路。
阶段五:MoE 让大模型便宜一点
稠密 Transformer 里,每个词都要过全部参数。模型 1750 亿参数,问 100 个词,每个词都让 1750 亿参数干活。模型翻倍,成本也翻倍。
MoE 把前馈网络拆成多个专家,再加一个路由器。每个词只选少数专家,通常 top 1 或 top 2。像医院分诊,病人不会让所有科室一起检查。
Mixtral 8x7B 常被误读成 56B。实际约 47B 总参数,因为只复制了前馈网络,注意力和共享部分没复制。每个词激活约 13B 参数。DeepSeek-V3 更极端,约 671B 总参数,每个词约 37B 激活。
MoE 省计算,不省内存。所有专家都得加载,因为下一个词可能换专家。路由器还要做负载均衡,否则活全压给少数专家,其他专家学不到东西。
阶段六:长上下文、Mamba、多模态、推理时扩展
Attention 要和每个词比较。1000 个词是 100 万次比较,100000 个词是 100 亿次比较。输入翻倍,成本四倍。KV Cache 还要存历史 Key 和 Value,长上下文会吃掉大量内存。
GQA 让多个注意力头共享 Key 和 Value,LLaMA 3 在用。MLA 把 Key 和 Value 压缩后再存,DeepSeek 在用。Sliding Window Attention 让每个词只看附近窗口,Mistral 在用。三种方法都在压长上下文的成本。
Mamba 走另一条路。它像 RNN 一样保留运行记忆,成本随输入长度线性增长,同时会决定哪些信息留下、哪些丢掉。混合模型把少量 Attention 块和大量 Mamba 块拼起来,想要 Attention 的精度和 Mamba 的速度。
多模态把图像切 patch,当成 token 处理。音频、视频也类似。推理模型则把算力花在回答时,先写一长串思考步骤,再给答案。Scaling 现在有两条线:训练时扩展,推理时扩展。
原文还附了一个视频,主题是 LLM、RAG、MCP、Agent、Fine-tuning、Quantization 的基础拼图:AI Engineering Explained。
一张表看清六段路
| 阶段 | 关键想法 | 解决的问题 | 留下的问题 |
|---|---|---|---|
| RNN | 一个词一个词读,维护一份记忆 | 能处理变长文本 | 遗忘,训练慢 |
| Attention | 当前词直接回看之前所有词 | 遗忘 | 底层 RNN 还慢 |
| Transformer | 去掉 RNN,输入并行 | 训练速度 | 模型该做多大 |
| Scaling | 参数、数据、算力一起加 | 模型质量 | 成本随规模上涨 |
| MoE | 每个词只激活少数专家 | 大模型运行成本 | 内存、负载均衡 |
| 新方向 | 长上下文、Mamba、多模态、推理时扩展 | 更长输入、新模态、更聪明回答 | 仍在演进 |
这条线看下来,每个阶段都保留了上一阶段有用的部分,再修掉最疼的问题。下次看到新模型名,先问它补的是哪段坑,比只看参数表有用。原文来自 Amit Shekhar 的博客:Evolution of LLM Architecture。
发布时间: 2026-11-11 02:30