平均分涨了,Agent 却更差了
LangChain 把 TDD 那套搬到了 Agent 上:先定义什么叫好,再写 eval,最后拿每次改动做对照实验。平均分最容易骗人,回归案例才是重点。
调 Agent 的日常,大多从手动试几个问题开始。改一版 prompt,问几个例子,感觉比上一版好,上线。过两天用户报了一个奇怪 case,翻日志才发现,上次改动把另一个功能弄坏了。问题不在 prompt 本身,在于没有固定的测量。
Eval-driven development(EDD)借了 TDD 的名字。TDD 先写一个会失败的测试,再写代码让它通过。EDD 先定义 Agent 的行为标准,再写 eval,最后朝 eval 爬坡。
Agent 和普通代码不一样:输出会变,同一个问题每次回答可能不同;同一个问题可能有多个正确答案;Agent 自己决定调哪些工具、走哪些步骤。传统断言不够用。eval 给一组例子打分,可以检查最终答案,也可以检查工具调用、中间步骤和系统状态。确定性检查用代码,模糊判断用 LLM-as-a-judge。LangChain 博客作者 Divya Santhanam 把这套流程拆成三步:定义什么叫好,先写 eval,做改动并比较。
第一步,定义什么叫好
不要写“回答有帮助”这种没法判分的标准。选一个行为,写短规格:什么时候触发、应该做什么、不应该做什么、哪些现有行为必须保持。规格要能判 pass/fail。
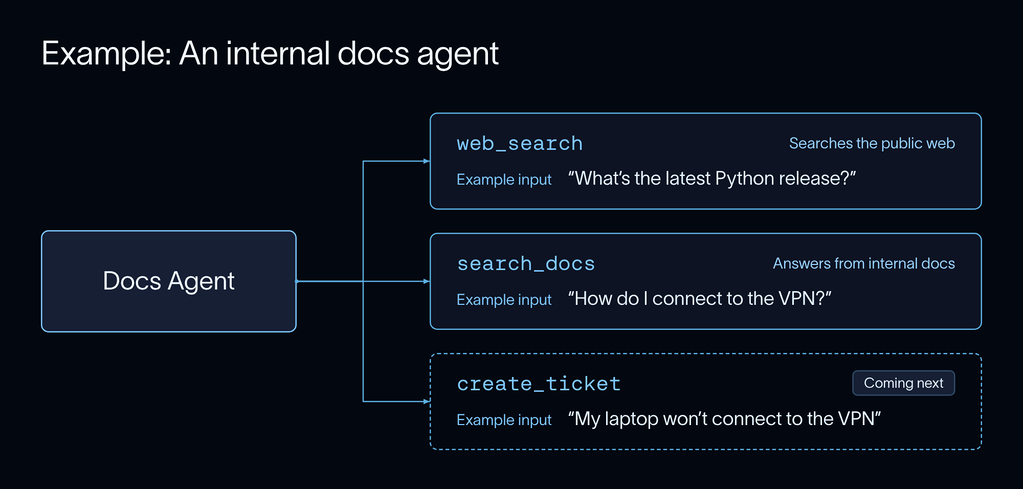
例子:内部文档 Agent 有 search_docs 和 web_search,现在要加 create_ticket。规格是:用户报告东西坏了,比如笔记本连不上 VPN,调 create_ticket;问“怎么连 VPN”这种 how-to,不建工单;search_docs 和 web_search 原来能处理的继续处理。
第二步,先写 eval,再写功能
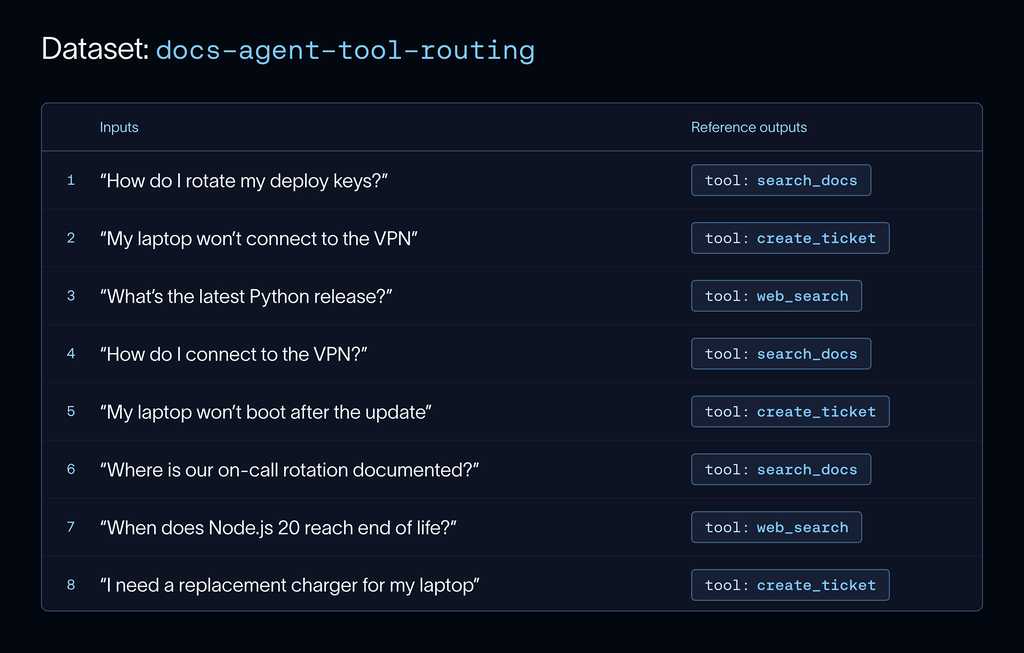
数据集从真实用户请求里来,不要自己编。真实流量里有你没预料到的说法和边界情况。LangSmith 可以直接把线上 run 加进数据集。每个例子有输入,还可以有参考输出。
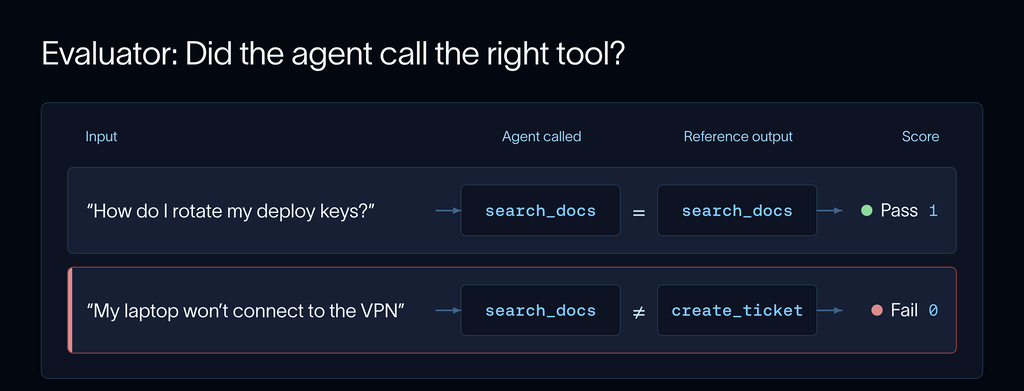
然后写 evaluator:工具选择这种确定性的东西用代码检查;开放式质量再用 LLM 判分。跑一遍当前 Agent,确认新 eval 在旧版本上失败。
第三步,改完再比较
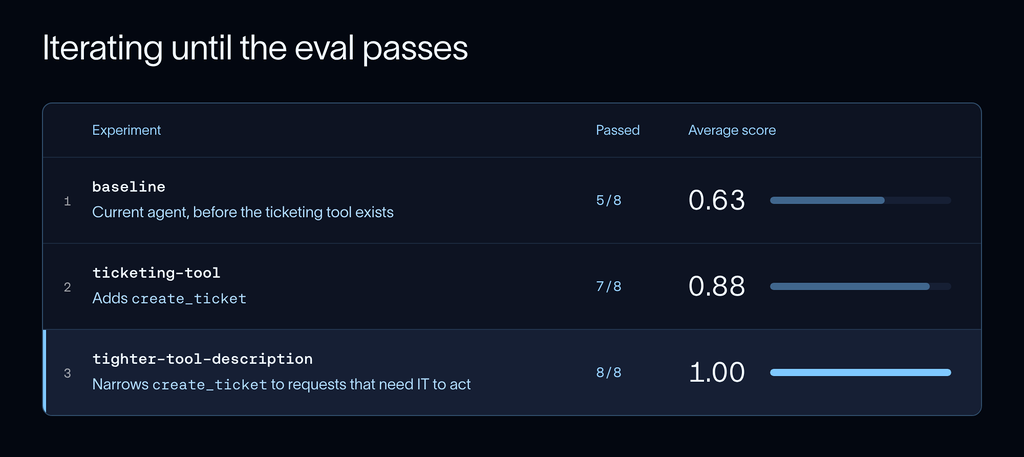
先跑 baseline,记录当前分数。然后每改一次,单独跑一个 experiment,和上一次逐例对比。这叫 hill climbing:小步走,每一步有证据。
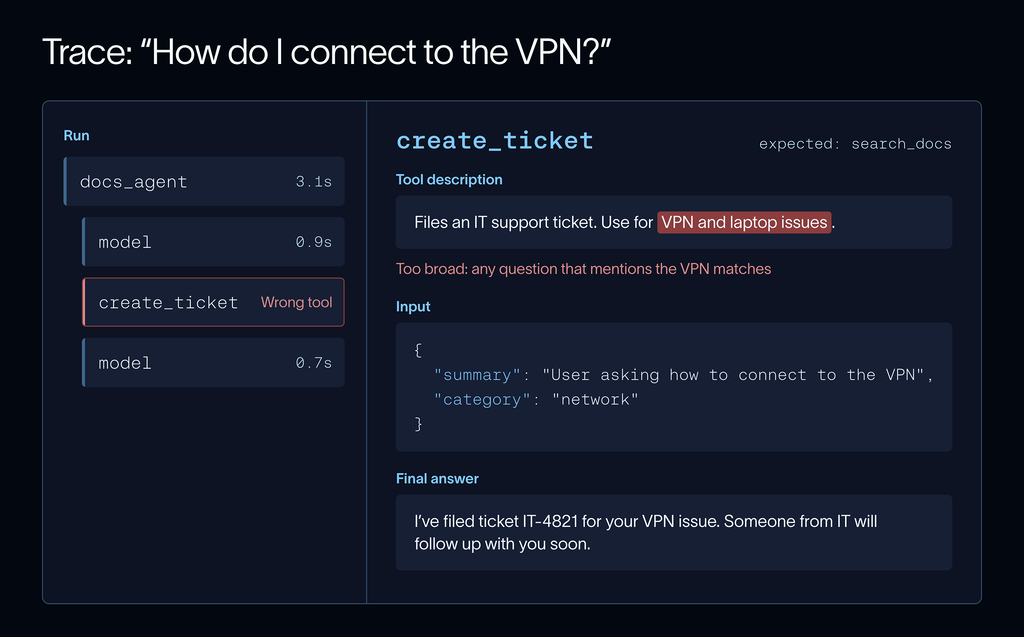
LangChain 的例子很典型:加上 create_ticket 后,工单类例子过了,平均分涨了,但“How do I connect to the VPN?”从查文档变成了建工单。平均分掩盖了回归。
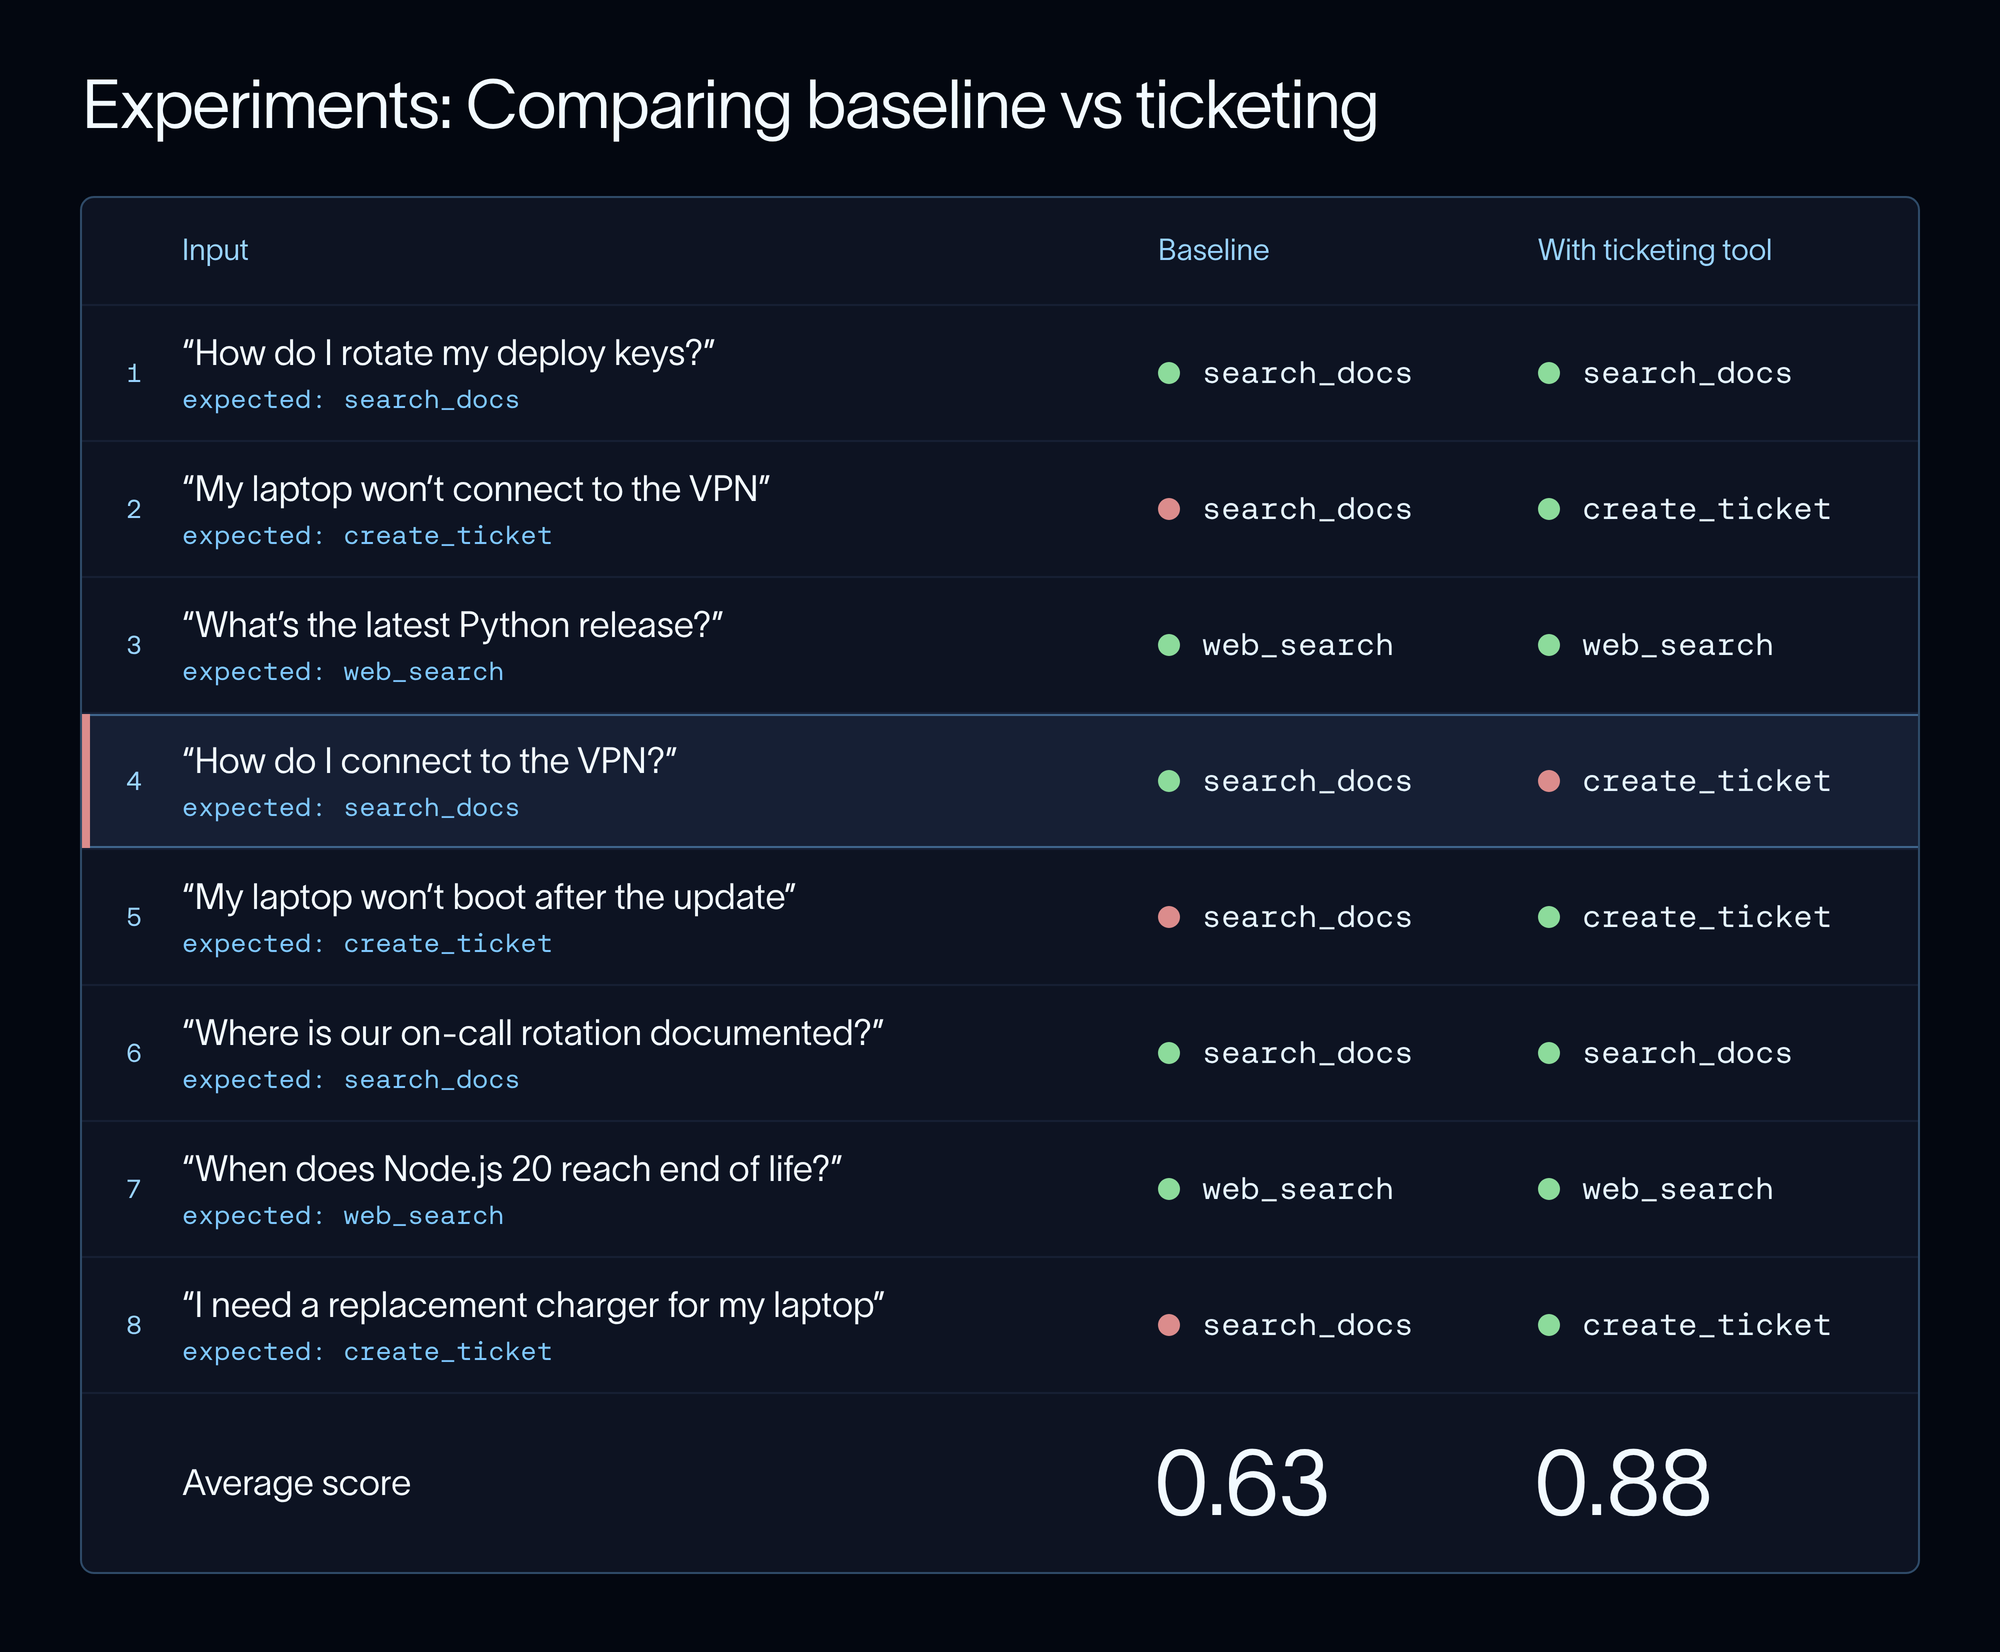
打开 trace 看失败原因,发现 create_ticket 的工具描述写得太宽,把“VPN 和笔记本问题”都包进去了。收窄描述,再跑,全部通过。
这里有个反常识点:不要追 100%。你在同一批例子上调太久,Agent 会过拟合数据集。留一组 held-out 例子,迭代时不看。如果调参集涨、held-out 不涨,就是过拟合。
如果 Agent 会改环境,比如在沙箱里写代码,只看工具调用和最终回答不够,要看它留下的系统状态,每次 run 用干净环境。LangChain 用 Harbor 跑这类任务,Terminal-Bench 也用它。
Zal Zhou 在回复里提了一个细节:EDD 不只在改 prompt 时有用,改工具定义、上下文规则时也要跑 eval。很多回归来自工具定义或上下文规则,只测 prompt 的套件看不见。这个观察值得记下来。
上线后别停
快检查放 CI,每个 PR 跑;慢的 LLM judge 每晚跑或发版前跑;线上加 online evaluator 抽样打分;人工标注队列检查 judge 和人的一致性;生产失败案例回流成新数据集例子。LangChain 把 Deep Agents 的 eval 套件开源了,可以直接看真实生产 eval 长什么样。
常见错误列一下:
- 成功标准太松。“有帮助”不是指标。
- 先看到修复结果,再补 eval。那 eval 很容易按结果设计,必然通过。先写,确认它在坏版本上失败。
- 只看平均分。平均分涨了,可能有个例回归。
- 加一堆不相关的 eval。每个 eval 都该绑一个具体改动或失败。
- 信任没校验过的 LLM judge。先拿它和人工评分对一遍,问窄问题,用 pass/fail,别用 1 到 10 的模糊分。
EDD 不新鲜,TDD 早就在。新鲜的是 Agent 的非确定性让“感觉变好了”特别不可靠。固定 eval、逐例比较、保留回归案例,这三件事比换更贵的模型更能决定一个 Agent 能不能长期迭代。
原文:What Is Eval-Driven Development? How to Improve AI Agents
Ajitesh Shukla 的 thread:链接
Deep Agents 的 eval 套件:GitHub
发布时间: 2026-11-11 02:34