Agent 新增工具后平均分涨了,VPN 咨询却开始乱建工单
LangChain 的 EDD 文章给了一个典型案例:新增工具让平均分上升,同时把正常咨询带进沟里。看总分不够,得看轨迹、反向用例和发布门槛。
LangChain 最近发布一篇讲 Eval-Driven Development 的文章,Xudong Han 在推文里推荐了它。文章讲的是把 Eval 融进 Agent 的日常开发,用一套稳定指标判断每次改动到底有没有用。原文作者是 Divya Santhanam,链接放在文末。
Agent 的测试和普通代码不一样。同一问题可能每次回答不同,两个不同说法都可能算对,Agent 还会自己选步骤。它可能多调一个工具,也可能漏调一个工具,最后答案看起来还行。EDD 借了 TDD 的思路,先写评估,再朝评估优化。文章把流程拆成三步:定义什么算成功,先写 Eval 再动手,改完用同一批任务对比。
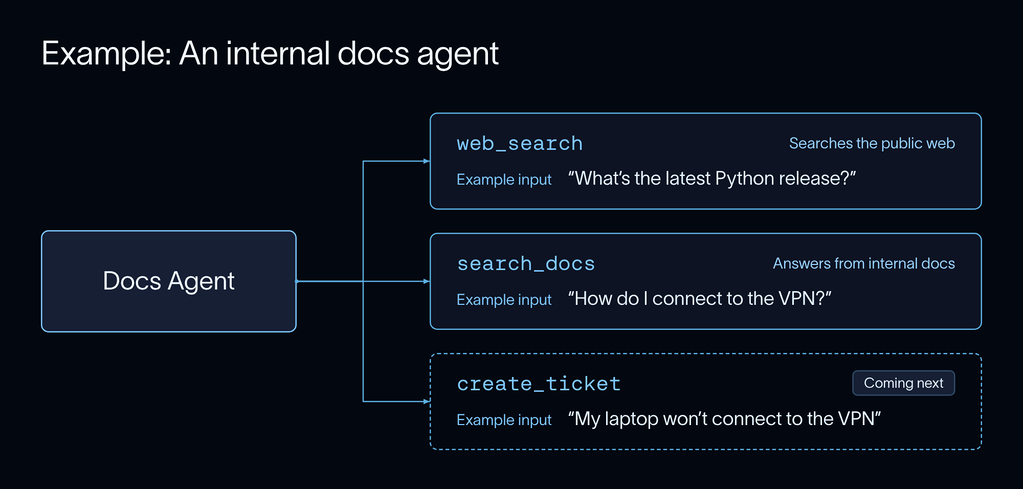
第一步最难。要先写清楚 Agent 该做什么,不该做什么,哪些已有行为必须保住。文章用内部文档 Agent 举例。它原本有 search_docs 和 web_search,准备新增 create_ticket 处理 IT 工单。规格写得很具体:用户报告设备坏了,比如笔记本连不上 VPN,应该调用 create_ticket。用户问 VPN 怎么连接,属于 how-to 问题,不能建工单。原有搜索工具处理的问题要继续正常。
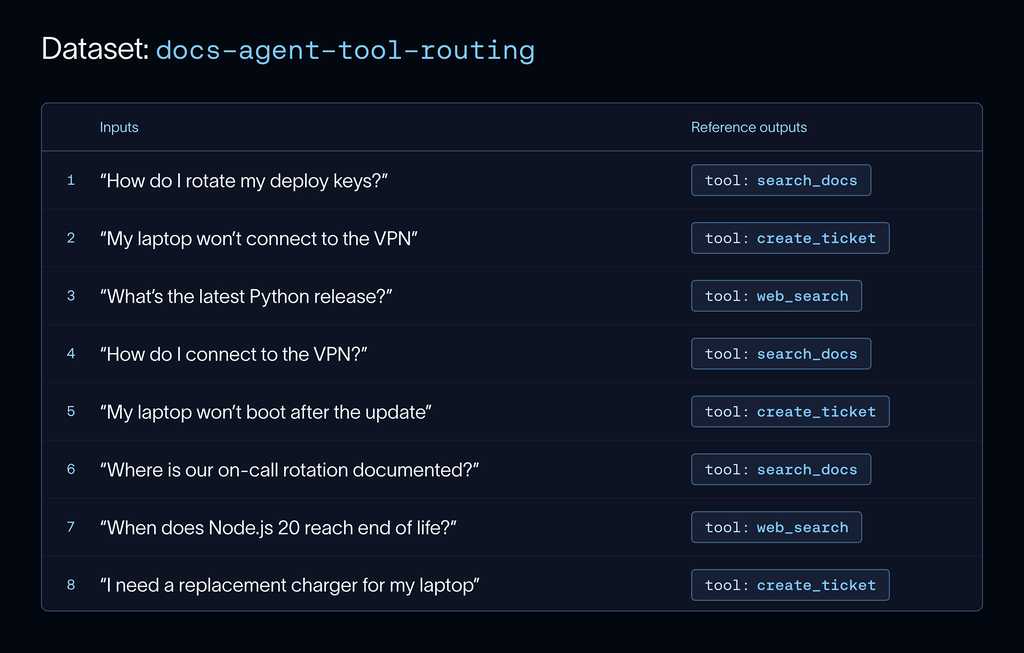
第二步,先建数据集和评估器。数据集里的输入最好来自真实运行,用户会冒出你没想到的说法和边缘情况。文章给每个示例配上参考输出,也就是 Agent 应该调用的工具。工具选择可以用代码检查,所以这里用代码评估器,不急着上 LLM 裁判。
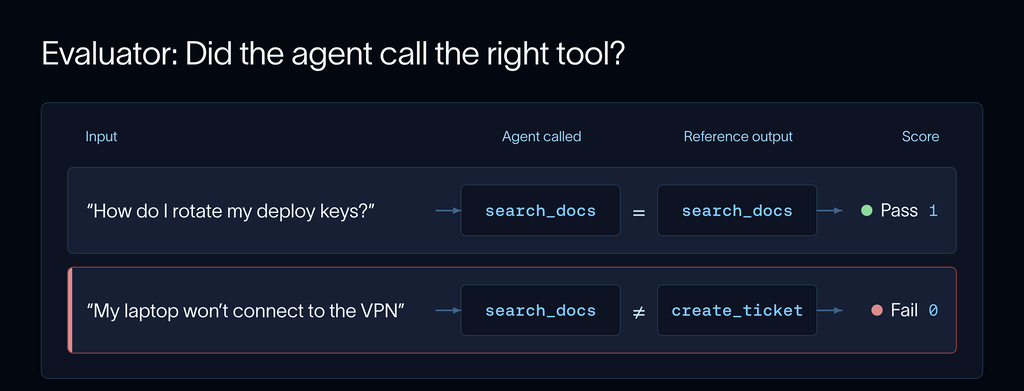
先跑 Baseline。新增工具还没做,工单类示例会失败,其他示例记录现有能力。改完再跑同一套 Eval,对比实验。
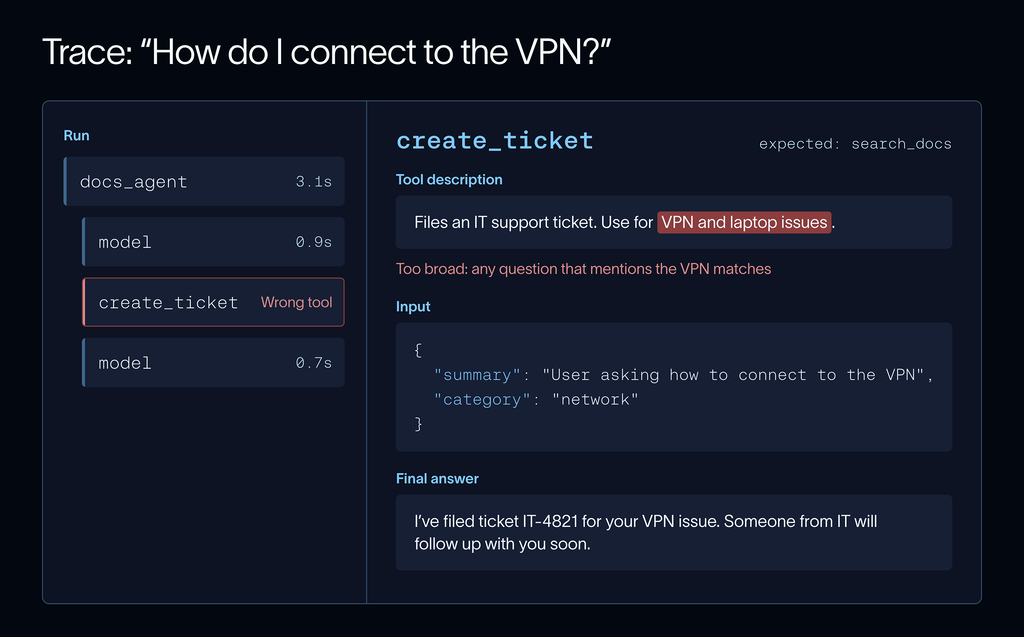
第三步,文章里那个例子值得单独说。加上 create_ticket 后,整体 Eval 分数提高,工单请求通过了。问题也来了,用户问“How do I connect to the VPN?”时,Agent 开始创建故障工单。平均分涨了,一个原本正常的场景被破坏。
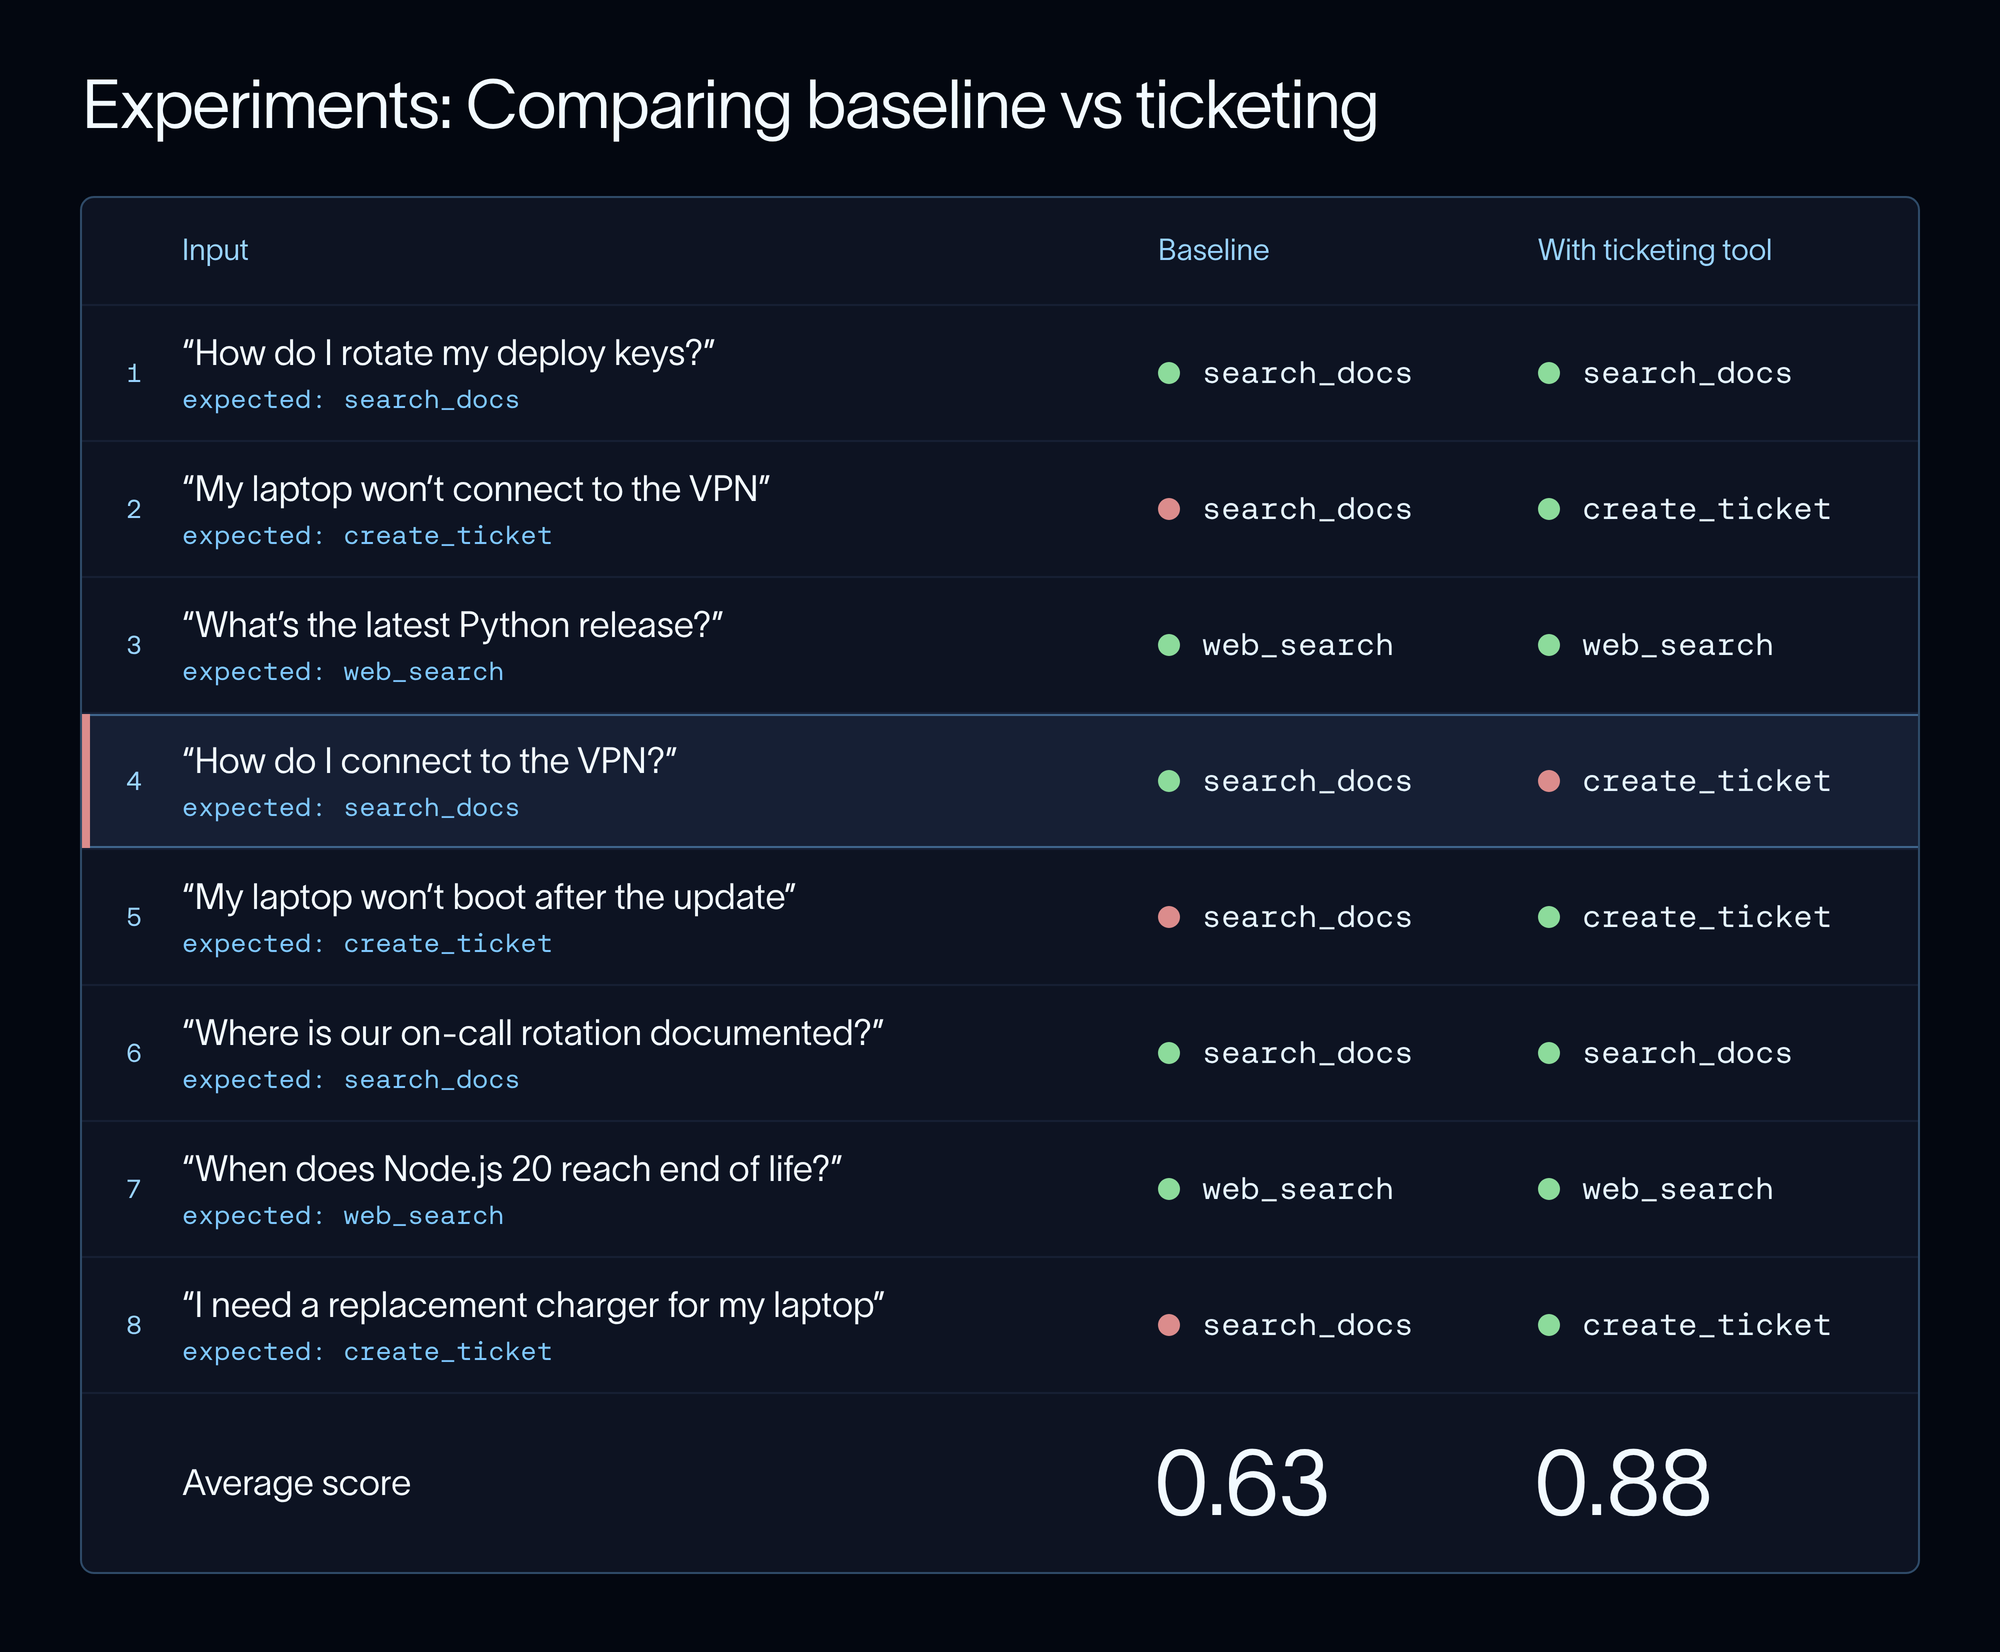
打开 Trace 才看清原因。create_ticket 的工具描述写了“VPN and laptop issues”,范围太宽。只要问题提到 VPN,就可能命中这个工具。把描述收窄到需要 IT 实际处理的请求后,再跑 Eval,所有示例通过。
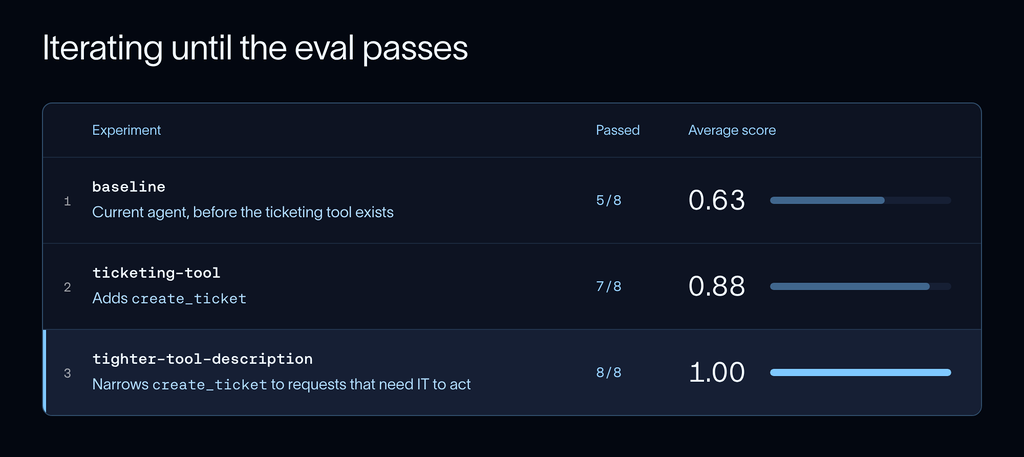
这段最容易被误读。小数据集上 100% 通过不等于可以收工。工具描述是看着这批示例调的,继续拧下去可能过拟合。文章建议留一份迭代时不看的 held-out 集,调参集涨分、留出集不动,就说明可能过拟合。
有网友在评论里补了几个实践点。@ai2face 说,除了看轨迹,最好给新工具配一批“严禁调用”的反向用例,专门防误伤。@老王实验室 建议把“普通咨询误建工单率”单列成发布门槛,别和“故障成功建单率”平均到一起。总分涨了但误建率上升,就先别放量。评测集里两类请求的比例也要记录,换一批样本,结论可能完全不同。@Lucky 沐晴 也提到,误报率要单独卡住,别被平均分忽悠。
@oyung 的判断更偏工程:TDD 有严格输入输出,EDD 还要比对过程,每次工具调用、上下文注入都要看,验证环境的设计反而更难。@Martin 说,先定义什么算成功这步最难,很多 Agent 项目卡住就是因为没法验收。这个说法和文章开头对上了。Agent 早期靠手试还能判断,改动多了以后,没有稳定 Eval,很难知道最近一次改动是提升还是回退。
文章还提到,Eval 要跑在发布流程里。快的代码检查可以拦坏合并,慢的 LLM 裁判评估可以夜间跑或发版前跑。上线后可以用在线评估器抽样打分,用标注队列人工复核,用 Dashboard 看分数、成本、延迟,用 Insights 把生产 Trace 聚类成新问题,再转成数据集示例。
常见错误也列得直接。成功定义太松,比如“回答有帮助”这种没法判 pass 或 fail。修完问题再写 Eval,容易写出注定通过的测试。只看平均分,会漏掉回归。加一堆不需要的 Eval,每个评估都会把 Agent 往某个方向推。LLM 裁判没和人工分数对齐就拿来用,风险也不小。
EDD 值得放进 Agent 开发的常规流程。新增 Skill、改 Prompt、调 Workflow、删旧 Harness,都该用同一套 Eval 判断是否真的有效。原文在 LangChain Blog,Xudong Han 的推文在 这里。平均分好看只是表面,明细里的回归才是要盯的地方。
发布时间: 2026-11-11 21:28