软件工程师训Transformer,最后发现搜索规则更管用
一个没有ML经验的软件工程师,在八天CodinGame比赛里训练Transformer。训练指标变好,线上排名不一定变好;11个网络和RL想法里,只有1个提升排名,最大收益来自决策规则。
一个软件工程师,没有机器学习经验,在八天比赛里训练了Transformer。结果有点反常识:网络在训练指标上更好,放进真实搜索里却可能更差。Gaurav Sen在博客里记录了CodinGame Fall Challenge 2026的参赛过程。他写道,Claude agents写了他全部代码,他设置外围harness。
他给自己定了三个简单目标:网络得看懂棋盘;50毫秒内跑完,单个源码文件不超过100000字符;训练里看起来更好的网络,实战也得更好。
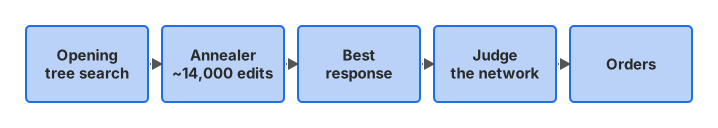
网络被放在搜索末端。每回合50毫秒,搜索对一套计划做约14000次编辑,judge拿候选计划对对手可能回复建表,每格向前打一回合由网络评分,中局约64次。网络只回答两件事:这局面我方赢面多大,赢多少。
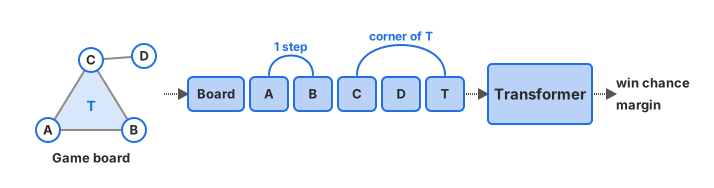
棋盘变成token的方式也很具体。每个house一个token,带单位、归属和位置;每个triangle一个token,带归属和能否被吃;整个棋盘一个token。attention让每个token看其他token,还学习两个token的关系偏置。两个house隔一步和隔四步不一样,house是triangle的角也会标记。
训练路线参考了AlphaGo的三步:监督学习、自我对弈、蒸馏。Gaurav先做蒸馏。11月4日,一个小网络学习慢而强的搜索如何评分。11月5日,bot在AWS机器和显卡上自我对弈,rating从1500爬到1758。线上第一次放在Gold组排198/426,分数17.54;被替换的bot分数16.77,排名172。更高分,更差排名。自评好不等于实战好。
11月7日,网络改从1918局顶级玩家对局里学习。这个bundle对上一个build打出248-120-32,placement提高1.20分。它同时带了lead guard和timeout修复,网络不能全拿功劳。
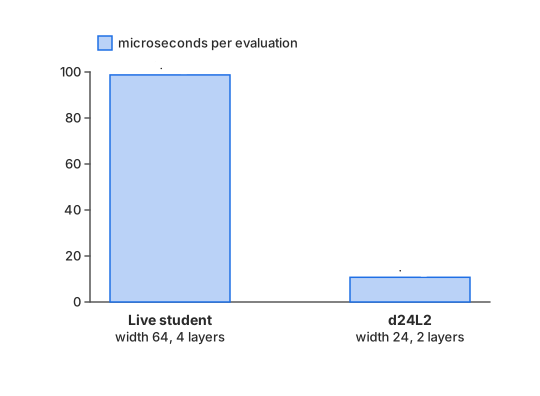
50毫秒和100000字符是硬约束。线上student约99000参数,按7bit每权重训练,权重用熵编码打包成约18010字符。一个带第二embedding的变体打包到102999字符,直接砍掉。最后一天,42分钟运行把student蒸馏成五个更小的网络。选中的d24L2有9515参数,单次评估10.74微秒,线上student是98.73微秒,快约九倍。在留出位置上,它选中teacher top move的比例是79.8%,value correlation 0.990。
训练数字好看,还要放回bot里测。96局共享测试机,d24L2加深搜索对线上bot赢64.5%;48局每核一局,赢55.7%。它也挂了开场测试,线上placement只有25.69。
RL更直接。一个overnight policy单独对parent打出819-203,放进搜索里只拿到46.0%。各种RL尝试都在55% gate下:self-play retrain 45.7%,local RL loop 46.6%,rule v3下49.5%,把四倍搜索蒸馏进judge 50.6%,AlphaGo式pipeline 46.0%。
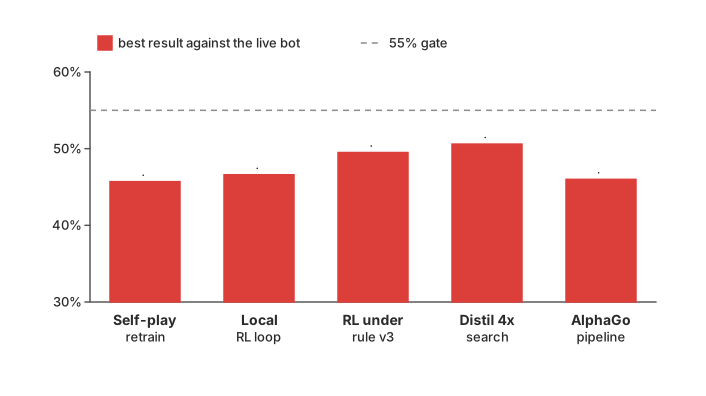
Gaurav的总结是,11个网络和RL想法里,5个通过了对线上bot的测试,1个提升了placement。placement最大的一次提升来自结构:bot先针对对手对自己计划的最佳回复做规划,再重新规划。
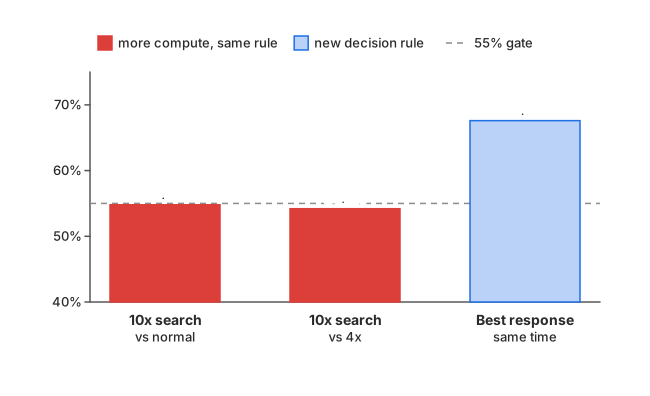
同等计算量下,这条规则赢67.6%。十倍搜索只赢54.8%,十倍对四倍搜索赢54.2%,也在55% gate下。网络是bot的一部分,围绕它的决策规则做了更多事。
评论区有人问,1年经验的SDE怎么和10到20年经验的人竞争,该学niche还是深扎ML。Seekful.org的回复很实用:从SWE转ML,理论比很多人怕的少,但顺序要对,矩阵乘法、导数、链式法则,有了这些,backprop就不神秘。另一个问题问SLM在小项目、隐私和速度场景是否更有效。这个案例里,小网络是50毫秒和100000字符逼出来的,先有系统约束,后有模型尺寸。
训练数字只能当参考,系统里的表现才算测试。
发布时间: 2026-11-12 07:39