线性注意力每生成一个token都要搬状态,LeapQuant把它压到8位还不掉点
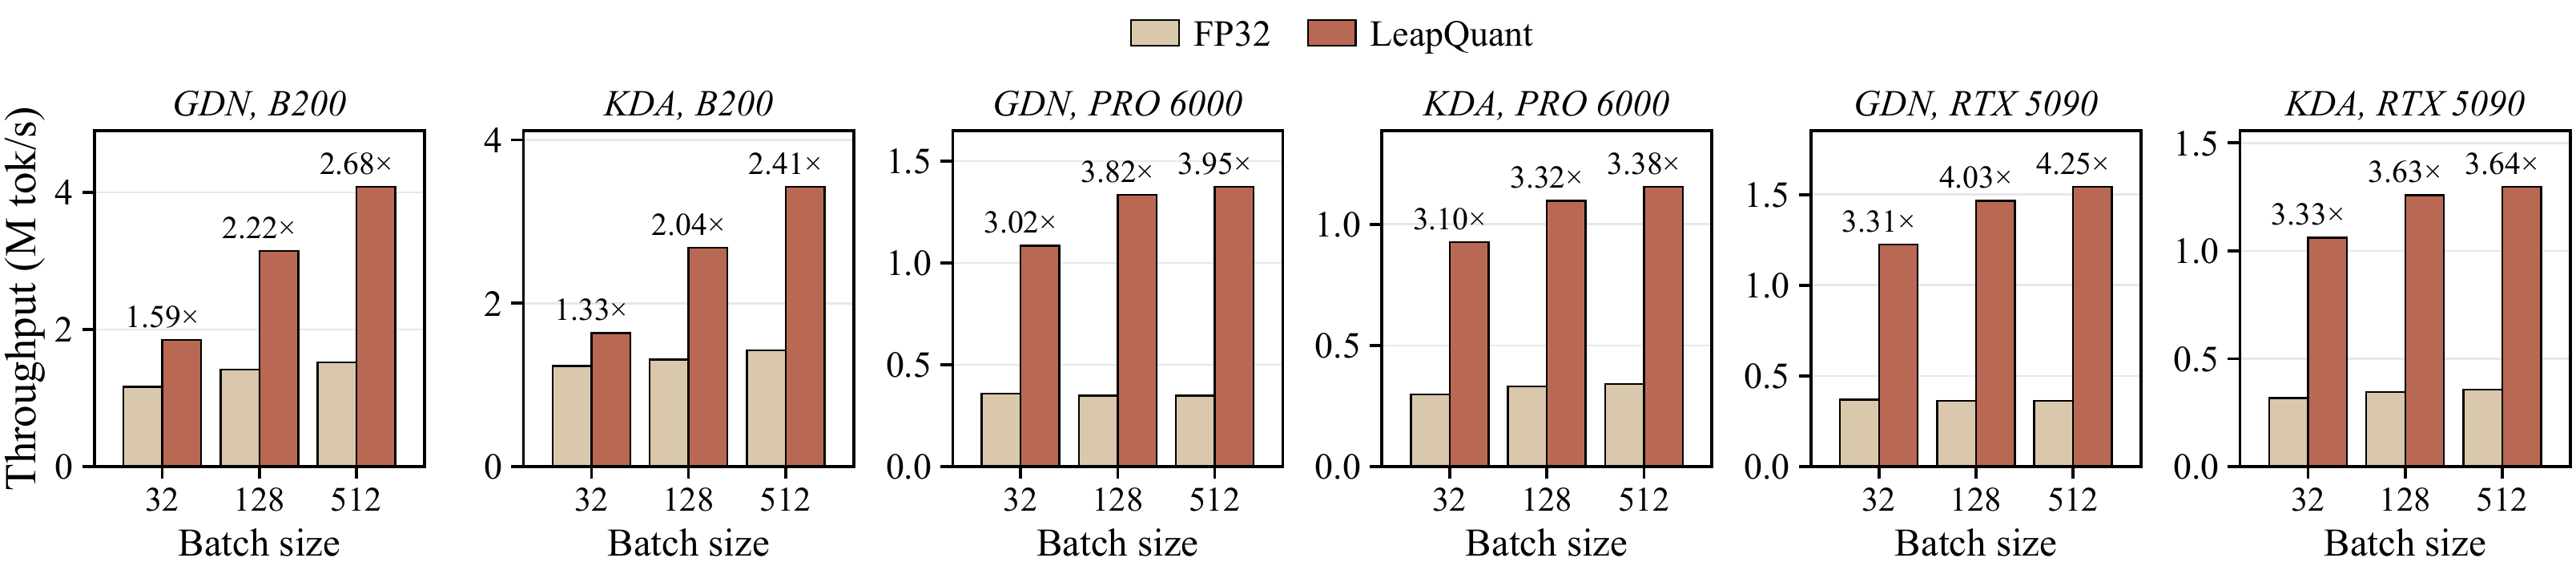
Yi Pan 等人提出 LeapQuant,免训练把线性注意力的循环状态量化到8位/4位,覆盖Qwen、Kimi、GLM。它用窗口量化、补偿token和残差平滑处理误差累积与outlier,8位和6位平均分与FP32持平,kernel平均加速2.05到3.70倍,内存最高降56%。
Qwen、Kimi、GLM 这些模型家族在把一部分标准注意力换成线性注意力。线性注意力把上下文压进固定大小的循环状态,省掉长上下文里注意力计算和KV缓存的增长。代价在解码:每生成一个token,线性注意力层都要把循环状态从HBM读出来,做一次轻量更新,再写回去。状态读写成了瓶颈。prefix caching打开后,服务系统还要为每个缓存前缀保留一份状态,显存占用跟着涨。
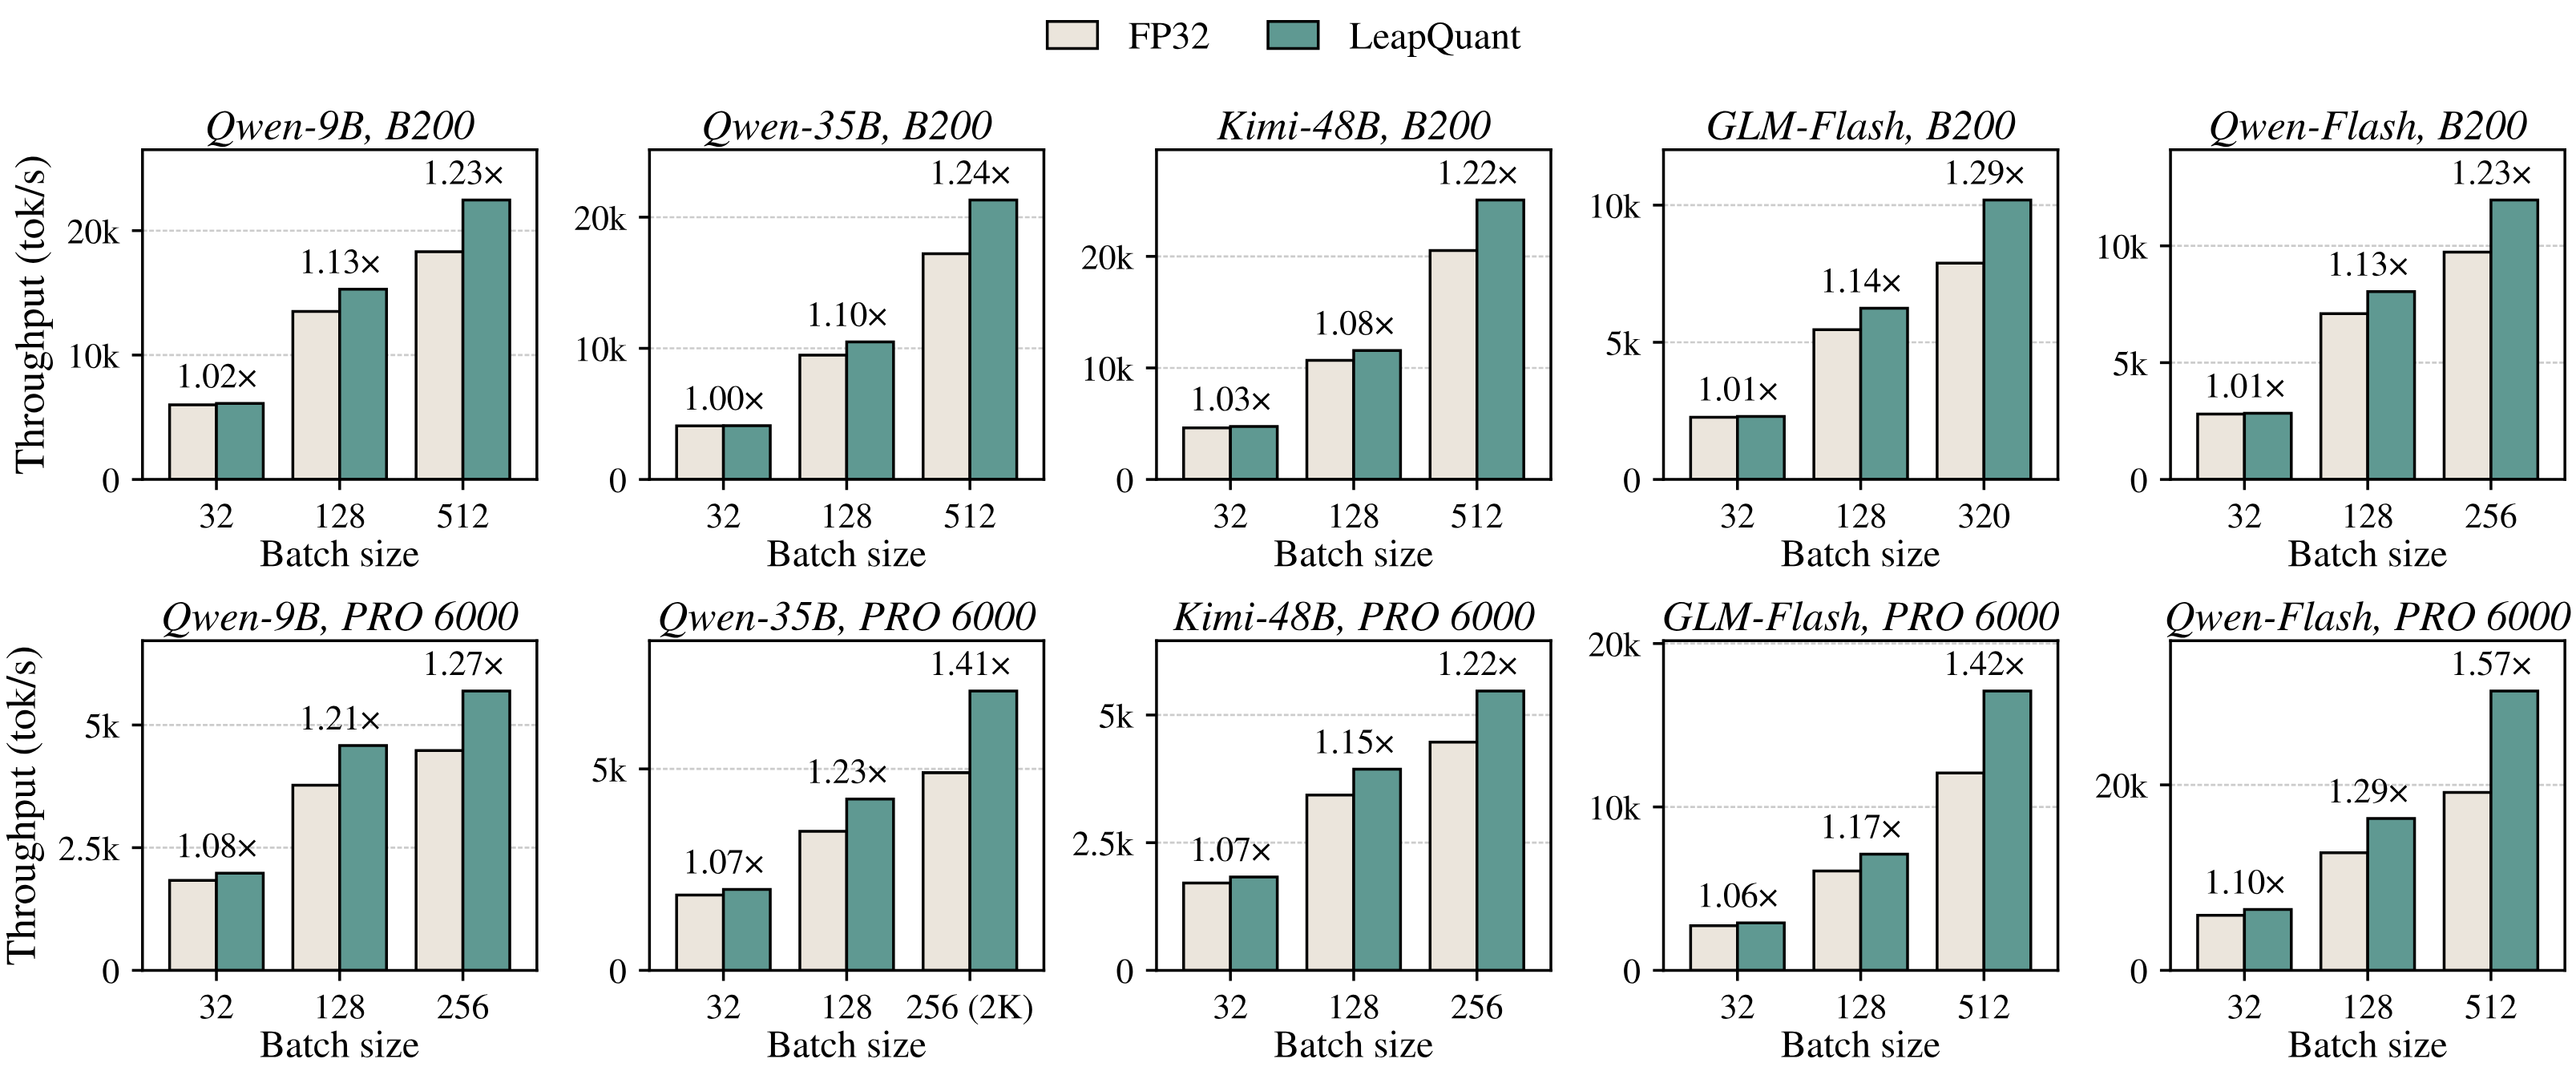
Yi Pan 在推文里介绍了 LeapQuant。推文称它是首个免训练、能让8位或4位循环状态跑起来的方法,覆盖 Qwen、Kimi、GLM。论文作者还包括 Haocheng Xi、Kan Zhu、Xingyang Li、Song Han、Kurt Keutzer、Ion Stoica 等。项目页给的结论很直接:精度接近FP32,kernel平均加速2.05到3.70倍,端到端推理平均1.57倍。
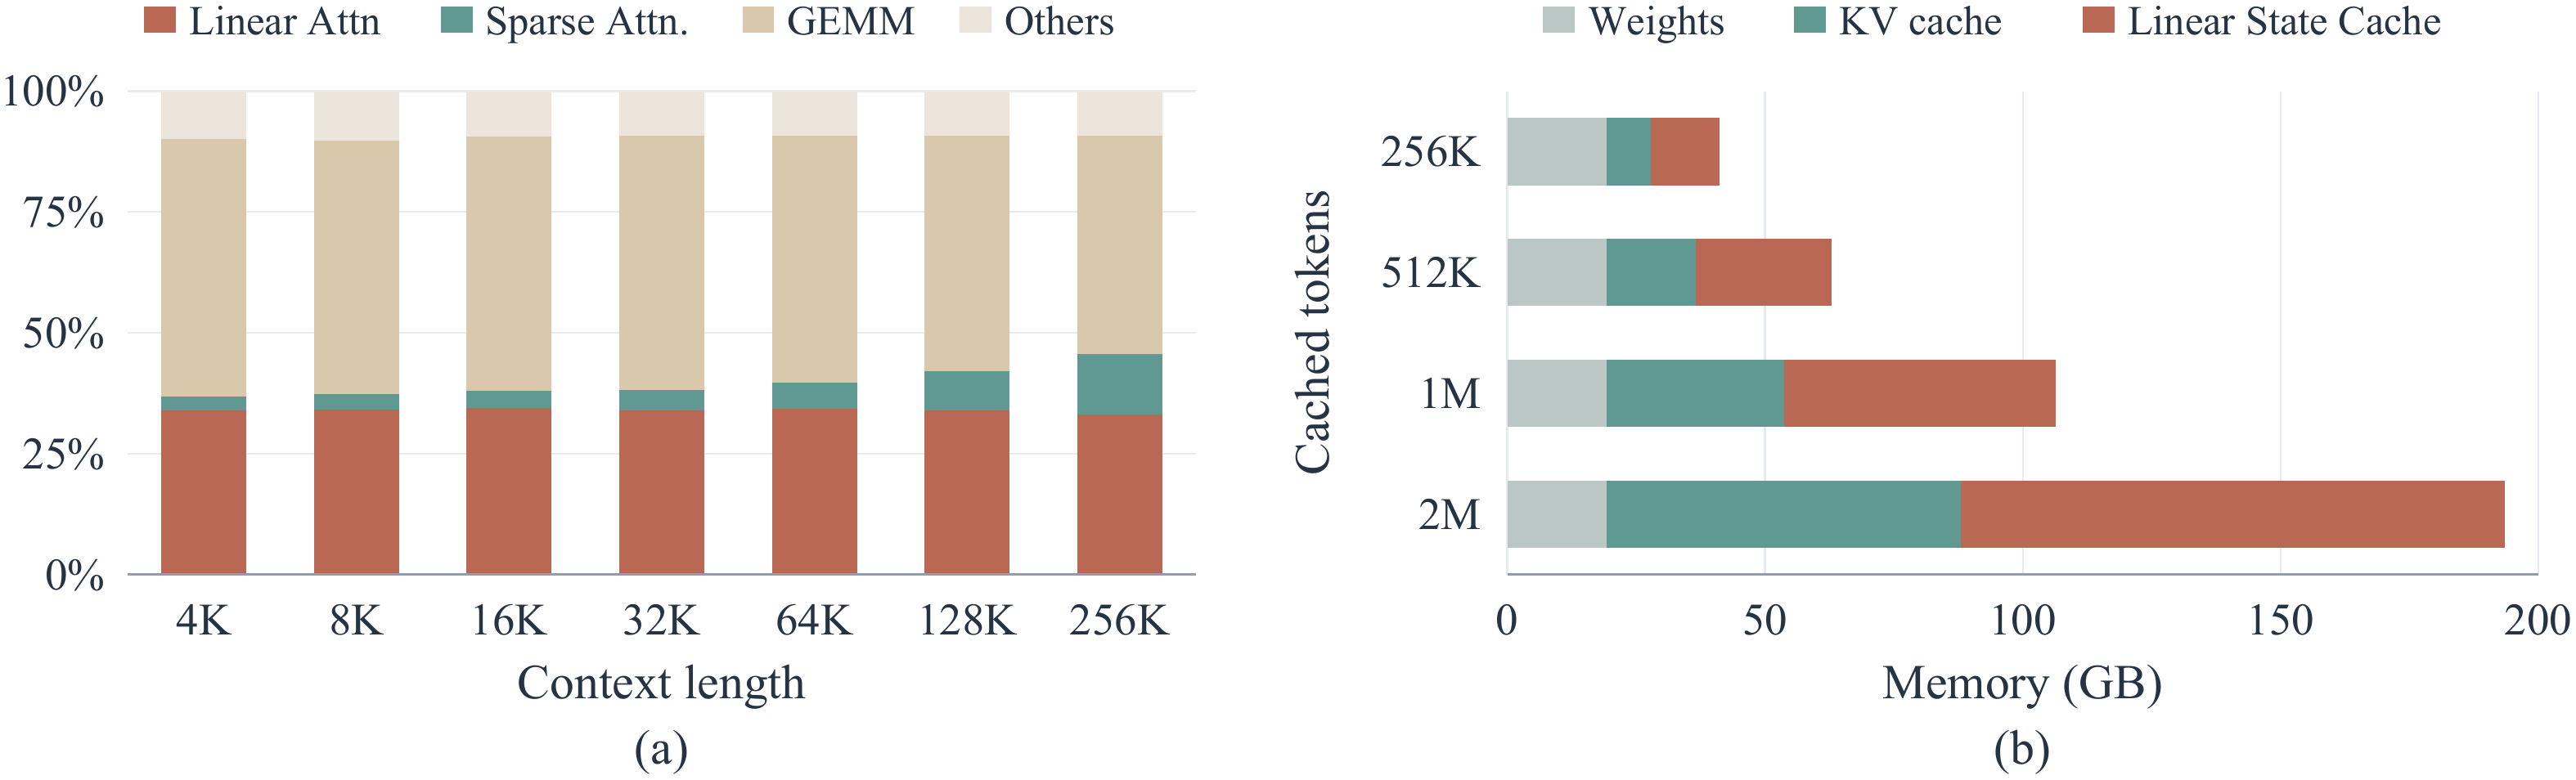
量化看起来是自然选择,难在循环状态每一步都在更新。每步量化会把舍入误差带进后续所有状态,长上下文里误差累积。状态里还有outlier行和列,它们撑大量化范围,把普通数值挤到更粗的量化格子上。Yi Pan 提到,朴素的FP8/INT8会崩,BF16也比FP32平均掉约11.5分,测试集是 AIME 2026、BeyondAIME、GPQA-Diamond、LiveCodeBench v6。
LeapQuant 用三招处理这两个问题。
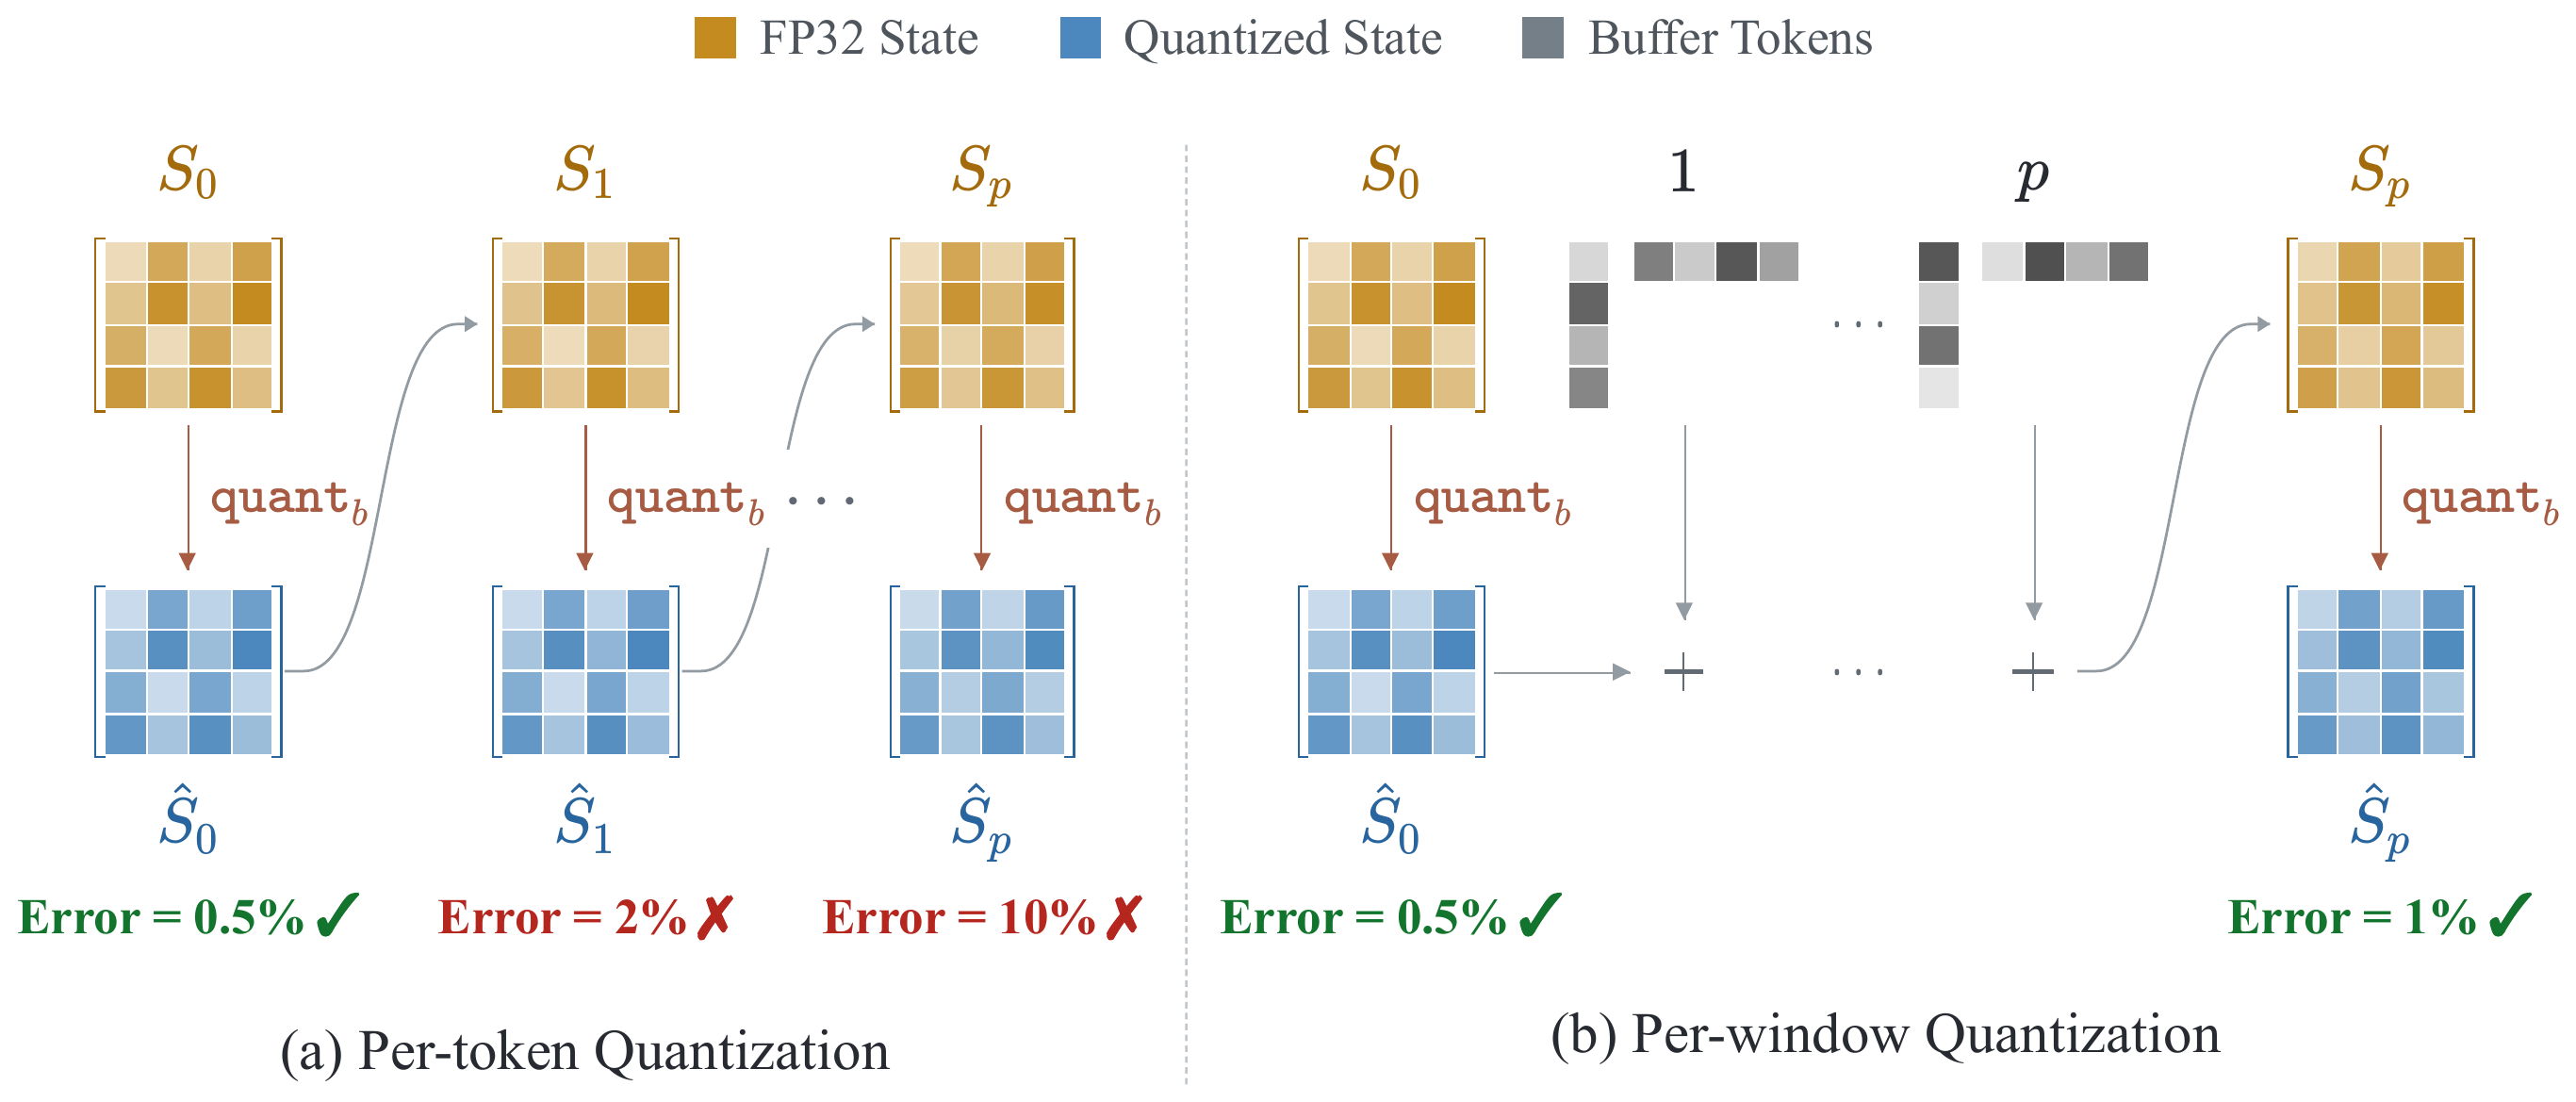
第一招是 per-window quantization。状态不在每个token后重新量化,而是跨过一个token窗口,只在窗口结束时量化一次。窗口内低精度状态固定不动,token更新先以高精度缓存,输出由固定状态和缓存更新共同算出。推文里提到每16个token轮一次。量化次数少了,误差不再每步滚一次。
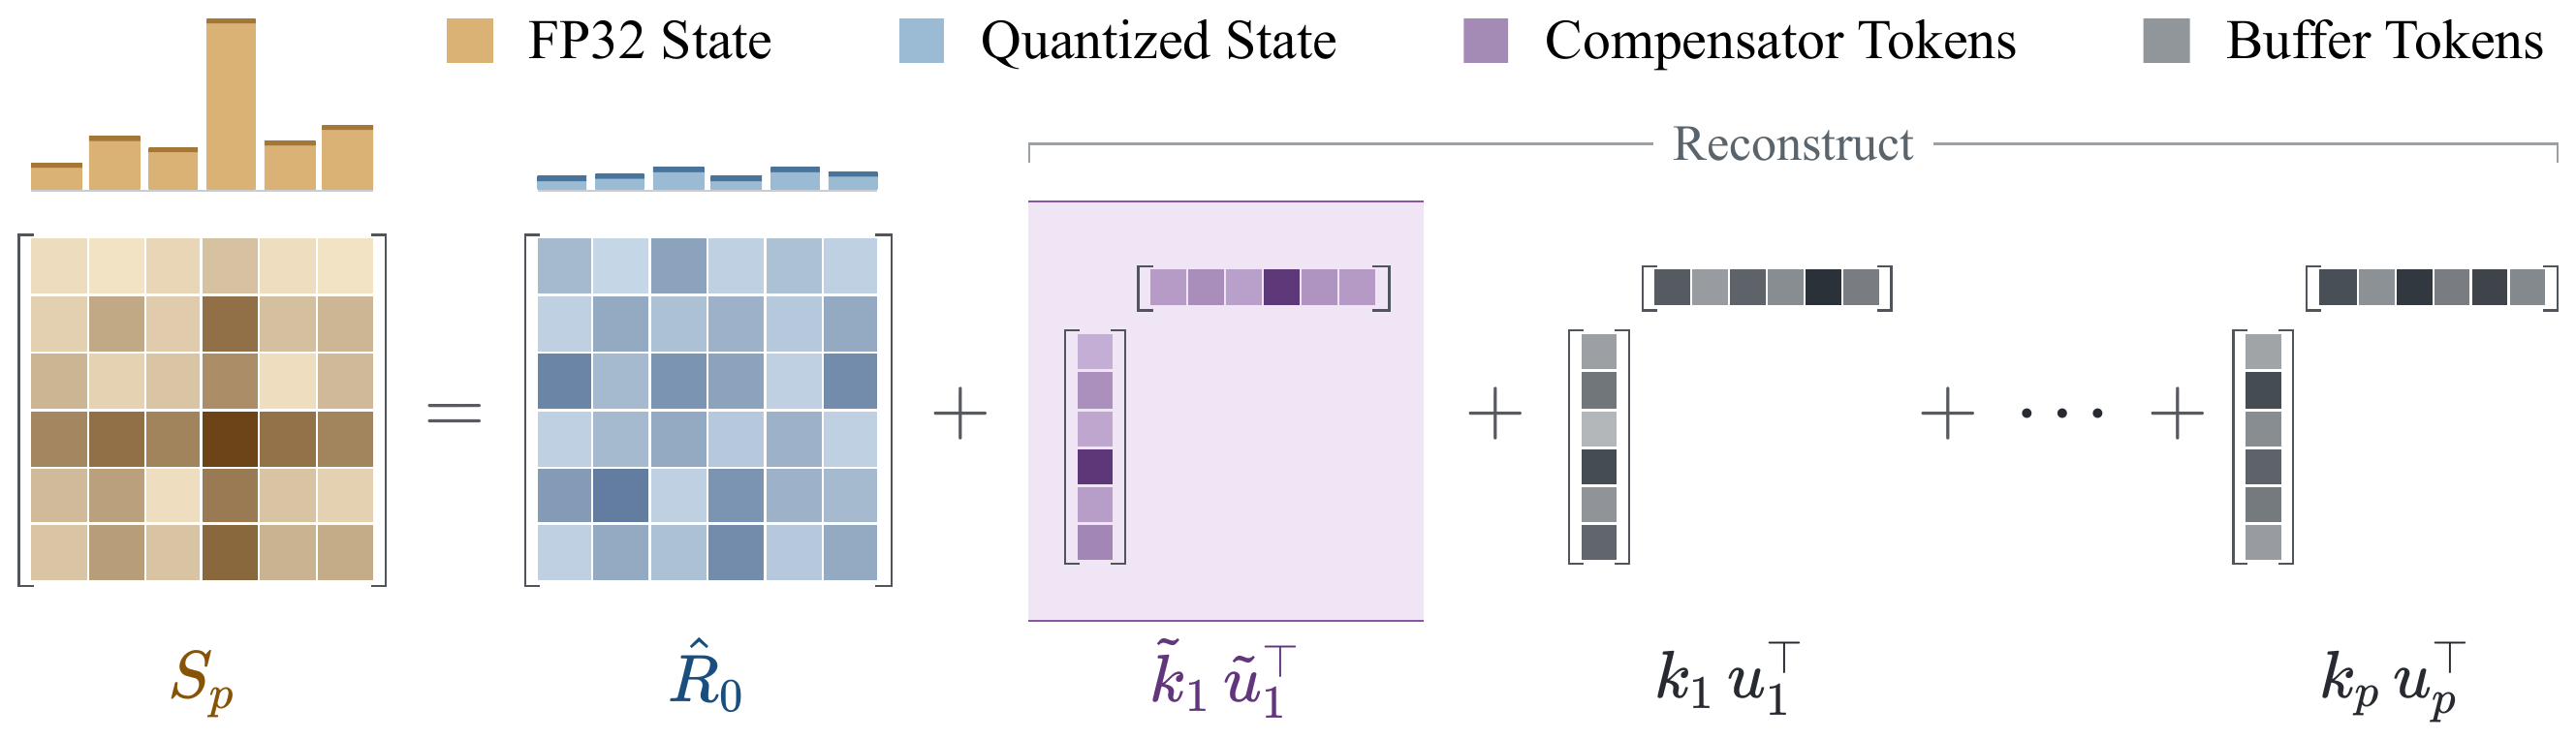
第二招是 Compensator Tokens。把状态里最大的outlier抽出来,保留为几个高精度的rank-one外积。它们和真实token更新的形式相同,所以能直接并入窗口的更新路径,几乎不增加额外状态更新。剩下的残差更好量化。
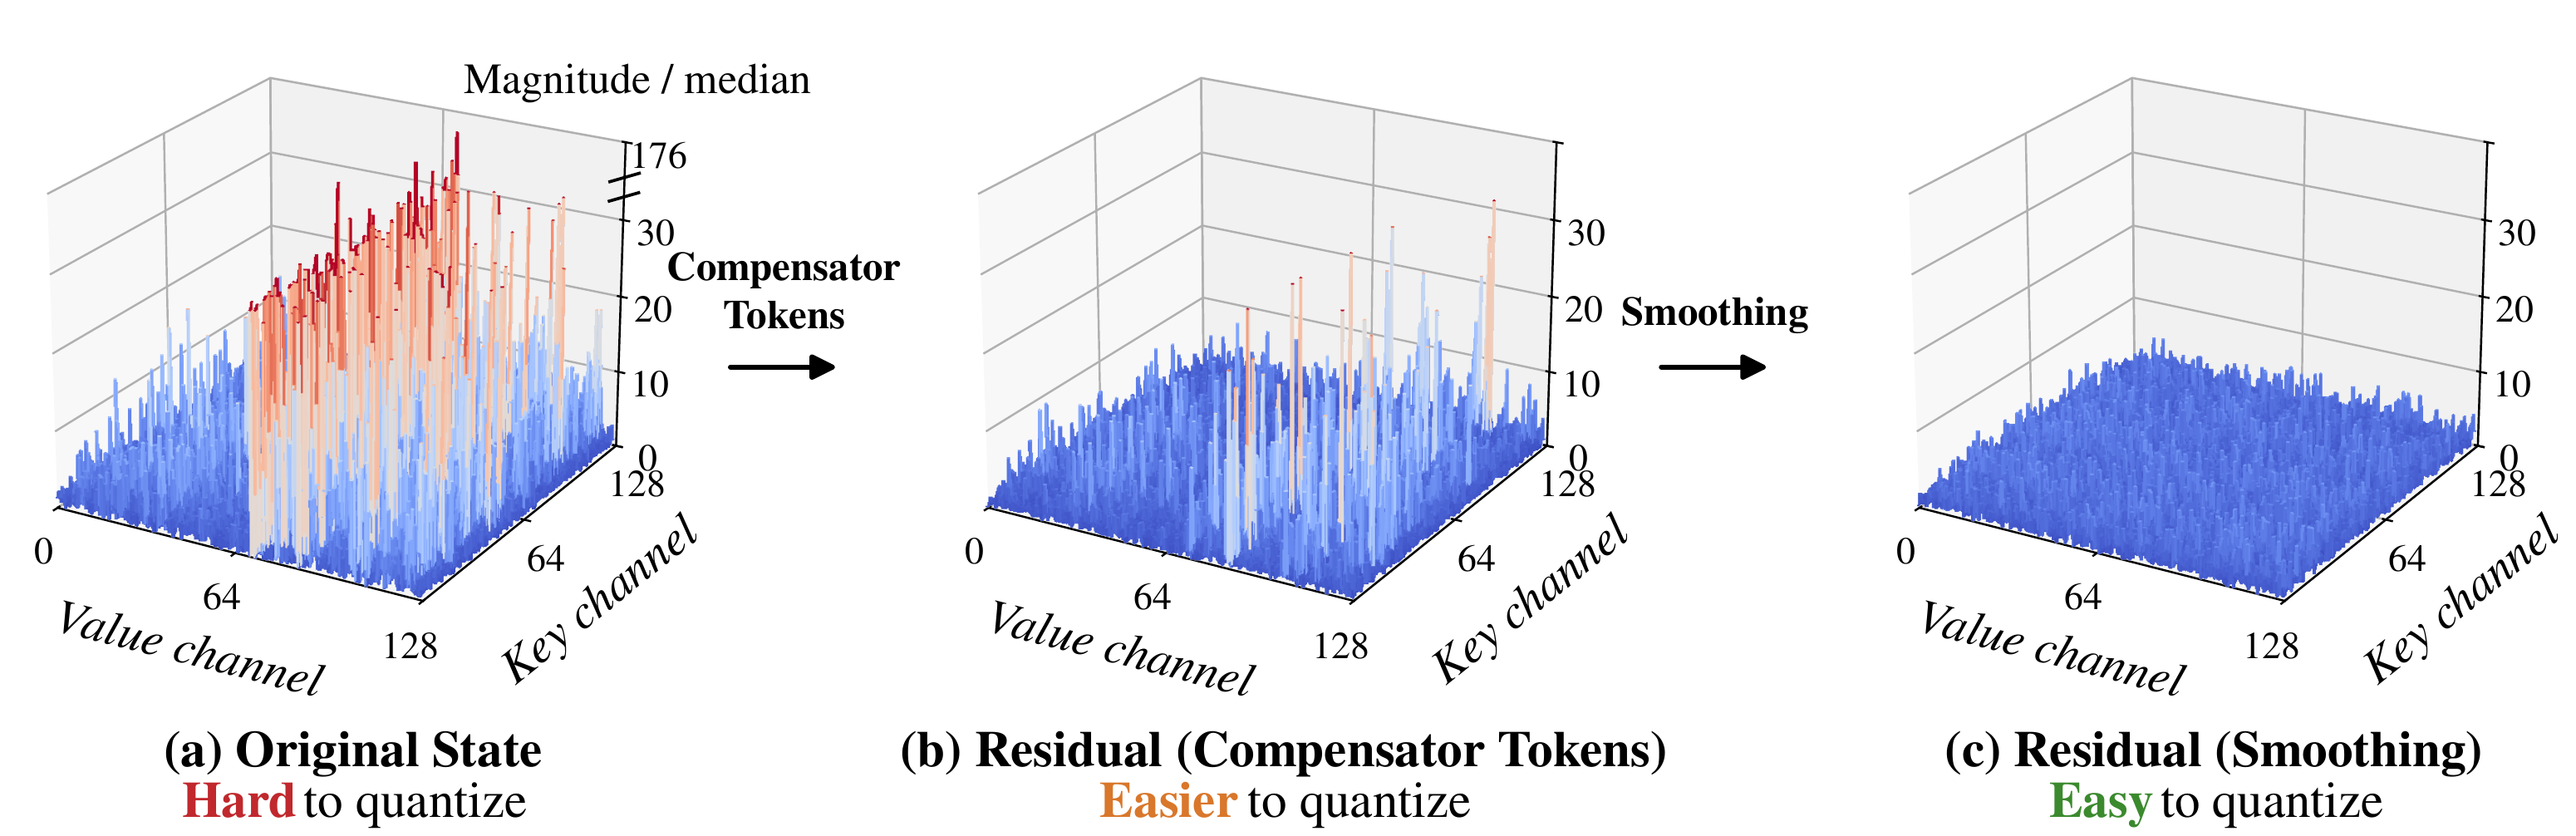
第三招是 residual smoothing。去掉补偿token后,残差在不同key通道上的幅度仍可能不均。量化前先平衡每一行的幅度,平滑scale在窗口内固定,到窗口边界再刷新。项目页给了一个Qwen3.5-9B注意力头的例子:outlier从176倍中位数降到5.3倍。
结果按三个模型平均看,8位和6位的LeapQuant都在84.4分,FP32是84.0分;BF16是72.5分,FP8是45.1分,INT8是47.7分。4位LeapQuant平均80.6分,比FP32低3.4分,但比表里其他4位方法高出一大截。
| 方法 | 平均分 |
|---|---|
| FP32 | 84.0 |
| BF16 | 72.5 |
| 8-bit LeapQuant | 84.4 |
| FP8 | 45.1 |
| INT8 | 47.7 |
| 6-bit LeapQuant | 84.4 |
| 4-bit LeapQuant | 80.6 |
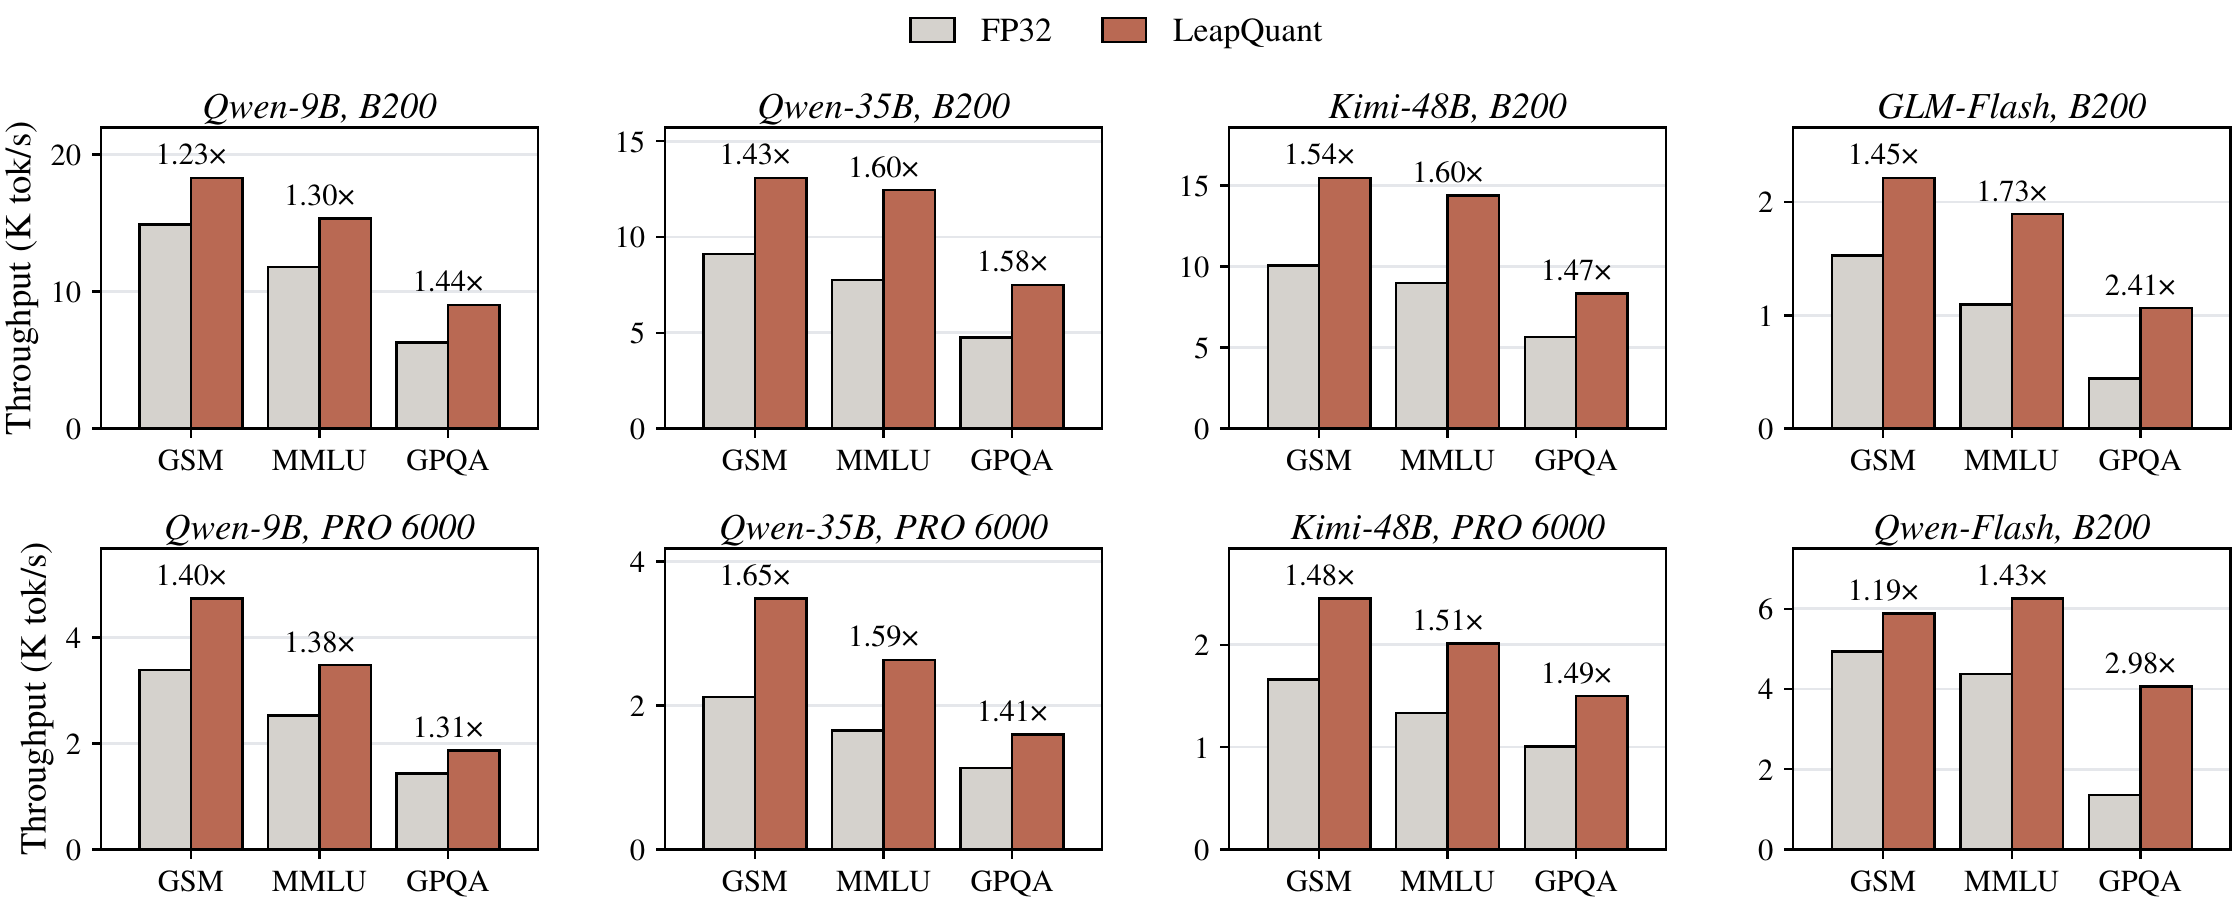
速度方面,推文给出的最高kernel加速是4.25倍,论文和项目页给的平均区间是2.05到3.70倍。项目页和GitHub写端到端平均1.57倍,arXiv摘要写1.47倍,版本之间有差异。内存上,项目页说循环状态的内存流量降3.4倍,端到端显存最高降56%。推文还写了推理吞吐最高2倍。
代码已经开源,集成进 vLLM 0.30.0 作为插件,支持 Qwen 的 Gated DeltaNet 和 GLM 的 Kimi Delta Attention。用法不复杂:
git clone https://github.com/leapquant/LeapQuant.git
cd LeapQuant && pip install -e .

bash serve.sh <model>
serve.sh 会启动一个OpenAI兼容的vLLM服务,循环状态用8位,额外参数传给 vllm serve。论文、代码和项目页都在这里:
这类工作的价值不在单点跑分,而在长上下文和prefix caching场景下把状态存储成本压下去,让同样显存服务更多前缀。有网友 Steven Gao 提到它可能帮助prefix reuse,Yi Pan 回复说这正是内存下降和吞吐增益的来源之一。真实收益还要看模型结构、batch大小、上下文长度和内核实现,代码开源后这些都可以自己测。
发布时间: 2026-11-12 21:34